

密ベクトル
密ベクトルは、機械学習やデータ分析で広く用いられる数値データの表現形式です。これは実数からなる配列で構成され、その要素のほとんどまたはすべてがゼロではありません。疎ベクトルと比較して、密ベクトルは各次元が意味のある値を持つため、同じ次元数においてより多くの情報を含んでいます。 この表現形式は、複雑なパターンや関係を効果的に捉えることができるため、高次元空間におけるデータの分析や処理が容易になります。密ベクトルは通常、固定された次元数を持っており、具体的な用途や要件に応じて、数十から数百、さらには数千にまで及びます。
密ベクトルは主に、セマンティック検索やレコメンデーションシステムなど、データの意味論を理解する必要がある場面で使用されます。セマンティック検索では、密ベクトルがクエリとドキュメントの間に潜む関連性を捉えるのに役立ち、検索結果の関連性を向上させます。レコメンデーションシステムでは、ユーザーとアイテム間の類似性を特定するのに役立ち、よりパーソナライズされた提案を提供します。
概要
高密度ベクトルは通常、[0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5] のような固定長の浮動小数点数の配列として表現されます。これらのベクトルの次元数は、128、256、768、1024など、通常は数百から数千の範囲です。 各次元はオブジェクトの特定の意味的特徴を捉えており、類似度計算を通じて様々なシナリオに適用可能です。
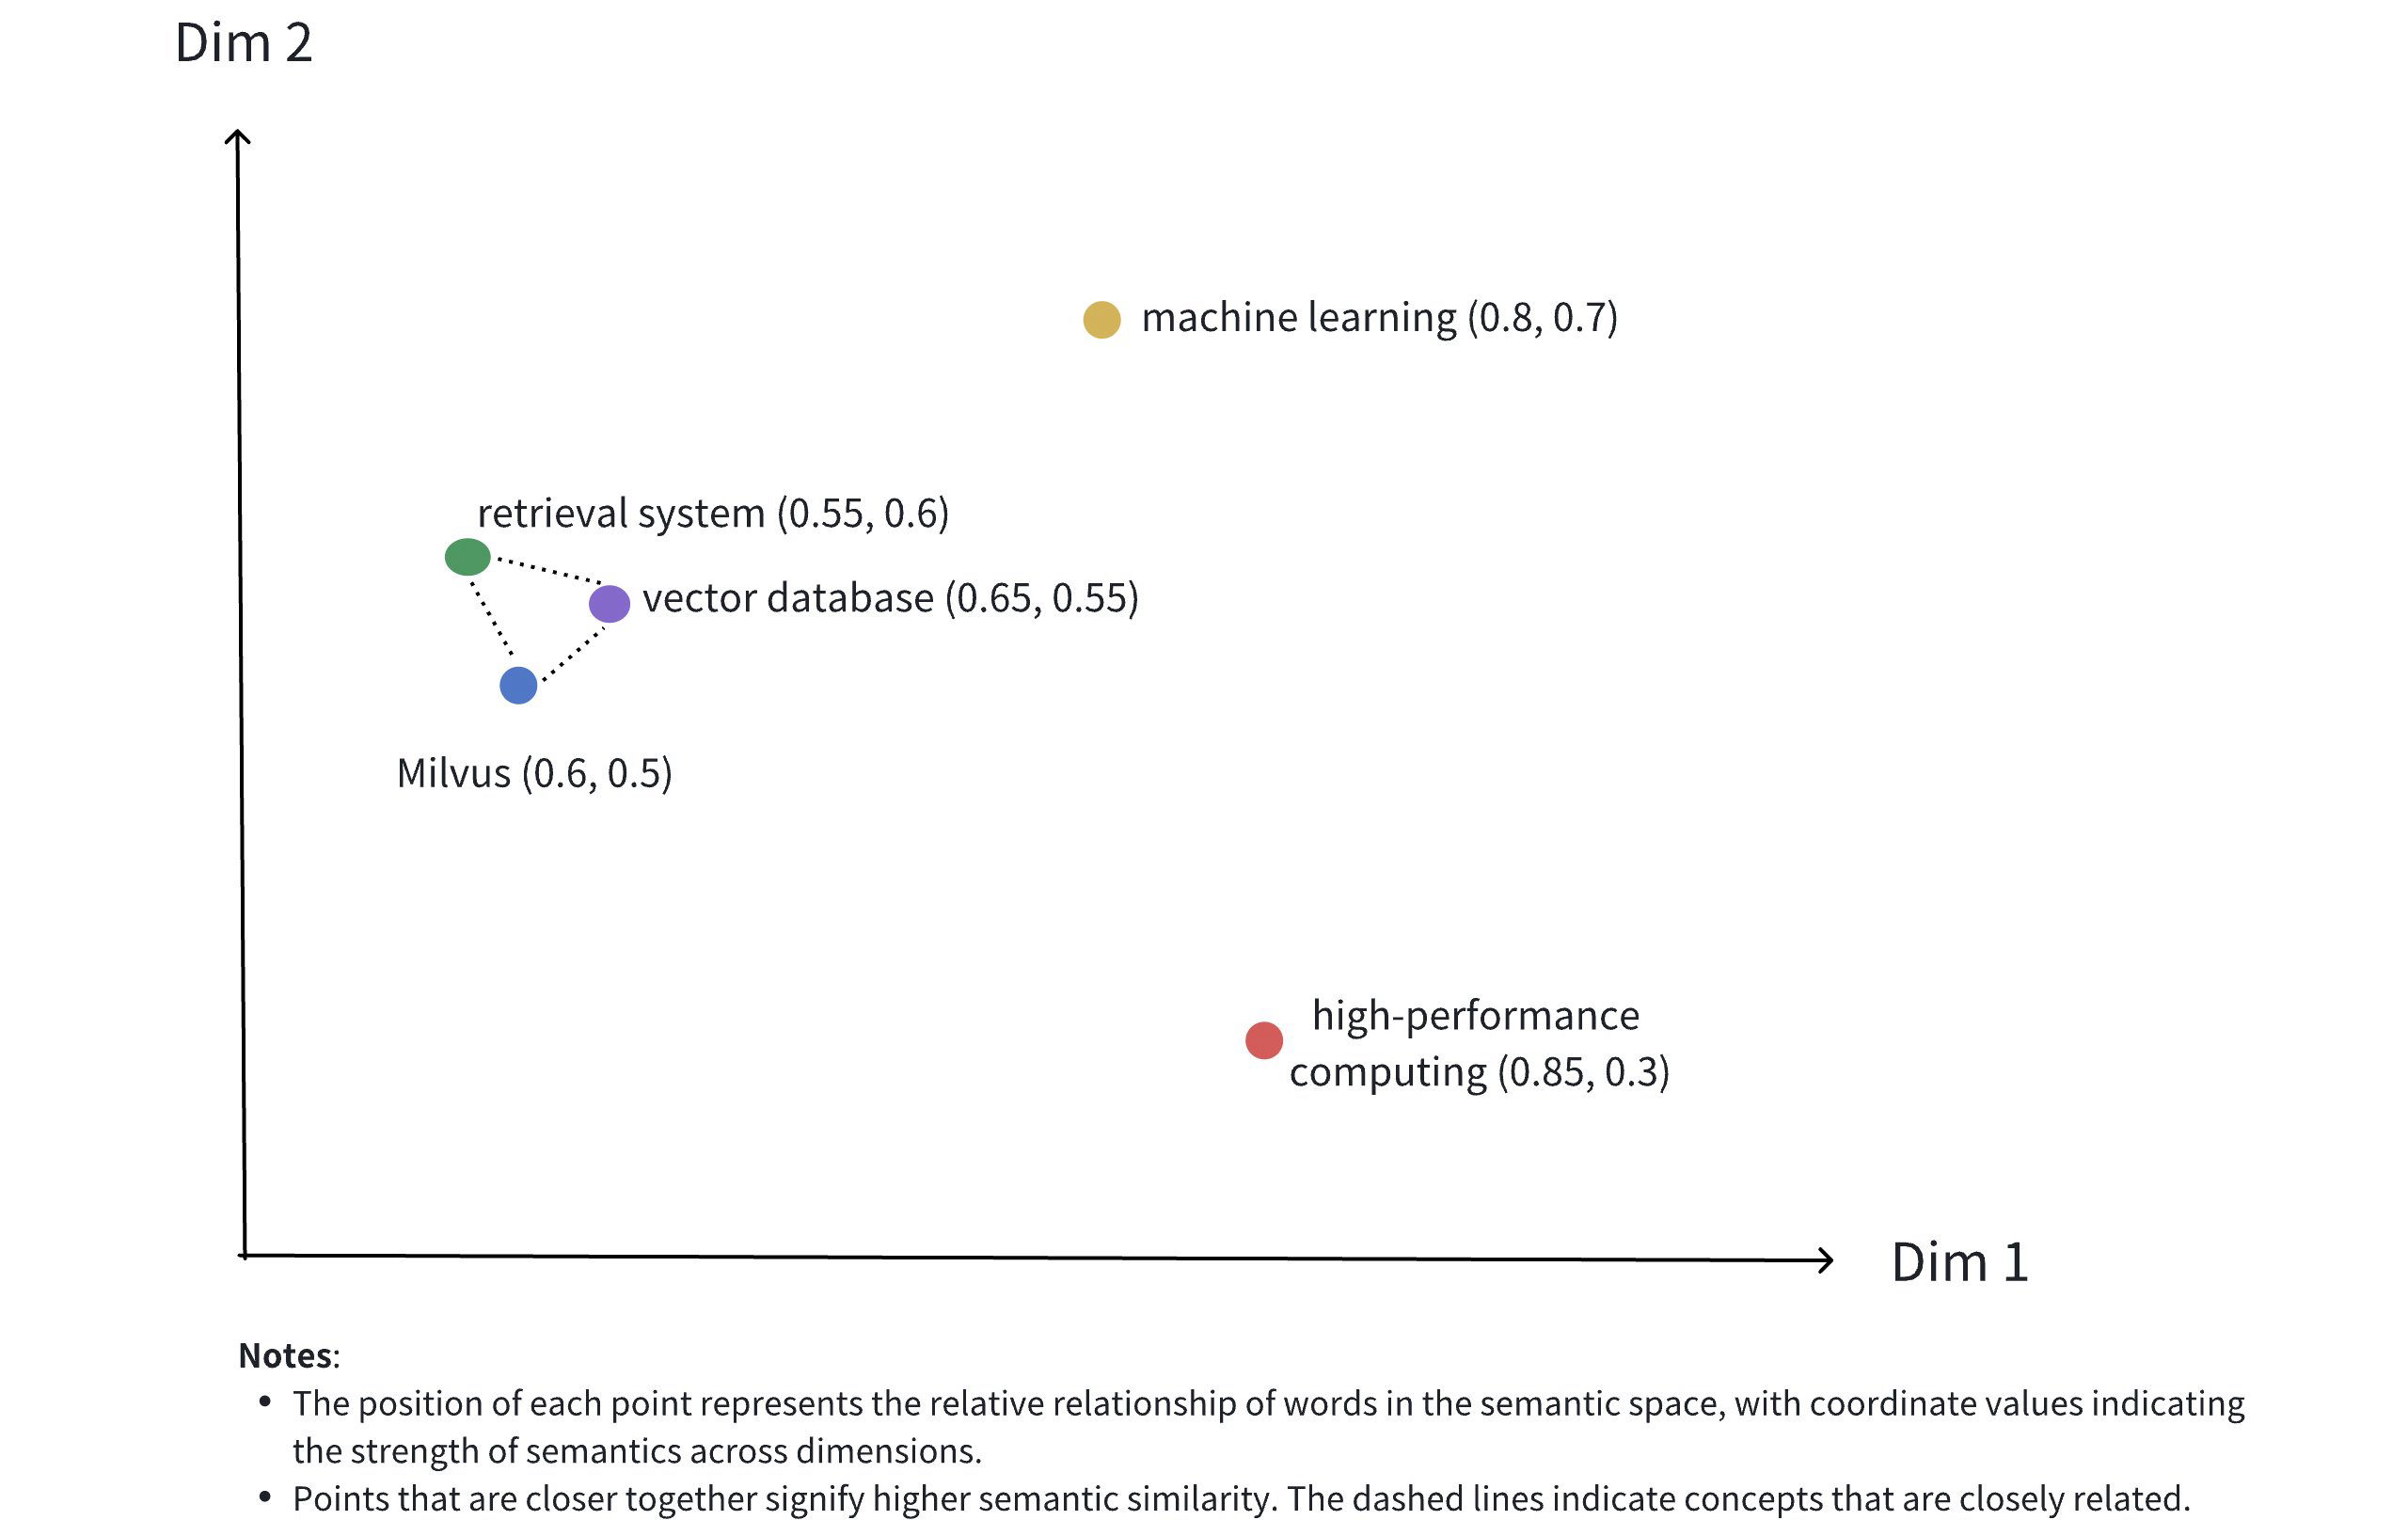 密ベクトル
上の図は、2次元空間における密ベクトルの表現を示しています。実世界のアプリケーションにおける密ベクトルは、多くの場合、はるかに高い次元を持っていますが、この2次元の図は、いくつかの重要な概念を効果的に伝えています。
多次元表現:各点は概念的なオブジェクト(Milvus、ベクトルデータベース、検索システムなど)を表しており、その位置は各次元の値によって決定されます。
意味的関係:点間の距離は、概念間の意味的類似性を反映しています。近い点ほど、意味的に密接に関連している概念であることを示しています。
クラスタリング効果:関連する概念(Milvus、ベクトルデータベース、検索システムなど)は空間上で互いに近くに配置され、意味的なクラスタを形成しています。
以下は、テキスト「"Milvus is an efficient vector database" 」を表す実際の高密度ベクトルの例です:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
高密度ベクトルは、画像用のCNNモデル(ResNet、VGGなど)やテキスト用の言語モデル(BERT、Word2Vecなど)など、さまざまな埋め込みモデルを使用して生成できます。これらのモデルは、生データを高次元空間上の点に変換し、データの意味的特徴を捉えます。 さらに、Milvusでは「Embeddings」で詳述されているように、ユーザーが密ベクトルを生成・処理するための便利なメソッドを提供しています。
データがベクトル化されると、Milvusに保存して管理やベクトル検索を行うことができます。以下の図は、その基本的なプロセスを示しています。
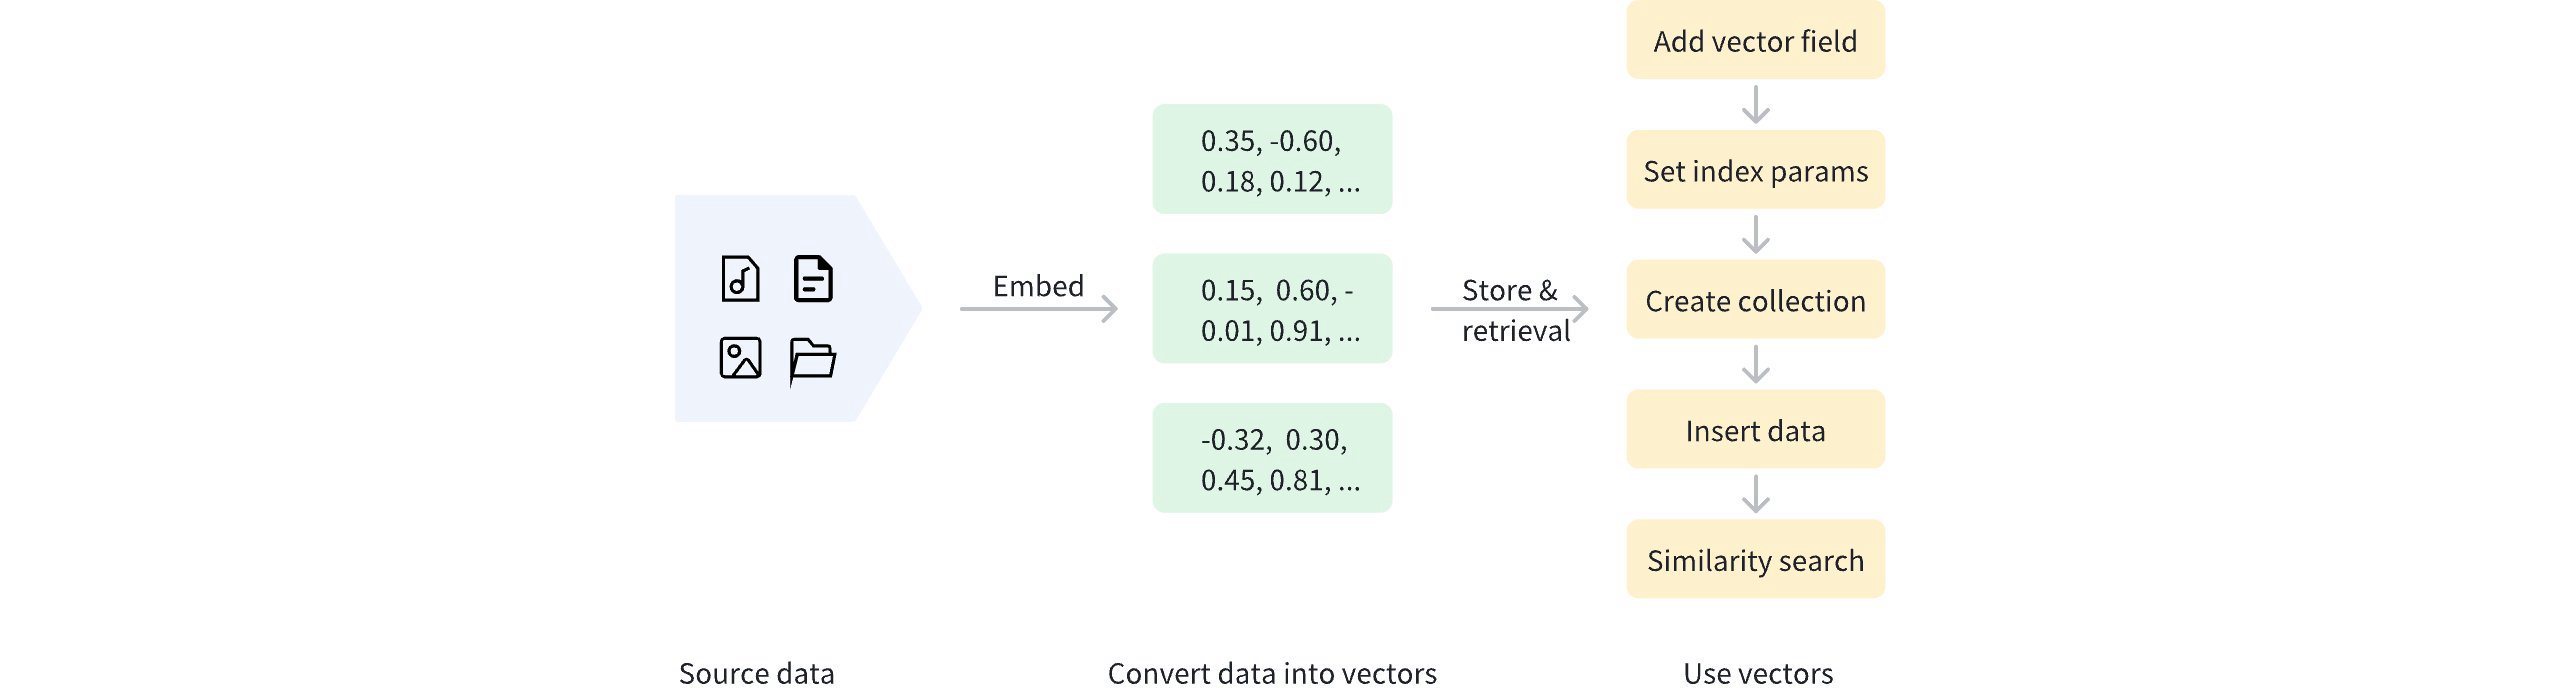 密ベクトルの使用
密ベクトルのほか、Milvusは疎ベクトルやバイナリベクトルもサポートしています。疎ベクトルは、キーワード検索や用語マッチングなど、特定の用語に基づく正確なマッチングに適しています。一方、バイナリベクトルは、画像パターンマッチングや特定のハッシュ処理など、二値化されたデータを効率的に扱うために一般的に使用されます。詳細については、「バイナリベクトル」および「疎ベクトル」を参照してください。
密ベクトルの使用
ベクトルフィールドの追加
Milvusで密ベクトルを使用するには、コレクションの作成時に、密ベクトルを格納するためのベクトルフィールドを最初に定義する必要があります。このプロセスには以下が含まれます:
datatypeをサポートされている密ベクトルデータ型に設定します。サポートされている密ベクトルデータ型については、「データ型」を参照してください。dimパラメータを使用して、密ベクトルの次元を指定します。
以下の例では、密ベクトルを格納するために「dense_vector 」という名前のベクトルフィールドを追加しています。このフィールドのデータ型はFLOAT_VECTOR で、次元は4 です。
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
密ベクトルフィールドでサポートされているデータ型:
データ型 |
説明 |
|---|---|
|
32ビット浮動小数点数を格納します。科学計算や機械学習において実数を表現するために一般的に使用されます。類似したベクトルの識別など、高精度が求められるシナリオに最適です。 |
|
16ビットの半精度浮動小数点数を格納します。ディープラーニングやGPU計算に使用されます。レコメンデーションシステムの低精度リコールフェーズなど、精度がそれほど重要ではないシナリオでは、ストレージ容量を節約できます。 |
|
16ビットのBrain Floating Point (bfloat16) 数値を格納します。Float32と同じ指数範囲を持ちますが、精度は低くなります。大規模な画像検索など、大量のベクトルを高速に処理する必要があるシナリオに適しています。 |
|
各次元の要素が8ビット整数(int8)で構成されるベクトルを格納します。各要素の値の範囲は–128から127です。 量子化されたディープラーニングモデル(ResNet、EfficientNetなど)向けに設計されたINT8_VECTORは、精度の低下を最小限に抑えながら、モデルのサイズを縮小し、推論を高速化します。 |
ベクトルフィールドのインデックスパラメータを設定する
セマンティック検索を高速化するには、ベクトルフィールドに対してインデックスを作成する必要があります。インデックス作成により、大規模なベクトルデータの検索効率を大幅に向上させることができます。
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
上記の例では、AUTOINDEX インデックス型を使用して、dense_vector フィールドに対してdense_vector_index という名前のインデックスが作成されています。metric_type はIP に設定されており、距離メトリックとして内積が使用されることを示しています。
Milvusでは、ベクトル検索の利便性を高めるために、さまざまなインデックスタイプが用意されています。AUTOINDEXは、ベクトル検索の学習曲線を緩やかにするために設計された特別なインデックスタイプです。他にも多くのインデックスタイプから選択可能です。詳細については、「インデックスの解説」を参照してください。
Milvusは他のメトリックタイプもサポートしています。詳細については、「Metric Types」を参照してください。
コレクションの作成
密ベクトルとインデックス・パラメータの設定が完了したら、密ベクトルを含むコレクションを作成できます。以下の例では、create_collection メソッドを使用して、my_collection という名前のコレクションを作成しています。
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
データの挿入
コレクションの作成後、insert メソッドを使用して、密ベクトルを含むデータを追加します。挿入する密ベクトルの次元が、密ベクトルフィールドを追加した際に定義したdim の値と一致していることを確認してください。
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
類似性検索の実行
密ベクトルに基づくセマンティック検索は、Milvusの中核機能の一つであり、ベクトル間の距離に基づいて、クエリベクトルに最も類似したデータを迅速に見つけることができます。類似度検索を実行するには、クエリベクトルと検索パラメータを準備し、search メソッドを呼び出します。
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
類似度検索のパラメータに関する詳細については、「基本的なANN検索」を参照してください。
