

Spiegazione dello schema
Uno schema definisce la struttura dei dati di una raccolta. Prima di creare una raccolta, è necessario elaborare un progetto del relativo schema. Questa pagina ti aiuta a comprendere lo schema della raccolta e a progettare autonomamente uno schema di esempio.
Panoramica
Su Milvus, lo schema di una collezione corrisponde a una tabella in un database relazionale, che definisce il modo in cui Milvus organizza i dati all’interno della collezione.
Uno schema ben progettato è essenziale in quanto astrae il modello di dati e determina se è possibile raggiungere gli obiettivi aziendali tramite una ricerca. Inoltre, poiché ogni riga di dati inserita nella collezione deve seguire lo schema, ciò contribuisce a mantenere la coerenza dei dati e la qualità a lungo termine. Da un punto di vista tecnico, uno schema ben definito porta a un'archiviazione dei dati delle colonne ben organizzata e a una struttura dell’indice più pulita, migliorando le prestazioni di ricerca.
Uno schema di raccolta presenta una chiave primaria, almeno un campo vettoriale e diversi campi scalari. Il diagramma seguente illustra come mappare un articolo a un elenco di campi dello schema.
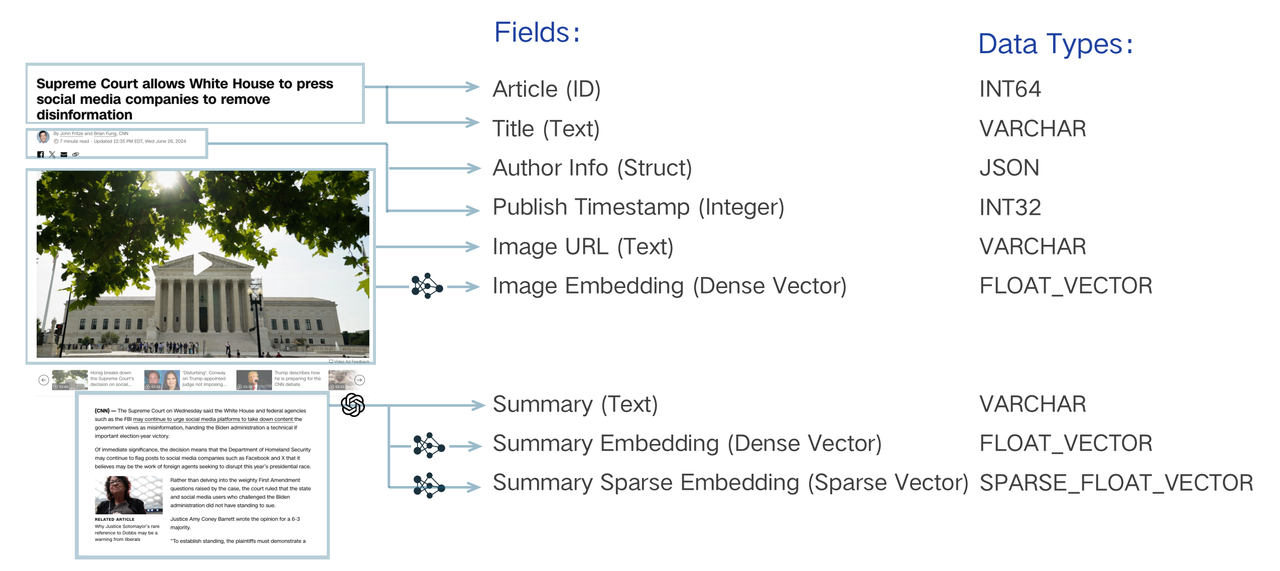 Anatomia della progettazione dello schema
La progettazione del modello di dati di un sistema di ricerca comporta l’analisi delle esigenze aziendali e l’astrazione delle informazioni in un modello di dati espresso tramite uno schema. Ad esempio, la ricerca di un brano di testo deve essere “indicizzata” convertendo la stringa letterale in un vettore tramite “embedding” e abilitando la ricerca vettoriale. Oltre a questo requisito essenziale, potrebbe essere necessario memorizzare altre proprietà, quali la data e l’ora di pubblicazione e l’autore. Questi metadati consentono di affinare le ricerche semantiche tramite filtri, restituendo solo i testi pubblicati dopo una data specifica o da un autore particolare. È inoltre possibile recuperare questi valori scalari insieme al testo principale per visualizzare il risultato della ricerca nell’applicazione. A ciascuno di essi dovrebbe essere assegnato un identificatore univoco, espresso come numero intero o stringa, per organizzare questi frammenti di testo. Questi elementi sono essenziali per ottenere una logica di ricerca sofisticata.
Fare riferimento alla guida pratica sulla progettazione dello schema per capire come realizzare uno schema ben progettato.
Creazione dello schema
Il seguente frammento di codice mostra come creare uno schema.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema()
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = client.createSchema();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const schema = []
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema()
export schema='{
    "fields": []
}'
Aggiungere il campo primario
Il campo primario in una collezione identifica in modo univoco un'entità. Accetta solo valori di tipo Int64 o VARCHAR. I seguenti frammenti di codice mostrano come aggiungere il campo primario.
schema.add_field(
    field_name="my_id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("my_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());
schema.push({
    name: "my_id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: false
});
schema.WithField(entity.NewField().WithName("my_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(false),
)
export primaryField='{
    "fieldName": "my_id",
    "dataType": "Int64",
    "isPrimary": true
}'

export schema='{
    \"autoID\": false,
    \"fields\": [
        $primaryField
    ]
}'
Quando si aggiunge un campo, è possibile specificarne esplicitamente la natura di campo primario impostando la proprietà ` is_primary ` su ` True`. Per impostazione predefinita, un campo primario accetta valori di tipo `Int64`. In questo caso, il valore del campo primario deve essere un numero intero simile a ` 12345`. Se si sceglie di utilizzare valori di tipo `VARCHAR` nel campo primario, il valore deve essere una stringa simile a ` my_entity_1234`.
È inoltre possibile impostare le proprietà autoId su True per fare in modo che Milvus assegni automaticamente i valori dei campi primari al momento dell’inserimento dei dati.
Si consiglia di affidarsi a autoId in tutti i casi, a meno che l’impostazione manuale delle chiavi primarie non sia vantaggiosa.
Per ulteriori dettagli, consultare Campo primario e AutoId.
Aggiunta di campi vettoriali
I campi vettoriali accettano vari embedding vettoriali sparsi e densi. Su Milvus, è possibile aggiungere quattro campi vettoriali a una collezione. I seguenti frammenti di codice mostrano come aggiungere un campo vettoriale.
schema.add_field(
    field_name="my_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
schema.push({
    name: "my_vector",
    data_type: DataType.FloatVector,
    dim: 5
});
schema.WithField(entity.NewField().WithName("my_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
export vectorField='{
    "fieldName": "my_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 5
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Il parametro ` dim ` nei frammenti di codice sopra riportati indica la dimensionalità delle rappresentazioni vettoriali da contenere nel campo vettoriale. Il valore ` FLOAT_VECTOR ` indica che il campo vettoriale contiene un elenco di numeri in virgola mobile a 32 bit, solitamente utilizzati per rappresentare gli antilogaritmi. Oltre a ciò, Milvus supporta anche i seguenti tipi di rappresentazioni vettoriali:
FLOAT16_VECTORUn campo vettoriale di questo tipo contiene un elenco di numeri in virgola mobile a mezza precisione a 16 bit e si applica solitamente a scenari di deep learning con limitazioni di memoria o larghezza di banda, oppure a scenari di calcolo basati su GPU.
BFLOAT16_VECTORUn campo vettoriale di questo tipo contiene un elenco di numeri in virgola mobile a 16 bit che presentano una precisione ridotta ma lo stesso intervallo di esponenti di Float32. Questo tipo di dati è comunemente utilizzato in scenari di deep learning, poiché riduce l’utilizzo di memoria senza influire in modo significativo sulla precisione.
INT8_VECTORUn campo vettoriale di questo tipo memorizza vettori composti da interi con segno a 8 bit (int8), con ciascuna componente compresa tra –128 e 127. Progettato su misura per architetture di deep learning quantizzate — come ResNet ed EfficientNet — riduce notevolmente le dimensioni del modello e aumenta la velocità di inferenza, il tutto con una perdita di precisione minima. Nota: questo tipo di vettore è supportato solo per gli indici HNSW.
BINARY_VECTORUn campo vettoriale di questo tipo contiene un elenco di 0 e 1. Questi fungono da caratteristiche compatte per rappresentare i dati in scenari di elaborazione delle immagini e di recupero delle informazioni.
SPARSE_FLOAT_VECTORUn campo vettoriale di questo tipo contiene un elenco di numeri diversi da zero e i relativi numeri di sequenza per rappresentare embedding vettoriali sparsi.
Aggiungere campi scalari
Nei casi più comuni, è possibile utilizzare i campi scalari per memorizzare i metadati delle rappresentazioni vettoriali archiviate in Milvus ed eseguire ricerche ANN con filtraggio dei metadati per migliorare l’accuratezza dei risultati di ricerca. Milvus supporta diversi tipi di campi scalari, tra cui VARCHAR, Boolean, Int, Float e Double.
Aggiunta di campi VARCHAR
In Milvus è possibile utilizzare i campi ` VARCHAR ` per memorizzare stringhe. Per ulteriori informazioni sul campo ` VARCHAR `, consultare il documento Campo VarChar.
schema.add_field(
    field_name="my_varchar",
    datatype=DataType.VARCHAR,
    max_length=512
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_varchar")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .build());
schema.push({
    name: "my_varchar",
    data_type: DataType.VarChar,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_varchar").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(512),
)
export varCharField='{
    "fieldName": "my_varchar",
    "dataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField
    ]
}"
Aggiungere campi numerici
I tipi numerici supportati da Milvus sono Int8, Int16, Int32, Int64, Float e Double. Per ulteriori informazioni sui campi numerici, consultare il campo numerico.
schema.add_field(
    field_name="my_int64",
    datatype=DataType.INT64,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_int64")
        .dataType(DataType.Int64)
        .build());
schema.push({
    name: "my_int64",
    data_type: DataType.Int64,
});
schema.WithField(entity.NewField().WithName("my_int64").
    WithDataType(entity.FieldTypeInt64),
)
export int64Field='{
    "fieldName": "my_int64",
    "dataType": "Int64"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field
    ]
}"
Aggiunta di campi booleani
Milvus supporta i campi booleani. I seguenti frammenti di codice mostrano come aggiungere un campo booleano.
schema.add_field(
    field_name="my_bool",
    datatype=DataType.BOOL,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_bool")
        .dataType(DataType.Bool)
        .build());
schema.push({
    name: "my_bool",
    data_type: DataType.Boolean,
});
schema.WithField(entity.NewField().WithName("my_bool").
    WithDataType(entity.FieldTypeBool),
)
export boolField='{
    "fieldName": "my_bool",
    "dataType": "Boolean"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField
    ]
}"
Aggiungere campi compositi
In Milvus, un campo composito è un campo che può essere suddiviso in sottocampi più piccoli, come le chiavi in un campo JSON o gli indici in un campo Array.
Aggiungere campi JSON
Un campo JSON di solito memorizza dati JSON semi-strutturati. Per ulteriori informazioni sui campi JSON, consultare Campo JSON.
schema.add_field(
    field_name="my_json",
    datatype=DataType.JSON,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_json")
        .dataType(DataType.JSON)
        .build());
schema.push({
    name: "my_json",
    data_type: DataType.JSON,
});
schema.WithField(entity.NewField().WithName("my_json").
    WithDataType(entity.FieldTypeJSON),
)
export jsonField='{
    "fieldName": "my_json",
    "dataType": "JSON"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField
    ]
}"
Aggiungere campi array
Un campo array memorizza un elenco di elementi. I tipi di dati di tutti gli elementi in un campo array devono essere gli stessi. Per ulteriori informazioni sui campi array, consultare Campo array.
schema.add_field(
    field_name="my_array",
    datatype=DataType.ARRAY,
    element_type=DataType.VARCHAR,
    max_capacity=5,
    max_length=512,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_array")
        .dataType(DataType.Array)
        .elementType(DataType.VarChar)
        .maxCapacity(5)
        .maxLength(512)
        .build());
schema.push({
    name: "my_array",
    data_type: DataType.Array,
    element_type: DataType.VarChar,
    max_capacity: 5,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_array").
    WithDataType(entity.FieldTypeArray).
    WithElementType(entity.FieldTypeInt64).
    WithMaxLength(512).
    WithMaxCapacity(5),
)
export arrayField='{
    "fieldName": "my_array",
    "dataType": "Array",
    "elementDataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField,
        $arrayField
    ]
}"
