


Crea un sistema RAG con Milvus e Gemini
L'API Gemini e Google AI Studio ti aiutano a iniziare a lavorare con i modelli più recenti di Google e a trasformare le tue idee in applicazioni scalabili. Gemini offre accesso a potenti modelli linguistici come Gemini-2.5-Flash e Gemini-2.5-Pro per attività quali la generazione di testo, l’elaborazione di documenti, la visione, l’analisi audio e altro ancora. Offre inoltre Gemini Embedding 2, un modello di embedding multimodale che supporta testo, immagini, video, audio e documenti PDF con dimensioni di output flessibili tramite il Matryoshka Representation Learning. L’API consente di inserire contesti estesi con milioni di token, ottimizzare i modelli per attività specifiche, generare output strutturati come JSON e sfruttare funzionalità quali il recupero semantico e l’esecuzione di codice.
In questo tutorial vi mostreremo come costruire una pipeline RAG (Retrieval-Augmented Generation) con Milvus e Gemini. Utilizzeremo il modello Gemini per generare risposte basate su una determinata query, arricchite con informazioni rilevanti recuperate da Milvus.
Preparazione
Dipendenze e ambiente
Per prima cosa, installa i pacchetti necessari:
$ pip install --upgrade pymilvus milvus-lite google-genai requests tqdm
Se state utilizzando Google Colab, per abilitare le dipendenze appena installate potrebbe essere necessario riavviare il runtime (fate clic sul menu “Runtime” nella parte superiore dello schermo e selezionate “Riavvia sessione” dal menu a tendina).
È necessario innanzitutto effettuare l’accesso alla piattaforma Google AI Studio e impostare la chiave API GEMINI_API_KEY come variabile d’ambiente.
import os

os.environ["GEMINI_API_KEY"] = "***********"
Preparazione dei dati
Utilizziamo le pagine delle FAQ della Documentazione Milvus 2.4.x come conoscenza privata nel nostro RAG; si tratta di una buona fonte di dati per una semplice pipeline RAG.
Scaricare il file zip ed estrarre i documenti nella cartella milvus_docs.
$ wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip
$ unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
Carichiamo tutti i file Markdown dalla cartella milvus_docs/en/faq. Per ogni documento, utilizziamo semplicemente "# " per separare il contenuto del file, il che permette di suddividere approssimativamente il contenuto in ciascuna parte principale del file Markdown.
from glob import glob

text_lines = []

for file_path in glob("milvus_docs/en/faq/*.md", recursive=True):
    with open(file_path, "r") as file:
        file_text = file.read()

    text_lines += file_text.split("# ")
Preparazione del modello LLM e del modello di embedding
Utilizziamo gemini-2.5-flash come LLM e gemini-embedding-2-preview come modello di embedding. gemini-embedding-2-preview è l’ultimo modello di embedding multimodale di Google, che supporta testo, immagini, video, audio e documenti PDF con dimensioni di output flessibili (da 128 a 3.072) tramite il Matryoshka Representation Learning.
Proviamo a generare una risposta di prova dall’LLM:
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-2.5-flash", contents="who are you"
)
print(response.text)
I am a large language model, trained by Google.

I'm designed to process and generate human-like text based on the vast amount of data I was trained on. This allows me to:

*   Answer questions
*   Provide summaries
*   Generate creative content
*   Translate languages
*   And much more

I don't have personal experiences, feelings, or consciousness. I'm a tool designed to be helpful and informative.
Generiamo un embedding di prova e visualizziamo la sua dimensione e i primi elementi.
test_embeddings = client.models.embed_content(
    model="gemini-embedding-2-preview", contents=["This is a test1", "This is a test2"]
)

embedding_dim = len(test_embeddings.embeddings[0].values)
print(embedding_dim)
print(test_embeddings.embeddings[0].values[:10])
3072
[-0.016769307, 0.013630492, 0.020277105, 0.0035285393, 0.003968259, -0.013498845, 0.028525498, 0.025498547, -0.021553498, 0.015233516]
Caricare i dati in Milvus
Creare la collezione
Inizializziamo il client Milvus e configuriamo la nostra collezione:
from pymilvus import MilvusClient

milvus_client = MilvusClient(uri="./milvus_demo.db")

collection_name = "my_rag_collection"
Per quanto riguarda l’argomento ` MilvusClient`:
- Impostare
uricome file locale, ad esempio./milvus.db, è il metodo più pratico, poiché utilizza automaticamente Milvus Lite per memorizzare tutti i dati in questo file. - Se si dispone di grandi quantità di dati, è possibile configurare un server Milvus più performante su Docker o Kubernetes. In questa configurazione, utilizzare l’URI del server, ad esempio
http://localhost:19530, comeuri. - Se si desidera utilizzare Zilliz Cloud, il servizio cloud completamente gestito per Milvus, modificare i valori di `
uri` e `token`, che corrispondono rispettivamente all’endpoint pubblico e alla chiave API in Zilliz Cloud.
Verifica se la raccolta esiste già e, in tal caso, eliminala.
if milvus_client.has_collection(collection_name):
    milvus_client.drop_collection(collection_name)
Crea una nuova raccolta con i parametri specificati.
Se non si specificano informazioni sui campi, Milvus creerà automaticamente un campo predefinito id per la chiave primaria e un campo vector per memorizzare i dati vettoriali. Un campo JSON riservato viene utilizzato per memorizzare i campi non definiti dallo schema e i relativi valori.
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=embedding_dim,
    metric_type="IP",  # Inner product distance
    # Strong consistency waits for all loads to complete, adding latency with large datasets
    # consistency_level="Strong",  # Strong consistency level
)
Inserire i dati
Scorrere le righe di testo, creare gli embedding e quindi inserire i dati in Milvus.
Ecco un nuovo campo text, che è un campo non definito nello schema della collezione. Verrà automaticamente aggiunto al campo dinamico JSON riservato, che a livello generale può essere trattato come un campo normale.
from tqdm import tqdm

data = []

doc = client.models.embed_content(model="gemini-embedding-2-preview", contents=text_lines)

for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):
    data.append({"id": i, "vector": doc.embeddings[i].values, "text": line})

milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████| 72/72 [00:00<00:00, 337796.30it/s]


{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
Creazione di un RAG
Recuperare i dati per una query
Specifichiamo una domanda frequente su Milvus.
question = "How is data stored in milvus?"
Cercare la domanda nella collezione e recuperare i primi tre risultati semantici più pertinenti.
quest_embed = client.models.embed_content(model="gemini-embedding-2-preview", contents=question)

search_res = milvus_client.search(
    collection_name=collection_name,
    data=[quest_embed.embeddings[0].values],
    limit=3,  # Return top 3 results
    search_params={"metric_type": "IP", "params": {}},  # Inner product distance
    output_fields=["text"],  # Return the text field
)
Diamo un'occhiata ai risultati della ricerca
import json

retrieved_lines_with_distances = [
    (res["entity"]["text"], res["distance"]) for res in search_res[0]
]
print(json.dumps(retrieved_lines_with_distances, indent=4))
[
    [
        " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",
        0.864
    ],
    [
        "Why is there no vector data in etcd?\n\netcd stores Milvus module metadata; MinIO stores entities.",
        0.7923
    ],
    [
        "What is the maximum dataset size Milvus can handle?\n\n  \nTheoretically, the maximum dataset size Milvus can handle is determined by the hardware it is run on, specifically system memory and storage:\n\n- Milvus loads all specified collections and partitions into memory before running queries. Therefore, memory size determines the maximum amount of data Milvus can query.\n- When new entities and and collection-related schema (currently only MinIO is supported for data persistence) are added to Milvus, system storage determines the maximum allowable size of inserted data.\n\n###",
        0.7857
    ]
]
Utilizziamo un modello LLM per ottenere una risposta RAG
Convertiamo i documenti recuperati in formato stringa.
context = "\n".join(
    [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances]
)
Definiamo i prompt di sistema e utente per il modello linguistico. Questo prompt viene assemblato con i documenti recuperati da Milvus.
from google.genai import types

SYSTEM_PROMPT = """
Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided.
"""
USER_PROMPT = f"""
Use the following pieces of information enclosed in <context> tags to provide an answer to the question enclosed in <question> tags.
<context>
{context}
</context>
<question>
{question}
</question>
"""
Utilizza Gemini per generare una risposta basata sui prompt.
response = client.models.generate_content(
    model="gemini-2.5-flash",
    config=types.GenerateContentConfig(system_instruction=SYSTEM_PROMPT),
    contents=USER_PROMPT,
)
print(response.text)
Milvus stores data in two main ways:

1.  **Inserted Data:** This includes vector data, scalar data, and collection-specific schema. This type of data is stored in persistent storage as an incremental log. Milvus supports various object storage backends for this, such as MinIO, AWS S3, Google Cloud Storage (GCS), Azure Blob Storage, Alibaba Cloud OSS, and Tencent Cloud Object Storage (COS).
2.  **Metadata:** Metadata is generated within Milvus by its various modules. Each module's metadata is stored in etcd.
Ricerca multimodale
Poiché l'gemini-embedding-2-preview a mappa testo, immagini e altre modalità nello stesso spazio di embedding, è possibile eseguire ricerche cross-modali — ad esempio, utilizzando una query testuale per trovare le immagini più pertinenti.
Preparazione dei dati immagine
Scarichiamo una serie di diagrammi dell’architettura RAG dal repository del Milvus Bootcamp da utilizzare come nostro set di dati di immagini.
import urllib.request
from pathlib import Path

image_dir = Path("images")
image_dir.mkdir(exist_ok=True)

image_files = [
    "vanilla_rag.png",
    "hyde.png",
    "query_routing.png",
    "self_reflection.png",
    "hybrid_and_rerank.png",
    "hierarchical_index.png",
]

base_url = "https://raw.githubusercontent.com/milvus-io/bootcamp/master/pics/advanced_rag/"

for fname in image_files:
    path = image_dir / fname
    if not path.exists():
        urllib.request.urlretrieve(base_url + fname, path)
        print(f"Downloaded {fname}")
    else:
        print(f"Already exists {fname}")

print(f"\nTotal images: {len(image_files)}")
Downloaded vanilla_rag.png
Downloaded hyde.png
Downloaded query_routing.png
Downloaded self_reflection.png
Downloaded hybrid_and_rerank.png
Downloaded hierarchical_index.png

Total images: 6
Incorporare le immagini e memorizzarle in Milvus
Leggiamo ogni immagine come byte e la passiamo a gemini-embedding-2-preview per generare gli embedding, quindi li archiviamo in una nuova collezione Milvus.
from google.genai import types

image_data = []

for fname in image_files:
    path = image_dir / fname
    with open(path, "rb") as f:
        image_bytes = f.read()

    result = client.models.embed_content(
        model="gemini-embedding-2-preview",
        contents=types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
    )
    image_data.append(
        {
            "id": len(image_data),
            "vector": result.embeddings[0].values,
            "filename": fname,
        }
    )
    print(f"Embedded {fname}")

# Create a new collection for images
image_collection = "image_collection"
if milvus_client.has_collection(image_collection):
    milvus_client.drop_collection(image_collection)

milvus_client.create_collection(
    collection_name=image_collection,
    dimension=len(image_data[0]["vector"]),
    metric_type="IP",
)

milvus_client.insert(collection_name=image_collection, data=image_data)
print(f"\nInserted {len(image_data)} image embeddings (dim={len(image_data[0]['vector'])})")
Embedded vanilla_rag.png
Embedded hyde.png
Embedded query_routing.png
Embedded self_reflection.png
Embedded hybrid_and_rerank.png
Embedded hierarchical_index.png

Inserted 6 image embeddings (dim=3072)
Ricerca cross-modale: query testuale → risultati immagine
Ora utilizziamo una query testuale per effettuare una ricerca tra le rappresentazioni delle immagini. Poiché sia il testo che le immagini sono mappati nello stesso spazio di rappresentazione, possiamo confrontarli direttamente.
from IPython.display import display, Image

text_queries = [
    "How does a basic RAG pipeline work?",
    "What is the hypothetical document embedding approach?",
    "How to combine hybrid search with reranking?",
]

for query in text_queries:
    query_embed = client.models.embed_content(
        model="gemini-embedding-2-preview", contents=query
    )

    results = milvus_client.search(
        collection_name=image_collection,
        data=[query_embed.embeddings[0].values],
        limit=1,
        search_params={"metric_type": "IP", "params": {}},
        output_fields=["filename"],
    )

    best = results[0][0]
    print(f"\nQuery: {query}")
    print(f"Match: {best['entity']['filename']} (score: {best['distance']:.4f})")
    display(Image(filename=str(image_dir / best["entity"]["filename"]), width=600))
Query: How does a basic RAG pipeline work?
Match: vanilla_rag.png (score: 0.5132)
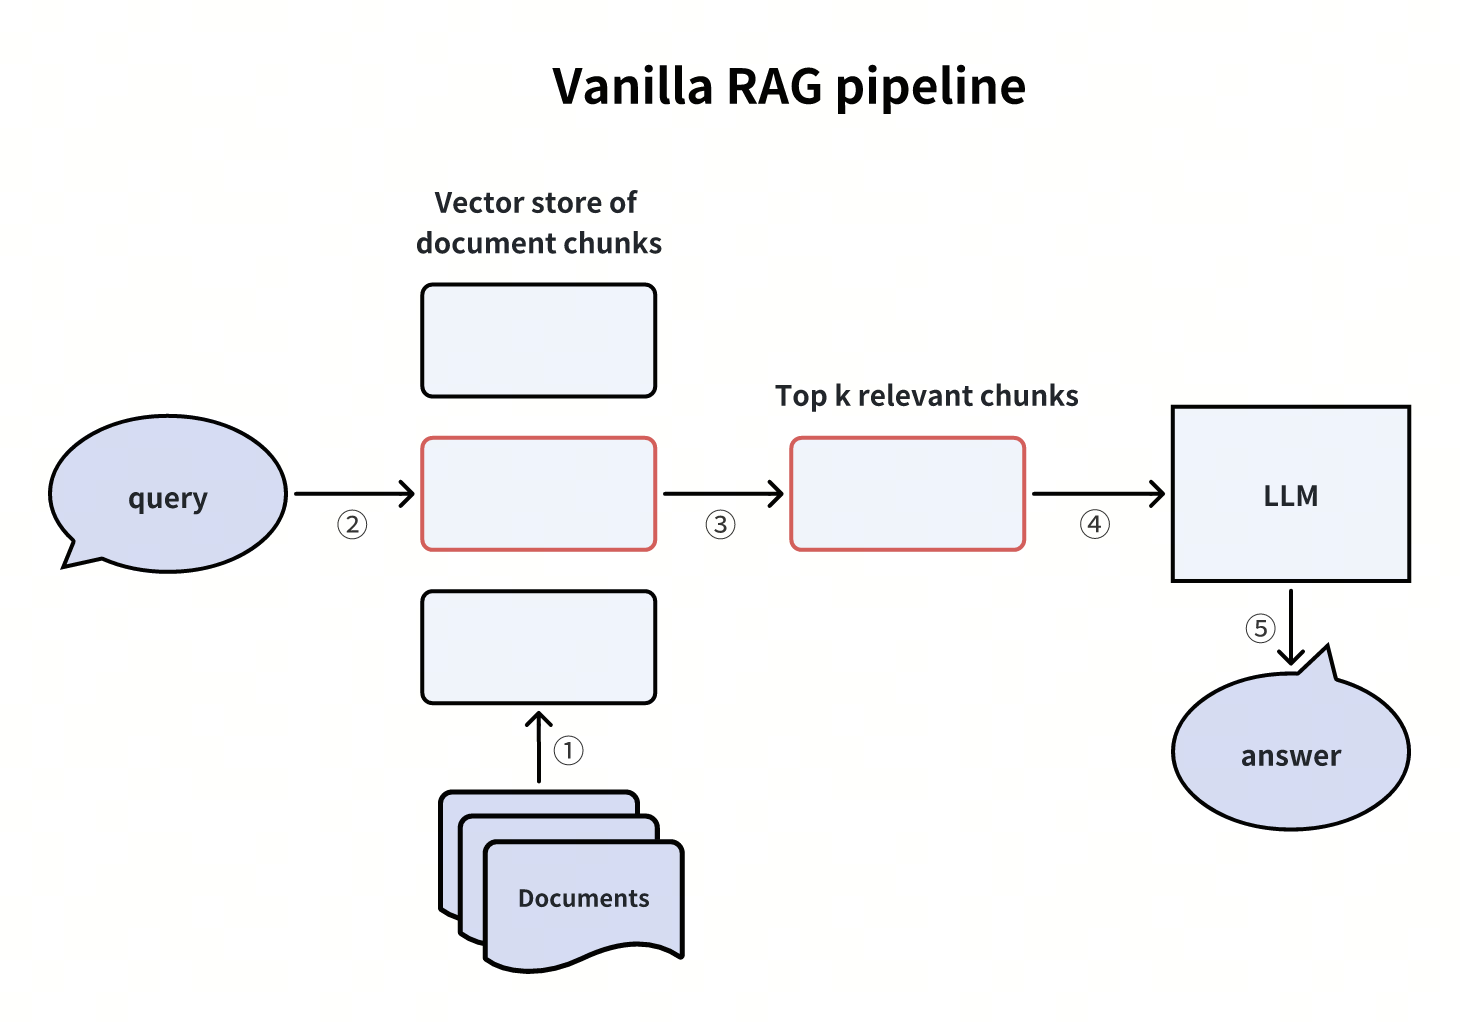 Pipeline RAG standard
Query: What is the hypothetical document embedding approach?
Match: hyde.png (score: 0.4756)
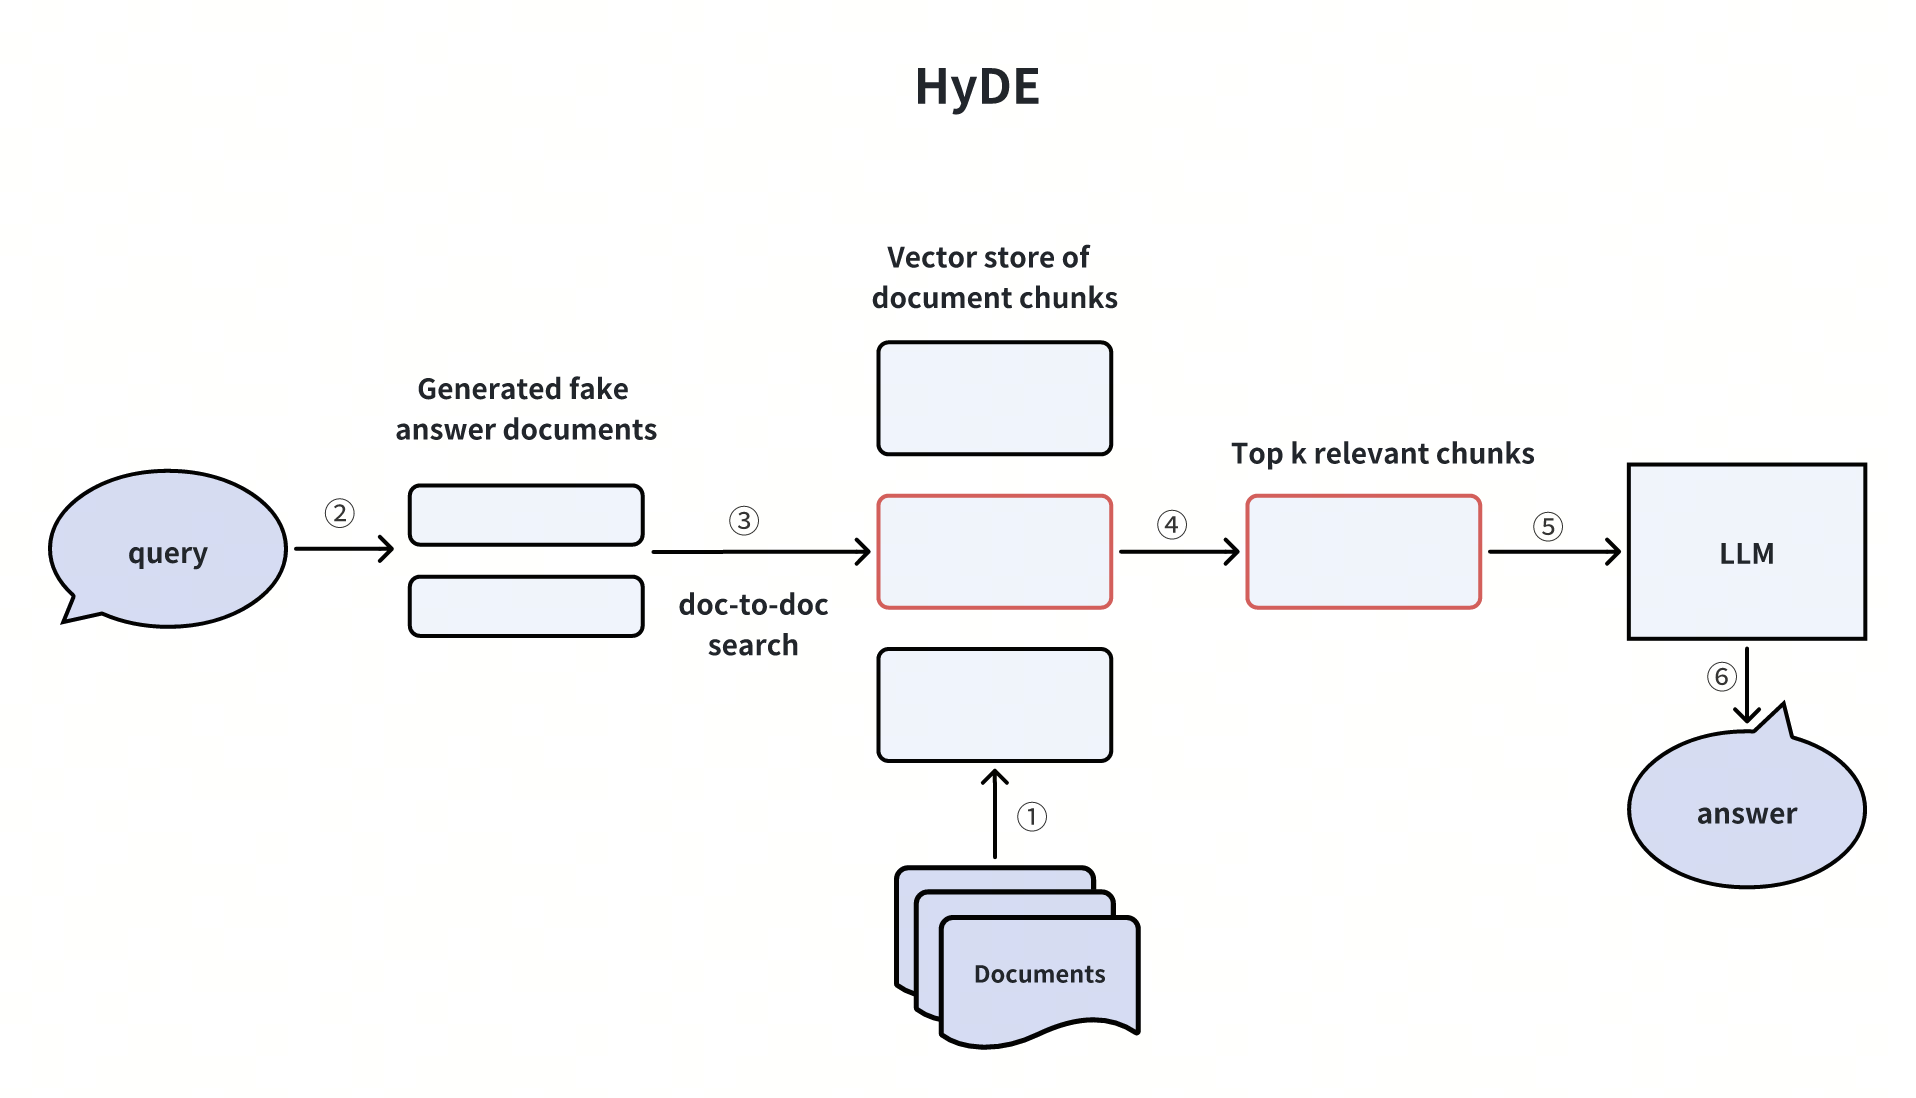 HyDE
Query: How to combine hybrid search with reranking?
Match: hybrid_and_rerank.png (score: 0.5271)
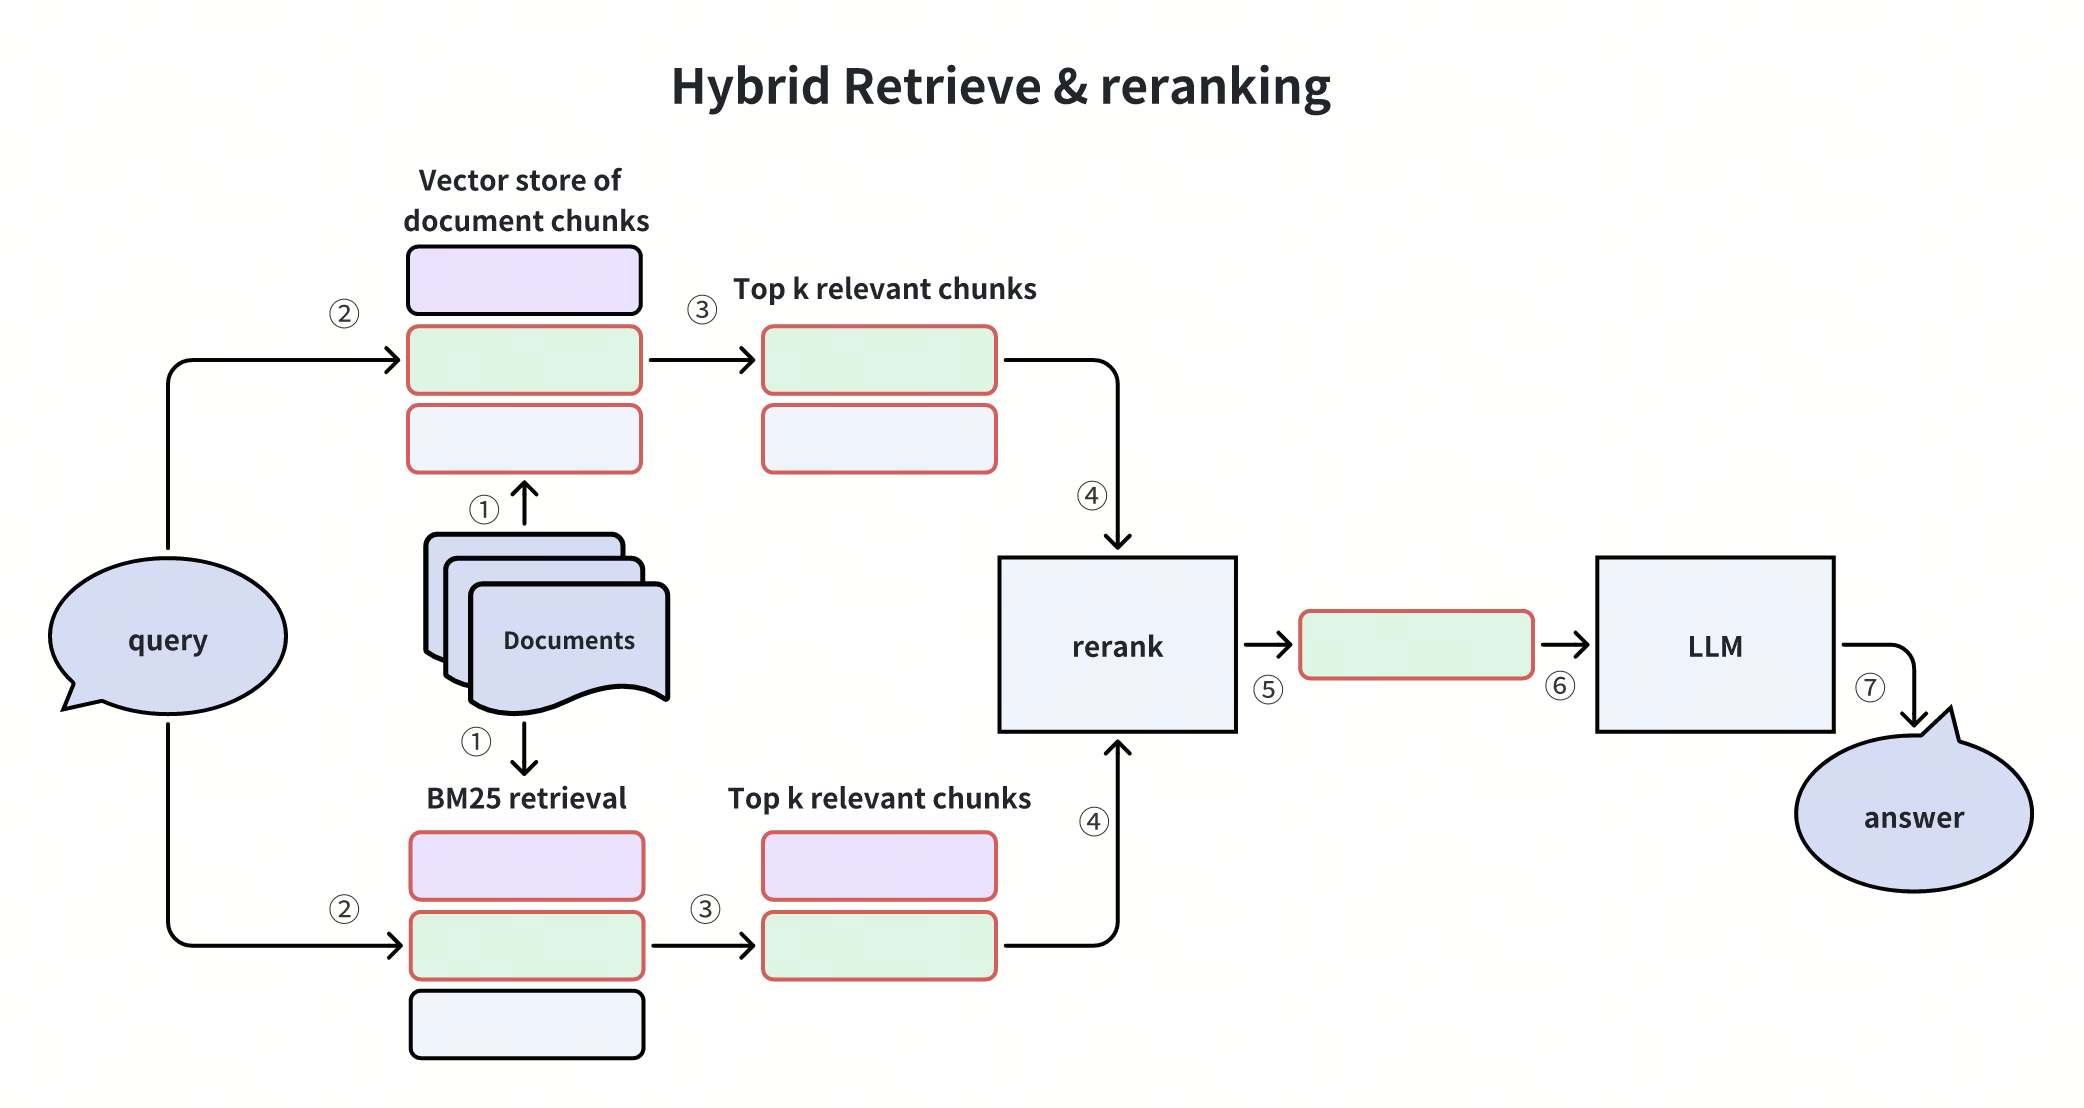 Recupero e riclassificazione ibridi
Ottimo! Abbiamo creato con successo una pipeline RAG con Milvus e Gemini e abbiamo dimostrato la ricerca cross-modale utilizzando query testuali per recuperare immagini pertinenti — il tutto grazie allo spazio di embedding unificato di gemini-embedding-2-preview.
