

Metrik Kemiripan
Di Milvus, metrik kemiripan digunakan untuk mengukur kemiripan di antara vektor. Memilih metrik jarak yang baik dapat membantu meningkatkan kinerja klasifikasi dan pengelompokan secara signifikan.
Tabel berikut menunjukkan bagaimana metrik kemiripan yang banyak digunakan ini sesuai dengan berbagai bentuk data input dan indeks Milvus. Saat ini, Milvus mendukung berbagai jenis data, termasuk penyisipan titik mengambang (sering dikenal sebagai vektor titik mengambang atau vektor padat), penyisipan biner (juga dikenal sebagai vektor biner), dan penyisipan jarang (juga dikenal sebagai vektor jarang).
| Jenis Metrik | Jenis Indeks |
|---|---|
|
|
| Jenis Metrik | Jenis Indeks |
|---|---|
|
|
| Jenis Metrik | Jenis Indeks |
|---|---|
| IP |
|
Jarak Euclidean (L2)
Pada dasarnya, jarak Euclidean mengukur panjang segmen yang menghubungkan 2 titik.
Rumus untuk jarak Euclidean adalah sebagai berikut:
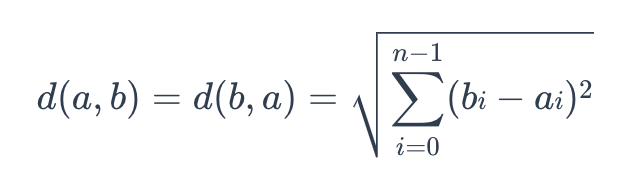 euclidean
di mana a = (a0, a1, ...,an-1) dan b = (b0, b0, ..., bn-1) adalah dua titik dalam ruang Euclidean n-dimensi
Ini adalah metrik jarak yang paling umum digunakan dan sangat berguna ketika datanya kontinu.
Produk dalam (IP)
Jarak IP antara dua penyisipan vektor didefinisikan sebagai berikut:
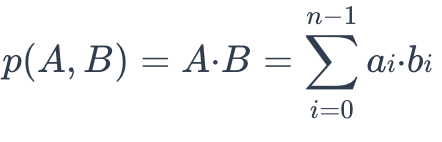 ip
IP lebih berguna jika Anda perlu membandingkan data yang tidak dinormalisasi atau ketika Anda peduli dengan besaran dan sudut.
Jika Anda menerapkan metrik jarak IP pada embedding yang dinormalisasi, hasilnya akan setara dengan menghitung kemiripan kosinus di antara embedding.
Misalkan X' dinormalisasi dari penyematan X:
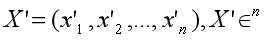 normalisasi
Korelasi antara kedua penyematan adalah sebagai berikut:
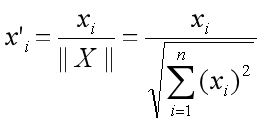 normalisasi
Kesamaan Kosinus
Kesamaan kosinus menggunakan kosinus sudut antara dua set vektor untuk mengukur seberapa mirip mereka. Anda dapat membayangkan dua set vektor sebagai dua segmen garis yang dimulai dari titik awal yang sama ([0,0,...]) tetapi mengarah ke arah yang berbeda.
Untuk menghitung kemiripan kosinus antara dua set vektor A = (a0, a1,...,an-1) dan B = (b0, b1,..., bn-1), gunakan rumus berikut:
 cosinus_similaritas
Kemiripan kosinus selalu berada dalam interval [-1, 1]. Sebagai contoh, dua vektor proporsional memiliki kemiripan kosinus 1, dua vektor ortogonal memiliki kemiripan 0, dan dua vektor yang berlawanan memiliki kemiripan -1. Semakin besar kosinus, semakin kecil sudut antara dua vektor, yang mengindikasikan bahwa dua vektor tersebut semakin mirip satu sama lain.
Dengan mengurangkan kemiripan kosinusnya dari 1, Anda bisa mendapatkan jarak kosinus antara dua vektor.
Jarak Jaccard
Koefisien kemiripan Jaccard mengukur kemiripan antara dua set sampel dan didefinisikan sebagai kardinalitas perpotongan set yang ditentukan dibagi dengan kardinalitas gabungan keduanya. Ini hanya dapat diterapkan pada set sampel yang terbatas.
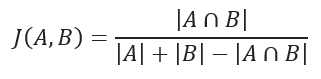 Koefisien kesamaan Jaccard
Jarak Jaccard mengukur ketidaksamaan antara kumpulan data dan diperoleh dengan mengurangi koefisien kemiripan Jaccard dari 1. Untuk variabel biner, jarak Jaccard setara dengan koefisien Tanimoto.
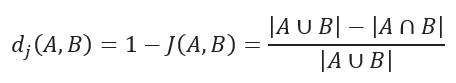 Jarak Jaccard
Jarak Hamming
Jarak Hamming mengukur string data biner. Jarak antara dua string dengan panjang yang sama adalah jumlah posisi bit di mana bit-bit tersebut berbeda.
Sebagai contoh, misalkan ada dua string, 1101 1001 dan 1001 1101.
11011001 ⊕ 10011101 = 01000100. Karena ini mengandung dua angka 1, maka jarak Hamming, d (11011001, 10011101) = 2.
Kesamaan Struktural
Ketika sebuah struktur kimia muncul sebagai bagian dari struktur kimia yang lebih besar, yang pertama disebut substruktur dan yang terakhir disebut superstruktur. Sebagai contoh, etanol adalah substruktur dari asam asetat, dan asam asetat adalah superstruktur dari etanol.
Kemiripan struktural digunakan untuk menentukan apakah dua rumus kimia mirip satu sama lain, yang satu merupakan superstruktur atau substruktur dari yang lain.
Untuk menentukan apakah A adalah superstruktur dari B, gunakan rumus berikut:
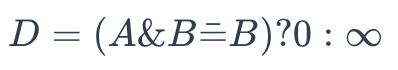 superstruktur
Dimana:
- A adalah representasi biner dari rumus kimia yang akan diambil
- B adalah representasi biner dari rumus kimia dalam basis data
Setelah mengembalikan 0, A bukan merupakan superstruktur dari B. Jika tidak, hasilnya adalah sebaliknya.
Untuk menentukan apakah A adalah sebuah substruktur dari B, gunakan rumus berikut:
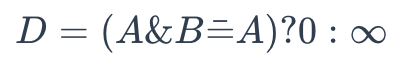 substruktur
Dimana:
- A adalah representasi biner dari rumus kimia yang akan diambil
- B adalah representasi biner dari rumus kimia dalam database
Setelah mengembalikan 0, A bukan merupakan substruktur dari B. Jika tidak, hasilnya adalah sebaliknya.
FAQ
Mengapa hasil pencarian vektor teratas bukan vektor pencarian itu sendiri, jika jenis metriknya adalah inner product?
Ini terjadi jika Anda belum menormalkan vektor saat menggunakan inner product sebagai metrik jarak.Apa yang dimaksud dengan normalisasi? Mengapa normalisasi diperlukan?
Normalisasi mengacu pada proses mengubah embedding (vektor) sehingga normalnya sama dengan 1. Jika Anda menggunakan Inner Product untuk menghitung kemiripan embedding, Anda harus menormalkan embedding Anda. Setelah normalisasi, inner product sama dengan kemiripan kosinus.
Lihat Wikipedia untuk informasi lebih lanjut.
Mengapa saya mendapatkan hasil yang berbeda dengan menggunakan jarak Euclidean (L2) dan inner product (IP) sebagai metrik jarak?
Periksa apakah vektor sudah dinormalisasi.
Jika tidak, Anda perlu menormalkan vektor terlebih dahulu. Secara teoritis, kemiripan yang dihasilkan oleh L2 berbeda dengan kemiripan yang dihasilkan oleh IP, jika vektor-vektornya tidak dinormalisasi.Apa selanjutnya
- Pelajari lebih lanjut tentang jenis indeks yang didukung di Milvus.
