

Vektor Padat
Vektor padat adalah representasi data numerik yang banyak digunakan dalam pembelajaran mesin dan analisis data. Vektor ini terdiri dari larik bilangan real, di mana sebagian besar atau seluruh elemennya tidak nol. Dibandingkan dengan vektor jarang, vektor padat mengandung lebih banyak informasi pada tingkat dimensi yang sama, karena setiap dimensi menyimpan nilai yang bermakna. Representasi ini dapat secara efektif menangkap pola dan hubungan yang kompleks, sehingga data lebih mudah dianalisis dan diproses dalam ruang berdimensi tinggi. Vektor padat biasanya memiliki jumlah dimensi yang tetap, berkisar dari beberapa lusin hingga beberapa ratus atau bahkan ribuan, tergantung pada aplikasi dan persyaratan spesifik.
Vektor padat terutama digunakan dalam skenario yang memerlukan pemahaman semantik data, seperti pencarian semantik dan sistem rekomendasi. Dalam pencarian semantik, vektor padat membantu menangkap hubungan mendasar antara kueri dan dokumen, sehingga meningkatkan relevansi hasil pencarian. Dalam sistem rekomendasi, vektor padat membantu mengidentifikasi kesamaan antara pengguna dan item, sehingga menawarkan saran yang lebih dipersonalisasi.
Gambaran Umum
Vektor padat biasanya direpresentasikan sebagai array bilangan floating-point dengan panjang tetap, seperti [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. Dimensi vektor-vektor ini biasanya berkisar dari ratusan hingga ribuan, seperti 128, 256, 768, atau 1024. Setiap dimensi menangkap fitur semantik spesifik dari suatu objek, sehingga dapat diterapkan pada berbagai skenario melalui perhitungan kesamaan.
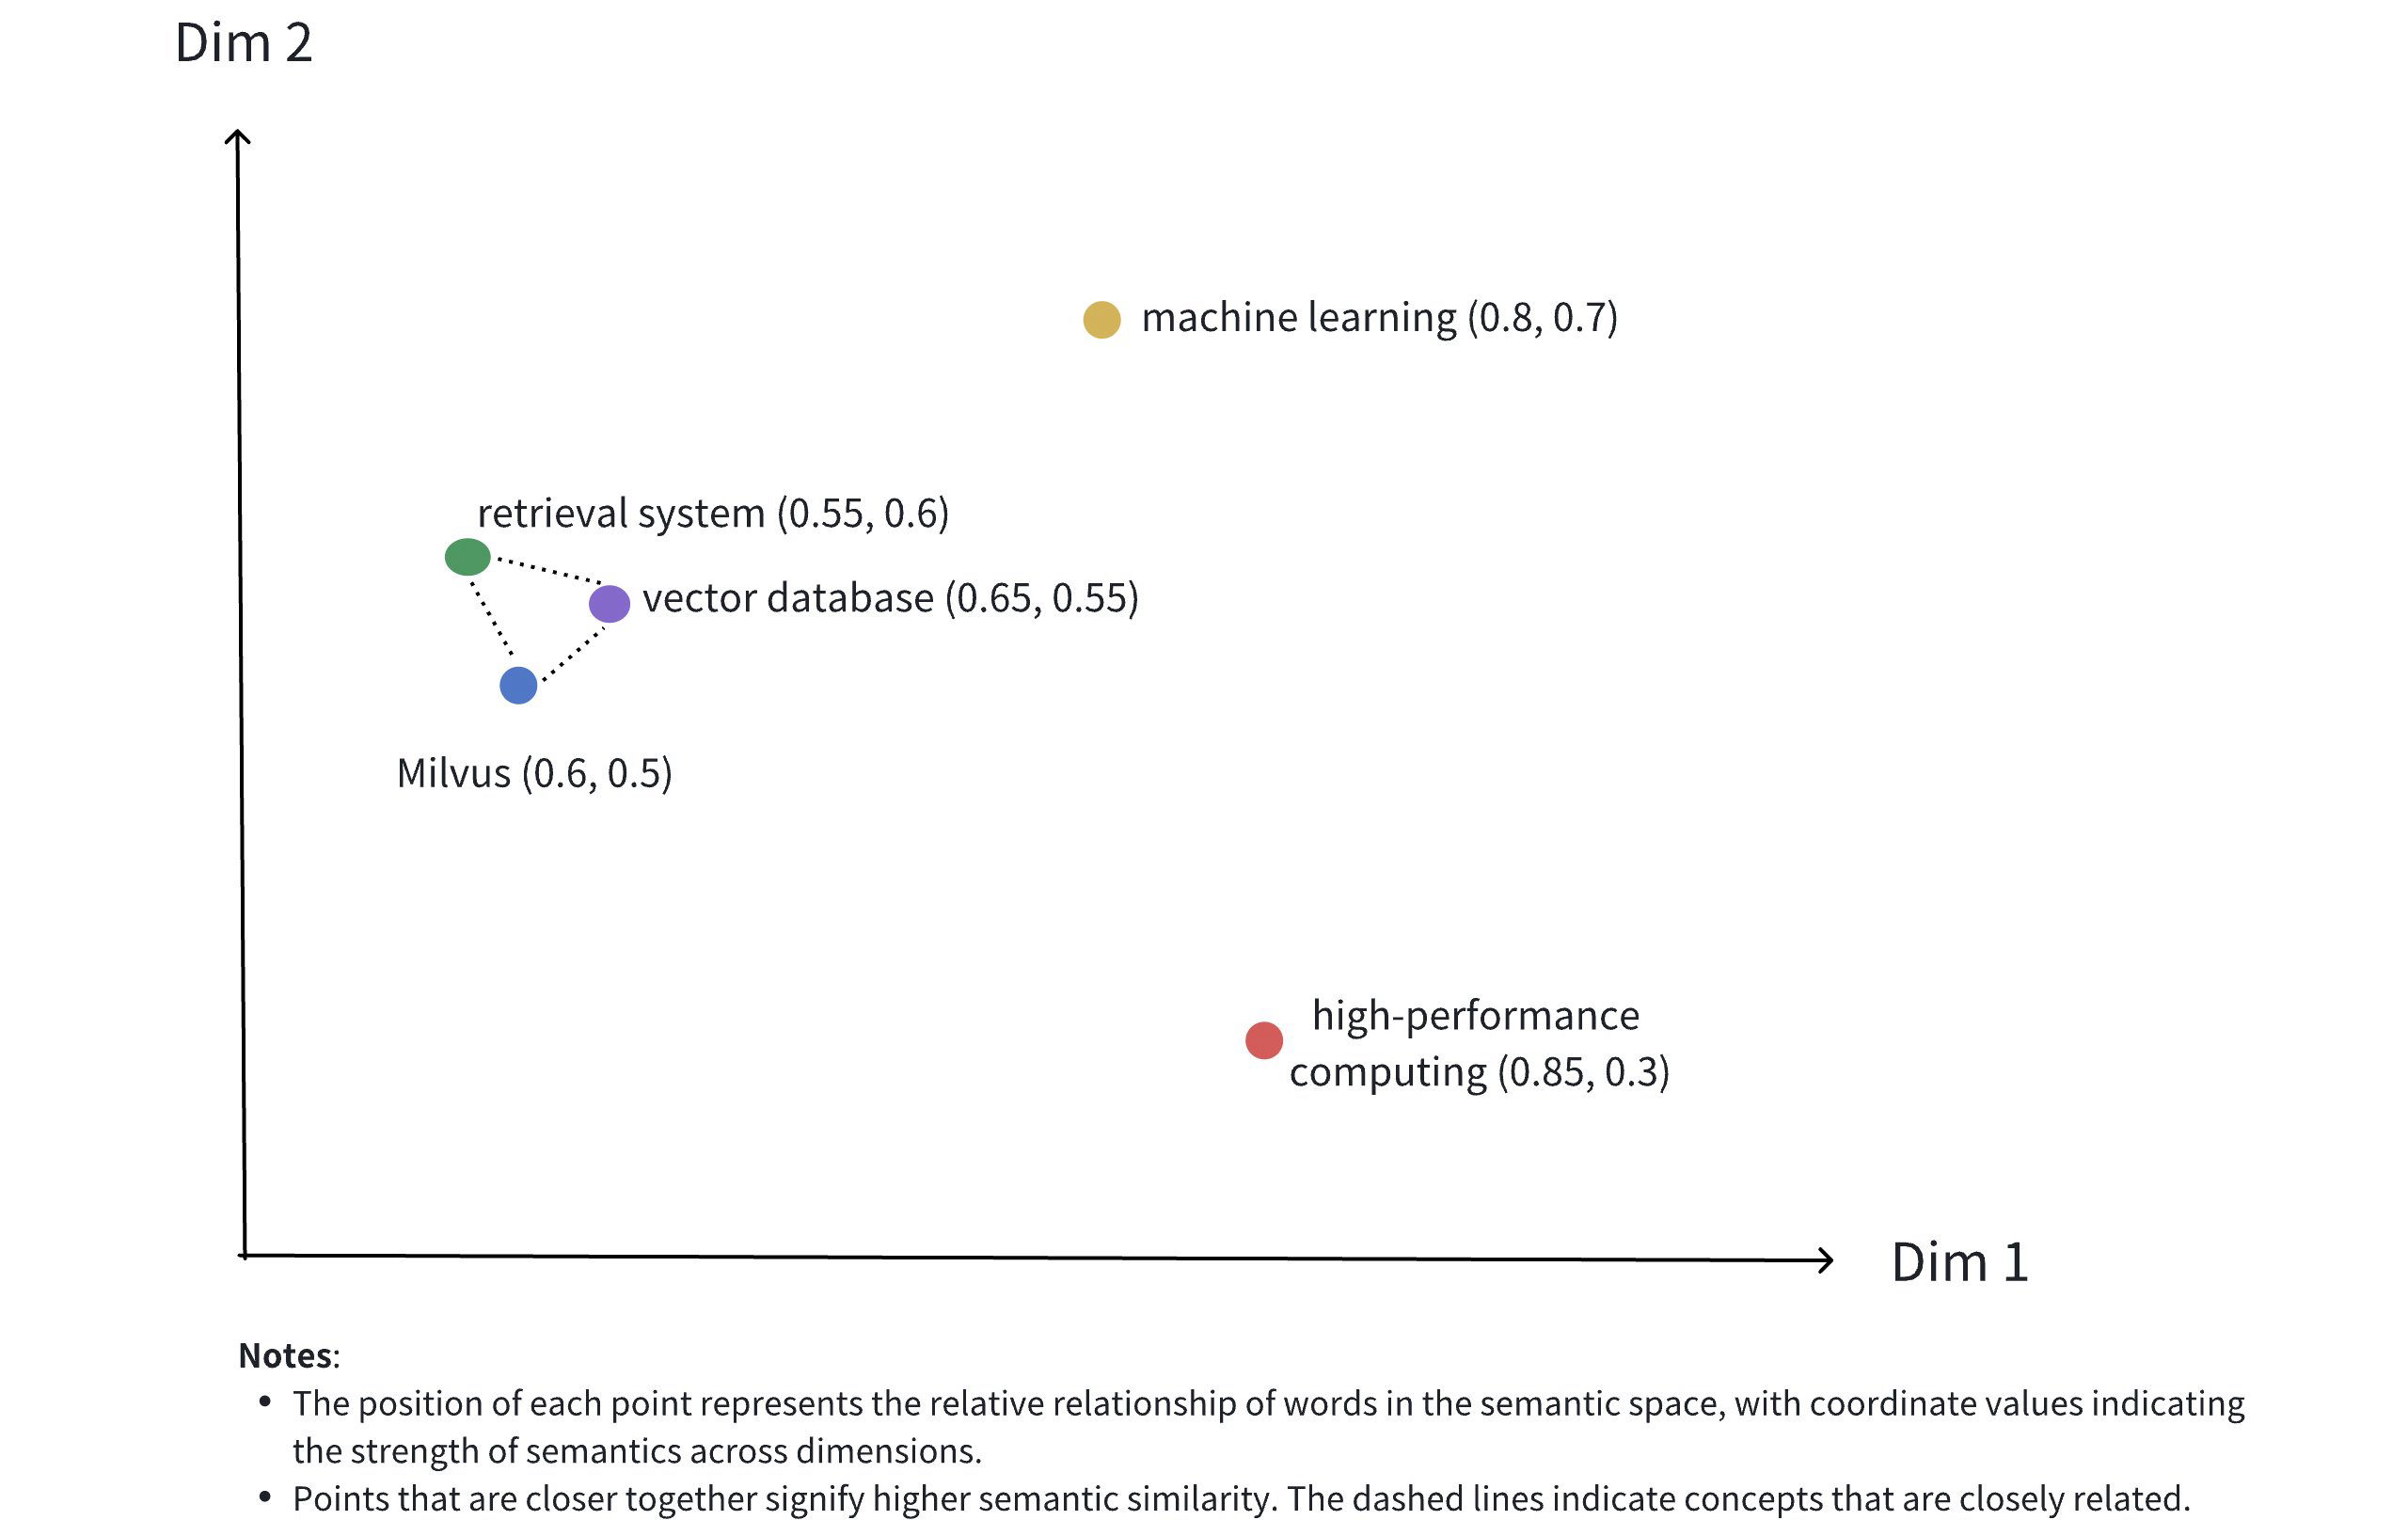 Vektor Padat
Gambar di atas menggambarkan representasi vektor padat dalam ruang 2D. Meskipun vektor padat dalam aplikasi dunia nyata seringkali memiliki dimensi yang jauh lebih tinggi, ilustrasi 2D ini secara efektif menyampaikan beberapa konsep kunci:
Representasi Multidimensi: Setiap titik mewakili objek konseptual (seperti Milvus, basis data vektor, sistem pencarian, dll.), dengan posisinya ditentukan oleh nilai-nilai dimensinya.
Hubungan Semantik: Jarak antar titik mencerminkan kemiripan semantik antar konsep. Titik yang lebih dekat menunjukkan konsep yang lebih terkait secara semantik.
Efek Pengelompokan: Konsep-konsep yang terkait (seperti Milvus, basis data vektor, dan sistem pencarian) ditempatkan berdekatan satu sama lain dalam ruang, membentuk sebuah kelompok semantik.
Di bawah ini adalah contoh vektor padat nyata yang mewakili teks “ "Milvus is an efficient vector database" ”:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
Vektor padat dapat dihasilkan menggunakan berbagai model embedding, seperti model CNN (seperti ResNet, VGG) untuk gambar dan model bahasa (seperti BERT, Word2Vec) untuk teks. Model-model ini mengubah data mentah menjadi titik-titik di ruang berdimensi tinggi, menangkap fitur semantik dari data tersebut. Selain itu, Milvus menawarkan metode praktis untuk membantu pengguna menghasilkan dan memproses vektor padat, sebagaimana dijelaskan dalam Embeddings.
Setelah data divektorisasi, data tersebut dapat disimpan di Milvus untuk pengelolaan dan pengambilan vektor. Diagram di bawah ini menunjukkan proses dasarnya.
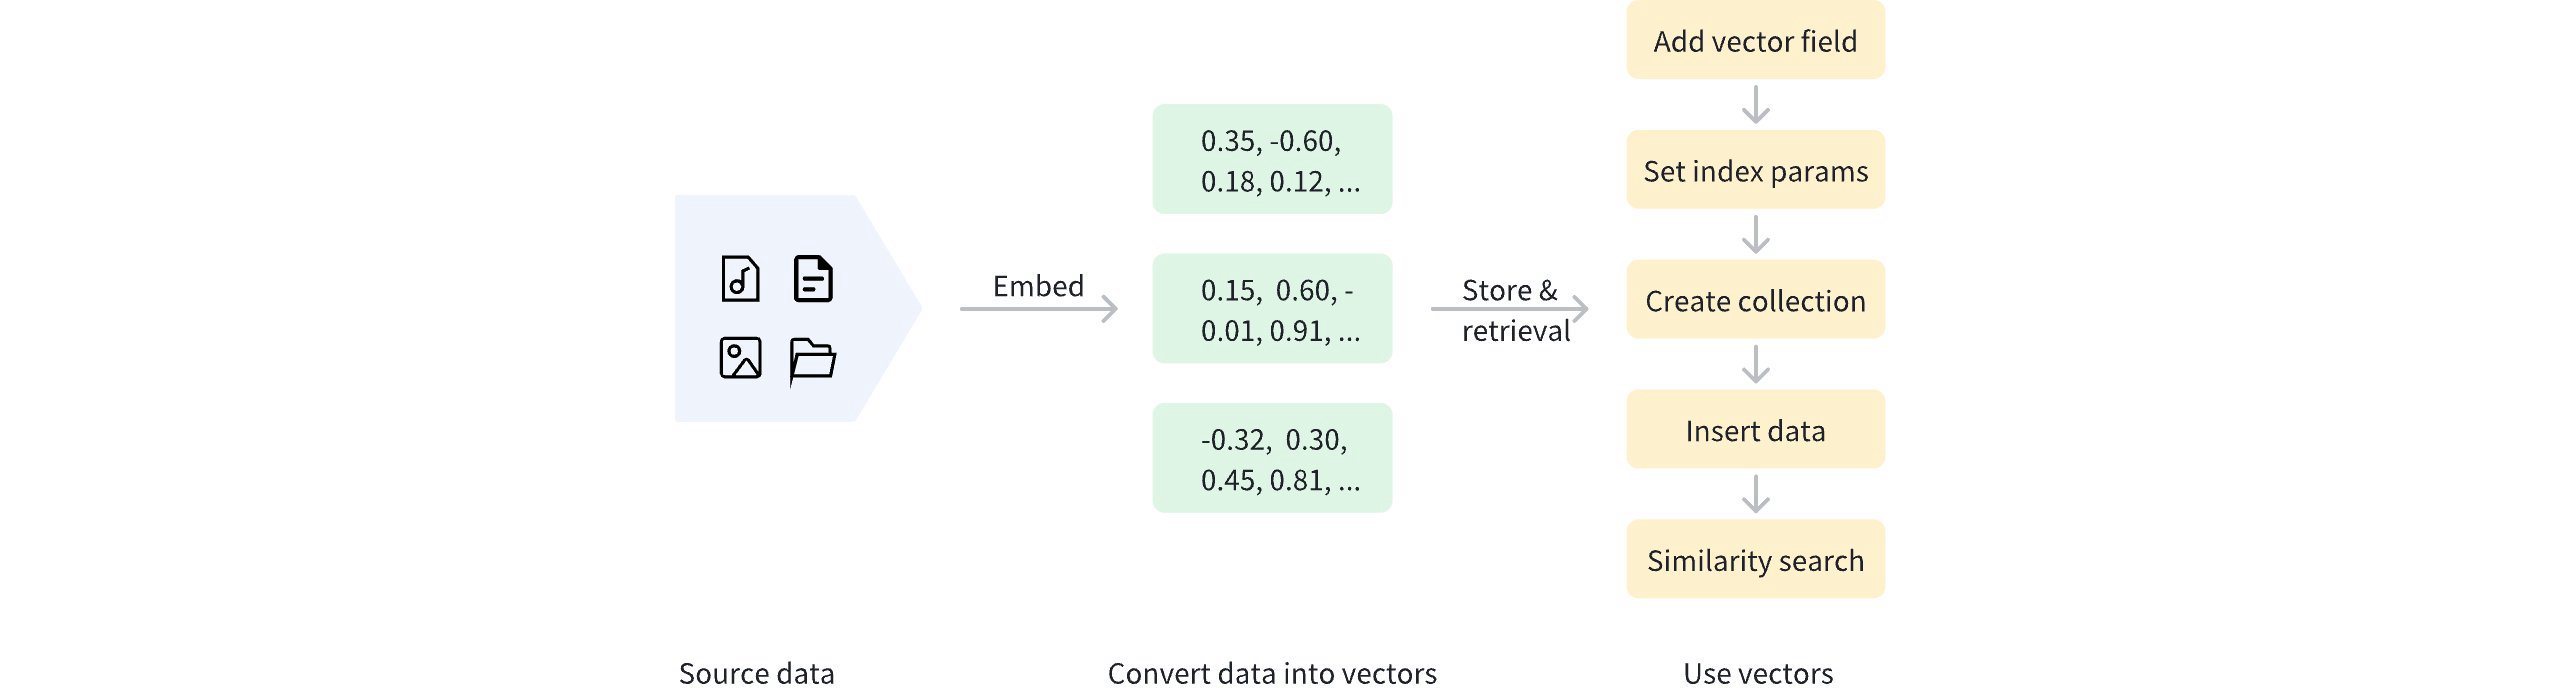 Gunakan Vektor Padat
Selain vektor padat, Milvus juga mendukung vektor jarang dan vektor biner. Vektor jarang cocok untuk pencocokan yang tepat berdasarkan istilah tertentu, seperti pencarian kata kunci dan pencocokan istilah, sedangkan vektor biner umumnya digunakan untuk menangani data biner secara efisien, seperti pencocokan pola gambar dan aplikasi hashing tertentu. Untuk informasi lebih lanjut, lihat Vektor Biner dan Vektor Jarang.
Gunakan vektor padat
Tambahkan bidang vektor
Untuk menggunakan vektor padat di Milvus, pertama-tama tentukan bidang vektor untuk menyimpan vektor padat saat membuat koleksi. Proses ini meliputi:
Menetapkan `
datatype` ke tipe data vektor padat yang didukung. Untuk tipe data vektor padat yang didukung, lihat Tipe Data.Menentukan dimensi vektor padat menggunakan parameter `
dim`.
Pada contoh di bawah ini, kami menambahkan bidang vektor bernama dense_vector untuk menyimpan vektor padat. Tipe data bidang tersebut adalah FLOAT_VECTOR, dengan dimensi 4.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Tipe data yang didukung untuk bidang vektor padat:
Tipe Data |
Deskripsi |
|---|---|
|
Menyimpan bilangan floating-point 32-bit, yang umumnya digunakan untuk merepresentasikan bilangan real dalam komputasi ilmiah dan pembelajaran mesin. Ideal untuk skenario yang membutuhkan presisi tinggi, seperti membedakan vektor yang serupa. |
|
Menyimpan bilangan floating-point presisi setengah 16-bit, digunakan untuk pembelajaran mendalam dan perhitungan GPU. Ini menghemat ruang penyimpanan dalam skenario di mana presisi kurang kritis, seperti pada fase recall presisi rendah dalam sistem rekomendasi. |
|
Menyimpan bilangan Brain Floating Point (bfloat16) 16-bit, yang menawarkan rentang eksponen yang sama dengan Float32 tetapi dengan presisi yang lebih rendah. Cocok untuk skenario yang perlu memproses vektor dalam jumlah besar dengan cepat, seperti pencarian gambar skala besar. |
|
Menyimpan vektor yang elemen individualnya di setiap dimensi berupa bilangan bulat 8-bit (int8), dengan setiap elemen berkisar antara –128 hingga 127. Dirancang untuk model pembelajaran mendalam yang dikuantisasi (misalnya, ResNet, EfficientNet), INT8_VECTOR mengurangi ukuran model dan mempercepat inferensi dengan kehilangan presisi minimal. |
Tetapkan parameter indeks untuk bidang vektor
Untuk mempercepat pencarian semantik, indeks harus dibuat untuk bidang vektor. Pengindeksan dapat secara signifikan meningkatkan efisiensi pencarian data vektor berskala besar.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
Pada contoh di atas, sebuah indeks bernama ` dense_vector_index ` dibuat untuk bidang ` dense_vector ` menggunakan tipe indeks ` AUTOINDEX `. Nilai ` metric_type ` diatur ke ` IP`, yang menunjukkan bahwa produk dalam akan digunakan sebagai metrik jarak.
Milvus menyediakan berbagai jenis indeks untuk pengalaman pencarian vektor yang lebih baik. AUTOINDEX adalah jenis indeks khusus yang dirancang untuk mempermudah proses pembelajaran dalam pencarian vektor. Terdapat banyak jenis indeks yang tersedia untuk Anda pilih. Untuk detailnya, lihat Penjelasan Indeks.
Milvus mendukung jenis metrik lainnya. Untuk informasi lebih lanjut, lihat " Jenis Metrik".
Buat koleksi
Setelah pengaturan vektor padat dan parameter indeks selesai, Anda dapat membuat koleksi yang berisi vektor padat. Contoh di bawah ini menggunakan metode ` create_collection ` untuk membuat koleksi bernama ` my_collection`.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Sisipkan data
Setelah membuat koleksi, gunakan metode ` insert ` untuk menambahkan data yang berisi vektor padat. Pastikan dimensi vektor padat yang dimasukkan sesuai dengan nilai ` dim ` yang ditentukan saat menambahkan bidang vektor padat.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
Melakukan pencarian kesamaan
Pencarian semantik berdasarkan vektor padat merupakan salah satu fitur inti Milvus, yang memungkinkan Anda menemukan data yang paling mirip dengan vektor kueri berdasarkan jarak antar vektor. Untuk melakukan pencarian kemiripan, siapkan vektor kueri dan parameter pencarian, lalu panggil metode ` search `.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
Untuk informasi lebih lanjut mengenai parameter pencarian kesamaan, lihat Pencarian ANN Dasar.
