


Bangun RAG dengan Milvus dan Gemini
API Gemini dan Google AI Studio membantu Anda mulai bekerja dengan model-model terbaru Google dan mengubah ide-ide Anda menjadi aplikasi yang dapat diskalakan. Gemini menyediakan akses ke model bahasa yang kuat seperti Gemini-2.5-Flash dan Gemini-2.5-Pro untuk tugas-tugas seperti pembuatan teks, pemrosesan dokumen, penglihatan, analisis audio, dan banyak lagi. Gemini juga menawarkan Gemini Embedding 2, model embedding multimodal yang mendukung teks, gambar, video, audio, dan dokumen PDF dengan dimensi keluaran yang fleksibel melalui Matryoshka Representation Learning. API ini memungkinkan Anda memasukkan konteks panjang dengan jutaan token, menyesuaikan model untuk tugas-tugas spesifik, menghasilkan keluaran terstruktur seperti JSON, serta memanfaatkan kemampuan seperti pencarian semantik dan eksekusi kode.
Dalam tutorial ini, kami akan menunjukkan kepada Anda cara membangun pipa RAG (Retrieval-Augmented Generation) dengan Milvus dan Gemini. Kami akan menggunakan model Gemini untuk menghasilkan respons berdasarkan kueri yang diberikan, yang dilengkapi dengan informasi relevan yang diambil dari Milvus.
Persiapan
Ketergantungan dan Lingkungan
Pertama, instal paket yang diperlukan:
$ pip install --upgrade pymilvus milvus-lite google-genai requests tqdm
Jika Anda menggunakan Google Colab, untuk mengaktifkan dependensi yang baru saja diinstal, Anda mungkin perlu me-restart runtime (klik menu “Runtime” di bagian atas layar, lalu pilih “Restart session” dari menu dropdown).
Anda harus terlebih dahulu masuk ke platform Google AI Studio dan menyiapkan kunci API GEMINI_API_KEY sebagai variabel lingkungan.
import os

os.environ["GEMINI_API_KEY"] = "***********"
Siapkan data
Kami menggunakan halaman FAQ dari Dokumentasi Milvus 2.4.x sebagai pengetahuan pribadi dalam RAG kami, yang merupakan sumber data yang baik untuk pipa RAG sederhana.
Unduh berkas ZIP dan ekstrak dokumen ke folder milvus_docs.
$ wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip
$ unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
Kami memuat semua berkas markdown dari folder milvus_docs/en/faq. Untuk setiap dokumen, kami cukup menggunakan "# " untuk memisahkan isi dalam berkas, yang secara kasar dapat memisahkan isi setiap bagian utama berkas markdown.
from glob import glob

text_lines = []

for file_path in glob("milvus_docs/en/faq/*.md", recursive=True):
    with open(file_path, "r") as file:
        file_text = file.read()

    text_lines += file_text.split("# ")
Siapkan LLM dan Model Embedding
Kami menggunakan gemini-2.5-flash sebagai LLM, dan gemini-embedding-2-preview sebagai model embedding. gemini-embedding-2-preview adalah model embedding multimodal terbaru dari Google, yang mendukung teks, gambar, video, audio, dan dokumen PDF dengan dimensi keluaran yang fleksibel (128–3.072) melalui Matryoshka Representation Learning.
Mari kita coba menghasilkan respons uji dari LLM:
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-2.5-flash", contents="who are you"
)
print(response.text)
I am a large language model, trained by Google.

I'm designed to process and generate human-like text based on the vast amount of data I was trained on. This allows me to:

*   Answer questions
*   Provide summaries
*   Generate creative content
*   Translate languages
*   And much more

I don't have personal experiences, feelings, or consciousness. I'm a tool designed to be helpful and informative.
Buat embedding uji dan tampilkan dimensinya serta beberapa elemen pertamanya.
test_embeddings = client.models.embed_content(
    model="gemini-embedding-2-preview", contents=["This is a test1", "This is a test2"]
)

embedding_dim = len(test_embeddings.embeddings[0].values)
print(embedding_dim)
print(test_embeddings.embeddings[0].values[:10])
3072
[-0.016769307, 0.013630492, 0.020277105, 0.0035285393, 0.003968259, -0.013498845, 0.028525498, 0.025498547, -0.021553498, 0.015233516]
Muat data ke dalam Milvus
Buat Koleksi
Mari kita inisialisasi klien Milvus dan atur koleksi kita:
from pymilvus import MilvusClient

milvus_client = MilvusClient(uri="./milvus_demo.db")

collection_name = "my_rag_collection"
Mengenai argumen ` MilvusClient`:
- Menetapkan `
uri` sebagai file lokal, misalnya `./milvus.db`, adalah metode yang paling praktis, karena secara otomatis menggunakan Milvus Lite untuk menyimpan semua data dalam file tersebut. - Jika Anda memiliki data dalam skala besar, Anda dapat menyiapkan server Milvus yang lebih berperforma di Docker atau Kubernetes. Dalam pengaturan ini, harap gunakan URI server, misalnya
http://localhost:19530, sebagaiuriAnda. - Jika Anda ingin menggunakan Zilliz Cloud, layanan cloud yang dikelola sepenuhnya untuk Milvus, sesuaikan `
uri` dan `token`, yang sesuai dengan Public Endpoint dan API Key di Zilliz Cloud.
Periksa apakah koleksi tersebut sudah ada dan hapus jika sudah ada.
if milvus_client.has_collection(collection_name):
    milvus_client.drop_collection(collection_name)
Buat koleksi baru dengan parameter yang ditentukan.
Jika kita tidak menentukan informasi bidang apa pun, Milvus akan secara otomatis membuat bidang id default untuk kunci utama, dan bidang vector untuk menyimpan data vektor. Bidang JSON yang dicadangkan digunakan untuk menyimpan bidang yang tidak ditentukan dalam skema beserta nilainya.
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=embedding_dim,
    metric_type="IP",  # Inner product distance
    # Strong consistency waits for all loads to complete, adding latency with large datasets
    # consistency_level="Strong",  # Strong consistency level
)
Sisipkan data
Lakukan iterasi melalui baris-baris teks, buat embedding, lalu masukkan data ke dalam Milvus.
Berikut adalah bidang baru text, yang merupakan bidang yang tidak didefinisikan dalam skema koleksi. Bidang ini akan secara otomatis ditambahkan ke bidang dinamis JSON yang dicadangkan, yang pada tingkat tinggi dapat diperlakukan sebagai bidang biasa.
from tqdm import tqdm

data = []

doc = client.models.embed_content(model="gemini-embedding-2-preview", contents=text_lines)

for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):
    data.append({"id": i, "vector": doc.embeddings[i].values, "text": line})

milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████| 72/72 [00:00<00:00, 337796.30it/s]


{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
Bangun RAG
Mengambil data untuk kueri
Mari tentukan pertanyaan yang sering diajukan tentang Milvus.
question = "How is data stored in milvus?"
Cari pertanyaan tersebut dalam koleksi dan ambil 3 hasil pencocokan semantik teratas.
quest_embed = client.models.embed_content(model="gemini-embedding-2-preview", contents=question)

search_res = milvus_client.search(
    collection_name=collection_name,
    data=[quest_embed.embeddings[0].values],
    limit=3,  # Return top 3 results
    search_params={"metric_type": "IP", "params": {}},  # Inner product distance
    output_fields=["text"],  # Return the text field
)
Mari kita lihat hasil pencarian dari kueri tersebut
import json

retrieved_lines_with_distances = [
    (res["entity"]["text"], res["distance"]) for res in search_res[0]
]
print(json.dumps(retrieved_lines_with_distances, indent=4))
[
    [
        " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",
        0.864
    ],
    [
        "Why is there no vector data in etcd?\n\netcd stores Milvus module metadata; MinIO stores entities.",
        0.7923
    ],
    [
        "What is the maximum dataset size Milvus can handle?\n\n  \nTheoretically, the maximum dataset size Milvus can handle is determined by the hardware it is run on, specifically system memory and storage:\n\n- Milvus loads all specified collections and partitions into memory before running queries. Therefore, memory size determines the maximum amount of data Milvus can query.\n- When new entities and and collection-related schema (currently only MinIO is supported for data persistence) are added to Milvus, system storage determines the maximum allowable size of inserted data.\n\n###",
        0.7857
    ]
]
Gunakan LLM untuk mendapatkan respons RAG
Konversikan dokumen yang diambil ke dalam format string.
context = "\n".join(
    [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances]
)
Tentukan prompt sistem dan pengguna untuk Model Bahasa. Prompt ini disusun menggunakan dokumen yang diambil dari Milvus.
from google.genai import types

SYSTEM_PROMPT = """
Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided.
"""
USER_PROMPT = f"""
Use the following pieces of information enclosed in <context> tags to provide an answer to the question enclosed in <question> tags.
<context>
{context}
</context>
<question>
{question}
</question>
"""
Gunakan Gemini untuk menghasilkan respons berdasarkan prompt tersebut.
response = client.models.generate_content(
    model="gemini-2.5-flash",
    config=types.GenerateContentConfig(system_instruction=SYSTEM_PROMPT),
    contents=USER_PROMPT,
)
print(response.text)
Milvus stores data in two main ways:

1.  **Inserted Data:** This includes vector data, scalar data, and collection-specific schema. This type of data is stored in persistent storage as an incremental log. Milvus supports various object storage backends for this, such as MinIO, AWS S3, Google Cloud Storage (GCS), Azure Blob Storage, Alibaba Cloud OSS, and Tencent Cloud Object Storage (COS).
2.  **Metadata:** Metadata is generated within Milvus by its various modules. Each module's metadata is stored in etcd.
Pencarian Multimodal
Karena gemini-embedding-2-preview memetakan teks, gambar, dan modalitas lainnya ke dalam ruang embedding yang sama, kita dapat melakukan pencarian lintas-modal — misalnya, menggunakan kueri teks untuk menemukan gambar yang paling relevan.
Siapkan data gambar
Kami mengunduh serangkaian diagram arsitektur RAG dari repositori Milvus Bootcamp untuk digunakan sebagai dataset gambar kami.
import urllib.request
from pathlib import Path

image_dir = Path("images")
image_dir.mkdir(exist_ok=True)

image_files = [
    "vanilla_rag.png",
    "hyde.png",
    "query_routing.png",
    "self_reflection.png",
    "hybrid_and_rerank.png",
    "hierarchical_index.png",
]

base_url = "https://raw.githubusercontent.com/milvus-io/bootcamp/master/pics/advanced_rag/"

for fname in image_files:
    path = image_dir / fname
    if not path.exists():
        urllib.request.urlretrieve(base_url + fname, path)
        print(f"Downloaded {fname}")
    else:
        print(f"Already exists {fname}")

print(f"\nTotal images: {len(image_files)}")
Downloaded vanilla_rag.png
Downloaded hyde.png
Downloaded query_routing.png
Downloaded self_reflection.png
Downloaded hybrid_and_rerank.png
Downloaded hierarchical_index.png

Total images: 6
Lakukan embedding pada gambar dan simpan di Milvus
Kami membaca setiap gambar sebagai byte dan meneruskannya ke gemini-embedding-2-preview untuk menghasilkan embedding, lalu menyimpannya dalam koleksi Milvus baru.
from google.genai import types

image_data = []

for fname in image_files:
    path = image_dir / fname
    with open(path, "rb") as f:
        image_bytes = f.read()

    result = client.models.embed_content(
        model="gemini-embedding-2-preview",
        contents=types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
    )
    image_data.append(
        {
            "id": len(image_data),
            "vector": result.embeddings[0].values,
            "filename": fname,
        }
    )
    print(f"Embedded {fname}")

# Create a new collection for images
image_collection = "image_collection"
if milvus_client.has_collection(image_collection):
    milvus_client.drop_collection(image_collection)

milvus_client.create_collection(
    collection_name=image_collection,
    dimension=len(image_data[0]["vector"]),
    metric_type="IP",
)

milvus_client.insert(collection_name=image_collection, data=image_data)
print(f"\nInserted {len(image_data)} image embeddings (dim={len(image_data[0]['vector'])})")
Embedded vanilla_rag.png
Embedded hyde.png
Embedded query_routing.png
Embedded self_reflection.png
Embedded hybrid_and_rerank.png
Embedded hierarchical_index.png

Inserted 6 image embeddings (dim=3072)
Pencarian lintas-modal: Kueri teks → Hasil gambar
Sekarang, mari gunakan kueri teks untuk mencari di seluruh embedding gambar. Karena teks dan gambar sama-sama dipetakan ke ruang embedding yang sama, kita dapat membandingkannya secara langsung.
from IPython.display import display, Image

text_queries = [
    "How does a basic RAG pipeline work?",
    "What is the hypothetical document embedding approach?",
    "How to combine hybrid search with reranking?",
]

for query in text_queries:
    query_embed = client.models.embed_content(
        model="gemini-embedding-2-preview", contents=query
    )

    results = milvus_client.search(
        collection_name=image_collection,
        data=[query_embed.embeddings[0].values],
        limit=1,
        search_params={"metric_type": "IP", "params": {}},
        output_fields=["filename"],
    )

    best = results[0][0]
    print(f"\nQuery: {query}")
    print(f"Match: {best['entity']['filename']} (score: {best['distance']:.4f})")
    display(Image(filename=str(image_dir / best["entity"]["filename"]), width=600))
Query: How does a basic RAG pipeline work?
Match: vanilla_rag.png (score: 0.5132)
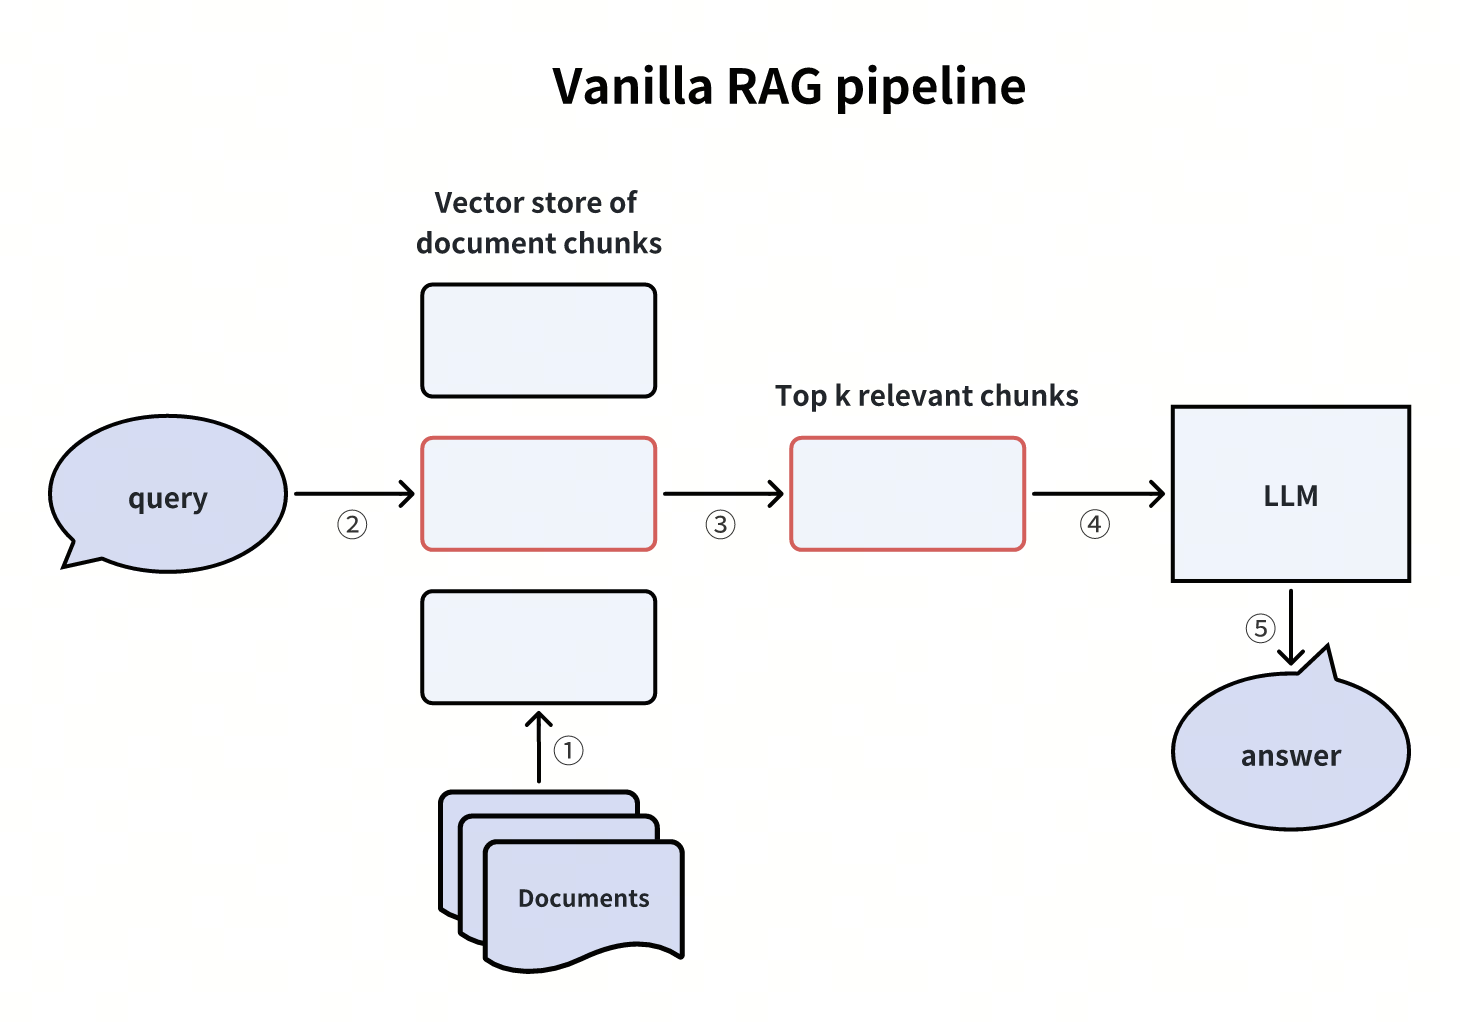 Pipa RAG Standar
Query: What is the hypothetical document embedding approach?
Match: hyde.png (score: 0.4756)
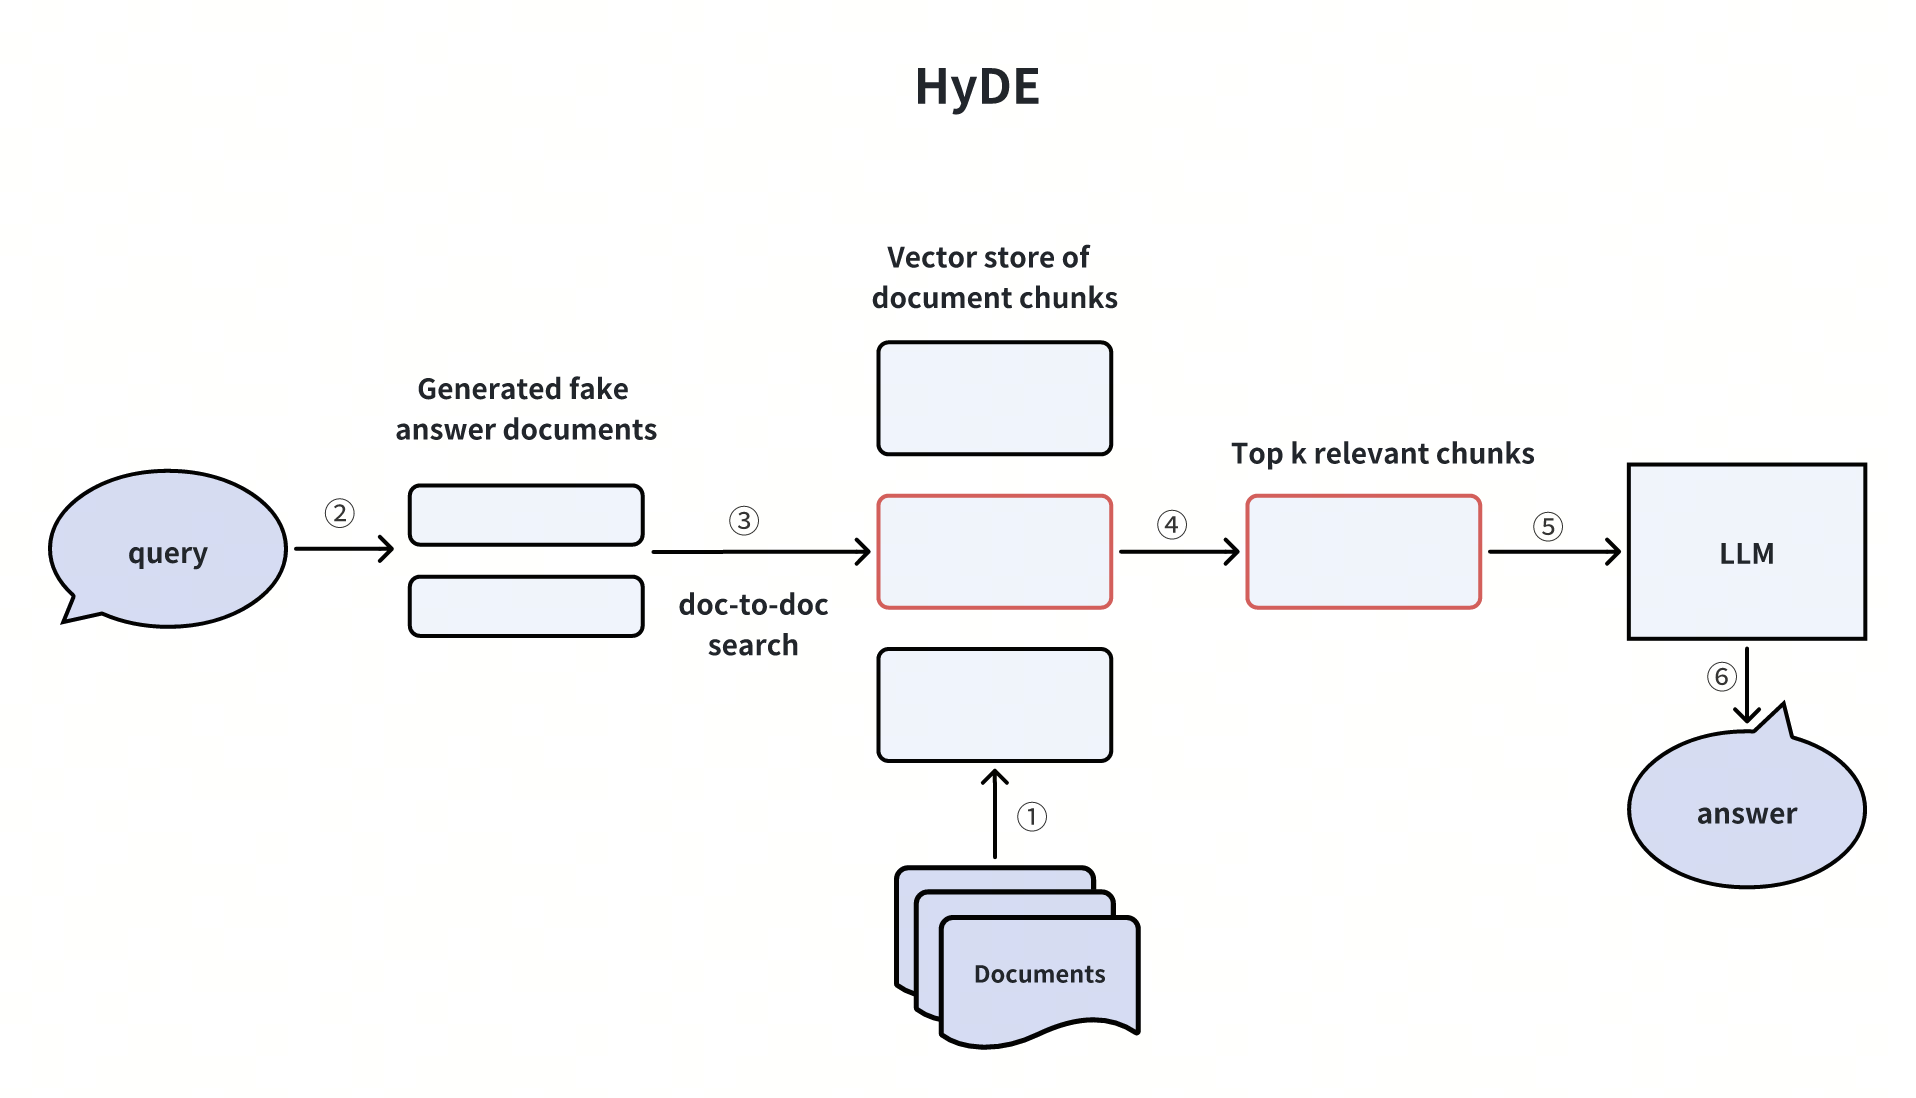 HyDE
Query: How to combine hybrid search with reranking?
Match: hybrid_and_rerank.png (score: 0.5271)
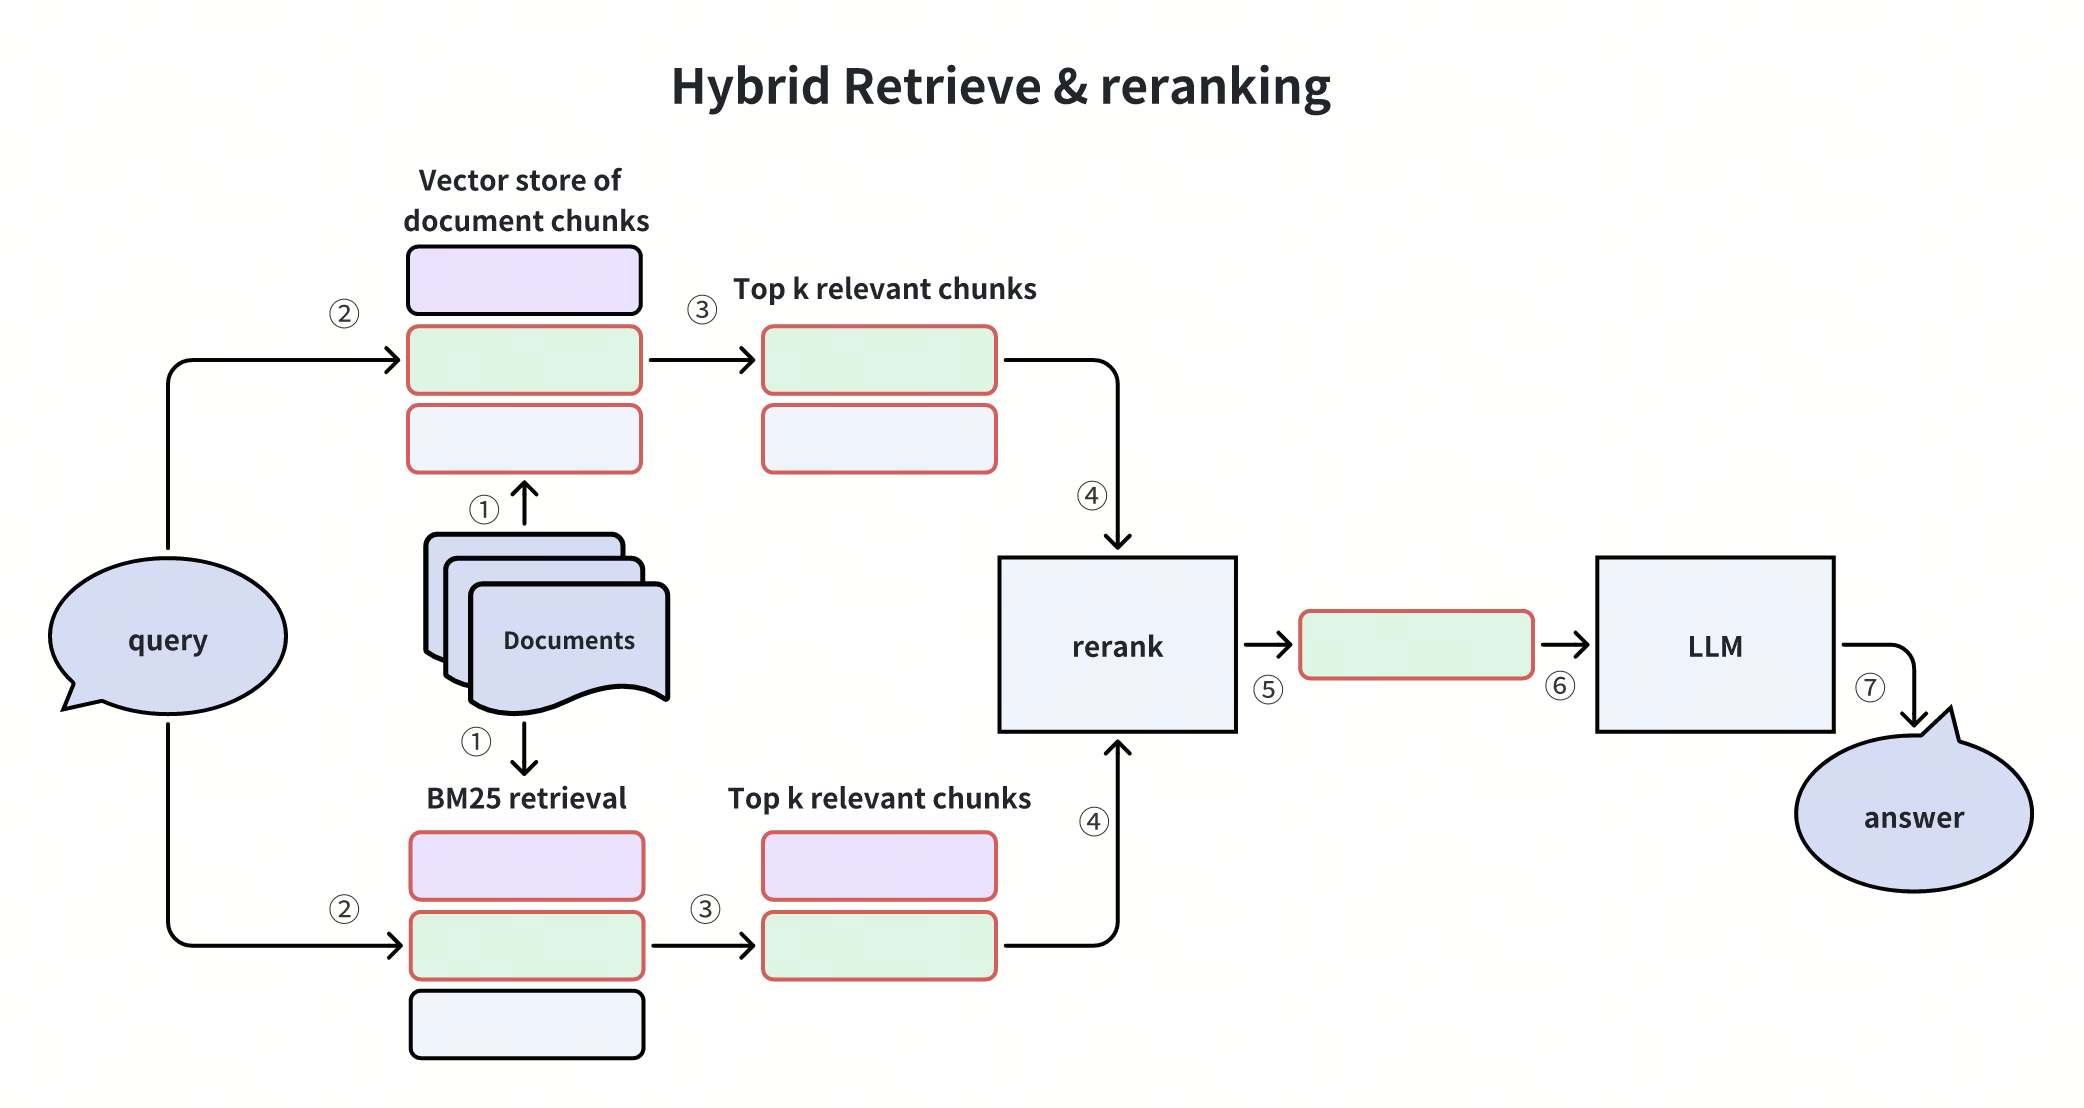 Pencarian dan Penilaian Ulang Hibrida
Hebat! Kita telah berhasil membangun pipa RAG dengan Milvus dan Gemini, serta mendemonstrasikan pencarian lintas-modal menggunakan kueri teks untuk mengambil gambar yang relevan — semuanya didukung oleh ruang embedding terpadu dari gemini-embedding-2-preview.
