

Vecteur dense
Les vecteurs denses sont des représentations de données numériques largement utilisées dans l’apprentissage automatique et l’analyse de données. Ils se composent de tableaux de nombres réels, dont la plupart ou la totalité des éléments sont différents de zéro. Par rapport aux vecteurs clairsemés, les vecteurs denses contiennent davantage d’informations à un même niveau de dimension, car chaque dimension renferme des valeurs significatives. Cette représentation permet de saisir efficacement des modèles et des relations complexes, facilitant ainsi l’analyse et le traitement des données dans des espaces à haute dimension. Les vecteurs denses possèdent généralement un nombre fixe de dimensions, allant de quelques dizaines à plusieurs centaines, voire plusieurs milliers, selon l’application et les exigences spécifiques.
Les vecteurs denses sont principalement utilisés dans des contextes nécessitant la compréhension de la sémantique des données, tels que la recherche sémantique et les systèmes de recommandation. Dans la recherche sémantique, les vecteurs denses aident à saisir les liens sous-jacents entre les requêtes et les documents, améliorant ainsi la pertinence des résultats de recherche. Dans les systèmes de recommandation, ils permettent d’identifier les similitudes entre les utilisateurs et les éléments, offrant ainsi des suggestions plus personnalisées.
Présentation
Les vecteurs denses sont généralement représentés sous forme de tableaux de nombres à virgule flottante de longueur fixe, tels qu'[0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. La dimensionnalité de ces vecteurs varie généralement de quelques centaines à plusieurs milliers, par exemple 128, 256, 768 ou 1 024. Chaque dimension capture des caractéristiques sémantiques spécifiques d’un objet, ce qui permet de l’appliquer à divers scénarios grâce à des calculs de similarité.
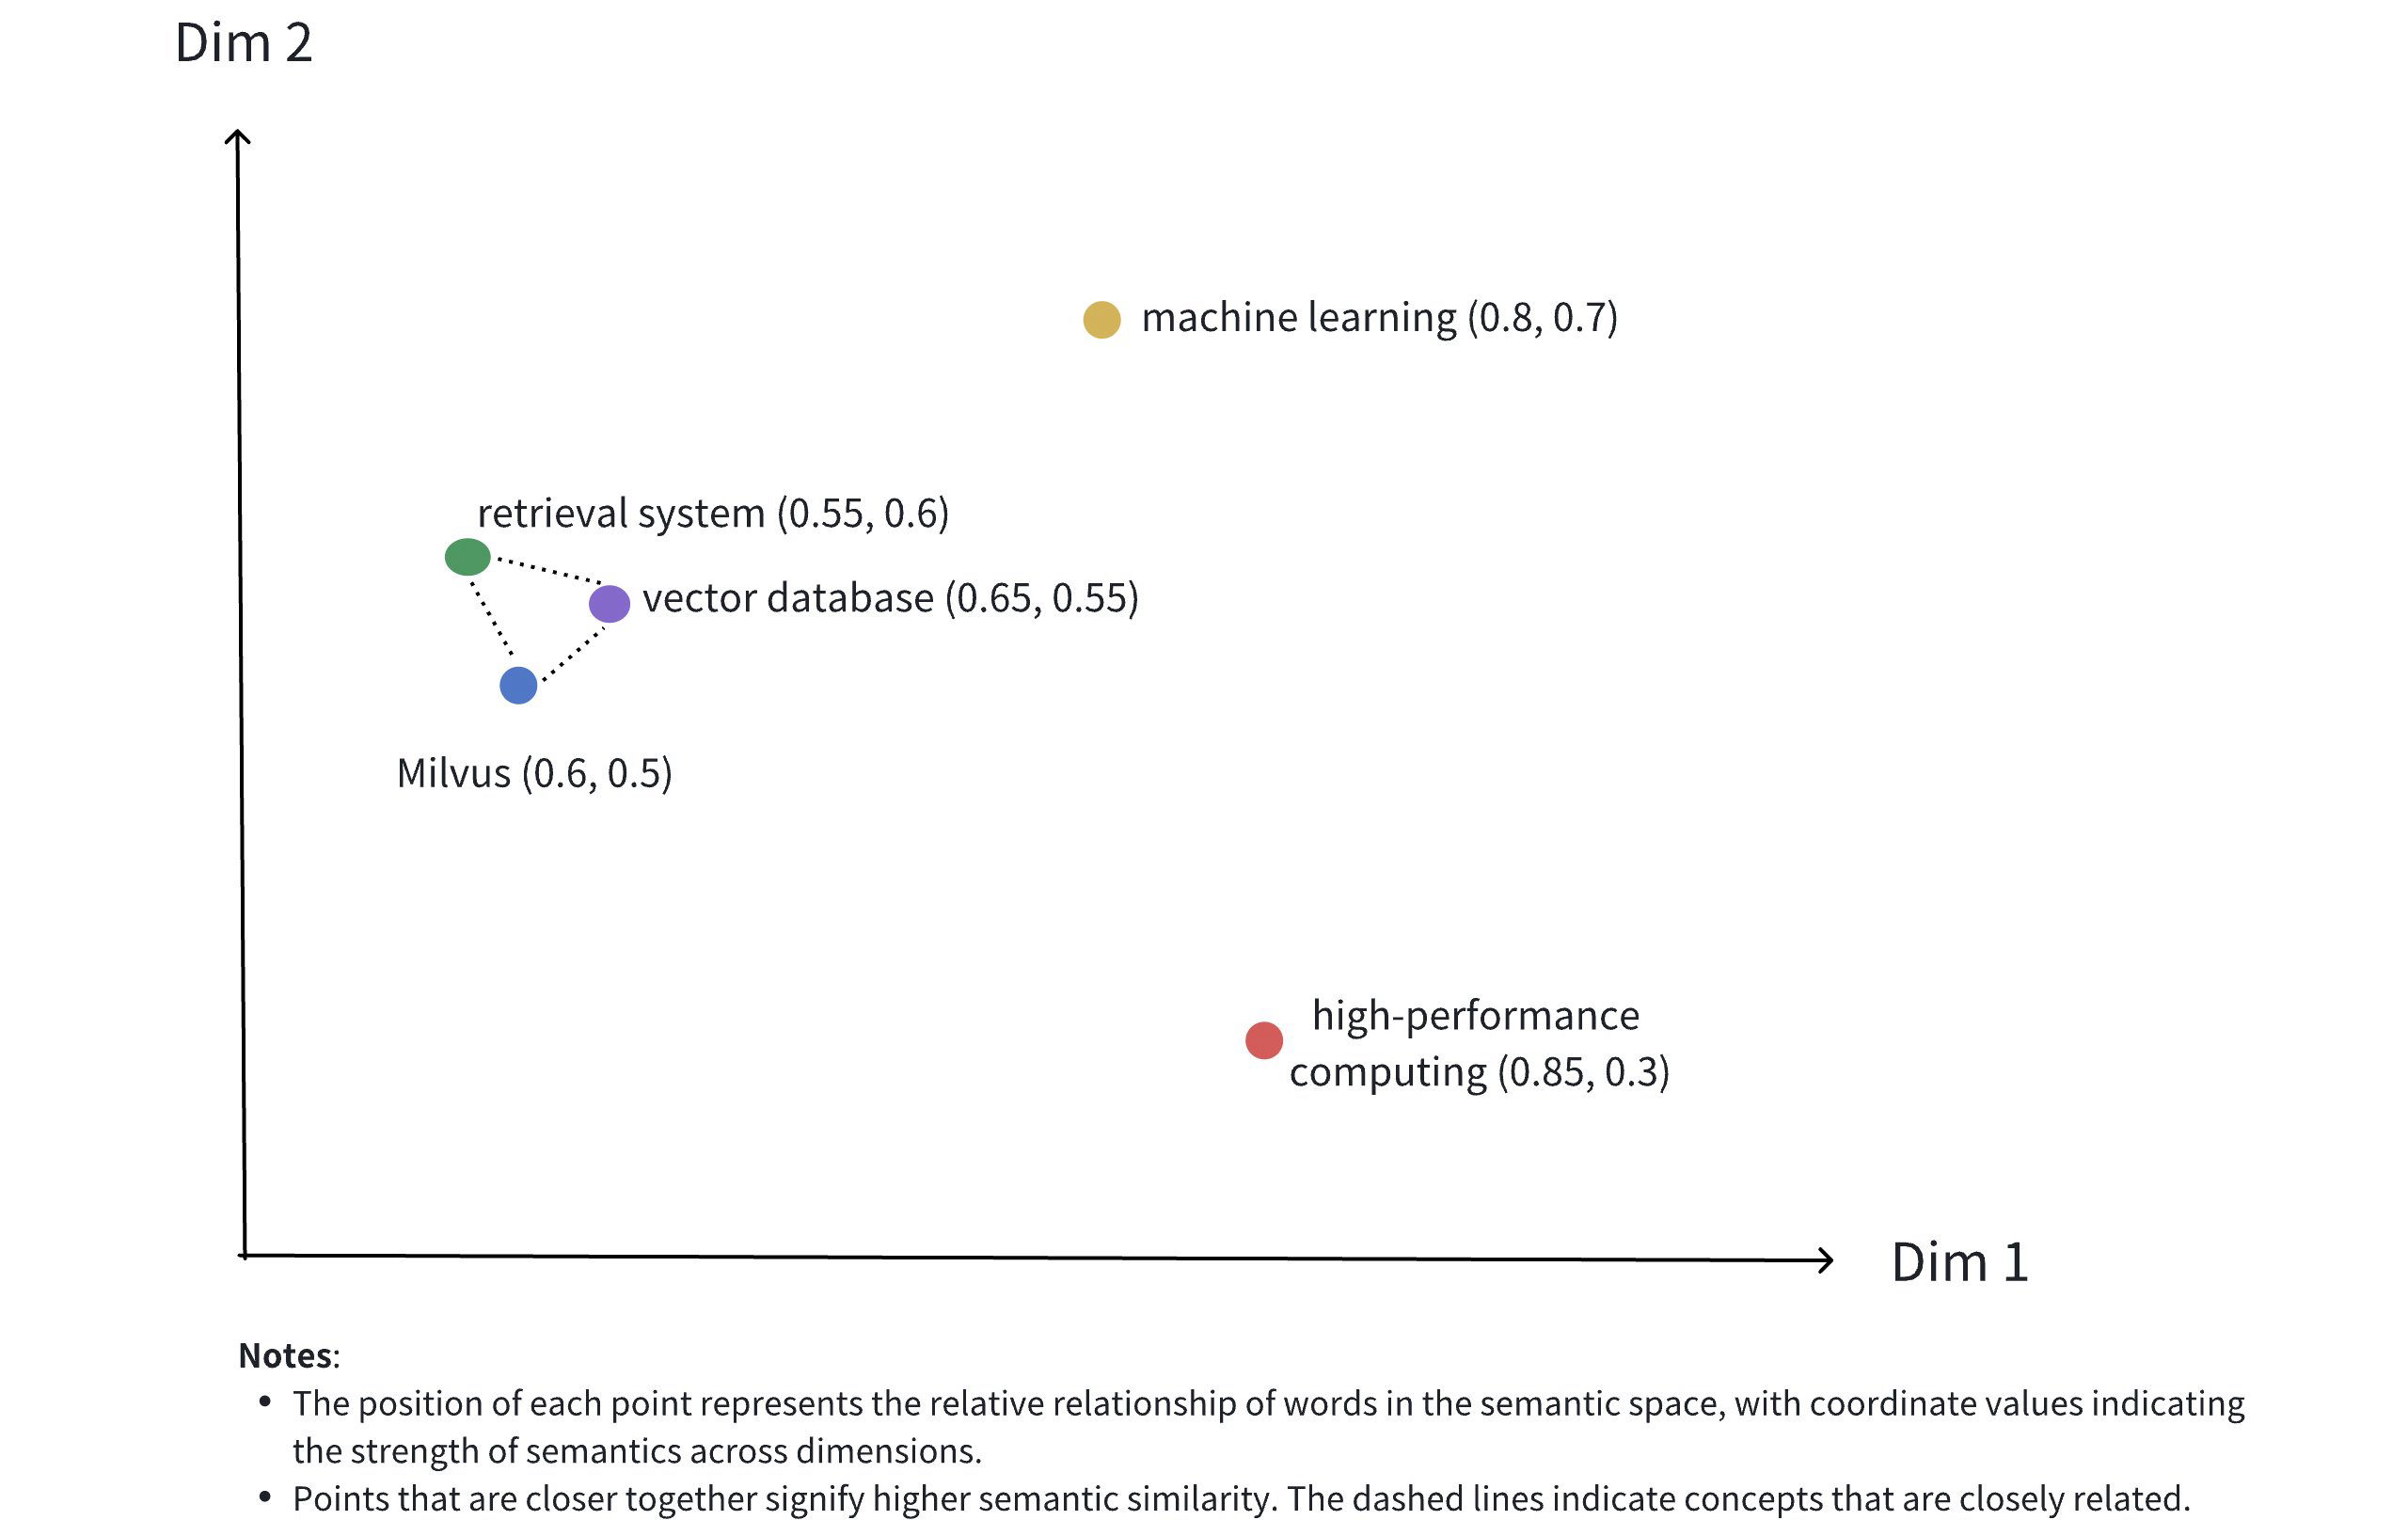 Vecteur dense
L’image ci-dessus illustre la représentation des vecteurs denses dans un espace en 2D. Bien que les vecteurs denses utilisés dans les applications concrètes aient souvent des dimensions bien plus élevées, cette illustration en 2D permet de bien comprendre plusieurs concepts clés :
Représentation multidimensionnelle : chaque point représente un objet conceptuel (tel que Milvus, une base de données vectorielle, un système de recherche, etc.), dont la position est déterminée par les valeurs de ses dimensions.
Relations sémantiques : les distances entre les points reflètent la similarité sémantique entre les concepts. Des points plus proches indiquent des concepts plus étroitement liés sur le plan sémantique.
Effet de regroupement : les concepts liés (tels que Milvus, base de données vectorielle et système de recherche) sont positionnés à proximité les uns des autres dans l’espace, formant ainsi un groupe sémantique.
Voici un exemple de vecteur dense réel représentant le texte « "Milvus is an efficient vector database" » :
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
Les vecteurs denses peuvent être générés à l’aide de divers modèles d’embedding, tels que les modèles CNN (comme ResNet, VGG) pour les images et les modèles linguistiques (comme BERT, Word2Vec) pour le texte. Ces modèles transforment les données brutes en points dans un espace à haute dimension, capturant ainsi les caractéristiques sémantiques des données. De plus, Milvus propose des méthodes pratiques pour aider les utilisateurs à générer et à traiter des vecteurs denses, comme détaillé dans la section « Embeddings ».
Une fois les données vectorisées, elles peuvent être stockées dans Milvus à des fins de gestion et de recherche vectorielle. Le schéma ci-dessous illustre le processus de base.
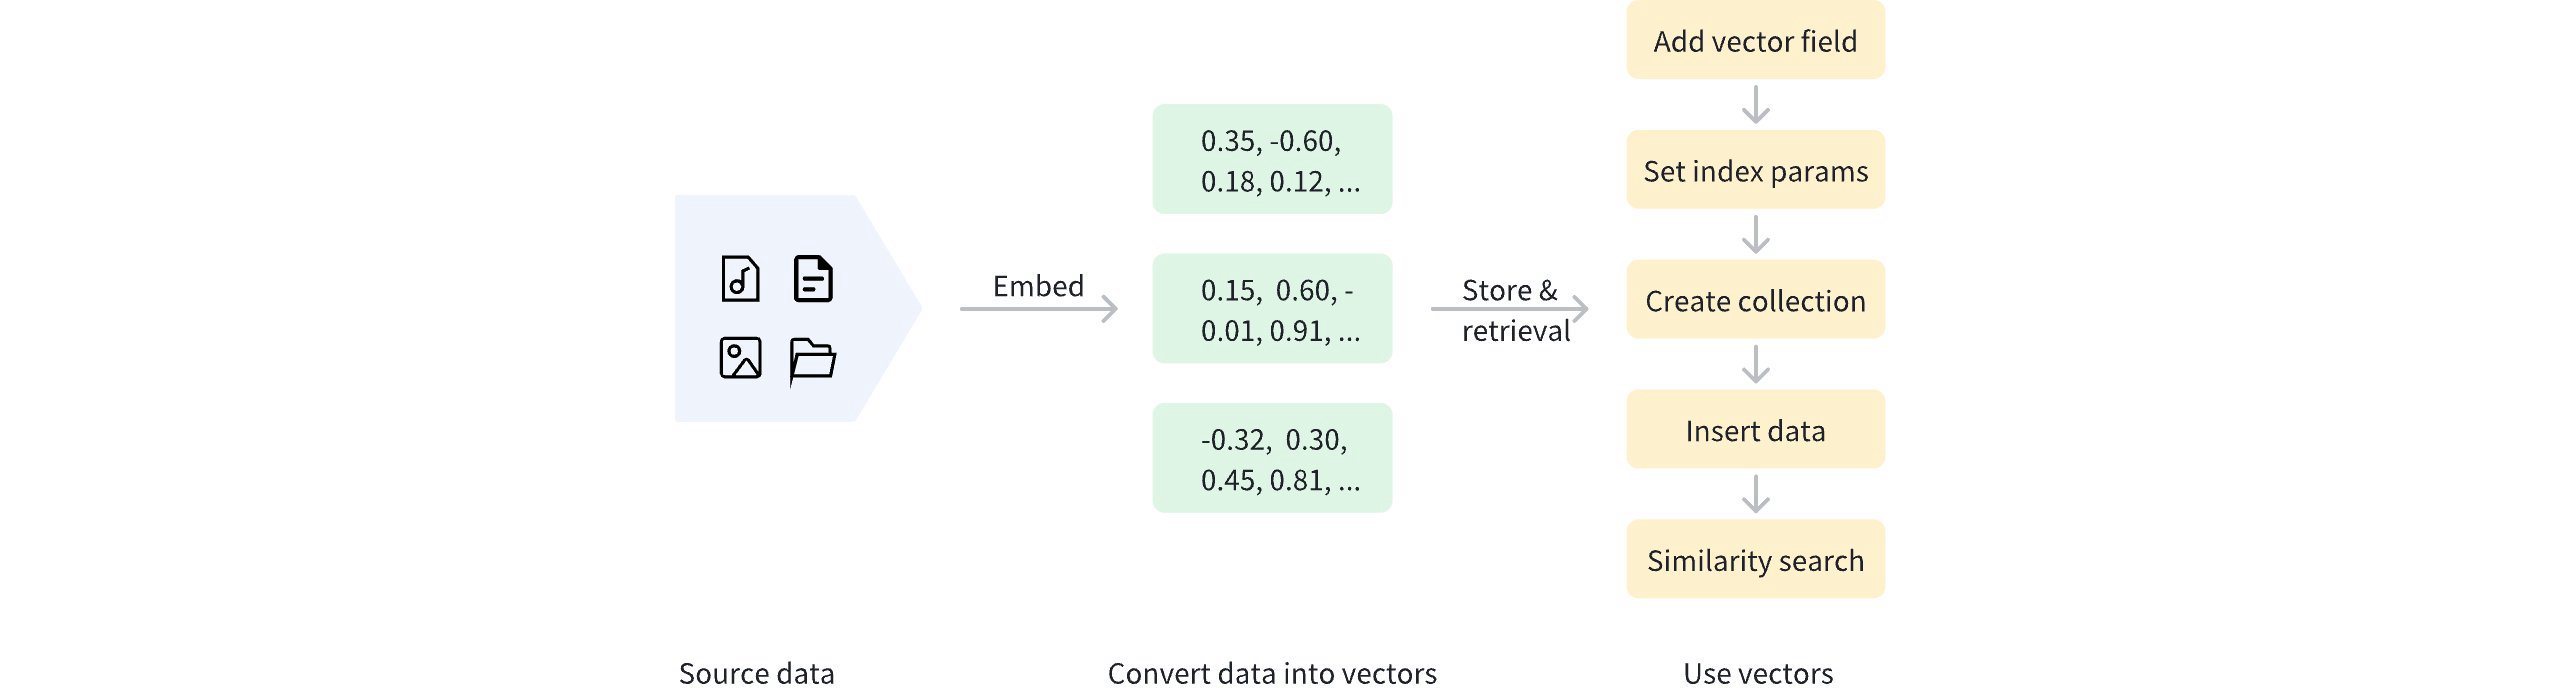 Utilisation des vecteurs denses
Outre les vecteurs denses, Milvus prend également en charge les vecteurs clairsemés et les vecteurs binaires. Les vecteurs clairsemés conviennent aux correspondances précises basées sur des termes spécifiques, tels que la recherche par mot-clé et la correspondance de termes, tandis que les vecteurs binaires sont couramment utilisés pour traiter efficacement des données binarisées, comme la correspondance de motifs d’images et certaines applications de hachage. Pour plus d’informations, consultez les sections « Vecteur binaire » et « Vecteur clairsemé ».
Utilisation des vecteurs denses
Ajouter un champ de vecteurs
Pour utiliser des vecteurs denses dans Milvus, définissez d’abord un champ vectoriel destiné à stocker ces vecteurs lors de la création d’une collection. Ce processus comprend :
Définir `
datatype` sur un type de données de vecteur dense pris en charge. Pour connaître les types de données de vecteur dense pris en charge, consultez la section « Types de données ».Spécifier les dimensions du vecteur dense à l’aide du paramètre `
dim`.
Dans l’exemple ci-dessous, nous ajoutons un champ vectoriel nommé dense_vector pour stocker des vecteurs denses. Le type de données du champ est FLOAT_VECTOR, avec une dimension de 4.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Types de données pris en charge pour les champs vectoriels denses:
Type de données |
Description |
|---|---|
|
Stocke des nombres à virgule flottante 32 bits, couramment utilisés pour représenter des nombres réels dans les calculs scientifiques et l’apprentissage automatique. Idéal pour les scénarios nécessitant une grande précision, tels que la distinction de vecteurs similaires. |
|
Stocke des nombres à virgule flottante de demi-précision sur 16 bits, utilisés pour l’apprentissage profond et les calculs sur GPU. Cela permet d’économiser de l’espace de stockage dans les scénarios où la précision est moins critique, comme lors de la phase de rappel à faible précision des systèmes de recommandation. |
|
Stocke des nombres à virgule flottante Brain (bfloat16) de 16 bits, offrant la même plage d’exposants que Float32 mais avec une précision réduite. Convient aux scénarios nécessitant de traiter rapidement de grands volumes de vecteurs, comme la recherche d’images à grande échelle. |
|
Stocke des vecteurs dont les éléments individuels dans chaque dimension sont des entiers de 8 bits (int8), chaque élément prenant des valeurs comprises entre –128 et 127. Conçu pour les modèles d’apprentissage profond quantifiés (par exemple, ResNet, EfficientNet), INT8_VECTOR réduit la taille du modèle et accélère l’inférence avec une perte de précision minimale. |
Définir les paramètres d’index pour le champ vectoriel
Pour accélérer les recherches sémantiques, un index doit être créé pour le champ vectoriel. L’indexation peut améliorer considérablement l’efficacité de la recherche dans des données vectorielles à grande échelle.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
Dans l’exemple ci-dessus, un index nommé « dense_vector_index » est créé pour le champ « dense_vector » à l’aide du type d’index « AUTOINDEX ». Le paramètre « metric_type » est défini sur « IP », ce qui indique que le produit scalaire sera utilisé comme métrique de distance.
Milvus propose divers types d’index pour une meilleure expérience de recherche vectorielle. AUTOINDEX est un type d’index spécial conçu pour faciliter l’apprentissage de la recherche vectorielle. De nombreux types d’index sont disponibles. Pour plus de détails, consultez la section « Explication des index ».
Milvus prend en charge d’autres types de métriques. Pour plus d’informations, consultez la section « Types de métriques ».
Créer une collection
Une fois les paramètres relatifs aux vecteurs denses et à l’index définis, vous pouvez créer une collection contenant des vecteurs denses. L’exemple ci-dessous utilise la méthode ` create_collection ` pour créer une collection nommée ` my_collection`.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Insérer des données
Après avoir créé la collection, utilisez la méthode ` insert ` pour ajouter des données contenant des vecteurs denses. Assurez-vous que la dimensionnalité des vecteurs denses insérés correspond à la valeur ` dim ` définie lors de l’ajout du champ de vecteur dense.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
Effectuer une recherche par similarité
La recherche sémantique basée sur des vecteurs denses est l’une des fonctionnalités phares de Milvus ; elle vous permet de trouver rapidement les données les plus similaires à un vecteur de requête en fonction de la distance entre les vecteurs. Pour effectuer une recherche par similarité, préparez le vecteur de requête et les paramètres de recherche, puis appelez la méthode ` search `.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
Pour plus d'informations sur les paramètres de recherche par similarité, consultez la section « Recherche ANN de base ».
