

Explicación del esquema
Un esquema define la estructura de datos de una colección. Antes de crear una colección, debes diseñar su esquema. Esta página te ayuda a comprender el esquema de una colección y a diseñar tú mismo un esquema de ejemplo.
Descripción general
En Milvus, el esquema de una colección equivale a una tabla en una base de datos relacional, que define cómo Milvus organiza los datos de la colección.
Un esquema bien diseñado es esencial, ya que abstrae el modelo de datos y determina si se pueden alcanzar los objetivos empresariales mediante una búsqueda. Además, dado que cada fila de datos insertada en la colección debe seguir el esquema, esto ayuda a mantener la coherencia de los datos y su calidad a largo plazo. Desde un punto de vista técnico, un esquema bien definido permite un almacenamiento de datos por columnas bien organizado y una estructura de índices más clara, lo que mejora el rendimiento de la búsqueda.
Un esquema de colección tiene una clave primaria, al menos un campo vectorial y varios campos escalares. El siguiente diagrama ilustra cómo asignar un artículo a una lista de campos del esquema.
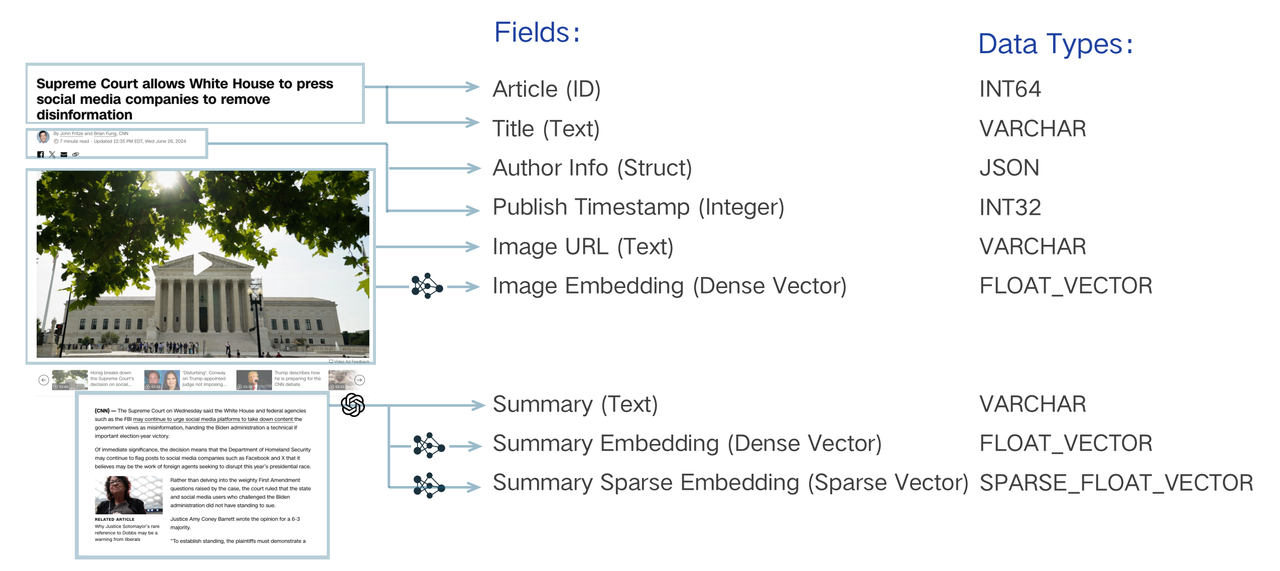 Anatomía del diseño de esquemas
El diseño del modelo de datos de un sistema de búsqueda implica analizar las necesidades empresariales y abstraer la información en un modelo de datos expresado mediante un esquema. Por ejemplo, la búsqueda de un fragmento de texto debe «indexarse» convirtiendo la cadena literal en un vector mediante «incrustación» y habilitando la búsqueda vectorial. Más allá de este requisito esencial, puede ser necesario almacenar otras propiedades, como la fecha y hora de publicación y el autor. Estos metadatos permiten refinar las búsquedas semánticas mediante filtros, devolviendo únicamente los textos publicados después de una fecha específica o por un autor concreto. También puedes recuperar estos valores escalares junto con el texto principal para mostrar el resultado de la búsqueda en la aplicación. A cada uno se le debe asignar un identificador único para organizar estos fragmentos de texto, expresado como un número entero o una cadena de caracteres. Estos elementos son esenciales para lograr una lógica de búsqueda sofisticada.
Consulta la guía práctica de diseño de esquemas para descubrir cómo crear un esquema bien diseñado.
Crear un esquema
El siguiente fragmento de código muestra cómo crear un esquema.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema()
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = client.createSchema();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const schema = []
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema()
export schema='{
    "fields": []
}'
Añadir un campo primario
El campo primario de una colección identifica de forma única a una entidad. Solo admite valores de tipo Int64 o VARCHAR. Los siguientes fragmentos de código muestran cómo añadir el campo primario.
schema.add_field(
    field_name="my_id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("my_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());
schema.push({
    name: "my_id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: false
});
schema.WithField(entity.NewField().WithName("my_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(false),
)
export primaryField='{
    "fieldName": "my_id",
    "dataType": "Int64",
    "isPrimary": true
}'

export schema='{
    \"autoID\": false,
    \"fields\": [
        $primaryField
    ]
}'
Al añadir un campo, puedes especificar explícitamente que se trata del campo primario estableciendo su propiedad ` is_primary ` en ` True`. Por defecto, un campo primario acepta valores `Int64`. En este caso, el valor del campo primario debe ser un número entero similar a ` 12345`. Si decides utilizar valores `VARCHAR` en el campo primario, el valor debe ser una cadena similar a ` my_entity_1234`.
También puede configurar las propiedades autoId en True para que Milvus asigne automáticamente los valores de los campos primarios al insertar datos.
Se recomienda utilizar « autoId » en todos los casos, salvo que resulte ventajoso establecer manualmente las claves primarias.
Para más detalles, consulta «Campo primario y AutoId».
Añadir campos vectoriales
Los campos vectoriales admiten diversas representaciones vectoriales, tanto dispersas como densas. En Milvus, puedes añadir cuatro campos vectoriales a una colección. Los siguientes fragmentos de código muestran cómo añadir un campo vectorial.
schema.add_field(
    field_name="my_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
schema.push({
    name: "my_vector",
    data_type: DataType.FloatVector,
    dim: 5
});
schema.WithField(entity.NewField().WithName("my_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
export vectorField='{
    "fieldName": "my_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 5
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
El parámetro ` dim ` de los fragmentos de código anteriores indica la dimensionalidad de las representaciones vectoriales que se almacenarán en el campo vectorial. El valor ` FLOAT_VECTOR ` indica que el campo vectorial contiene una lista de números de coma flotante de 32 bits, que suelen utilizarse para representar antilogaritmos. Además, Milvus también admite los siguientes tipos de representaciones vectoriales:
FLOAT16_VECTORUn campo vectorial de este tipo contiene una lista de números de coma flotante de media precisión de 16 bits y suele aplicarse a escenarios de aprendizaje profundo o de computación basada en GPU con restricciones de memoria o de ancho de banda.
BFLOAT16_VECTORUn campo vectorial de este tipo contiene una lista de números de coma flotante de 16 bits que tienen una precisión reducida, pero el mismo rango de exponentes que Float32. Este tipo de datos se utiliza habitualmente en escenarios de aprendizaje profundo, ya que reduce el uso de memoria sin afectar significativamente a la precisión.
INT8_VECTORUn campo vectorial de este tipo almacena vectores compuestos por enteros con signo de 8 bits (int8), con cada componente en el rango de –128 a 127. Diseñado específicamente para arquitecturas de aprendizaje profundo cuantificadas —como ResNet y EfficientNet—, reduce sustancialmente el tamaño del modelo y aumenta la velocidad de inferencia, todo ello con una pérdida de precisión mínima. Nota: Este tipo de vector solo es compatible con los índices HNSW.
BINARY_VECTORUn campo vectorial de este tipo contiene una lista de ceros y unos. Sirven como características compactas para representar datos en escenarios de procesamiento de imágenes y recuperación de información.
SPARSE_FLOAT_VECTORUn campo vectorial de este tipo contiene una lista de números distintos de cero y sus números de secuencia para representar incrustaciones vectoriales dispersas.
Añadir campos escalares
En los casos más habituales, puedes utilizar campos escalares para almacenar los metadatos de las incrustaciones vectoriales guardadas en Milvus y realizar búsquedas mediante redes neuronales artificiales (ANN) con filtrado de metadatos para mejorar la precisión de los resultados de búsqueda. Milvus admite varios tipos de campos escalares, entre ellos VARCHAR, Booleano, Int, Float y Double.
Añadir campos VARCHAR
En Milvus, se pueden utilizar campos « VARCHAR » para almacenar cadenas de caracteres. Para obtener más información sobre el campo « VARCHAR », consulte el apartado «Campo VarChar».
schema.add_field(
    field_name="my_varchar",
    datatype=DataType.VARCHAR,
    max_length=512
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_varchar")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .build());
schema.push({
    name: "my_varchar",
    data_type: DataType.VarChar,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_varchar").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(512),
)
export varCharField='{
    "fieldName": "my_varchar",
    "dataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField
    ]
}"
Añadir campos numéricos
Los tipos numéricos que admite Milvus son « Int8 », « Int16 », « Int32 », « Int64 », « Float » y « Double ». Para obtener más información sobre los campos numéricos, consulta «Campo numérico».
schema.add_field(
    field_name="my_int64",
    datatype=DataType.INT64,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_int64")
        .dataType(DataType.Int64)
        .build());
schema.push({
    name: "my_int64",
    data_type: DataType.Int64,
});
schema.WithField(entity.NewField().WithName("my_int64").
    WithDataType(entity.FieldTypeInt64),
)
export int64Field='{
    "fieldName": "my_int64",
    "dataType": "Int64"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field
    ]
}"
Añadir campos booleanos
Milvus admite campos booleanos. Los siguientes fragmentos de código muestran cómo añadir un campo booleano.
schema.add_field(
    field_name="my_bool",
    datatype=DataType.BOOL,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_bool")
        .dataType(DataType.Bool)
        .build());
schema.push({
    name: "my_bool",
    data_type: DataType.Boolean,
});
schema.WithField(entity.NewField().WithName("my_bool").
    WithDataType(entity.FieldTypeBool),
)
export boolField='{
    "fieldName": "my_bool",
    "dataType": "Boolean"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField
    ]
}"
Añadir campos compuestos
En Milvus, un campo compuesto es aquel que se puede dividir en subcampos más pequeños, como las claves de un campo JSON o los índices de un campo de matriz.
Añadir campos JSON
Un campo JSON suele almacenar datos JSON semiestructurados. Para obtener más información sobre los campos JSON, consulta «Campo JSON».
schema.add_field(
    field_name="my_json",
    datatype=DataType.JSON,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_json")
        .dataType(DataType.JSON)
        .build());
schema.push({
    name: "my_json",
    data_type: DataType.JSON,
});
schema.WithField(entity.NewField().WithName("my_json").
    WithDataType(entity.FieldTypeJSON),
)
export jsonField='{
    "fieldName": "my_json",
    "dataType": "JSON"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField
    ]
}"
Añadir campos de matriz
Un campo de matriz almacena una lista de elementos. Los tipos de datos de todos los elementos de un campo de matriz deben ser los mismos. Para obtener más información sobre los campos de matriz, consulta «Campo de matriz».
schema.add_field(
    field_name="my_array",
    datatype=DataType.ARRAY,
    element_type=DataType.VARCHAR,
    max_capacity=5,
    max_length=512,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_array")
        .dataType(DataType.Array)
        .elementType(DataType.VarChar)
        .maxCapacity(5)
        .maxLength(512)
        .build());
schema.push({
    name: "my_array",
    data_type: DataType.Array,
    element_type: DataType.VarChar,
    max_capacity: 5,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_array").
    WithDataType(entity.FieldTypeArray).
    WithElementType(entity.FieldTypeInt64).
    WithMaxLength(512).
    WithMaxCapacity(5),
)
export arrayField='{
    "fieldName": "my_array",
    "dataType": "Array",
    "elementDataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField,
        $arrayField
    ]
}"
