

Vector denso
Los vectores densos son representaciones numéricas de datos muy utilizadas en el aprendizaje automático y el análisis de datos. Consisten en matrices de números reales, en las que la mayoría o la totalidad de los elementos son distintos de cero. En comparación con los vectores dispersos, los vectores densos contienen más información en el mismo nivel dimensional, ya que cada dimensión contiene valores significativos. Esta representación permite captar de forma eficaz patrones y relaciones complejos, lo que facilita el análisis y el procesamiento de los datos en espacios de alta dimensión. Los vectores densos suelen tener un número fijo de dimensiones, que puede oscilar entre unas pocas docenas y varios cientos o incluso miles, dependiendo de la aplicación y los requisitos específicos.
Los vectores densos se utilizan principalmente en escenarios que requieren comprender la semántica de los datos, como la búsqueda semántica y los sistemas de recomendación. En la búsqueda semántica, los vectores densos ayudan a captar las conexiones subyacentes entre las consultas y los documentos, mejorando la relevancia de los resultados de búsqueda. En los sistemas de recomendación, ayudan a identificar similitudes entre usuarios y elementos, ofreciendo sugerencias más personalizadas.
Descripción general
Los vectores densos suelen representarse como matrices de números de coma flotante de longitud fija, como [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. La dimensionalidad de estos vectores suele oscilar entre cientos y miles, como 128, 256, 768 o 1024. Cada dimensión capta características semánticas específicas de un objeto, lo que permite su aplicación en diversos escenarios mediante cálculos de similitud.
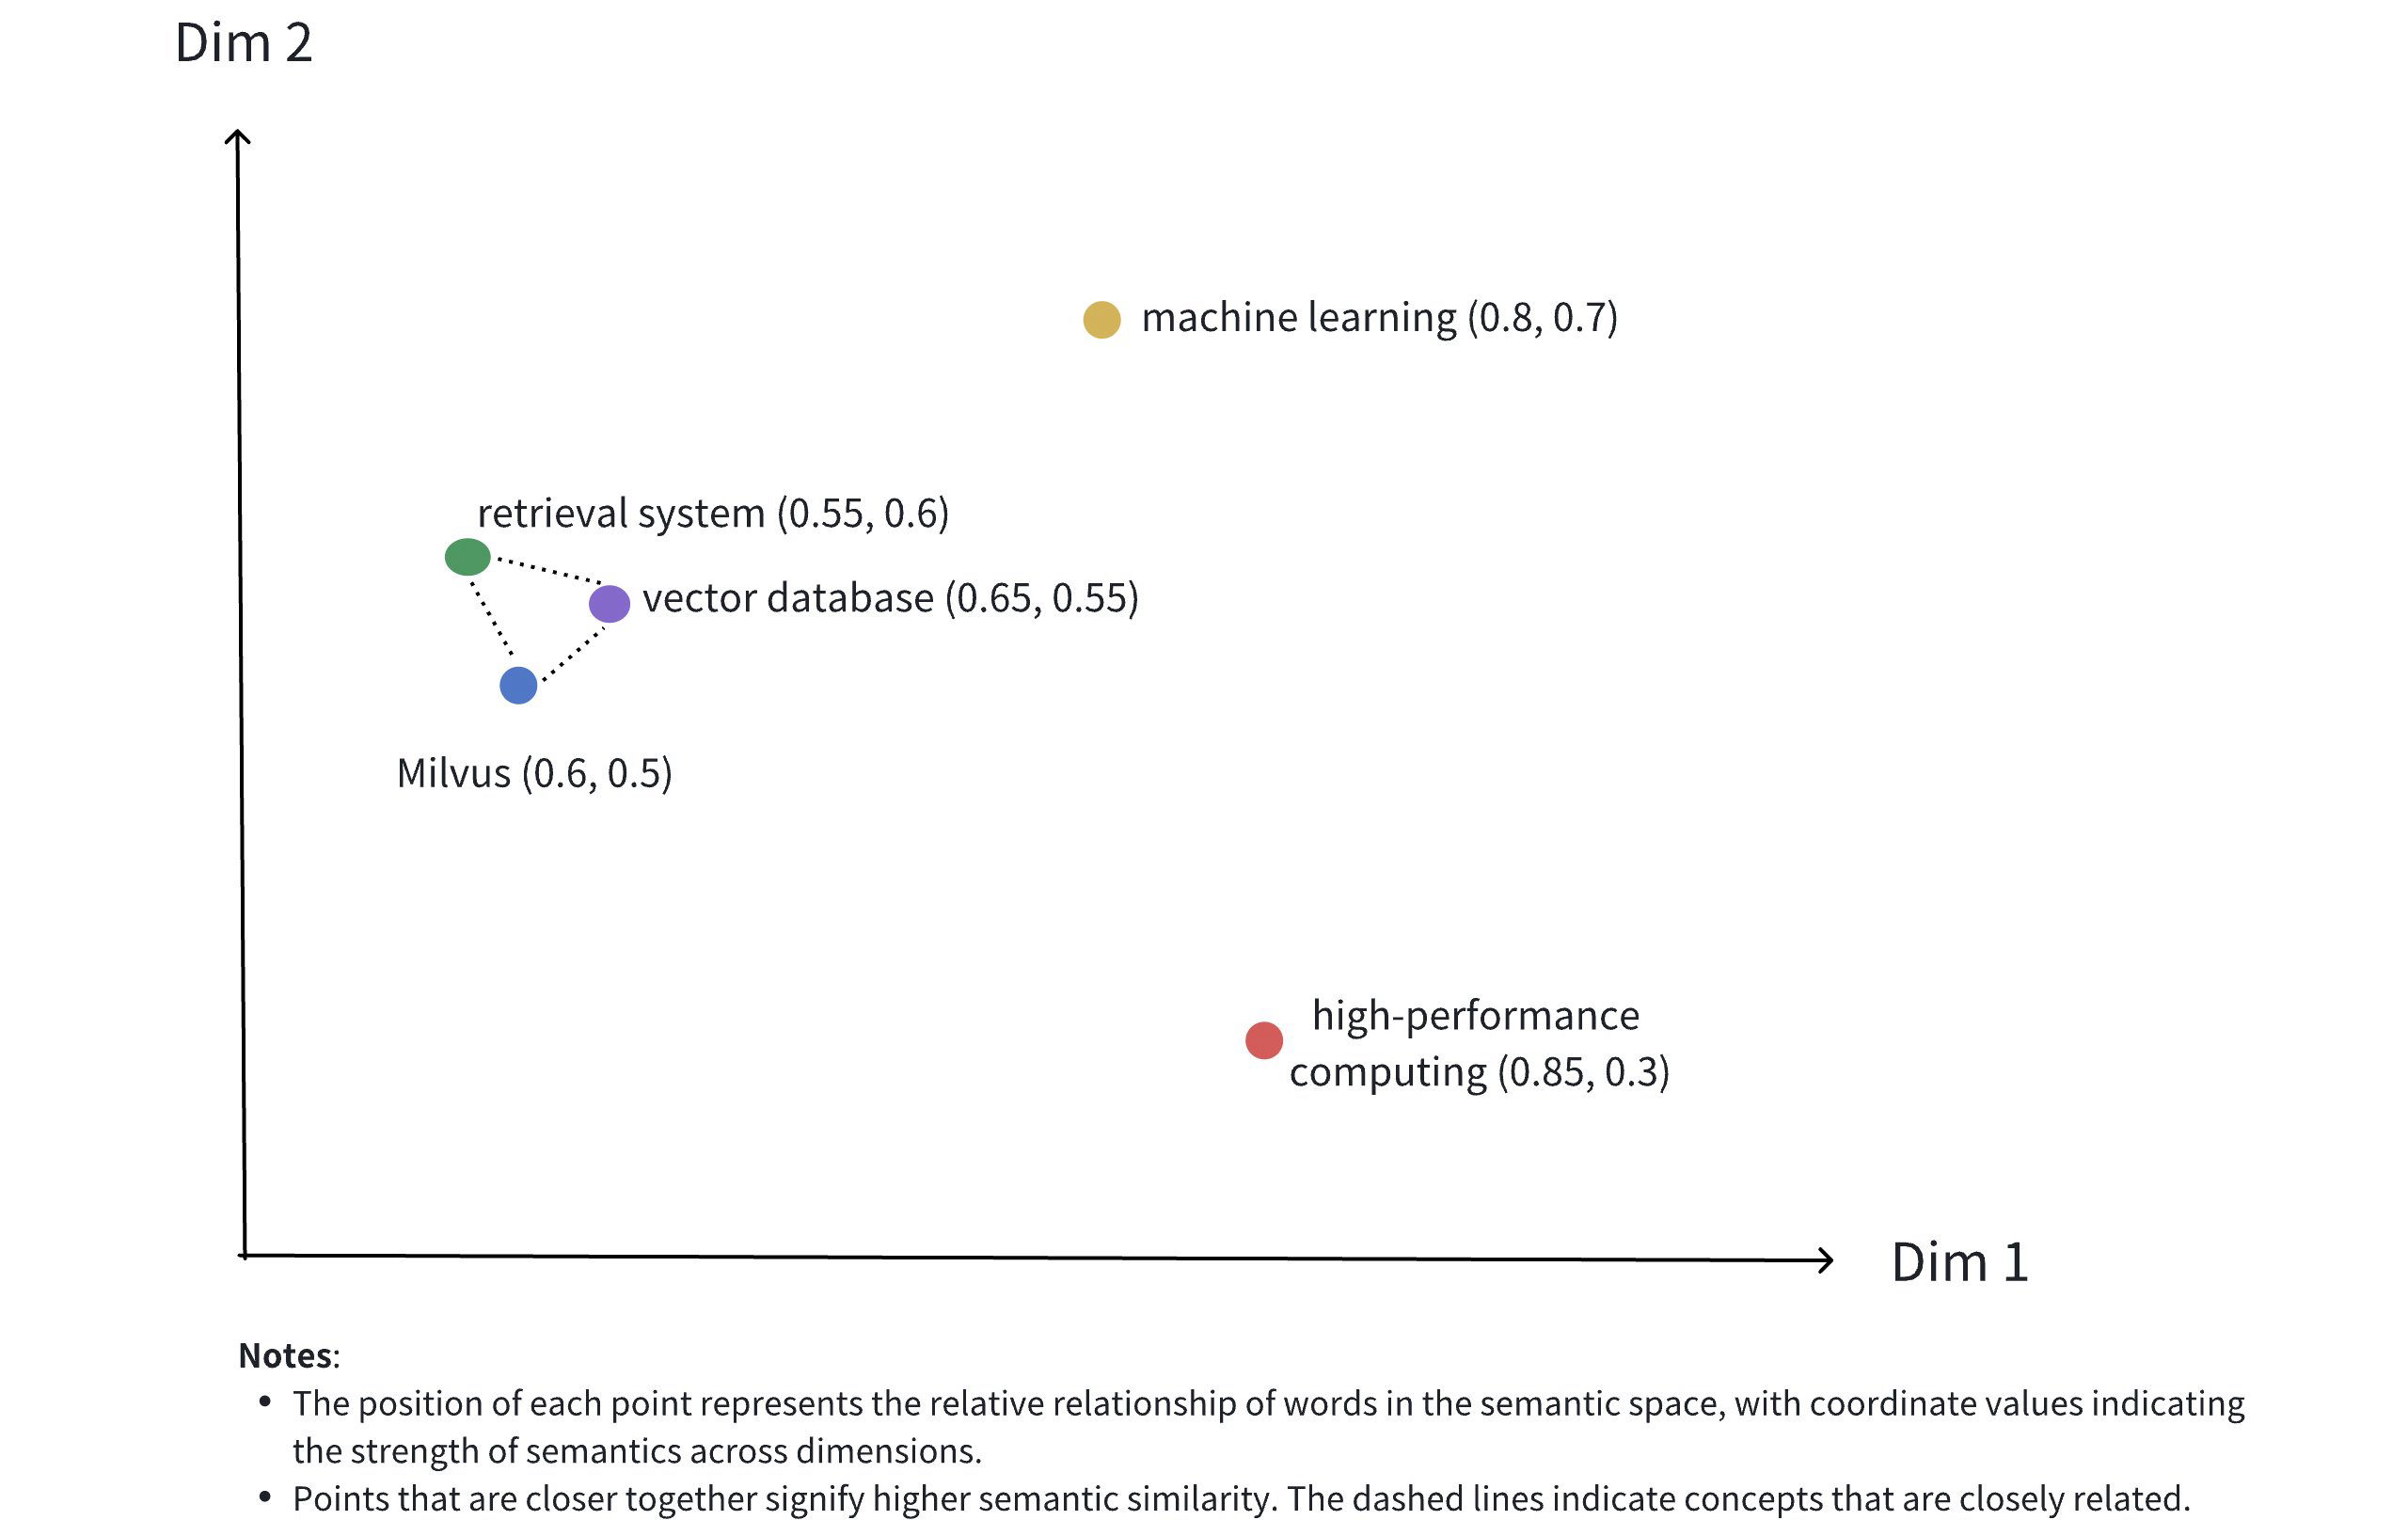 Vector denso
La imagen anterior ilustra la representación de los vectores densos en un espacio bidimensional. Aunque los vectores densos en aplicaciones del mundo real suelen tener dimensiones mucho mayores, esta ilustración bidimensional transmite eficazmente varios conceptos clave:
Representación multidimensional: cada punto representa un objeto conceptual (como Milvus, una base de datos vectorial, un sistema de recuperación, etc.), cuya posición viene determinada por los valores de sus dimensiones.
Relaciones semánticas: Las distancias entre los puntos reflejan la similitud semántica entre los conceptos. Los puntos más cercanos indican conceptos que están más relacionados semánticamente.
Efecto de agrupamiento: los conceptos relacionados (como Milvus, base de datos vectorial y sistema de recuperación) se sitúan cerca unos de otros en el espacio, formando un clúster semántico.
A continuación se muestra un ejemplo de un vector denso real que representa el texto « "Milvus is an efficient vector database" »:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
Los vectores densos pueden generarse utilizando diversos modelos de incrustación, como los modelos CNN (por ejemplo, ResNet o VGG) para imágenes y los modelos lingüísticos (como BERT o Word2Vec) para texto. Estos modelos transforman los datos brutos en puntos en un espacio de alta dimensión, captando las características semánticas de los datos. Además, Milvus ofrece métodos prácticos para ayudar a los usuarios a generar y procesar vectores densos, tal y como se detalla en «Incrustaciones».
Una vez vectorizados los datos, se pueden almacenar en Milvus para su gestión y recuperación vectorial. El siguiente diagrama muestra el proceso básico.
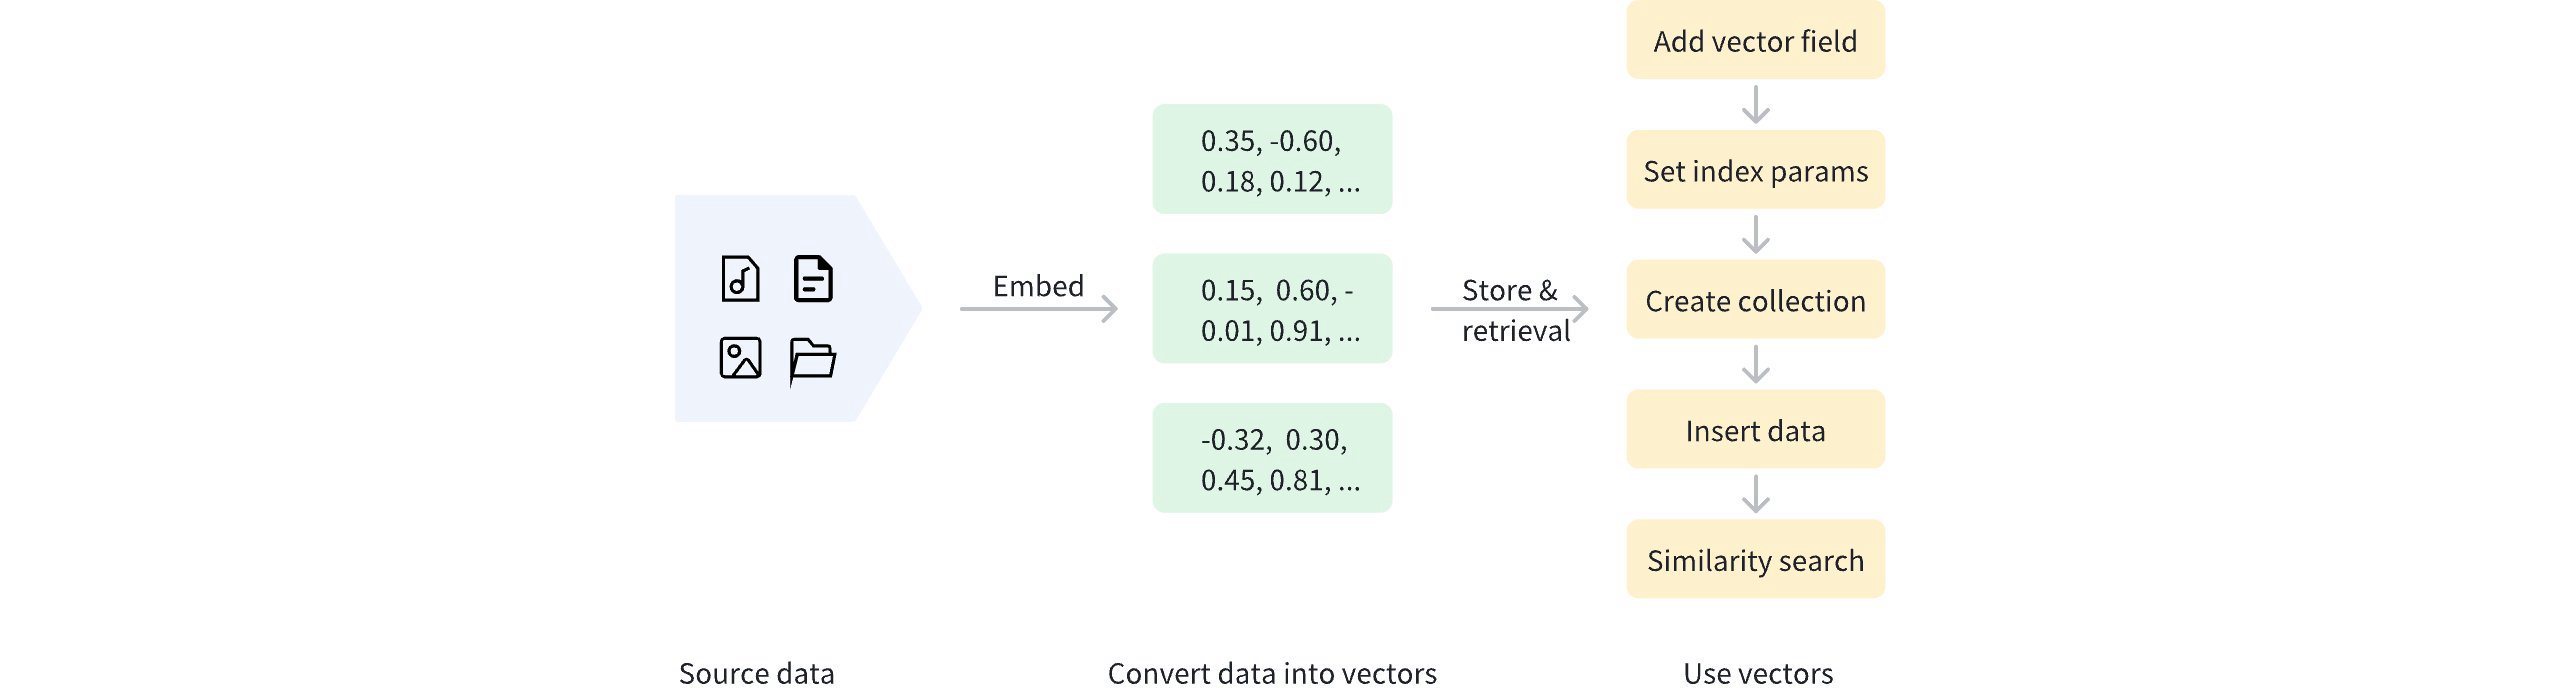 Utilizar vectores densos
Además de los vectores densos, Milvus también admite vectores dispersos y vectores binarios. Los vectores dispersos son adecuados para coincidencias precisas basadas en términos específicos, como la búsqueda por palabras clave y la coincidencia de términos, mientras que los vectores binarios se utilizan habitualmente para gestionar de forma eficiente datos binarizados, como la coincidencia de patrones de imágenes y determinadas aplicaciones de hash. Para obtener más información, consulta «Vector binario » y «Vector disperso».
Uso de vectores densos
Añadir un campo de vectores
Para utilizar vectores densos en Milvus, primero debe definir un campo vectorial para almacenar vectores densos al crear una colección. Este proceso incluye:
Establecer `
datatype` en un tipo de datos de vector denso compatible. Para conocer los tipos de datos de vector denso compatibles, consulte Tipos de datos.Especificar las dimensiones del vector denso mediante el parámetro `
dim`.
En el ejemplo siguiente, añadimos un campo vectorial denominado dense_vector para almacenar vectores densos. El tipo de datos del campo es FLOAT_VECTOR, con una dimensión de 4.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Tipos de datos admitidos para campos vectoriales densos:
Tipo de datos |
Descripción |
|---|---|
|
Almacena números de coma flotante de 32 bits, que se utilizan habitualmente para representar números reales en cálculos científicos y aprendizaje automático. Ideal para situaciones que requieren alta precisión, como la distinción entre vectores similares. |
|
Almacena números de coma flotante de media precisión de 16 bits, utilizados para el aprendizaje profundo y los cálculos en GPU. Ahorra espacio de almacenamiento en situaciones en las que la precisión es menos crítica, como en la fase de recuperación de baja precisión de los sistemas de recomendación. |
|
Almacena números de punto flotante Brain (bfloat16) de 16 bits, que ofrecen el mismo rango de exponentes que Float32, pero con una precisión reducida. Adecuado para situaciones en las que es necesario procesar grandes volúmenes de vectores rápidamente, como la recuperación de imágenes a gran escala. |
|
Almacena vectores cuyos elementos individuales en cada dimensión son enteros de 8 bits (int8), con un rango para cada elemento de –128 a 127. Diseñado para modelos de aprendizaje profundo cuantificados (por ejemplo, ResNet, EfficientNet), INT8_VECTOR reduce el tamaño del modelo y acelera la inferencia con una pérdida mínima de precisión. |
Configurar los parámetros del índice para el campo vectorial
Para acelerar las búsquedas semánticas, es necesario crear un índice para el campo vectorial. La indexación puede mejorar significativamente la eficiencia de la recuperación de datos vectoriales a gran escala.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
En el ejemplo anterior, se crea un índice denominado « dense_vector_index » para el campo « dense_vector » utilizando el tipo de índice « AUTOINDEX ». El parámetro « metric_type » se establece en « IP », lo que indica que se utilizará el producto interno como métrica de distancia.
Milvus ofrece diversos tipos de índices para mejorar la experiencia de búsqueda vectorial. AUTOINDEX es un tipo de índice especial diseñado para facilitar el aprendizaje de la búsqueda vectorial. Hay muchos tipos de índices disponibles entre los que elegir. Para obtener más información, consulta la sección «Explicación de los índices».
Milvus admite otros tipos de métricas. Para obtener más información, consulta «Tipos de métricas».
Crear una colección
Una vez completada la configuración de los parámetros de vectores densos y del índice, puede crear una colección que contenga vectores densos. El ejemplo siguiente utiliza el método ` create_collection ` para crear una colección denominada ` my_collection`.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Insertar datos
Tras crear la colección, utiliza el método ` insert ` para añadir datos que contengan vectores densos. Asegúrate de que la dimensionalidad de los vectores densos que se insertan coincida con el valor de ` dim ` definido al añadir el campo de vector denso.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
Realizar una búsqueda por similitud
La búsqueda semántica basada en vectores densos es una de las características principales de Milvus, ya que permite encontrar rápidamente los datos más similares a un vector de consulta en función de la distancia entre vectores. Para realizar una búsqueda por similitud, prepara el vector de consulta y los parámetros de búsqueda y, a continuación, llama al método ` search `.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
Para obtener más información sobre los parámetros de búsqueda por similitud, consulta «Búsqueda básica con redes neuronales artificiales (ANN)».
