


Crea un sistema RAG con Milvus y Gemini
La API de Gemini y Google AI Studio te ayudan a empezar a trabajar con los últimos modelos de Google y a convertir tus ideas en aplicaciones escalables. Gemini proporciona acceso a potentes modelos de lenguaje como Gemini-2.5-Flash y Gemini-2.5-Pro para tareas como la generación de texto, el procesamiento de documentos, la visión, el análisis de audio y mucho más. También ofrece Gemini Embedding 2, un modelo de incrustación multimodal compatible con texto, imágenes, vídeo, audio y documentos PDF con dimensiones de salida flexibles a través del aprendizaje de representaciones Matryoshka. La API permite introducir contextos largos con millones de tokens, ajustar modelos para tareas específicas, generar salidas estructuradas como JSON y aprovechar capacidades como la recuperación semántica y la ejecución de código.
En este tutorial, te mostraremos cómo crear un flujo de trabajo RAG (Retrieval-Augmented Generation) con Milvus y Gemini. Utilizaremos el modelo Gemini para generar respuestas basadas en una consulta determinada, complementadas con información relevante recuperada de Milvus.
Preparación
Dependencias y entorno
En primer lugar, instala los paquetes necesarios:
$ pip install --upgrade pymilvus milvus-lite google-genai requests tqdm
Si utilizas Google Colab, para habilitar las dependencias que acabas de instalar, es posible que tengas que reiniciar el entorno de ejecución (haz clic en el menú «Runtime» en la parte superior de la pantalla y selecciona «Restart session» en el menú desplegable).
En primer lugar, debes iniciar sesión en la plataforma Google AI Studio y configurar la clave API GEMINI_API_KEY como variable de entorno.
import os

os.environ["GEMINI_API_KEY"] = "***********"
Prepara los datos
Utilizamos las páginas de preguntas frecuentes de la documentación de Milvus 2.4.x como conocimiento privado en nuestro RAG, lo cual constituye una buena fuente de datos para un proceso de RAG sencillo.
Descarga el archivo zip y extrae los documentos a la carpeta milvus_docs.
$ wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip
$ unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
Cargamos todos los archivos Markdown de la carpeta milvus_docs/en/faq. Para cada documento, simplemente utilizamos «# » para separar el contenido del archivo, lo que permite dividir a grandes rasgos el contenido de cada parte principal del archivo Markdown.
from glob import glob

text_lines = []

for file_path in glob("milvus_docs/en/faq/*.md", recursive=True):
    with open(file_path, "r") as file:
        file_text = file.read()

    text_lines += file_text.split("# ")
Preparación del LLM y del modelo de incrustación
Utilizamos gemini-2.5-flash como LLM y gemini-embedding-2-preview como modelo de incrustación. gemini-embedding-2-preview es el último modelo de incrustación multimodal de Google, que admite texto, imágenes, vídeo, audio y documentos PDF con dimensiones de salida flexibles (128–3.072) a través del aprendizaje de representaciones Matryoshka.
Intentemos generar una respuesta de prueba a partir del LLM:
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-2.5-flash", contents="who are you"
)
print(response.text)
I am a large language model, trained by Google.

I'm designed to process and generate human-like text based on the vast amount of data I was trained on. This allows me to:

*   Answer questions
*   Provide summaries
*   Generate creative content
*   Translate languages
*   And much more

I don't have personal experiences, feelings, or consciousness. I'm a tool designed to be helpful and informative.
Genera una incrustación de prueba y muestra su dimensión y los primeros elementos.
test_embeddings = client.models.embed_content(
    model="gemini-embedding-2-preview", contents=["This is a test1", "This is a test2"]
)

embedding_dim = len(test_embeddings.embeddings[0].values)
print(embedding_dim)
print(test_embeddings.embeddings[0].values[:10])
3072
[-0.016769307, 0.013630492, 0.020277105, 0.0035285393, 0.003968259, -0.013498845, 0.028525498, 0.025498547, -0.021553498, 0.015233516]
Cargar datos en Milvus
Crear la colección
Inicialicemos el cliente de Milvus y configuremos nuestra colección:
from pymilvus import MilvusClient

milvus_client = MilvusClient(uri="./milvus_demo.db")

collection_name = "my_rag_collection"
En cuanto al argumento de ` MilvusClient`:
- Configurar `
uri` como un archivo local, por ejemplo, `./milvus.db`, es el método más cómodo, ya que utiliza automáticamente Milvus Lite para almacenar todos los datos en este archivo. - Si dispones de una gran cantidad de datos, puedes configurar un servidor Milvus de mayor rendimiento en Docker o Kubernetes. En esta configuración, utiliza la URI del servidor, por ejemplo,
http://localhost:19530, como tuuri. - Si desea utilizar Zilliz Cloud, el servicio en la nube totalmente gestionado para Milvus, modifique los campos «
uri» y «token», que se corresponden con el «Public Endpoint» y la «API key» de Zilliz Cloud.
Comprueba si la colección ya existe y, en caso afirmativo, elimínala.
if milvus_client.has_collection(collection_name):
    milvus_client.drop_collection(collection_name)
Crea una nueva colección con los parámetros especificados.
Si no especificamos ninguna información de campo, Milvus creará automáticamente un campo predeterminado « id » para la clave primaria y un campo « vector » para almacenar los datos vectoriales. Se utiliza un campo JSON reservado para almacenar los campos no definidos en el esquema y sus valores.
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=embedding_dim,
    metric_type="IP",  # Inner product distance
    # Strong consistency waits for all loads to complete, adding latency with large datasets
    # consistency_level="Strong",  # Strong consistency level
)
Insertar datos
Recorre las líneas de texto, crea representaciones y, a continuación, inserta los datos en Milvus.
Aquí hay un nuevo campo « text », que es un campo no definido en el esquema de la colección. Se añadirá automáticamente al campo dinámico JSON reservado, que, a grandes rasgos, puede tratarse como un campo normal.
from tqdm import tqdm

data = []

doc = client.models.embed_content(model="gemini-embedding-2-preview", contents=text_lines)

for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):
    data.append({"id": i, "vector": doc.embeddings[i].values, "text": line})

milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████| 72/72 [00:00<00:00, 337796.30it/s]


{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
Crear un RAG
Recuperar datos para una consulta
Especifiquemos una pregunta frecuente sobre Milvus.
question = "How is data stored in milvus?"
Busca la pregunta en la colección y recupera las tres coincidencias semánticas principales.
quest_embed = client.models.embed_content(model="gemini-embedding-2-preview", contents=question)

search_res = milvus_client.search(
    collection_name=collection_name,
    data=[quest_embed.embeddings[0].values],
    limit=3,  # Return top 3 results
    search_params={"metric_type": "IP", "params": {}},  # Inner product distance
    output_fields=["text"],  # Return the text field
)
Echemos un vistazo a los resultados de búsqueda de la consulta
import json

retrieved_lines_with_distances = [
    (res["entity"]["text"], res["distance"]) for res in search_res[0]
]
print(json.dumps(retrieved_lines_with_distances, indent=4))
[
    [
        " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",
        0.864
    ],
    [
        "Why is there no vector data in etcd?\n\netcd stores Milvus module metadata; MinIO stores entities.",
        0.7923
    ],
    [
        "What is the maximum dataset size Milvus can handle?\n\n  \nTheoretically, the maximum dataset size Milvus can handle is determined by the hardware it is run on, specifically system memory and storage:\n\n- Milvus loads all specified collections and partitions into memory before running queries. Therefore, memory size determines the maximum amount of data Milvus can query.\n- When new entities and and collection-related schema (currently only MinIO is supported for data persistence) are added to Milvus, system storage determines the maximum allowable size of inserted data.\n\n###",
        0.7857
    ]
]
Utiliza un modelo de lenguaje grande (LLM) para obtener una respuesta RAG
Convertir los documentos recuperados a formato de cadena.
context = "\n".join(
    [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances]
)
Definamos las indicaciones del sistema y del usuario para el modelo de lenguaje. Esta indicación se elabora a partir de los documentos recuperados de Milvus.
from google.genai import types

SYSTEM_PROMPT = """
Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided.
"""
USER_PROMPT = f"""
Use the following pieces of information enclosed in <context> tags to provide an answer to the question enclosed in <question> tags.
<context>
{context}
</context>
<question>
{question}
</question>
"""
Utiliza Gemini para generar una respuesta basada en las indicaciones.
response = client.models.generate_content(
    model="gemini-2.5-flash",
    config=types.GenerateContentConfig(system_instruction=SYSTEM_PROMPT),
    contents=USER_PROMPT,
)
print(response.text)
Milvus stores data in two main ways:

1.  **Inserted Data:** This includes vector data, scalar data, and collection-specific schema. This type of data is stored in persistent storage as an incremental log. Milvus supports various object storage backends for this, such as MinIO, AWS S3, Google Cloud Storage (GCS), Azure Blob Storage, Alibaba Cloud OSS, and Tencent Cloud Object Storage (COS).
2.  **Metadata:** Metadata is generated within Milvus by its various modules. Each module's metadata is stored in etcd.
Búsqueda multimodal
Dado que gemini-embedding-2-preview mapea texto, imágenes y otras modalidades en el mismo espacio de incrustación, podemos realizar búsquedas multimodales; por ejemplo, utilizando una consulta de texto para encontrar las imágenes más relevantes.
Preparación de los datos de imagen
Descargamos un conjunto de diagramas de la arquitectura RAG del repositorio de Milvus Bootcamp para utilizarlos como nuestro conjunto de datos de imágenes.
import urllib.request
from pathlib import Path

image_dir = Path("images")
image_dir.mkdir(exist_ok=True)

image_files = [
    "vanilla_rag.png",
    "hyde.png",
    "query_routing.png",
    "self_reflection.png",
    "hybrid_and_rerank.png",
    "hierarchical_index.png",
]

base_url = "https://raw.githubusercontent.com/milvus-io/bootcamp/master/pics/advanced_rag/"

for fname in image_files:
    path = image_dir / fname
    if not path.exists():
        urllib.request.urlretrieve(base_url + fname, path)
        print(f"Downloaded {fname}")
    else:
        print(f"Already exists {fname}")

print(f"\nTotal images: {len(image_files)}")
Downloaded vanilla_rag.png
Downloaded hyde.png
Downloaded query_routing.png
Downloaded self_reflection.png
Downloaded hybrid_and_rerank.png
Downloaded hierarchical_index.png

Total images: 6
Incrustar imágenes y almacenarlas en Milvus
Leemos cada imagen como bytes y la pasamos a gemini-embedding-2-preview para generar representaciones, y luego las almacenamos en una nueva colección de Milvus.
from google.genai import types

image_data = []

for fname in image_files:
    path = image_dir / fname
    with open(path, "rb") as f:
        image_bytes = f.read()

    result = client.models.embed_content(
        model="gemini-embedding-2-preview",
        contents=types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
    )
    image_data.append(
        {
            "id": len(image_data),
            "vector": result.embeddings[0].values,
            "filename": fname,
        }
    )
    print(f"Embedded {fname}")

# Create a new collection for images
image_collection = "image_collection"
if milvus_client.has_collection(image_collection):
    milvus_client.drop_collection(image_collection)

milvus_client.create_collection(
    collection_name=image_collection,
    dimension=len(image_data[0]["vector"]),
    metric_type="IP",
)

milvus_client.insert(collection_name=image_collection, data=image_data)
print(f"\nInserted {len(image_data)} image embeddings (dim={len(image_data[0]['vector'])})")
Embedded vanilla_rag.png
Embedded hyde.png
Embedded query_routing.png
Embedded self_reflection.png
Embedded hybrid_and_rerank.png
Embedded hierarchical_index.png

Inserted 6 image embeddings (dim=3072)
Búsqueda multimodal: consulta de texto → resultados de imágenes
Ahora utilicemos una consulta de texto para buscar entre las representaciones de las imágenes. Dado que tanto el texto como las imágenes se mapean en el mismo espacio de representaciones, podemos compararlos directamente.
from IPython.display import display, Image

text_queries = [
    "How does a basic RAG pipeline work?",
    "What is the hypothetical document embedding approach?",
    "How to combine hybrid search with reranking?",
]

for query in text_queries:
    query_embed = client.models.embed_content(
        model="gemini-embedding-2-preview", contents=query
    )

    results = milvus_client.search(
        collection_name=image_collection,
        data=[query_embed.embeddings[0].values],
        limit=1,
        search_params={"metric_type": "IP", "params": {}},
        output_fields=["filename"],
    )

    best = results[0][0]
    print(f"\nQuery: {query}")
    print(f"Match: {best['entity']['filename']} (score: {best['distance']:.4f})")
    display(Image(filename=str(image_dir / best["entity"]["filename"]), width=600))
Query: How does a basic RAG pipeline work?
Match: vanilla_rag.png (score: 0.5132)
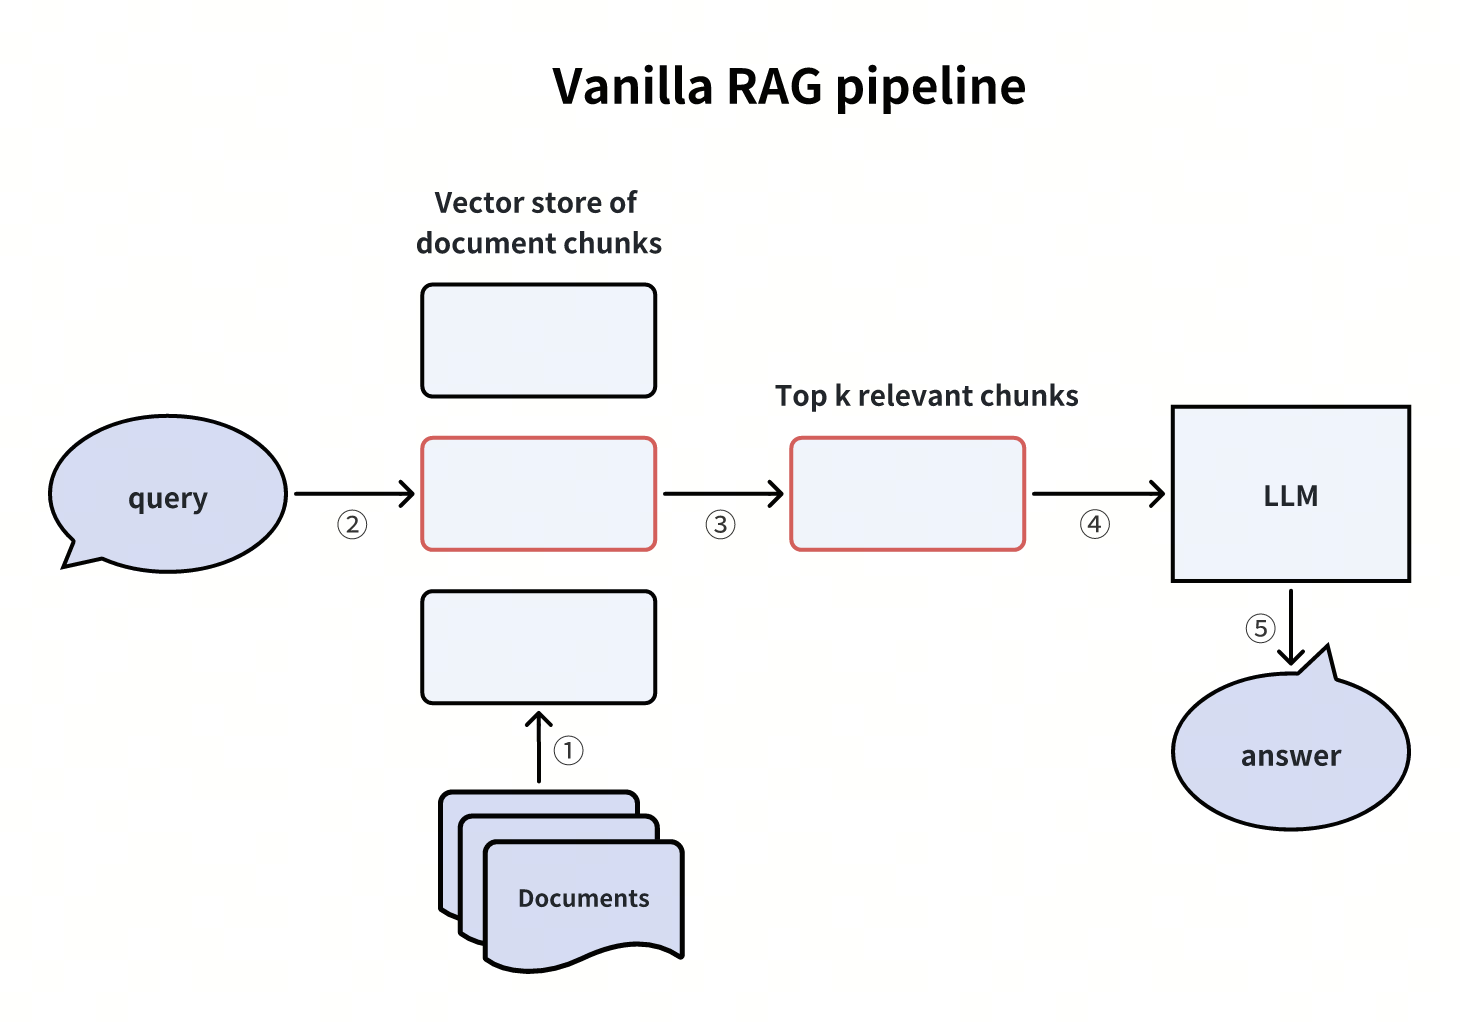 Pipeline RAG básico
Query: What is the hypothetical document embedding approach?
Match: hyde.png (score: 0.4756)
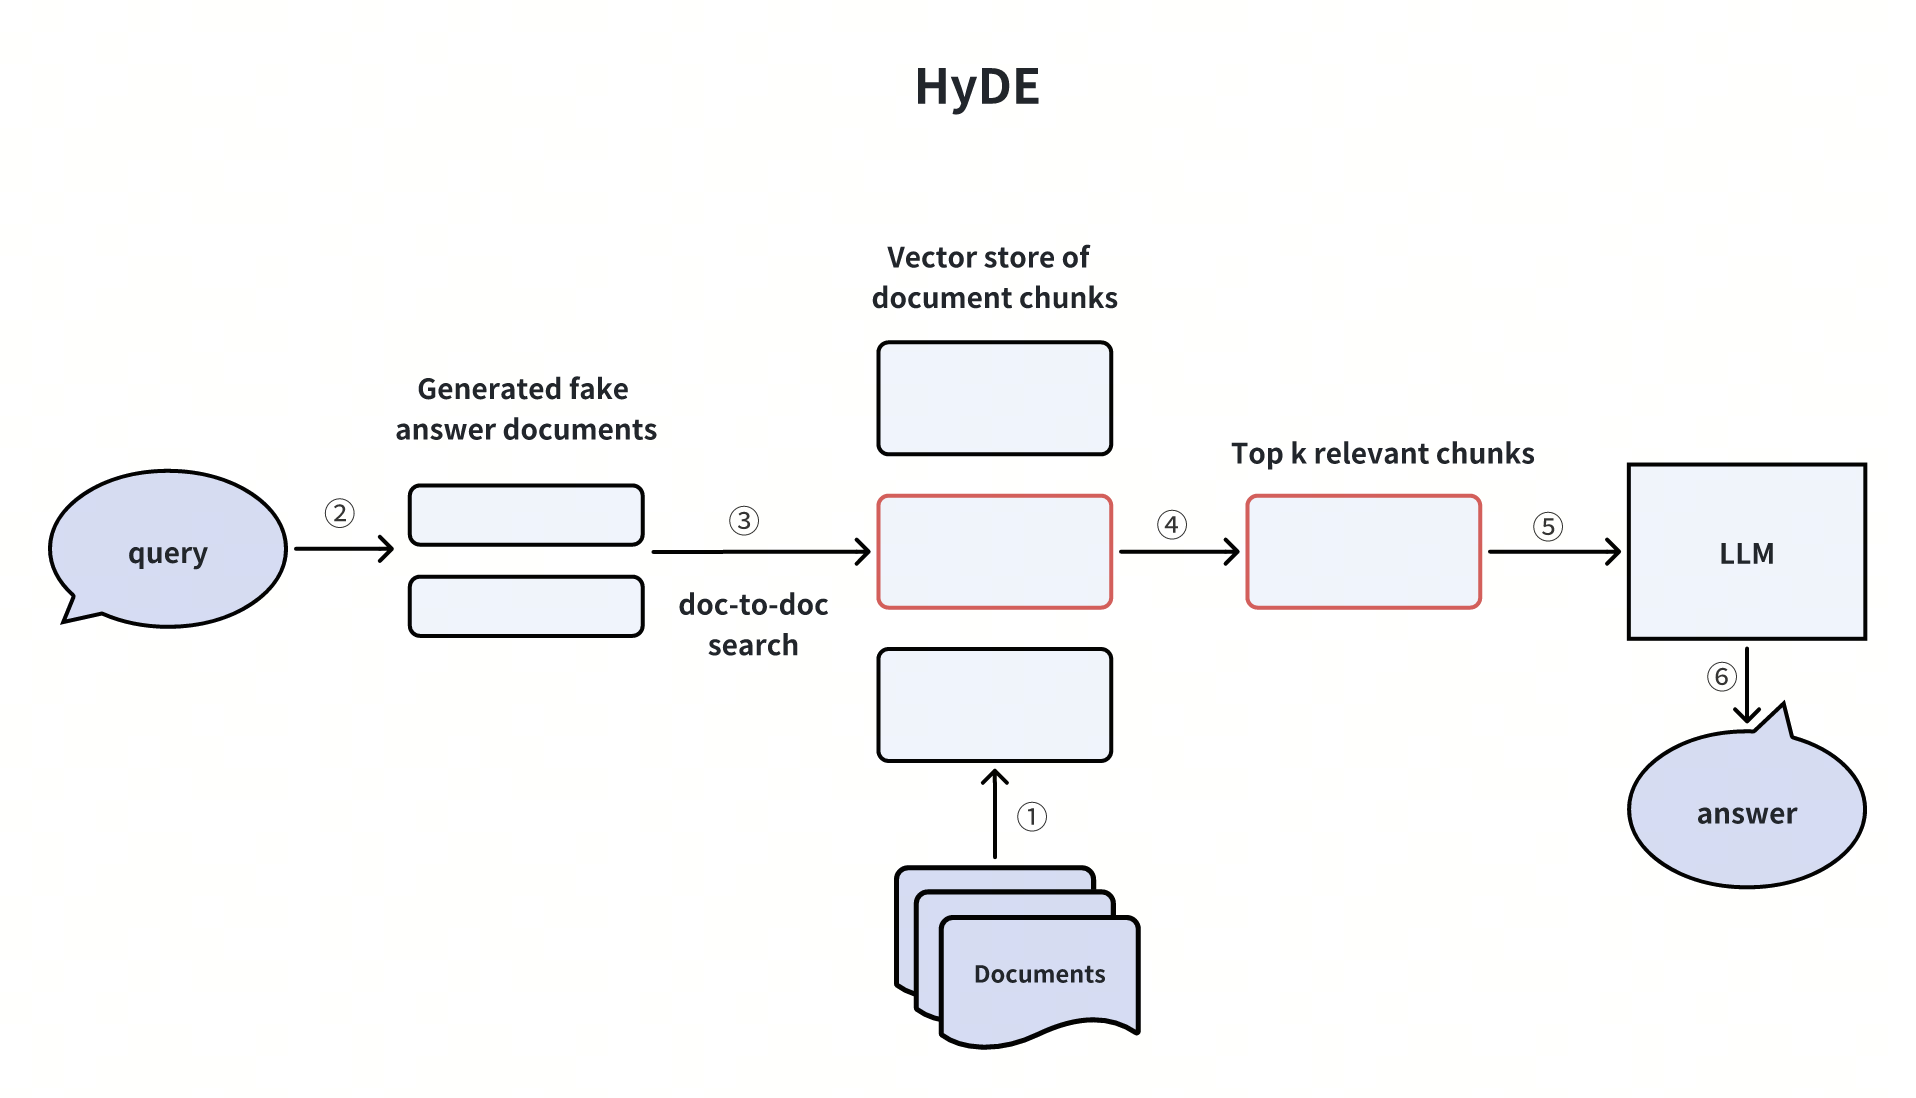 HyDE
Query: How to combine hybrid search with reranking?
Match: hybrid_and_rerank.png (score: 0.5271)
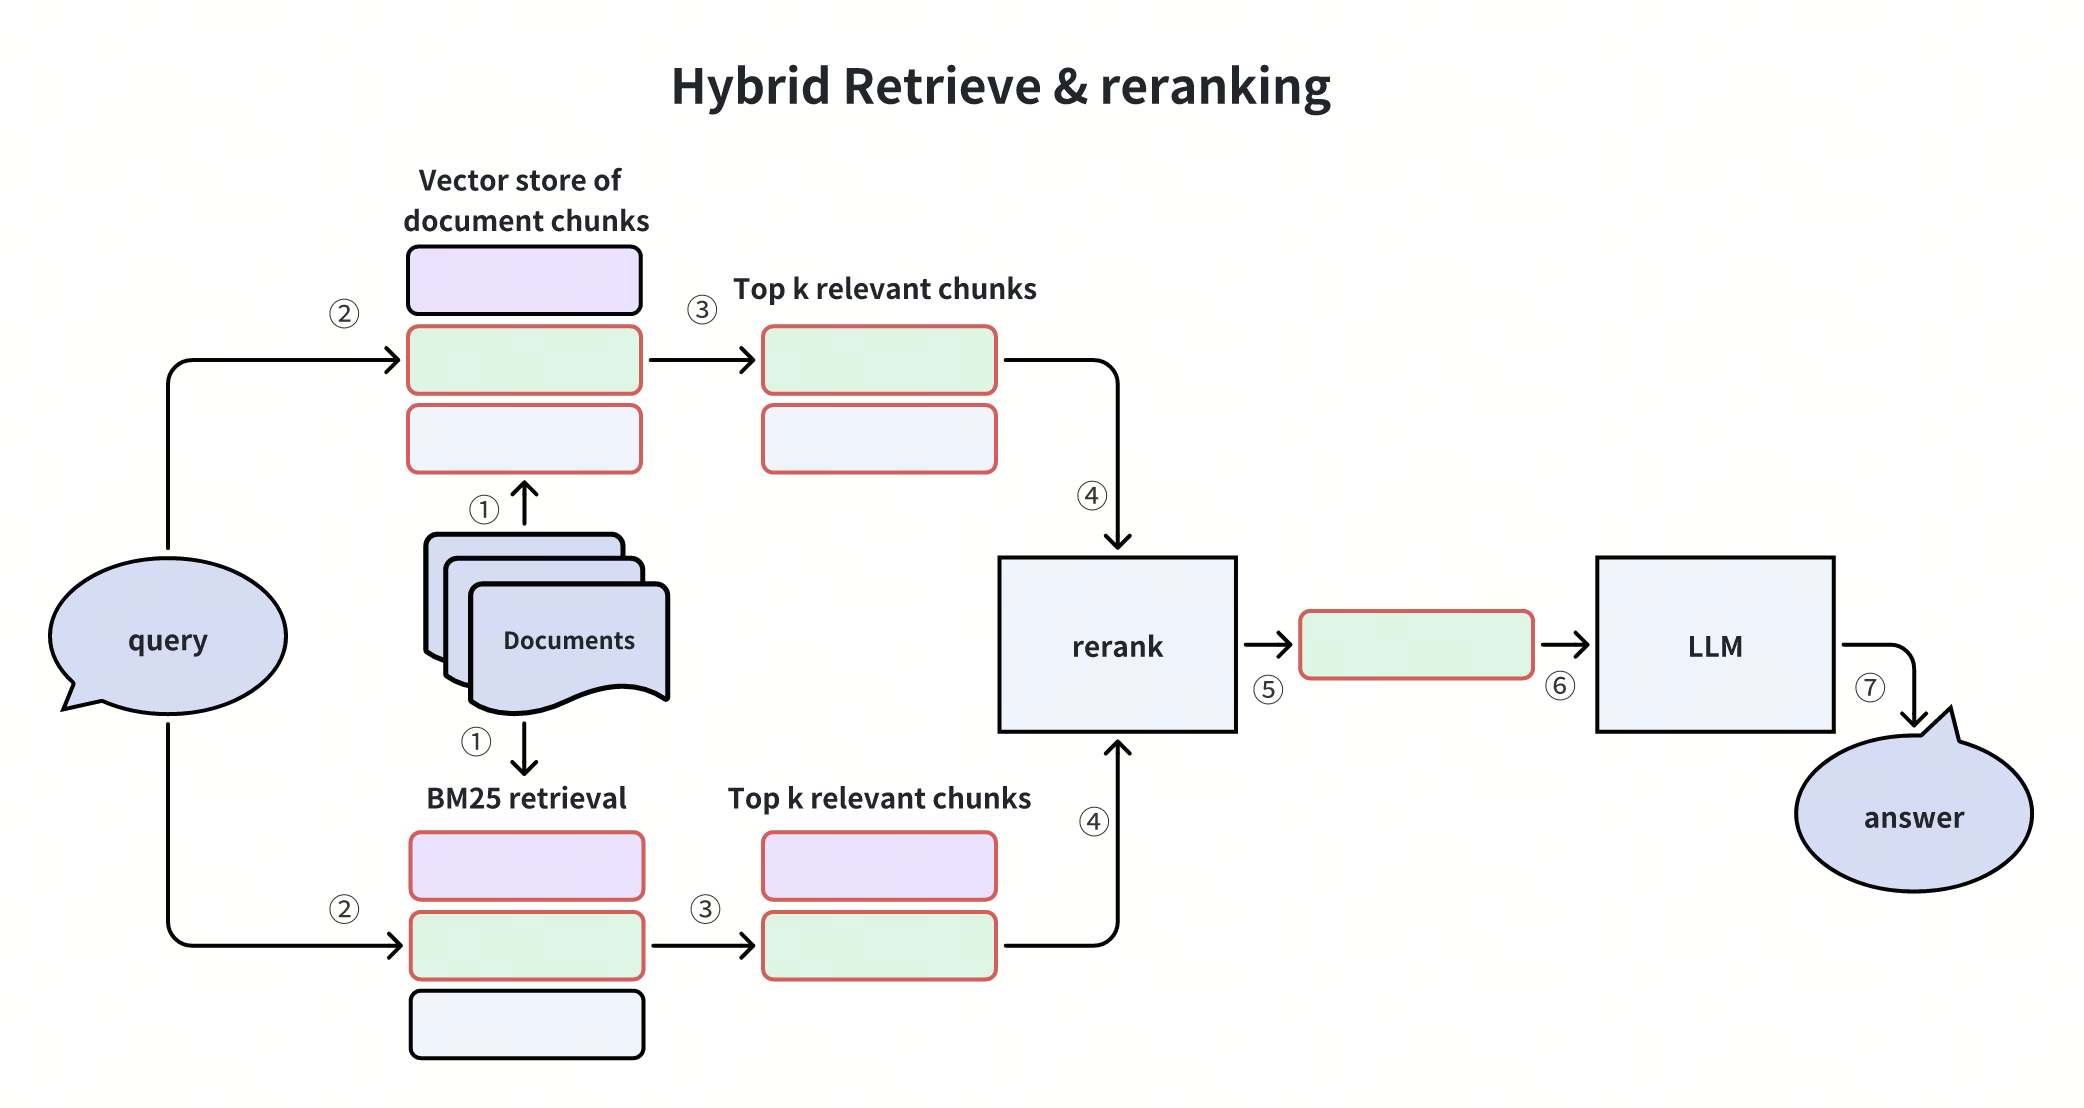 Recuperación híbrida y reordenación
¡Genial! Hemos creado con éxito un proceso RAG con Milvus y Gemini, y hemos demostrado la búsqueda multimodal utilizando consultas de texto para recuperar imágenes relevantes, todo ello gracias al espacio de incrustación unificado de gemini-embedding-2-preview.
