

Dichter Vektor
Dichte Vektoren sind numerische Datendarstellungen, die im maschinellen Lernen und in der Datenanalyse weit verbreitet sind. Sie bestehen aus Arrays mit reellen Zahlen, wobei die meisten oder alle Elemente ungleich Null sind. Im Vergleich zu spärlichen Vektoren enthalten dichte Vektoren bei gleicher Dimensionsanzahl mehr Informationen, da jede Dimension aussagekräftige Werte enthält. Diese Darstellung kann komplexe Muster und Beziehungen effektiv erfassen, wodurch sich Daten in hochdimensionalen Räumen leichter analysieren und verarbeiten lassen. Dichte Vektoren haben typischerweise eine feste Anzahl von Dimensionen, die je nach spezifischer Anwendung und Anforderungen von einigen Dutzend bis zu mehreren Hundert oder sogar Tausenden reicht.
Dichte Vektoren werden hauptsächlich in Szenarien eingesetzt, die ein Verständnis der Semantik von Daten erfordern, wie beispielsweise bei der semantischen Suche und in Empfehlungssystemen. Bei der semantischen Suche helfen dichte Vektoren dabei, die zugrunde liegenden Zusammenhänge zwischen Suchanfragen und Dokumenten zu erfassen und so die Relevanz der Suchergebnisse zu verbessern. In Empfehlungssystemen unterstützen sie die Identifizierung von Ähnlichkeiten zwischen Nutzern und Objekten und ermöglichen so personalisiertere Vorschläge.
Überblick
Dichte Vektoren werden typischerweise als Arrays aus Gleitkommazahlen mit fester Länge dargestellt, beispielsweise [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. Die Dimensionalität dieser Vektoren reicht in der Regel von Hunderten bis zu Tausenden, wie etwa 128, 256, 768 oder 1024. Jede Dimension erfasst spezifische semantische Merkmale eines Objekts, wodurch es durch Ähnlichkeitsberechnungen auf verschiedene Szenarien anwendbar ist.
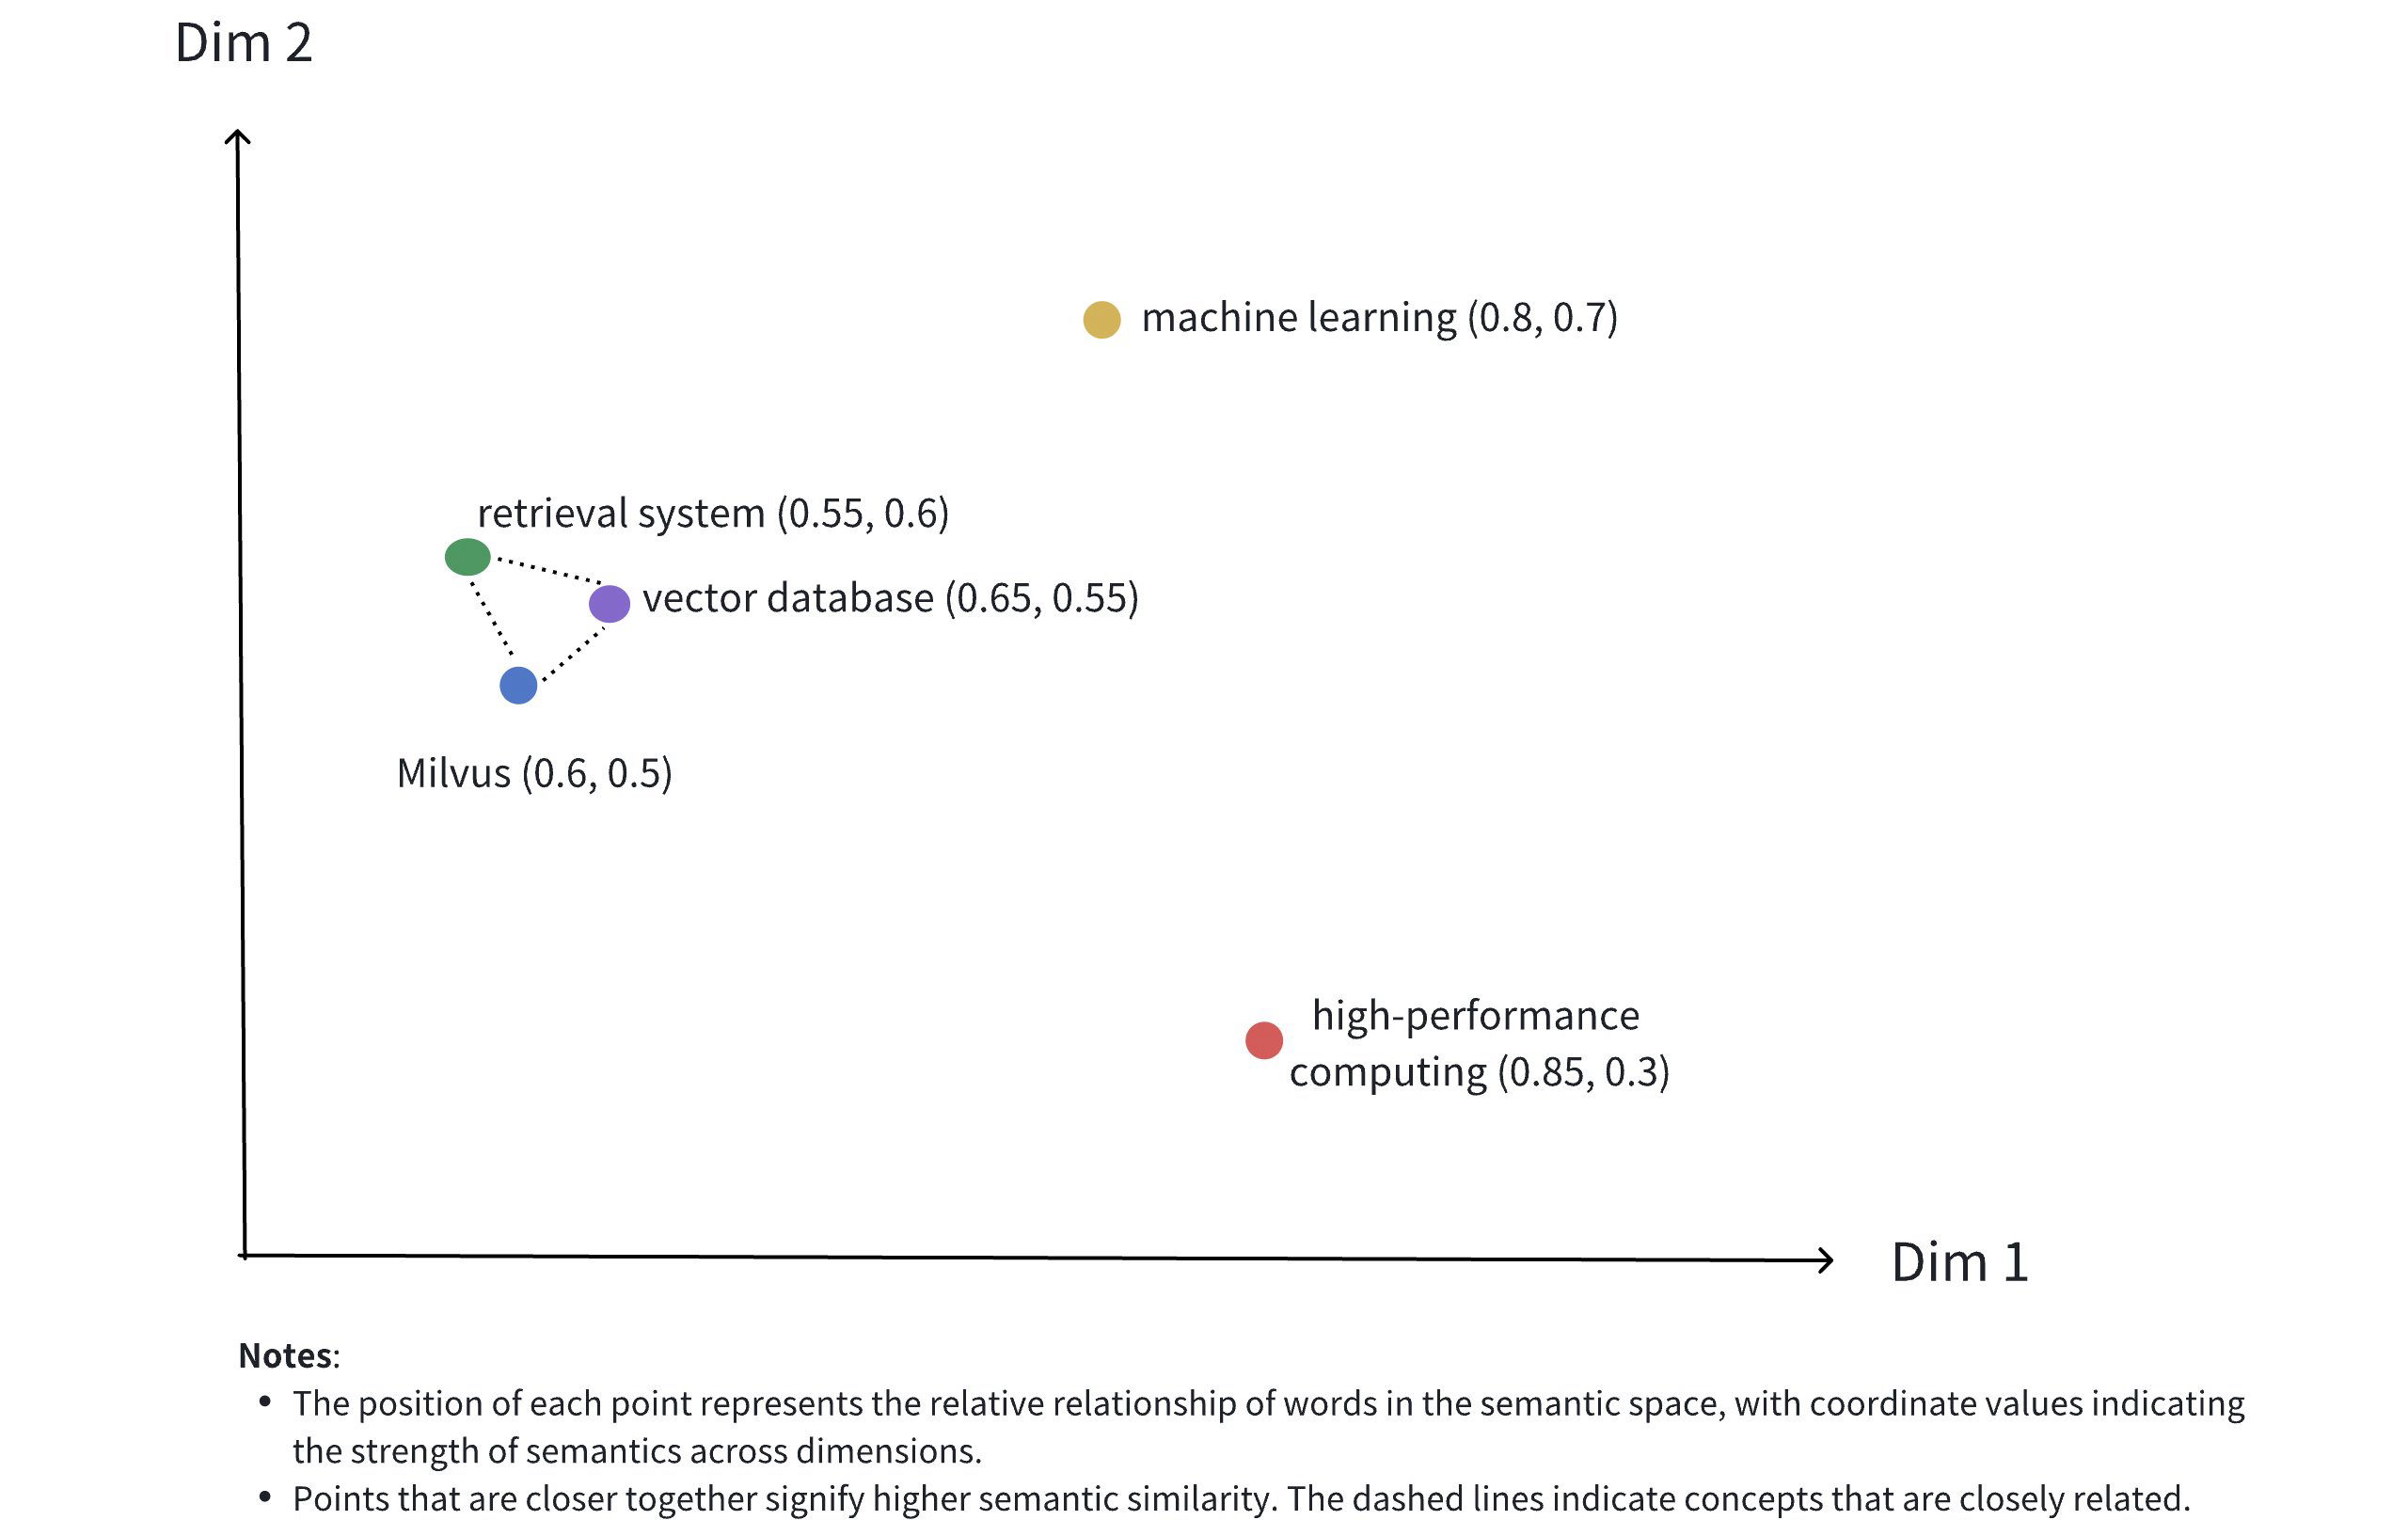 Dichter Vektor
Die obige Abbildung veranschaulicht die Darstellung dichter Vektoren in einem 2D-Raum. Obwohl dichte Vektoren in realen Anwendungen oft weitaus höhere Dimensionen aufweisen, vermittelt diese 2D-Darstellung auf anschauliche Weise mehrere Schlüsselkonzepte:
Mehrdimensionale Darstellung: Jeder Punkt repräsentiert ein konzeptionelles Objekt (wie Milvus, eine Vektordatenbank, ein Abrufsystem usw.), dessen Position durch die Werte seiner Dimensionen bestimmt wird.
Semantische Beziehungen: Die Abstände zwischen den Punkten spiegeln die semantische Ähnlichkeit zwischen den Konzepten wider. Näher beieinander liegende Punkte weisen auf Konzepte hin, die semantisch enger miteinander verbunden sind.
Clustering-Effekt: Verwandte Konzepte (wie Milvus, Vektordatenbank und Abrufsystem) sind im Raum nahe beieinander positioniert und bilden einen semantischen Cluster.
Nachfolgend finden Sie ein Beispiel für einen echten dichten Vektor, der den Text „ "Milvus is an efficient vector database" “ darstellt:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
Dichte Vektoren können mithilfe verschiedener Einbettungsmodelle generiert werden, beispielsweise CNN-Modelle (wie ResNet, VGG) für Bilder und Sprachmodelle (wie BERT, Word2Vec) für Text. Diese Modelle wandeln Rohdaten in Punkte im hochdimensionalen Raum um und erfassen dabei die semantischen Merkmale der Daten. Darüber hinaus bietet Milvus praktische Methoden, die Anwendern bei der Generierung und Verarbeitung dichter Vektoren helfen, wie im Abschnitt „Embeddings“ näher beschrieben.
Sobald die Daten vektorisiert sind, können sie in Milvus zur Verwaltung und zum Abruf der Vektoren gespeichert werden. Das folgende Diagramm veranschaulicht den grundlegenden Prozess.
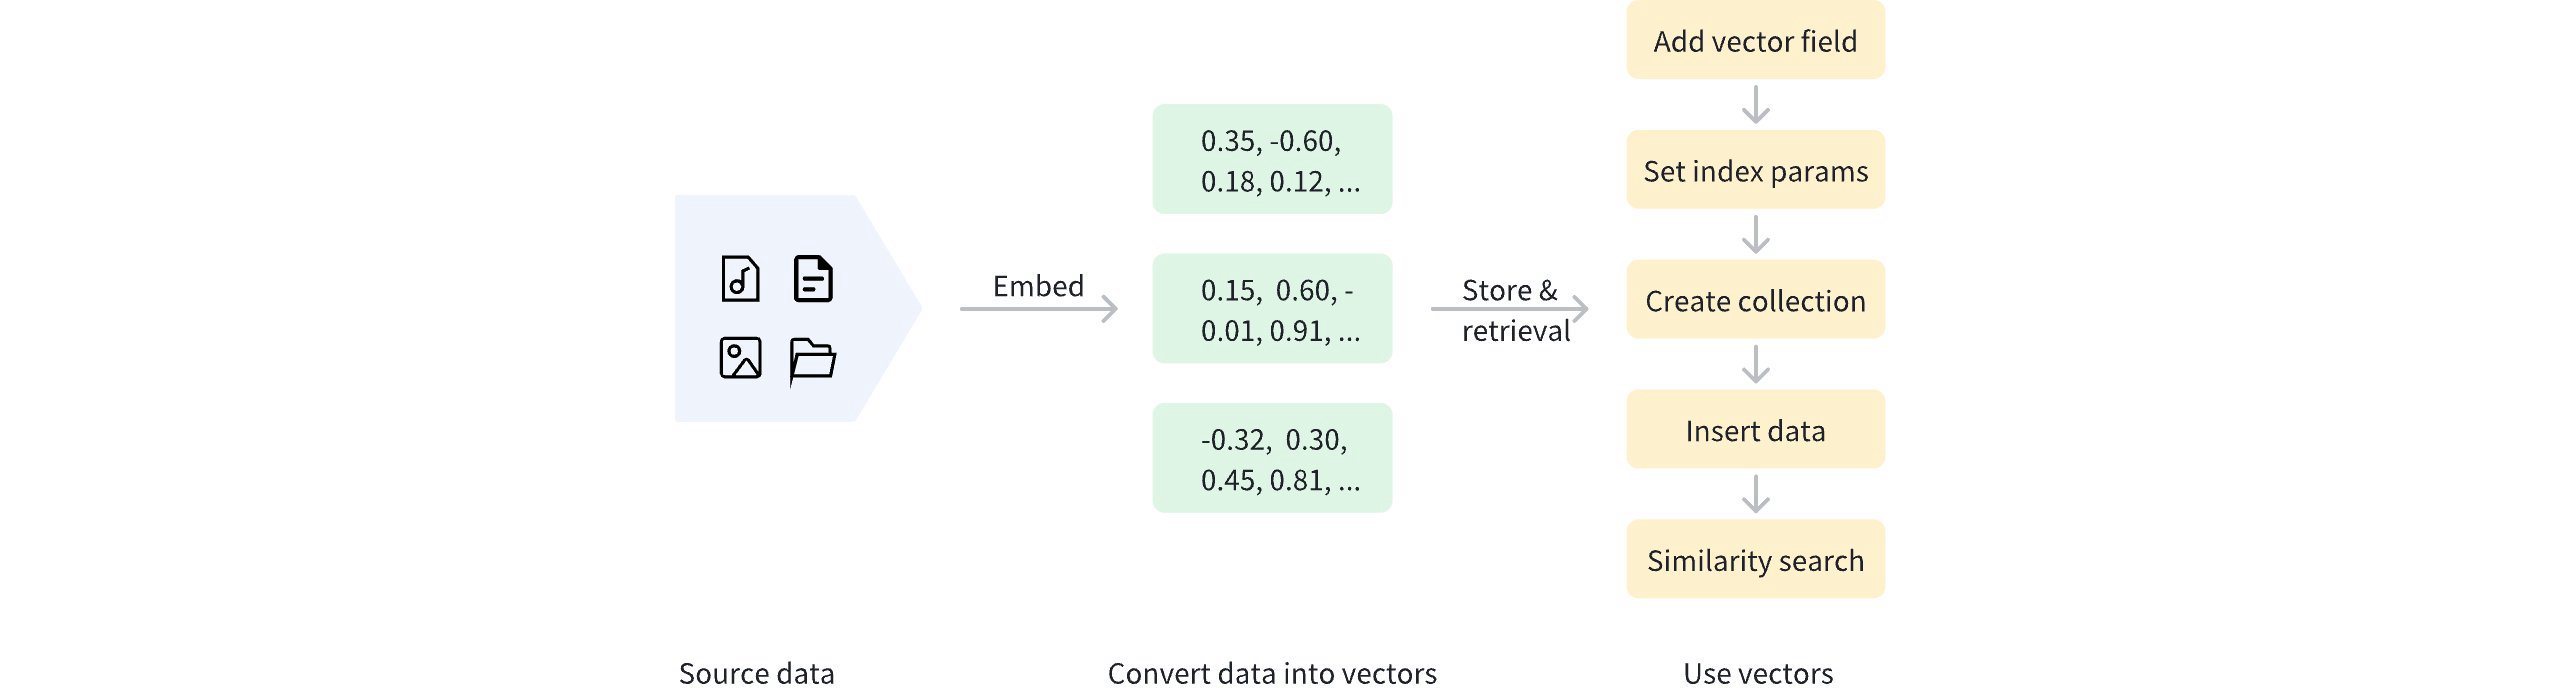 Dichte Vektoren verwenden
Neben dichten Vektoren unterstützt Milvus auch spärliche Vektoren und binäre Vektoren. Spärliche Vektoren eignen sich für präzise Übereinstimmungen auf der Grundlage bestimmter Begriffe, wie beispielsweise die Stichwortsuche und den Begriffsabgleich, während binäre Vektoren häufig für die effiziente Verarbeitung binarisierter Daten verwendet werden, wie zum Beispiel beim Abgleich von Bildmustern und bei bestimmten Hashing-Anwendungen. Weitere Informationen finden Sie unter „Binäre Vektoren “ und „Spärliche Vektoren“.
Verwendung von dichten Vektoren
Vektorfeld hinzufügen
Um dichte Vektoren in Milvus zu verwenden, definieren Sie zunächst bei der Erstellung einer Sammlung ein Vektorfeld zum Speichern dichter Vektoren. Dieser Vorgang umfasst:
Setzen Sie „
datatype“ auf einen unterstützten Datentyp für dichte Vektoren. Informationen zu den unterstützten Datentypen für dichte Vektoren finden Sie unter „Datentypen“.Angabe der Dimensionen des dichten Vektors mithilfe des Parameters „
dim“.
Im folgenden Beispiel fügen wir ein Vektorfeld namens „ dense_vector “ hinzu, um dichte Vektoren zu speichern. Der Datentyp des Feldes lautet „ FLOAT_VECTOR “ mit einer Dimension von „ 4 “.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Unterstützte Datentypen für dichte Vektorfelder:
Datentyp |
Beschreibung |
|---|---|
|
Speichert 32-Bit-Gleitkommazahlen, die üblicherweise zur Darstellung reeller Zahlen in wissenschaftlichen Berechnungen und im maschinellen Lernen verwendet werden. Ideal für Szenarien, die eine hohe Genauigkeit erfordern, wie beispielsweise die Unterscheidung ähnlicher Vektoren. |
|
Speichert 16-Bit-Gleitkommazahlen mit halber Genauigkeit, die für Deep Learning und GPU-Berechnungen verwendet werden. Dies spart Speicherplatz in Szenarien, in denen die Genauigkeit weniger kritisch ist, wie beispielsweise in der Recall-Phase mit geringer Genauigkeit von Empfehlungssystemen. |
|
Speichert 16-Bit-Brain-Floating-Point-Zahlen (bfloat16), die denselben Exponentenbereich wie Float32 bieten, jedoch mit geringerer Genauigkeit. Geeignet für Szenarien, in denen große Mengen an Vektoren schnell verarbeitet werden müssen, wie z. B. bei der groß angelegten Bildsuche. |
|
Speichert Vektoren, deren einzelne Elemente in jeder Dimension 8-Bit-Ganzzahlen (int8) sind, wobei jedes Element im Bereich von –128 bis 127 liegt. INT8_VECTOR wurde für quantisierte Deep-Learning-Modelle (z. B. ResNet, EfficientNet) entwickelt und reduziert die Modellgröße sowie beschleunigt die Inferenz bei minimalem Präzisionsverlust. |
Indexparameter für Vektorfeld festlegen
Um semantische Suchvorgänge zu beschleunigen, muss ein Index für das Vektorfeld erstellt werden. Die Indizierung kann die Effizienz der Abfrage großer Vektordatenmengen erheblich verbessern.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
Im obigen Beispiel wird für das Feld „ dense_vector “ ein Index namens „ dense_vector_index “ unter Verwendung des Indextyps „ AUTOINDEX “ erstellt. Die „ metric_type “ ist auf „ IP “ gesetzt, was angibt, dass das Skalarprodukt als Distanzmetrik verwendet wird.
Milvus bietet verschiedene Indextypen für eine optimierte Vektorsuche. AUTOINDEX ist ein spezieller Indextyp, der entwickelt wurde, um den Einstieg in die Vektorsuche zu erleichtern. Es stehen zahlreiche Indextypen zur Auswahl. Weitere Informationen finden Sie unter „Index-Erklärung“.
Milvus unterstützt weitere Metriktypen. Weitere Informationen finden Sie unter „Metriktypen“.
Sammlung erstellen
Sobald die Einstellungen für dichte Vektoren und Indexparameter abgeschlossen sind, können Sie eine Sammlung erstellen, die dichte Vektoren enthält. Im folgenden Beispiel wird die Methode „ create_collection “ verwendet, um eine Sammlung mit dem Namen „ my_collection “ zu erstellen.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Daten einfügen
Verwenden Sie nach dem Erstellen der Sammlung die Methode ` insert `, um Daten hinzuzufügen, die dichte Vektoren enthalten. Stellen Sie sicher, dass die Dimensionalität der einzufügenden dichten Vektoren mit dem Wert ` dim ` übereinstimmt, der beim Hinzufügen des Felds für dichte Vektoren definiert wurde.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
Ähnlichkeitssuche durchführen
Die semantische Suche auf Basis dichter Vektoren ist eine der Kernfunktionen von Milvus. Sie ermöglicht es Ihnen, anhand des Abstands zwischen Vektoren schnell die Daten zu finden, die einem Abfragevektor am ähnlichsten sind. Um eine Ähnlichkeitssuche durchzuführen, bereiten Sie den Abfragevektor und die Suchparameter vor und rufen Sie anschließend die Methode „ search “ auf.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
Weitere Informationen zu den Parametern für die Ähnlichkeitssuche finden Sie unter „Grundlegende ANN-Suche“.
