


RAG mit Milvus und Gemini erstellen
Die Gemini-API und Google AI Studio helfen Ihnen dabei, mit den neuesten Modellen von Google zu arbeiten und Ihre Ideen in skalierbare Anwendungen umzusetzen. Gemini bietet Zugriff auf leistungsstarke Sprachmodelle wie „ Gemini-2.5-Flash “ und „ Gemini-2.5-Pro “ für Aufgaben wie Textgenerierung, Dokumentenverarbeitung, Bildverarbeitung, Audioanalyse und vieles mehr. Außerdem bietet es „ Gemini Embedding 2 “, ein multimodales Einbettungsmodell, das Text, Bilder, Videos, Audio und PDF-Dokumente mit flexiblen Ausgabedimensionen über „Matryoshka Representation Learning“ unterstützt. Die API ermöglicht es Ihnen, lange Kontexte mit Millionen von Tokens einzugeben, Modelle für bestimmte Aufgaben fein abzustimmen, strukturierte Ausgaben wie JSON zu generieren und Funktionen wie semantisches Retrieval und Codeausführung zu nutzen.
In diesem Tutorial zeigen wir Ihnen, wie Sie mit Milvus und Gemini eine RAG-Pipeline (Retrieval-Augmented Generation) aufbauen. Wir werden das Gemini-Modell verwenden, um Antworten auf der Grundlage einer vorgegebenen Anfrage zu generieren, ergänzt durch relevante Informationen, die aus Milvus abgerufen werden.
Vorbereitung
Voraussetzungen und Umgebung
Installieren Sie zunächst die erforderlichen Pakete:
$ pip install --upgrade pymilvus milvus-lite google-genai requests tqdm
Wenn Sie Google Colab verwenden, müssen Sie möglicherweise die Laufzeitumgebung neu starten, um die soeben installierten Abhängigkeiten zu aktivieren (klicken Sie oben auf dem Bildschirm auf das Menü „Runtime“ und wählen Sie im Dropdown-Menü „Restart session“ aus).
Sie sollten sich zunächst bei der Google AI Studio-Plattform anmelden und den API-Schlüssel GEMINI_API_KEY als Umgebungsvariable vorbereiten.
import os

os.environ["GEMINI_API_KEY"] = "***********"
Daten vorbereiten
Wir verwenden die FAQ-Seiten aus der Milvus-Dokumentation 2.4.x als privates Wissen in unserem RAG – dies ist eine gute Datenquelle für eine einfache RAG-Pipeline.
Laden Sie die ZIP-Datei herunter und extrahieren Sie die Dokumente in den Ordner „ milvus_docs “.
$ wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip
$ unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
Wir laden alle Markdown-Dateien aus dem Ordner „ milvus_docs/en/faq “ ein. Für jedes Dokument verwenden wir einfach „# “ zur Trennung des Inhalts in der Datei, wodurch sich der Inhalt der einzelnen Hauptabschnitte der Markdown-Datei grob voneinander abgrenzen lässt.
from glob import glob

text_lines = []

for file_path in glob("milvus_docs/en/faq/*.md", recursive=True):
    with open(file_path, "r") as file:
        file_text = file.read()

    text_lines += file_text.split("# ")
Vorbereitung des LLM und des Embedding-Modells
Wir verwenden „ gemini-2.5-flash “ als LLM und „ gemini-embedding-2-preview “ als Embedding-Modell. „ gemini-embedding-2-preview “ ist Googles neuestes multimodales Embedding-Modell, das Text, Bilder, Videos, Audio und PDF-Dokumente mit flexiblen Ausgabedimensionen (128–3.072) über „Matryoshka Representation Learning“ unterstützt.
Versuchen wir, eine Testantwort vom LLM zu generieren:
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-2.5-flash", contents="who are you"
)
print(response.text)
I am a large language model, trained by Google.

I'm designed to process and generate human-like text based on the vast amount of data I was trained on. This allows me to:

*   Answer questions
*   Provide summaries
*   Generate creative content
*   Translate languages
*   And much more

I don't have personal experiences, feelings, or consciousness. I'm a tool designed to be helpful and informative.
Generieren Sie ein Test-Embedding und geben Sie dessen Dimension sowie die ersten paar Elemente aus.
test_embeddings = client.models.embed_content(
    model="gemini-embedding-2-preview", contents=["This is a test1", "This is a test2"]
)

embedding_dim = len(test_embeddings.embeddings[0].values)
print(embedding_dim)
print(test_embeddings.embeddings[0].values[:10])
3072
[-0.016769307, 0.013630492, 0.020277105, 0.0035285393, 0.003968259, -0.013498845, 0.028525498, 0.025498547, -0.021553498, 0.015233516]
Laden Sie die Daten in Milvus
Erstellen Sie die Sammlung
Initialisieren wir den Milvus-Client und richten unsere Sammlung ein:
from pymilvus import MilvusClient

milvus_client = MilvusClient(uri="./milvus_demo.db")

collection_name = "my_rag_collection"
Was das Argument „ MilvusClient “ betrifft:
- Die Angabe von „
uri“ als lokale Datei, z. B. „./milvus.db“, ist die bequemste Methode, da dabei automatisch Milvus Lite verwendet wird, um alle Daten in dieser Datei zu speichern. - Wenn Sie über große Datenmengen verfügen, können Sie einen leistungsfähigeren Milvus-Server auf Docker oder Kubernetes einrichten. Verwenden Sie in dieser Konfiguration bitte die Server-URI, z. B.
http://localhost:19530, als Ihre `uri`. - Wenn Sie Zilliz Cloud, den vollständig verwalteten Cloud-Dienst für Milvus, nutzen möchten, passen Sie die Werte für „
uri“ und „token“ entsprechend dem öffentlichen Endpunkt und dem API-Schlüssel in Zilliz Cloud an.
Prüfen Sie, ob die Sammlung bereits existiert, und löschen Sie sie gegebenenfalls.
if milvus_client.has_collection(collection_name):
    milvus_client.drop_collection(collection_name)
Erstellen Sie eine neue Sammlung mit den angegebenen Parametern.
Wenn keine Feldinformationen angegeben werden, erstellt Milvus automatisch ein Standardfeld „ id “ für den Primärschlüssel und ein Feld „ vector “ zur Speicherung der Vektordaten. Ein reserviertes JSON-Feld dient zur Speicherung von nicht im Schema definierten Feldern und deren Werten.
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=embedding_dim,
    metric_type="IP",  # Inner product distance
    # Strong consistency waits for all loads to complete, adding latency with large datasets
    # consistency_level="Strong",  # Strong consistency level
)
Daten einfügen
Durchlaufen Sie die Textzeilen, erstellen Sie Einbettungen und fügen Sie die Daten anschließend in Milvus ein.
Hier ist ein neues Feld „ text “, das im Schema der Sammlung nicht definiert ist. Es wird automatisch dem dynamischen Feld „reserved JSON“ hinzugefügt, das auf einer übergeordneten Ebene wie ein normales Feld behandelt werden kann.
from tqdm import tqdm

data = []

doc = client.models.embed_content(model="gemini-embedding-2-preview", contents=text_lines)

for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):
    data.append({"id": i, "vector": doc.embeddings[i].values, "text": line})

milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████| 72/72 [00:00<00:00, 337796.30it/s]


{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
RAG erstellen
Daten für eine Abfrage abrufen
Legen wir eine häufig gestellte Frage zu Milvus fest.
question = "How is data stored in milvus?"
Suchen Sie in der Sammlung nach der Frage und rufen Sie die drei semantisch besten Treffer ab.
quest_embed = client.models.embed_content(model="gemini-embedding-2-preview", contents=question)

search_res = milvus_client.search(
    collection_name=collection_name,
    data=[quest_embed.embeddings[0].values],
    limit=3,  # Return top 3 results
    search_params={"metric_type": "IP", "params": {}},  # Inner product distance
    output_fields=["text"],  # Return the text field
)
Werfen wir einen Blick auf die Suchergebnisse der Abfrage
import json

retrieved_lines_with_distances = [
    (res["entity"]["text"], res["distance"]) for res in search_res[0]
]
print(json.dumps(retrieved_lines_with_distances, indent=4))
[
    [
        " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",
        0.864
    ],
    [
        "Why is there no vector data in etcd?\n\netcd stores Milvus module metadata; MinIO stores entities.",
        0.7923
    ],
    [
        "What is the maximum dataset size Milvus can handle?\n\n  \nTheoretically, the maximum dataset size Milvus can handle is determined by the hardware it is run on, specifically system memory and storage:\n\n- Milvus loads all specified collections and partitions into memory before running queries. Therefore, memory size determines the maximum amount of data Milvus can query.\n- When new entities and and collection-related schema (currently only MinIO is supported for data persistence) are added to Milvus, system storage determines the maximum allowable size of inserted data.\n\n###",
        0.7857
    ]
]
Verwenden Sie LLM, um eine RAG-Antwort zu erhalten
Konvertieren Sie die abgerufenen Dokumente in ein Zeichenfolgenformat.
context = "\n".join(
    [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances]
)
Definieren Sie System- und Benutzer-Prompts für das Sprachmodell. Dieser Prompt wird aus den von Milvus abgerufenen Dokumenten zusammengestellt.
from google.genai import types

SYSTEM_PROMPT = """
Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided.
"""
USER_PROMPT = f"""
Use the following pieces of information enclosed in <context> tags to provide an answer to the question enclosed in <question> tags.
<context>
{context}
</context>
<question>
{question}
</question>
"""
Verwenden Sie Gemini, um auf der Grundlage der Eingabeaufforderungen eine Antwort zu generieren.
response = client.models.generate_content(
    model="gemini-2.5-flash",
    config=types.GenerateContentConfig(system_instruction=SYSTEM_PROMPT),
    contents=USER_PROMPT,
)
print(response.text)
Milvus stores data in two main ways:

1.  **Inserted Data:** This includes vector data, scalar data, and collection-specific schema. This type of data is stored in persistent storage as an incremental log. Milvus supports various object storage backends for this, such as MinIO, AWS S3, Google Cloud Storage (GCS), Azure Blob Storage, Alibaba Cloud OSS, and Tencent Cloud Object Storage (COS).
2.  **Metadata:** Metadata is generated within Milvus by its various modules. Each module's metadata is stored in etcd.
Multimodale Suche
Da „ gemini-embedding-2-preview “ Text, Bilder und andere Modalitäten in denselben Einbettungsraum abbildet, können wir eine modalitätsübergreifende Suche durchführen – beispielsweise mithilfe einer Textanfrage, um die relevantesten Bilder zu finden.
Bilddaten vorbereiten
Wir laden eine Reihe von RAG-Architekturdiagrammen aus dem Milvus-Bootcamp-Repository herunter, um sie als unseren Bilddatensatz zu verwenden.
import urllib.request
from pathlib import Path

image_dir = Path("images")
image_dir.mkdir(exist_ok=True)

image_files = [
    "vanilla_rag.png",
    "hyde.png",
    "query_routing.png",
    "self_reflection.png",
    "hybrid_and_rerank.png",
    "hierarchical_index.png",
]

base_url = "https://raw.githubusercontent.com/milvus-io/bootcamp/master/pics/advanced_rag/"

for fname in image_files:
    path = image_dir / fname
    if not path.exists():
        urllib.request.urlretrieve(base_url + fname, path)
        print(f"Downloaded {fname}")
    else:
        print(f"Already exists {fname}")

print(f"\nTotal images: {len(image_files)}")
Downloaded vanilla_rag.png
Downloaded hyde.png
Downloaded query_routing.png
Downloaded self_reflection.png
Downloaded hybrid_and_rerank.png
Downloaded hierarchical_index.png

Total images: 6
Bilder einbetten und in Milvus speichern
Wir lesen jedes Bild als Byte-Daten ein und übergeben es an „ gemini-embedding-2-preview “, um Einbettungen zu generieren, die wir anschließend in einer neuen Milvus-Sammlung speichern.
from google.genai import types

image_data = []

for fname in image_files:
    path = image_dir / fname
    with open(path, "rb") as f:
        image_bytes = f.read()

    result = client.models.embed_content(
        model="gemini-embedding-2-preview",
        contents=types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
    )
    image_data.append(
        {
            "id": len(image_data),
            "vector": result.embeddings[0].values,
            "filename": fname,
        }
    )
    print(f"Embedded {fname}")

# Create a new collection for images
image_collection = "image_collection"
if milvus_client.has_collection(image_collection):
    milvus_client.drop_collection(image_collection)

milvus_client.create_collection(
    collection_name=image_collection,
    dimension=len(image_data[0]["vector"]),
    metric_type="IP",
)

milvus_client.insert(collection_name=image_collection, data=image_data)
print(f"\nInserted {len(image_data)} image embeddings (dim={len(image_data[0]['vector'])})")
Embedded vanilla_rag.png
Embedded hyde.png
Embedded query_routing.png
Embedded self_reflection.png
Embedded hybrid_and_rerank.png
Embedded hierarchical_index.png

Inserted 6 image embeddings (dim=3072)
Modalübergreifende Suche: Textabfrage → Bildergebnisse
Nun verwenden wir eine Textabfrage, um die Bild-Embeddings zu durchsuchen. Da sowohl Text als auch Bilder in denselben Embedding-Raum abgebildet werden, können wir sie direkt miteinander vergleichen.
from IPython.display import display, Image

text_queries = [
    "How does a basic RAG pipeline work?",
    "What is the hypothetical document embedding approach?",
    "How to combine hybrid search with reranking?",
]

for query in text_queries:
    query_embed = client.models.embed_content(
        model="gemini-embedding-2-preview", contents=query
    )

    results = milvus_client.search(
        collection_name=image_collection,
        data=[query_embed.embeddings[0].values],
        limit=1,
        search_params={"metric_type": "IP", "params": {}},
        output_fields=["filename"],
    )

    best = results[0][0]
    print(f"\nQuery: {query}")
    print(f"Match: {best['entity']['filename']} (score: {best['distance']:.4f})")
    display(Image(filename=str(image_dir / best["entity"]["filename"]), width=600))
Query: How does a basic RAG pipeline work?
Match: vanilla_rag.png (score: 0.5132)
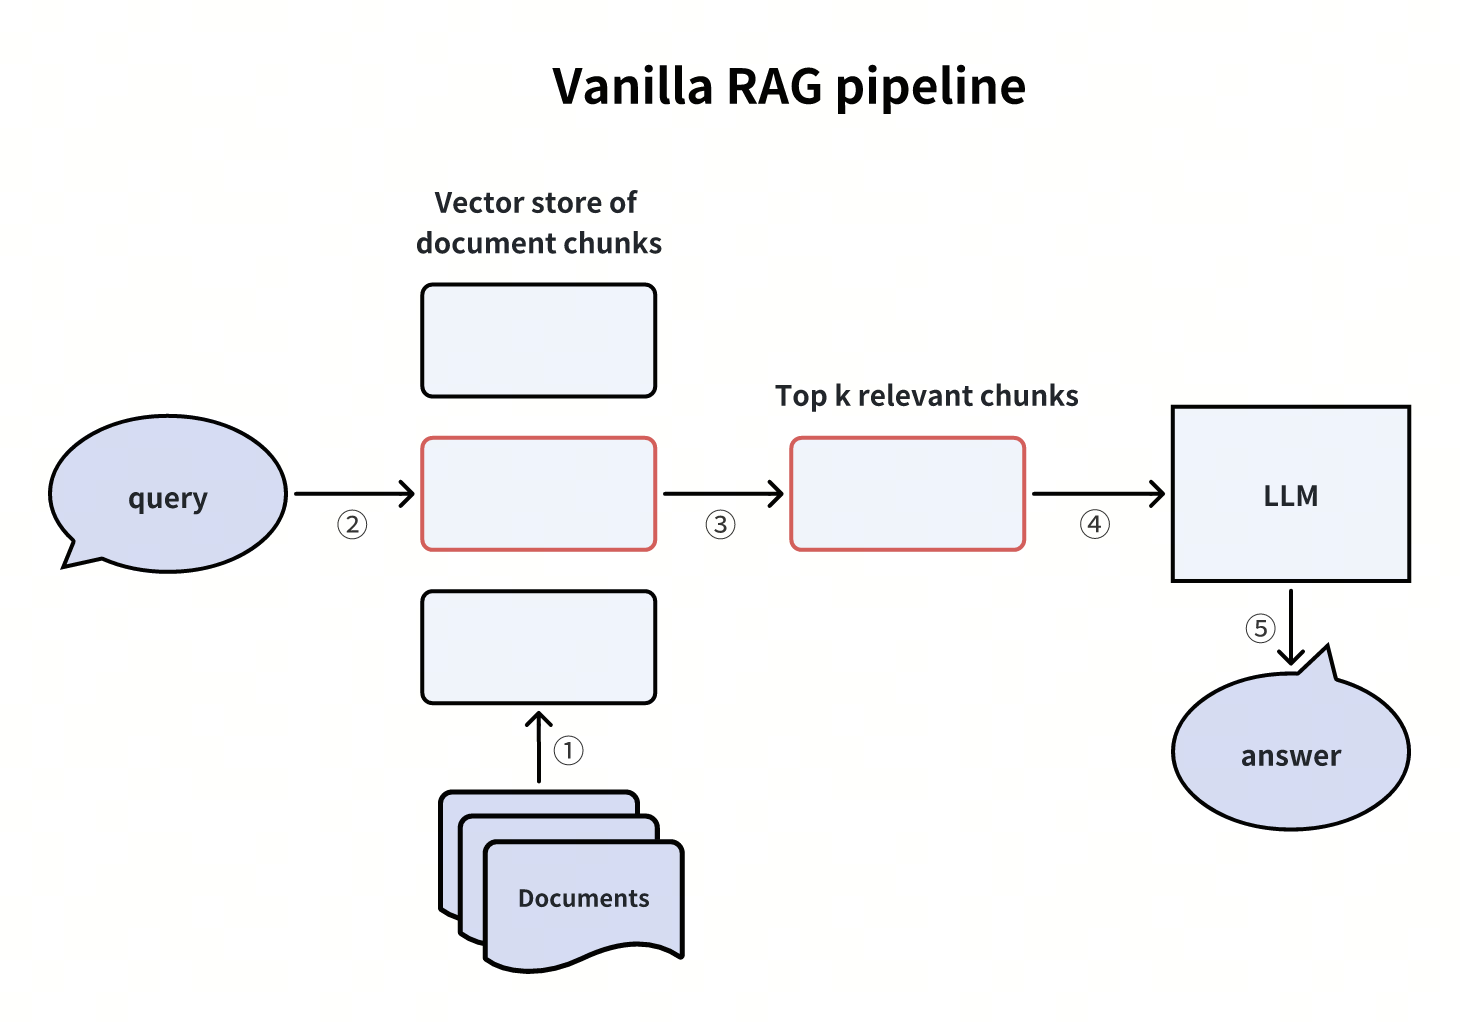 Vanilla-RAG-Pipeline
Query: What is the hypothetical document embedding approach?
Match: hyde.png (score: 0.4756)
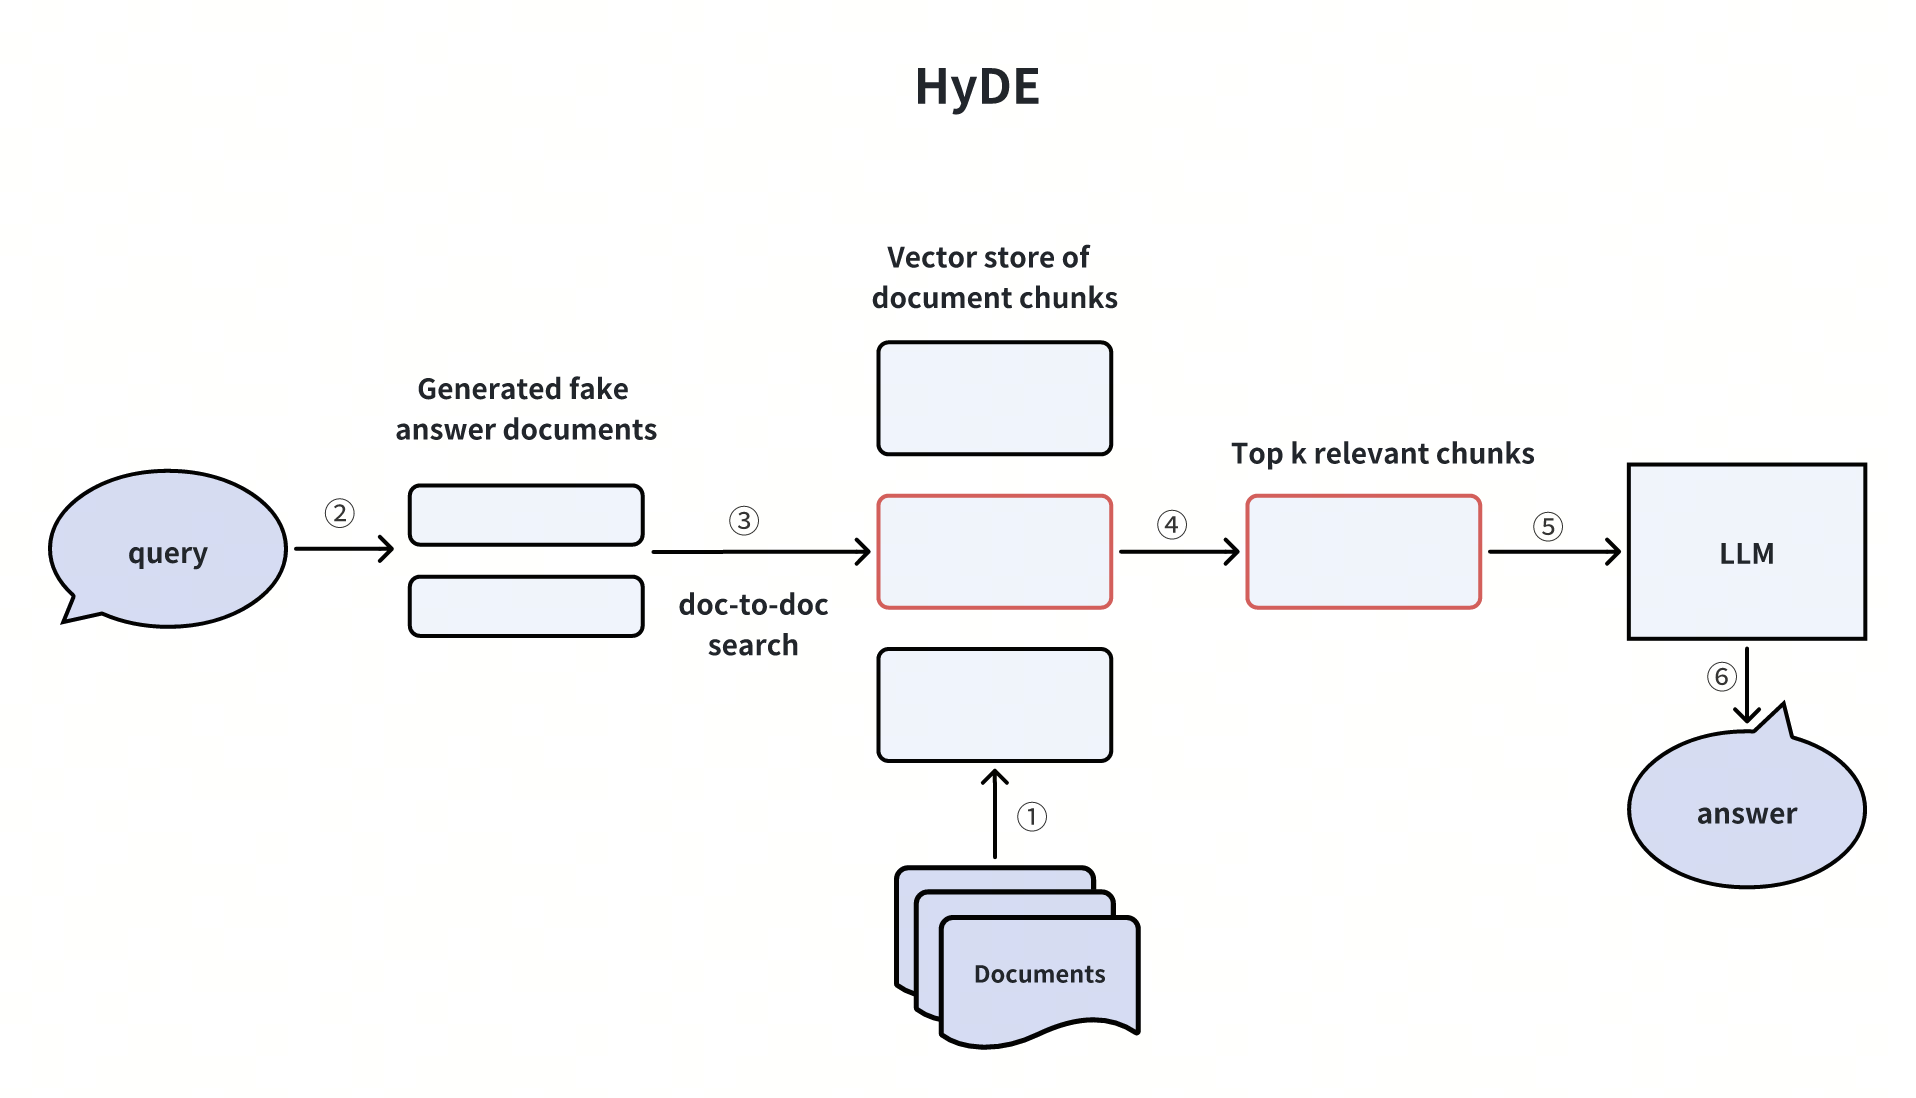 HyDE
Query: How to combine hybrid search with reranking?
Match: hybrid_and_rerank.png (score: 0.5271)
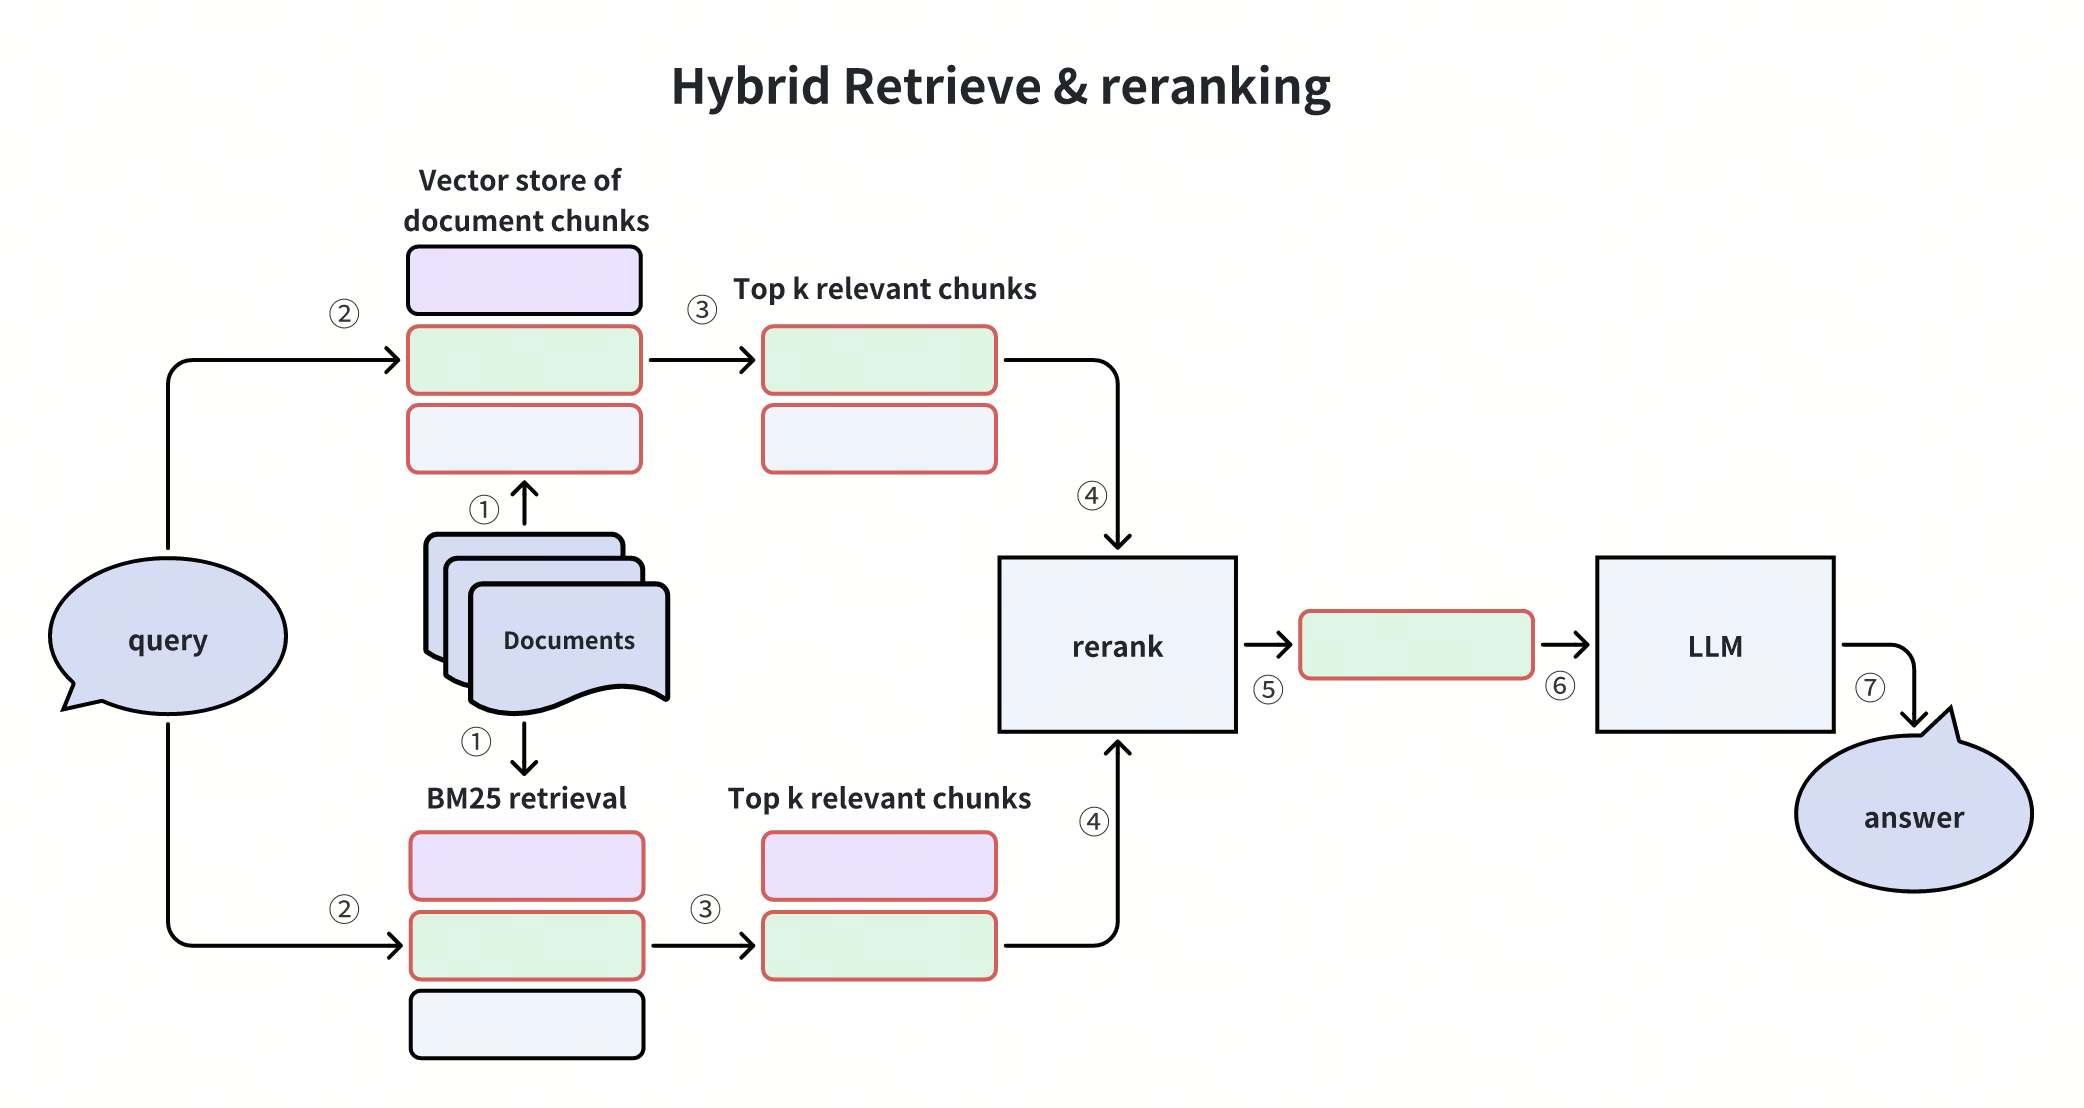 Hybrides Abrufen und Neurangieren
Großartig! Wir haben erfolgreich eine RAG-Pipeline mit Milvus und Gemini aufgebaut und die modalübergreifende Suche anhand von Textabfragen zum Abrufen relevanter Bilder demonstriert – alles auf Basis des einheitlichen Einbettungsraums von „ gemini-embedding-2-preview “.
