


إنشاء RAG باستخدام Milvus وGemini
تساعدك واجهة برمجة تطبيقات Gemini و Google AI Studio على البدء في العمل باستخدام أحدث نماذج Google وتحويل أفكارك إلى تطبيقات قابلة للتوسع. توفر Gemini إمكانية الوصول إلى نماذج لغوية قوية مثل Gemini-2.5-Flash و Gemini-2.5-Pro لمهام مثل إنشاء النصوص ومعالجة المستندات والرؤية وتحليل الصوت والمزيد. كما توفر أيضًا Gemini Embedding 2 ، وهو نموذج تضمين متعدد الوسائط يدعم النصوص والصور والفيديو والصوت ومستندات PDF بأبعاد إخراج مرنة عبر Matryoshka Representation Learning. تتيح لك واجهة برمجة التطبيقات (API) إدخال سياق طويل يحتوي على ملايين الرموز، وضبط النماذج لمهام محددة، وإنشاء مخرجات منظمة مثل JSON، والاستفادة من إمكانيات مثل الاسترجاع الدلالي وتنفيذ التعليمات البرمجية.
في هذا البرنامج التعليمي، سنوضح لك كيفية إنشاء مسار RAG (التوليد المعزز بالاسترجاع) باستخدام Milvus وGemini. سنستخدم نموذج Gemini لتوليد استجابات بناءً على استعلام معين، معززة بالمعلومات ذات الصلة المسترجعة من Milvus.
التحضير
التبعيات والبيئة
أولاً، قم بتثبيت الحزم المطلوبة:
$ pip install --upgrade pymilvus milvus-lite google-genai requests tqdm
إذا كنت تستخدم Google Colab، فلتفعيل التبعيات التي تم تثبيتها للتو، قد تحتاج إلى إعادة تشغيل بيئة التشغيل (انقر على قائمة «Runtime» في أعلى الشاشة، واختر «Restart session» من القائمة المنسدلة).
يجب عليك أولاً تسجيل الدخول إلى منصة Google AI Studio وإعداد مفتاح واجهة برمجة التطبيقات (API) GEMINI_API_KEY كمتغير بيئة.
import os

os.environ["GEMINI_API_KEY"] = "***********"
تحضير البيانات
نستخدم صفحات الأسئلة الشائعة من وثائق Milvus 2.4.x كمعرفة خاصة في RAG الخاص بنا، وهو مصدر بيانات جيد لخط أنابيب RAG بسيط.
قم بتنزيل الملف المضغوط واستخرج المستندات إلى المجلد milvus_docs.
$ wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip
$ unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
نقوم بتحميل جميع ملفات Markdown من المجلد milvus_docs/en/faq. بالنسبة لكل مستند، نستخدم ببساطة الرمز "# " لفصل المحتوى في الملف، مما يتيح فصل محتوى كل جزء رئيسي من ملف Markdown بشكل تقريبي.
from glob import glob

text_lines = []

for file_path in glob("milvus_docs/en/faq/*.md", recursive=True):
    with open(file_path, "r") as file:
        file_text = file.read()

    text_lines += file_text.split("# ")
تحضير نموذج اللغة الكبير (LLM) ونموذج التضمين
نستخدم gemini-2.5-flash كنموذج لغة كبير (LLM)، ونموذج gemini-embedding-2-preview كنموذج التضمين. gemini-embedding-2-preview هو أحدث نموذج تضمين متعدد الوسائط من Google، وهو يدعم النصوص والصور والفيديو والصوت وملفات PDF بأبعاد إخراج مرنة (128–3,072) عبر تقنية Matryoshka Representation Learning.
دعونا نحاول إنشاء استجابة اختبارية من نموذج اللغة الكبير (LLM):
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-2.5-flash", contents="who are you"
)
print(response.text)
I am a large language model, trained by Google.

I'm designed to process and generate human-like text based on the vast amount of data I was trained on. This allows me to:

*   Answer questions
*   Provide summaries
*   Generate creative content
*   Translate languages
*   And much more

I don't have personal experiences, feelings, or consciousness. I'm a tool designed to be helpful and informative.
إنشاء تضمين تجريبي وعرض أبعاده والعناصر القليلة الأولى منه.
test_embeddings = client.models.embed_content(
    model="gemini-embedding-2-preview", contents=["This is a test1", "This is a test2"]
)

embedding_dim = len(test_embeddings.embeddings[0].values)
print(embedding_dim)
print(test_embeddings.embeddings[0].values[:10])
3072
[-0.016769307, 0.013630492, 0.020277105, 0.0035285393, 0.003968259, -0.013498845, 0.028525498, 0.025498547, -0.021553498, 0.015233516]
تحميل البيانات إلى Milvus
إنشاء المجموعة
دعونا نُهيئ عميل Milvus ونُعد مجموعتنا:
from pymilvus import MilvusClient

milvus_client = MilvusClient(uri="./milvus_demo.db")

collection_name = "my_rag_collection"
بالنسبة لحجة MilvusClient:
- يُعد تعيين
uriكملف محلي، على سبيل المثال./milvus.db، الطريقة الأكثر ملاءمة، حيث يستخدم تلقائيًا Milvus Lite لتخزين جميع البيانات في هذا الملف. - إذا كانت لديك بيانات ضخمة الحجم، فيمكنك إعداد خادم Milvus أكثر كفاءة على Docker أو Kubernetes. في هذا الإعداد، يرجى استخدام عنوان URI للخادم، على سبيل المثال
http://localhost:19530، كـuriالخاص بك. - إذا كنت ترغب في استخدام Zilliz Cloud، وهي الخدمة السحابية المُدارة بالكامل لـ Milvus، فقم بتعديل
uriوtoken، اللذين يتوافقان مع «نقطة النهاية العامة» (Public Endpoint) و«مفتاح API» (Api key) في Zilliz Cloud.
تحقق مما إذا كانت المجموعة موجودة بالفعل وقم بحذفها في حالة وجودها.
if milvus_client.has_collection(collection_name):
    milvus_client.drop_collection(collection_name)
قم بإنشاء مجموعة جديدة باستخدام المعلمات المحددة.
إذا لم نحدد أي معلومات عن الحقول، فسيقوم Milvus تلقائيًا بإنشاء حقل افتراضي id للمفتاح الأساسي، وحقل vector لتخزين بيانات المتجهات. ويُستخدم حقل JSON محجوز لتخزين الحقول غير المحددة في المخطط وقيمها.
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=embedding_dim,
    metric_type="IP",  # Inner product distance
    # Strong consistency waits for all loads to complete, adding latency with large datasets
    # consistency_level="Strong",  # Strong consistency level
)
إدراج البيانات
قم بالتكرار عبر أسطر النص، وإنشاء التضمينات، ثم إدراج البيانات في Milvus.
إليك حقل جديد text ، وهو حقل غير محدد في مخطط المجموعة. سيتم إضافته تلقائيًا إلى الحقل الديناميكي JSON المحجوز، والذي يمكن التعامل معه كحقل عادي على مستوى عالٍ.
from tqdm import tqdm

data = []

doc = client.models.embed_content(model="gemini-embedding-2-preview", contents=text_lines)

for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):
    data.append({"id": i, "vector": doc.embeddings[i].values, "text": line})

milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████| 72/72 [00:00<00:00, 337796.30it/s]


{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
إنشاء RAG
استرداد البيانات لاستعلام
دعونا نحدد سؤالًا متكررًا حول Milvus.
question = "How is data stored in milvus?"
ابحث عن السؤال في المجموعة واسترجع أفضل 3 نتائج مطابقة من الناحية الدلالية.
quest_embed = client.models.embed_content(model="gemini-embedding-2-preview", contents=question)

search_res = milvus_client.search(
    collection_name=collection_name,
    data=[quest_embed.embeddings[0].values],
    limit=3,  # Return top 3 results
    search_params={"metric_type": "IP", "params": {}},  # Inner product distance
    output_fields=["text"],  # Return the text field
)
دعونا نلقي نظرة على نتائج البحث الخاصة بالاستعلام
import json

retrieved_lines_with_distances = [
    (res["entity"]["text"], res["distance"]) for res in search_res[0]
]
print(json.dumps(retrieved_lines_with_distances, indent=4))
[
    [
        " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",
        0.864
    ],
    [
        "Why is there no vector data in etcd?\n\netcd stores Milvus module metadata; MinIO stores entities.",
        0.7923
    ],
    [
        "What is the maximum dataset size Milvus can handle?\n\n  \nTheoretically, the maximum dataset size Milvus can handle is determined by the hardware it is run on, specifically system memory and storage:\n\n- Milvus loads all specified collections and partitions into memory before running queries. Therefore, memory size determines the maximum amount of data Milvus can query.\n- When new entities and and collection-related schema (currently only MinIO is supported for data persistence) are added to Milvus, system storage determines the maximum allowable size of inserted data.\n\n###",
        0.7857
    ]
]
استخدام LLM للحصول على استجابة RAG
تحويل المستندات المسترجعة إلى تنسيق سلسلة نصية.
context = "\n".join(
    [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances]
)
تحديد مطالبات النظام والمستخدم لنموذج اللغة. يتم تجميع هذه المطالبة باستخدام المستندات التي تم استرجاعها من Milvus.
from google.genai import types

SYSTEM_PROMPT = """
Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided.
"""
USER_PROMPT = f"""
Use the following pieces of information enclosed in <context> tags to provide an answer to the question enclosed in <question> tags.
<context>
{context}
</context>
<question>
{question}
</question>
"""
استخدم Gemini لتوليد استجابة بناءً على المطالبات.
response = client.models.generate_content(
    model="gemini-2.5-flash",
    config=types.GenerateContentConfig(system_instruction=SYSTEM_PROMPT),
    contents=USER_PROMPT,
)
print(response.text)
Milvus stores data in two main ways:

1.  **Inserted Data:** This includes vector data, scalar data, and collection-specific schema. This type of data is stored in persistent storage as an incremental log. Milvus supports various object storage backends for this, such as MinIO, AWS S3, Google Cloud Storage (GCS), Azure Blob Storage, Alibaba Cloud OSS, and Tencent Cloud Object Storage (COS).
2.  **Metadata:** Metadata is generated within Milvus by its various modules. Each module's metadata is stored in etcd.
البحث متعدد الوسائط
نظرًا لأن نموذج اللغة المتعدد الوسائط ( gemini-embedding-2-preview ) يقوم بتعيين النصوص والصور والوسائط الأخرى في نفس مساحة التضمين، يمكننا إجراء بحث عبر الوسائط — على سبيل المثال، استخدام استعلام نصي للعثور على الصور الأكثر صلة.
تحضير بيانات الصور
نقوم بتنزيل مجموعة من مخططات بنية RAG من مستودع Milvus Bootcamp لاستخدامها كمجموعة بيانات الصور الخاصة بنا.
import urllib.request
from pathlib import Path

image_dir = Path("images")
image_dir.mkdir(exist_ok=True)

image_files = [
    "vanilla_rag.png",
    "hyde.png",
    "query_routing.png",
    "self_reflection.png",
    "hybrid_and_rerank.png",
    "hierarchical_index.png",
]

base_url = "https://raw.githubusercontent.com/milvus-io/bootcamp/master/pics/advanced_rag/"

for fname in image_files:
    path = image_dir / fname
    if not path.exists():
        urllib.request.urlretrieve(base_url + fname, path)
        print(f"Downloaded {fname}")
    else:
        print(f"Already exists {fname}")

print(f"\nTotal images: {len(image_files)}")
Downloaded vanilla_rag.png
Downloaded hyde.png
Downloaded query_routing.png
Downloaded self_reflection.png
Downloaded hybrid_and_rerank.png
Downloaded hierarchical_index.png

Total images: 6
تضمين الصور وتخزينها في Milvus
نقوم بقراءة كل صورة على شكل بايتات ونمررها إلى gemini-embedding-2-preview لتوليد التضمينات، ثم نقوم بتخزينها في مجموعة Milvus جديدة.
from google.genai import types

image_data = []

for fname in image_files:
    path = image_dir / fname
    with open(path, "rb") as f:
        image_bytes = f.read()

    result = client.models.embed_content(
        model="gemini-embedding-2-preview",
        contents=types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
    )
    image_data.append(
        {
            "id": len(image_data),
            "vector": result.embeddings[0].values,
            "filename": fname,
        }
    )
    print(f"Embedded {fname}")

# Create a new collection for images
image_collection = "image_collection"
if milvus_client.has_collection(image_collection):
    milvus_client.drop_collection(image_collection)

milvus_client.create_collection(
    collection_name=image_collection,
    dimension=len(image_data[0]["vector"]),
    metric_type="IP",
)

milvus_client.insert(collection_name=image_collection, data=image_data)
print(f"\nInserted {len(image_data)} image embeddings (dim={len(image_data[0]['vector'])})")
Embedded vanilla_rag.png
Embedded hyde.png
Embedded query_routing.png
Embedded self_reflection.png
Embedded hybrid_and_rerank.png
Embedded hierarchical_index.png

Inserted 6 image embeddings (dim=3072)
البحث عبر الوسائط: استعلام نصي → نتائج صور
الآن دعونا نستخدم استعلامًا نصيًا للبحث عبر التضمينات الصورية. نظرًا لأن النص والصور يتم تعيينهما في نفس مساحة التضمين، يمكننا مقارنتهما مباشرةً.
from IPython.display import display, Image

text_queries = [
    "How does a basic RAG pipeline work?",
    "What is the hypothetical document embedding approach?",
    "How to combine hybrid search with reranking?",
]

for query in text_queries:
    query_embed = client.models.embed_content(
        model="gemini-embedding-2-preview", contents=query
    )

    results = milvus_client.search(
        collection_name=image_collection,
        data=[query_embed.embeddings[0].values],
        limit=1,
        search_params={"metric_type": "IP", "params": {}},
        output_fields=["filename"],
    )

    best = results[0][0]
    print(f"\nQuery: {query}")
    print(f"Match: {best['entity']['filename']} (score: {best['distance']:.4f})")
    display(Image(filename=str(image_dir / best["entity"]["filename"]), width=600))
Query: How does a basic RAG pipeline work?
Match: vanilla_rag.png (score: 0.5132)
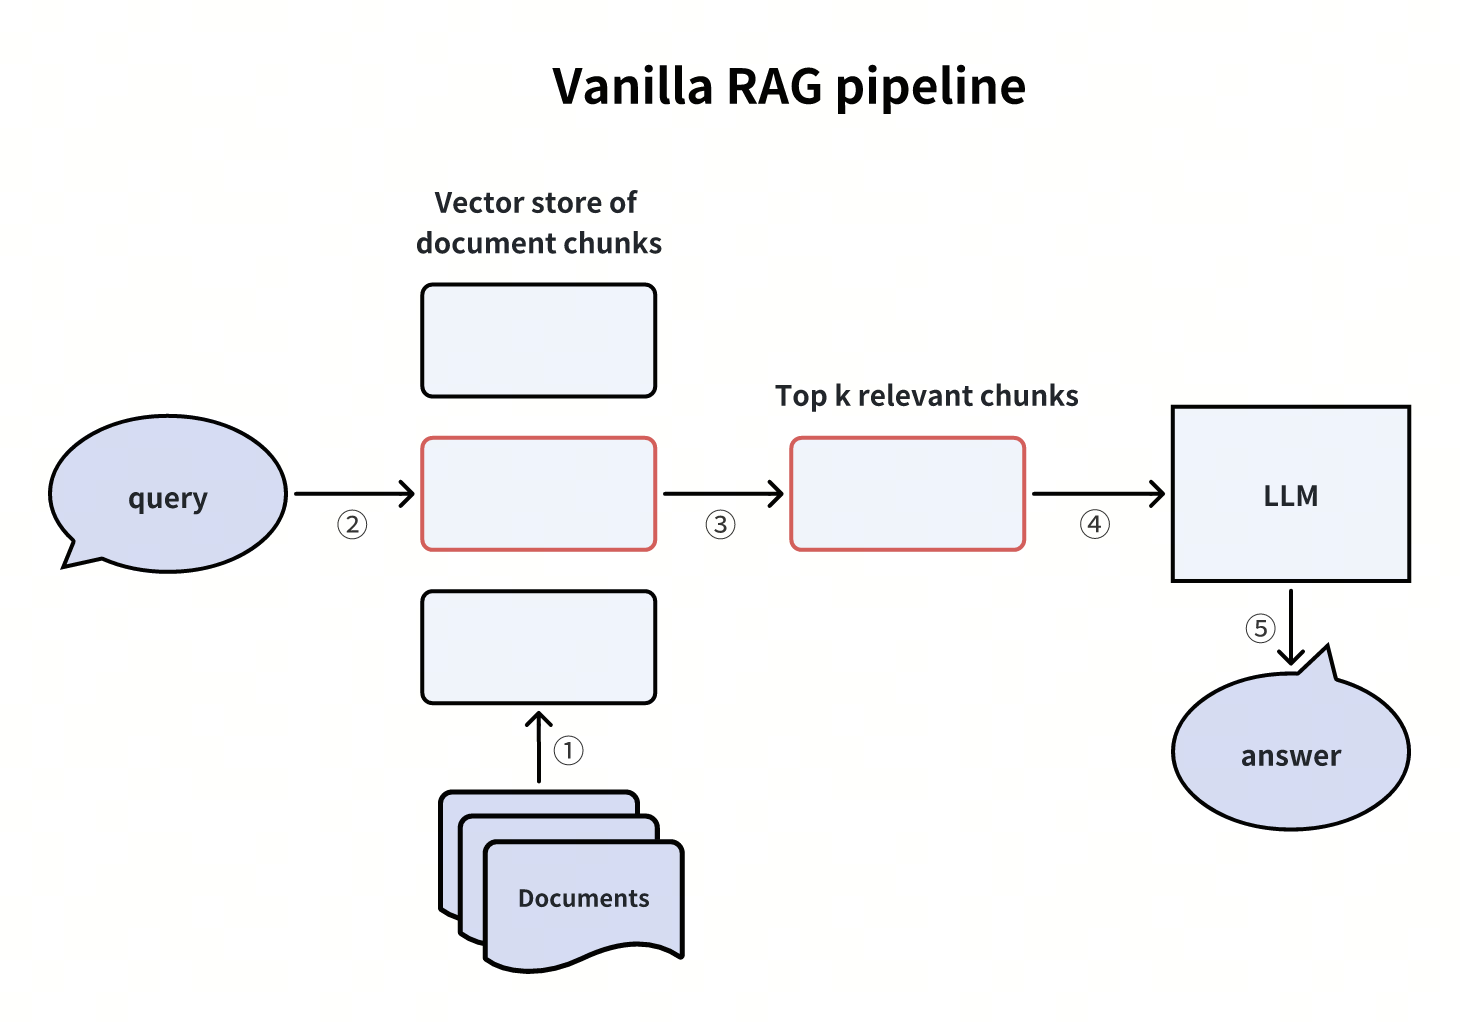 مسار RAG الأساسي
Query: What is the hypothetical document embedding approach?
Match: hyde.png (score: 0.4756)
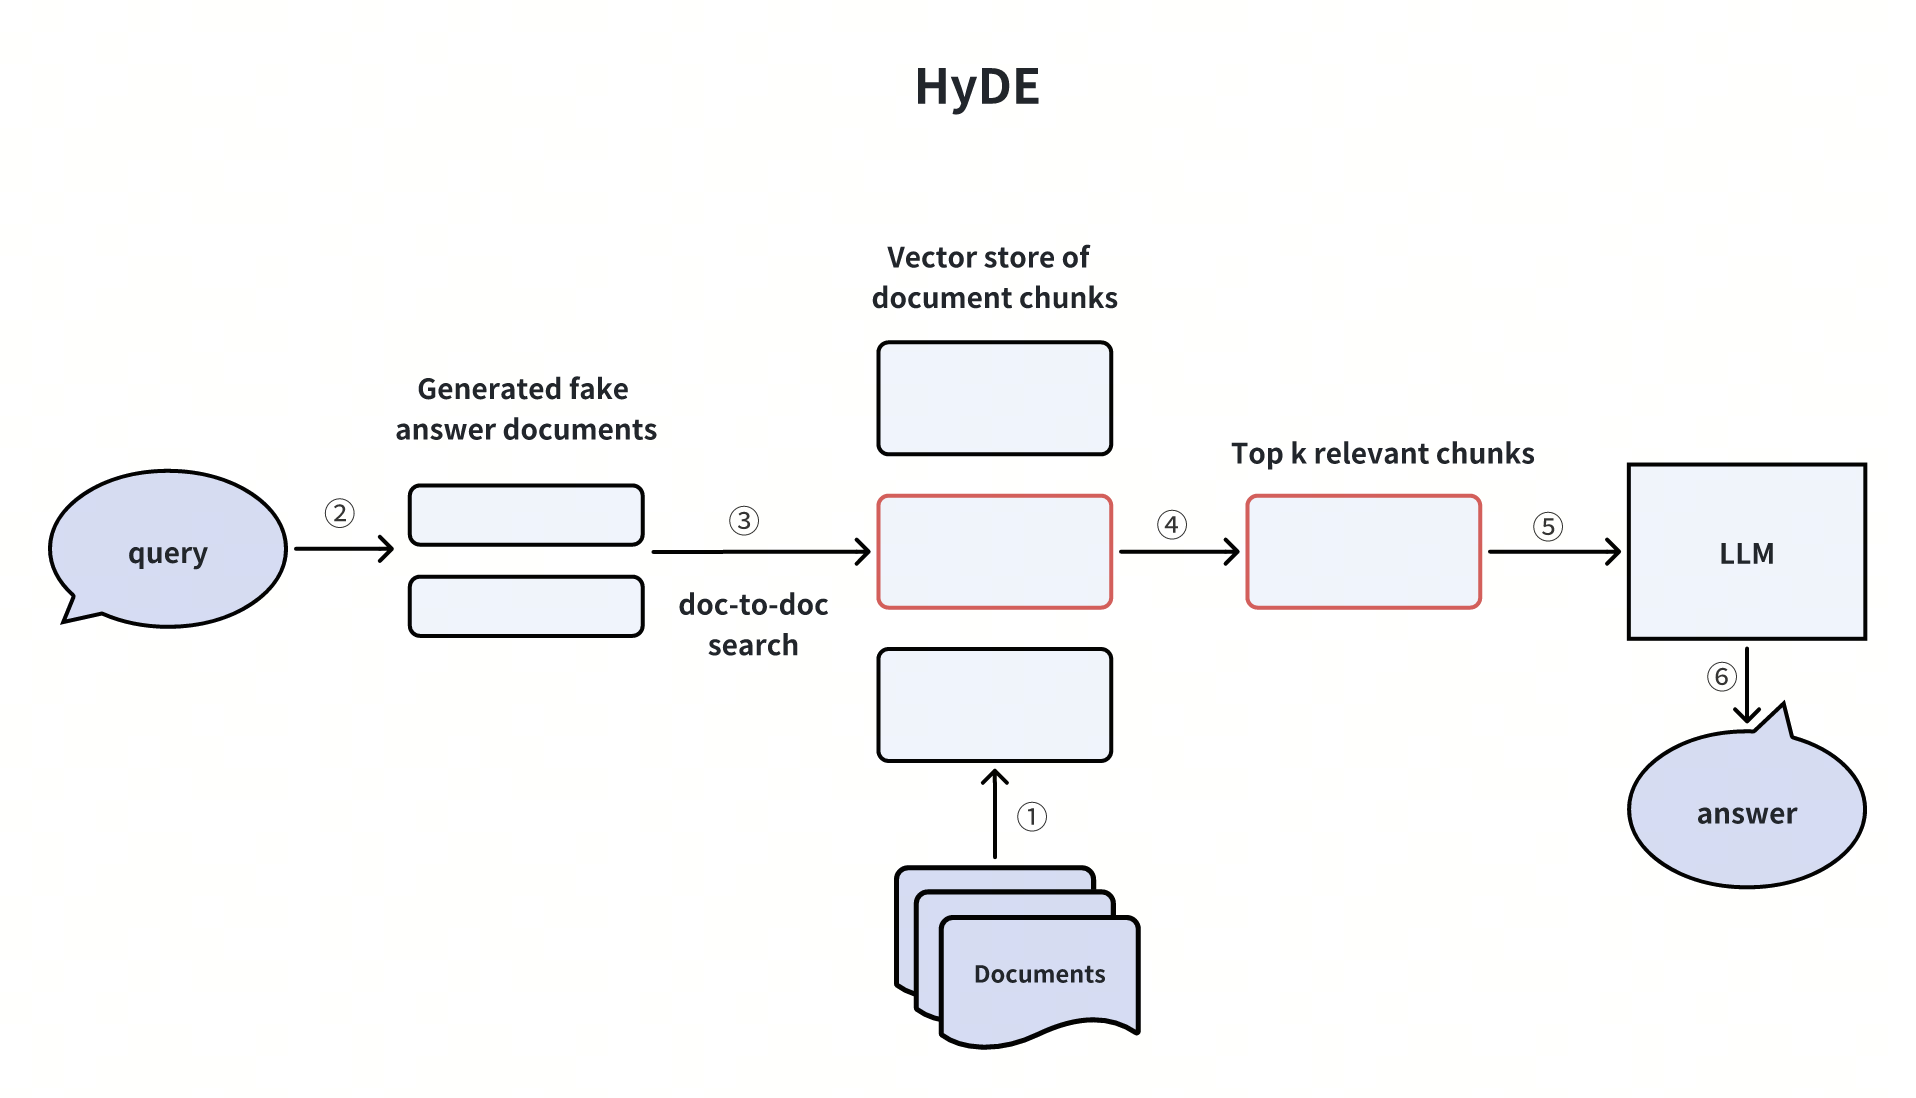 HyDE
Query: How to combine hybrid search with reranking?
Match: hybrid_and_rerank.png (score: 0.5271)
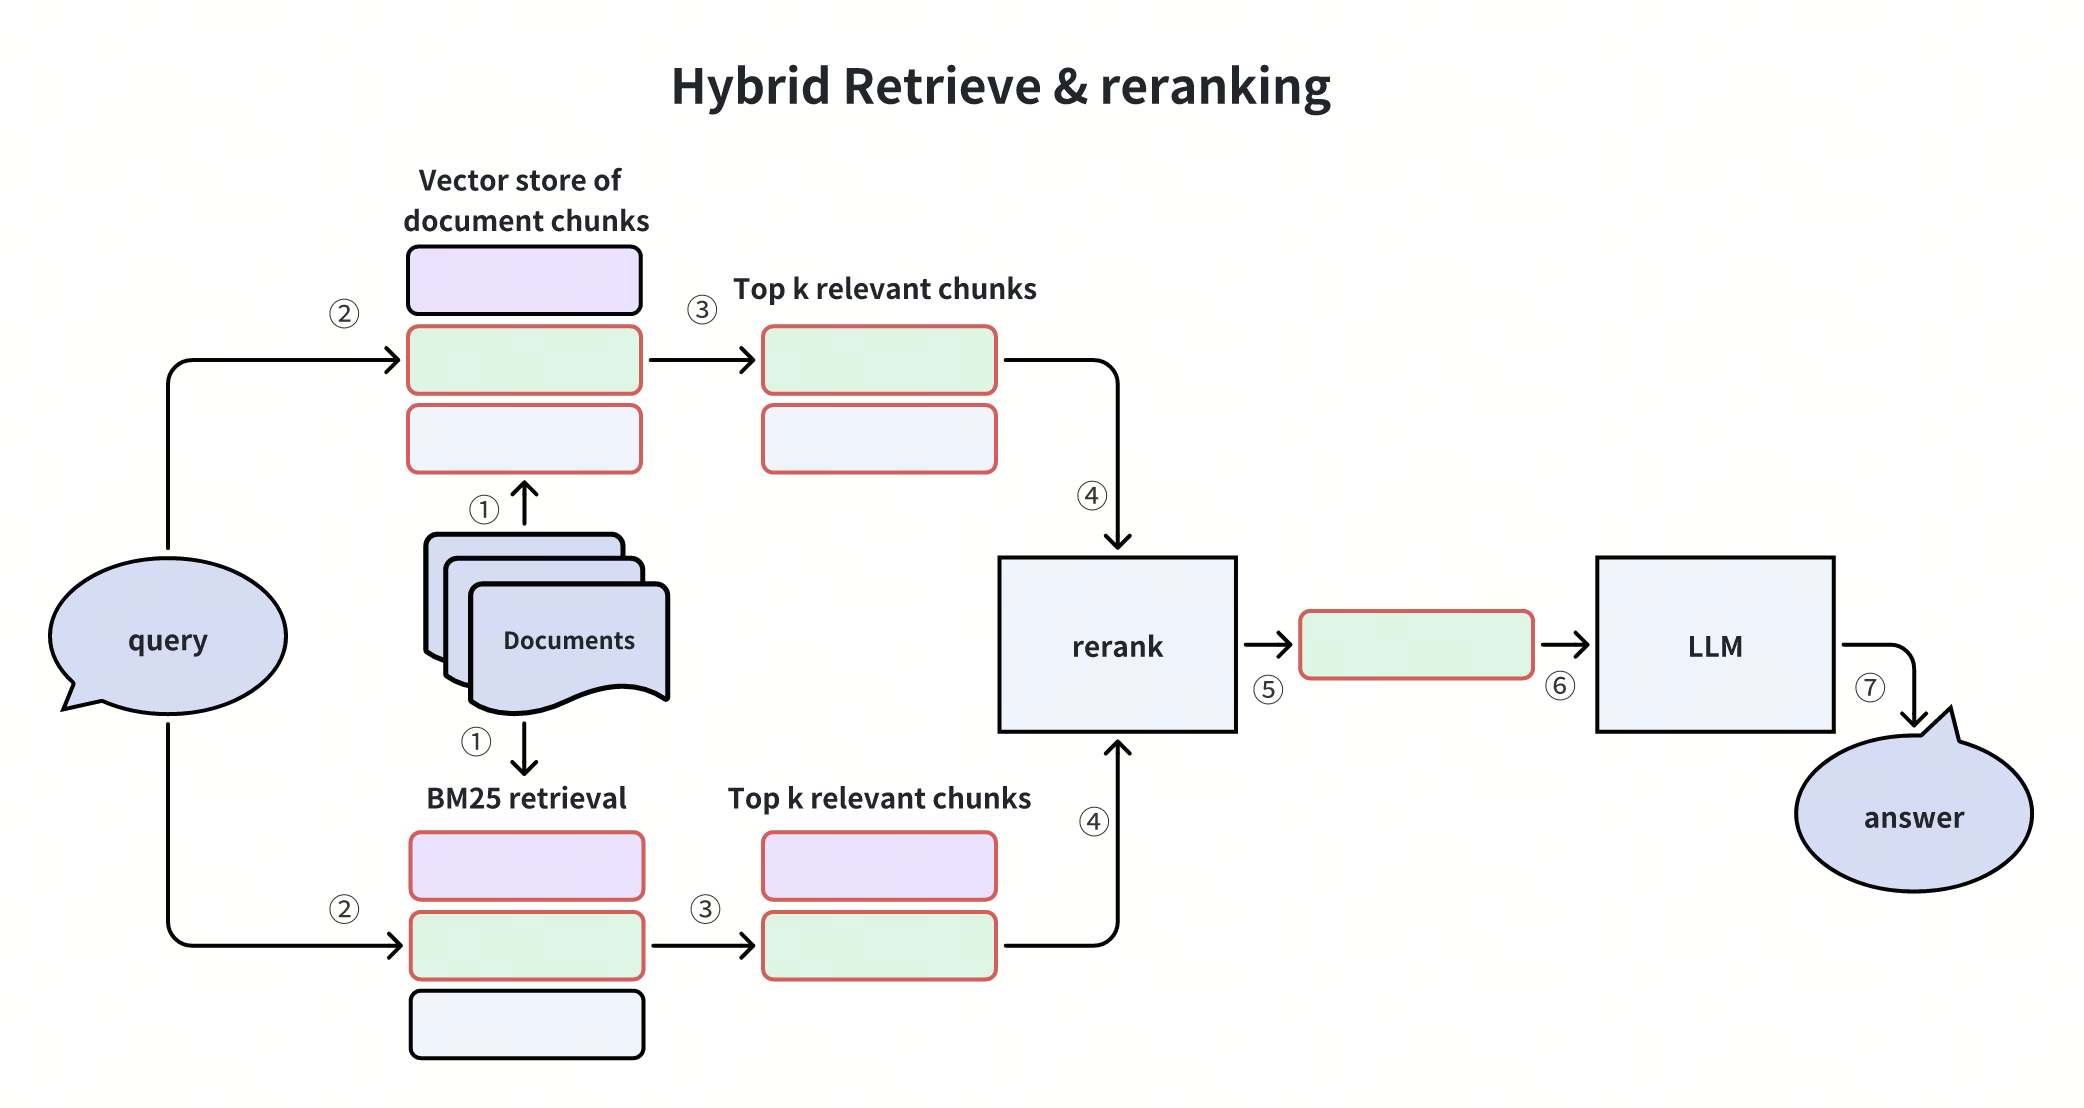 الاسترجاع الهجين وإعادة الترتيب
رائع! لقد نجحنا في بناء مسار RAG باستخدام Milvus وGemini، وأثبتنا فعالية البحث عبر الوسائط باستخدام استعلامات نصية لاسترجاع الصور ذات الصلة — كل ذلك مدعوم بمساحة التضمين الموحدة لـ gemini-embedding-2-preview.
