7 款最適合用於 Claude 程式碼上下文管理的開源工具
即使您為 Claude Code 提供 100 萬個代幣的上下文視窗,隨著時間推移,得到的答案仍會越來越差。問題不僅在於上下文大小,更在於上下文的品質。
當終端機日誌、工具的原始輸出、重複的檔案讀取、冗長的回應,以及被遺忘的專案歷史紀錄,全都爭奪模型的注意力時,Claude Code 的運作表現就會下降。在長時間運行的代理工作流程中,這些干擾會形成一個惡性循環:模型會失去邏輯脈絡,你為了修正答案而增加更多對話輪次,而這些額外的輪次又會產生更多干擾。
這就是所謂的「上下文失焦」:模型雖有足夠空間儲存資訊,但重要資訊卻被低信號的上下文所掩蓋。更大的上下文視窗可能會讓人更容易忽略這個問題,因為開發者不再仔細思考提示語中應包含哪些內容。
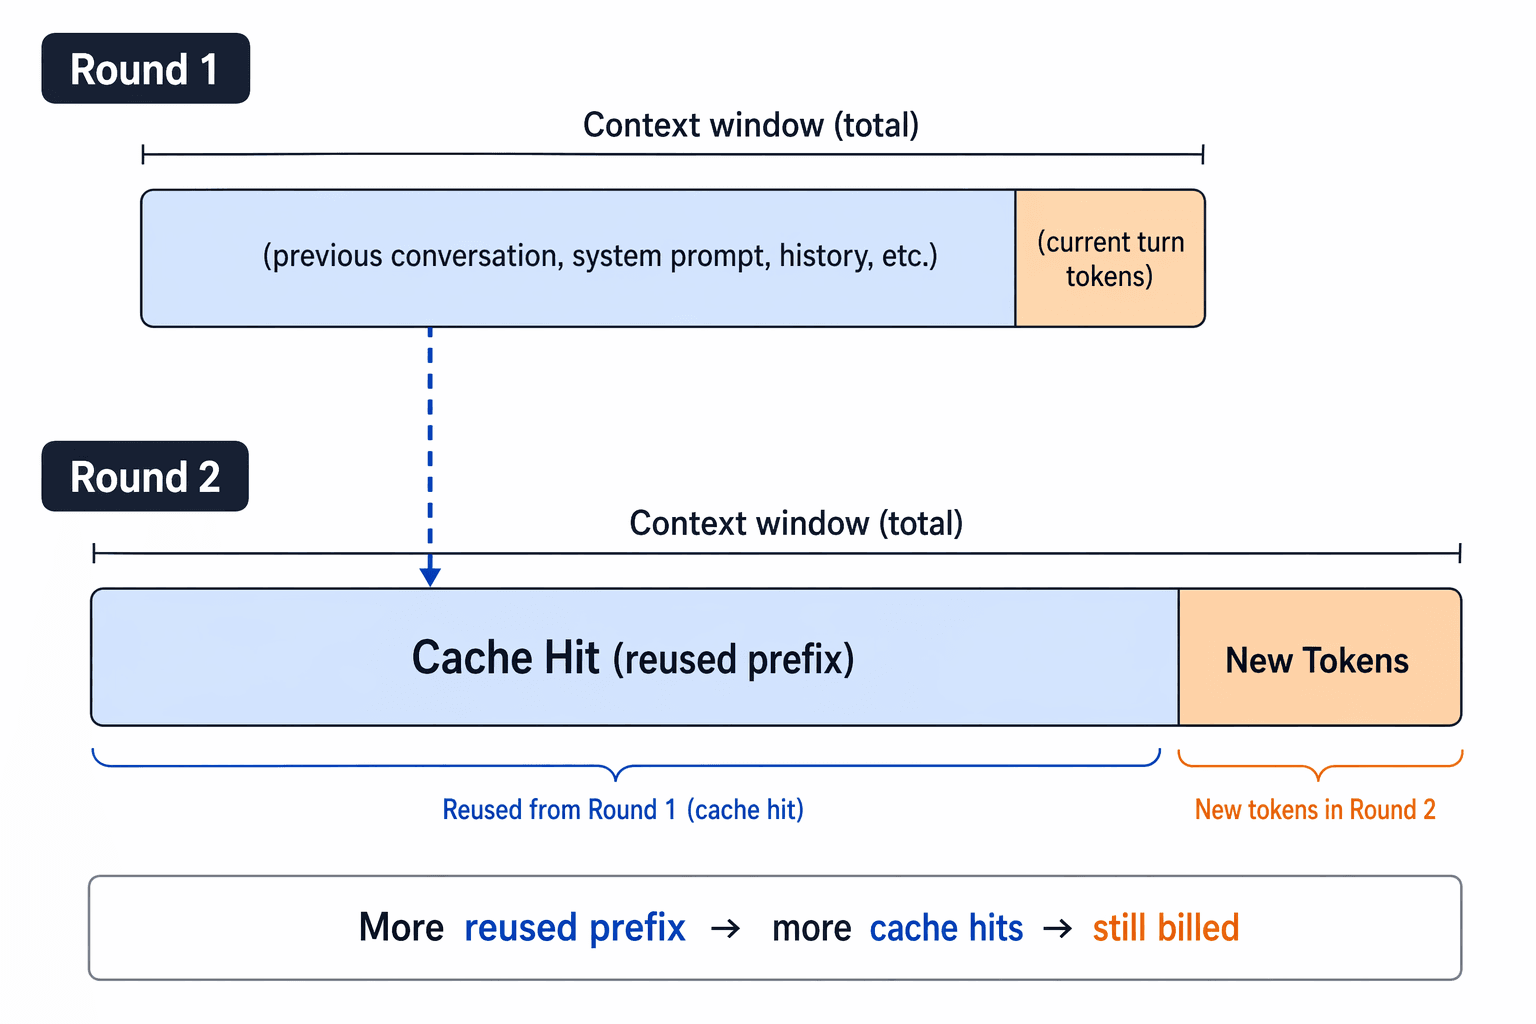 提示字串快取示意圖,展示重複使用的前綴如何在各輪交互中持續增加計費上下文
提示詞快取雖能降低重複前綴的成本,但並不會讓上下文視窗變成雜物抽屜。您仍需為新標記付費,且仍需模型針對正確資訊進行推理。
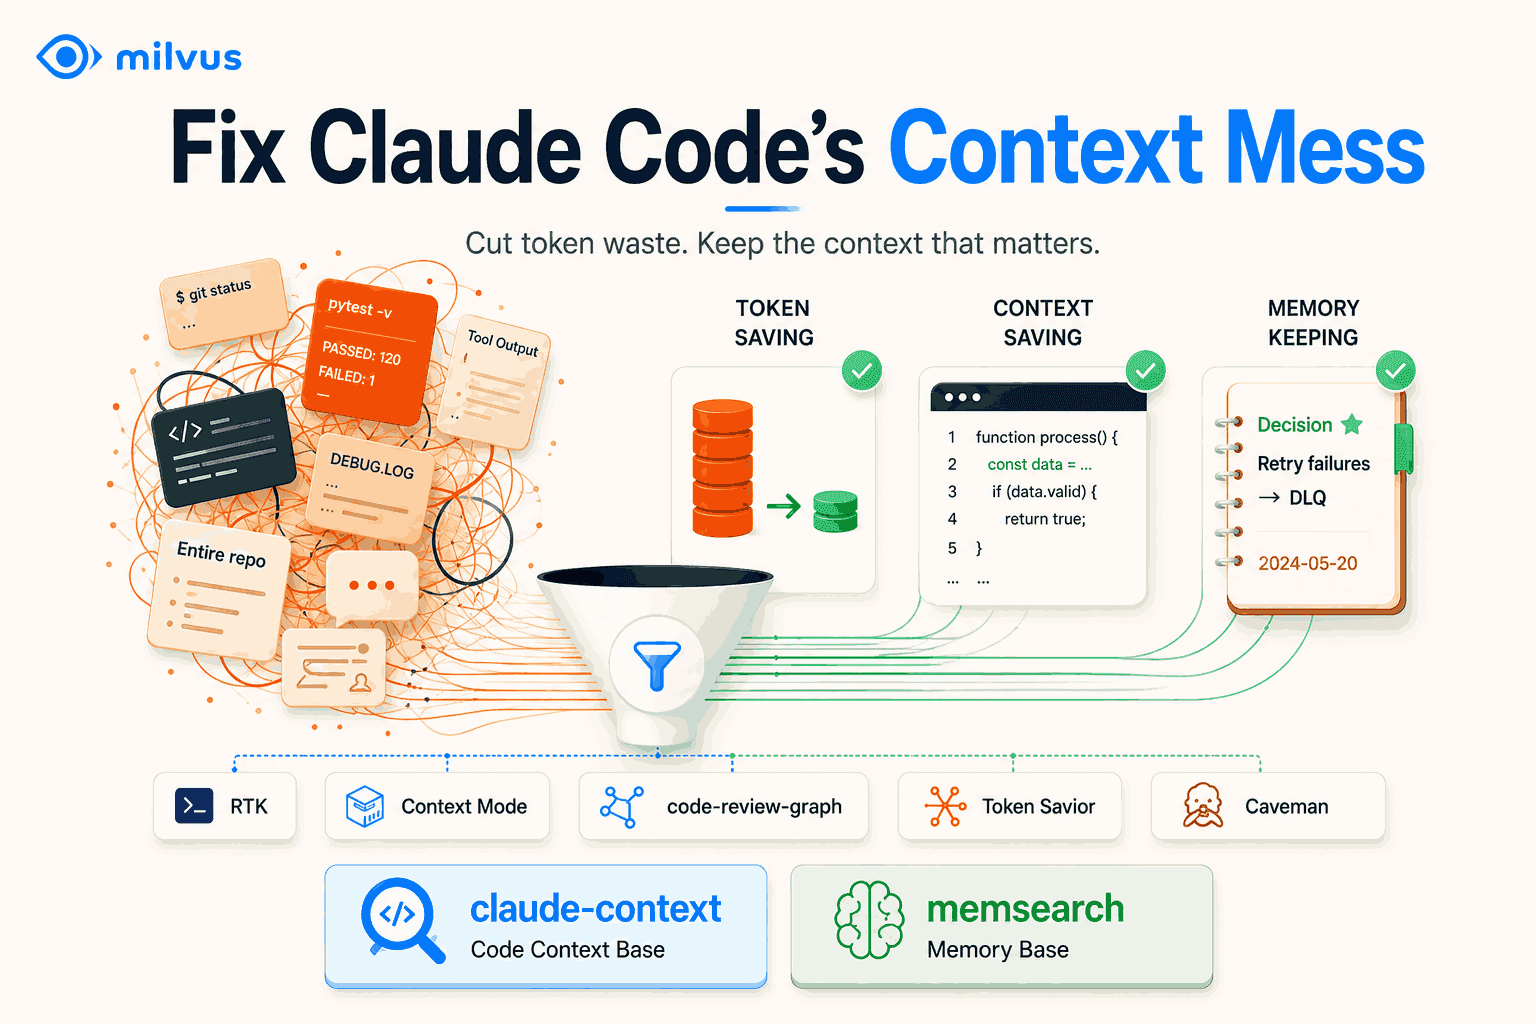
本文綜述了七種從不同層面解決「上下文失焦」問題的開源工具:終端機輸出、工具輸出、程式碼庫導覽、檔案讀取、模型詳盡度、語義程式碼檢索,以及跨會話記憶。文中亦闡述了這些概念如何與向量資料庫設計、向量相似度搜尋,以及如 Milvus 般的檢索系統相呼應。
是什麼導致 Claude Code 的「上下文失焦」?
Claude Code 的上下文失焦通常源自五種失效模式:過多的原始指令文字、雜訊過多的工具輸出、重複的程式碼庫探索、過長的模型回應,以及跨會話或跨代理人的記憶缺口。
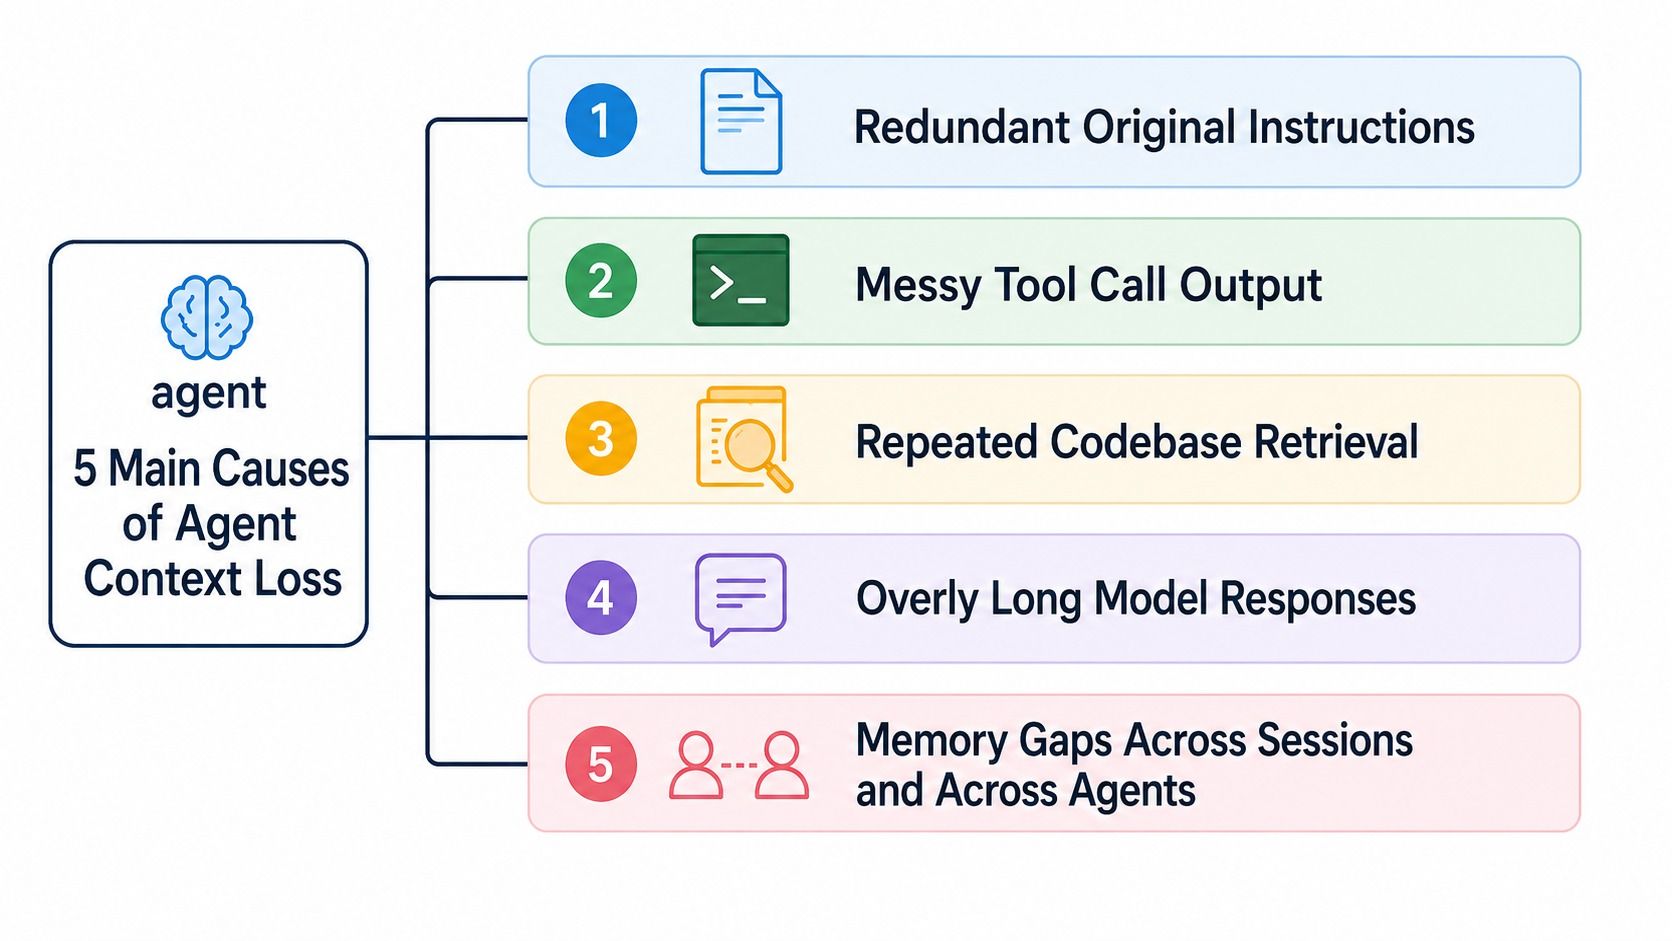 Claude Code 上下文遺失的五種成因:冗餘指令、雜亂的工具輸出、重複的程式碼庫檢索、過長的回應,以及記憶體缺口
| 上下文失效模式 | 在 Claude Code 中的表現 | 有助於解決問題的工具類別 |
|---|---|---|
| 終端機日誌雜訊過多 | git、pytest 、gh 以及雲端 CLI 會輸出比模型所需更多的文字。 | CLI 輸出壓縮 |
| 工具輸出淹沒視窗 | 測試日誌、DOM 轉儲及 MCP 輸出會以巨型原始區塊的形式進入聊天視窗。 | 工具輸出隔離 |
| 程式碼庫導覽重複執行 | Claude 會列出目錄、執行 grep 指令、讀取檔案,並在每次會話中重複相同的探索流程。 | 程式碼圖譜或語義檢索 |
| 檔案讀取範圍過廣 | 模型僅需一個符號或摘要時,卻會讀取整份檔案。 | 漸進式程式碼閱讀 |
| Claude 說話太多 | 答案本身為後續回合增添了不必要的上下文。 | 回應壓縮 |
| 記憶無法保留 | 每次開始新會話時,你都會重新解釋專案決策。 | 以 Markdown 為先的記憶機制 |
一套良好的情境管理架構應具備三項功能:過濾掉無用資訊、按需檢索正確的專案知識,以及在不同會話間保留持久的決策。
你應該先使用哪款 Claude Code 上下文工具?
從在你的工作流程中產生最多干擾的那一層開始著手。如果終端機輸出是問題所在,就從 RTK 開始;如果 Claude 總是在龐大的儲存庫中四處遊走,就從 claude-context 或 code-review-graph 開始;如果你真正的痛點是每天都要重新解釋相同的決策,那就從 memsearch 開始。
| 工具 | 主要解決的問題 | 最適合的場景 |
|---|---|---|
| RTK | 常見開發者指令產生的雜訊終端機輸出。 | 在 Claude Code 內執行大量 CLI 指令的開發者。 |
| 情境模式 | 大量原始工具輸出進入主要對話。 | 大量使用 Playwright、GitHub、日誌或 MCP 工具的使用者。 |
| code-review-graph | 在大型儲存庫中進行盲式程式碼庫探索。 | 審查、依賴性分析及影響範圍相關問題。 |
| Token Savior | 明明僅需符號摘要即可,卻仍進行整檔讀取。 | 大型檔案、重複的符號查詢,以及增量式程式碼讀取。 |
| 穴居人 | Claude 自身冗長的回應習慣。 | 希望輸出簡潔且未來上下文較小的使用者。 |
| claude-context | 每次會話都重新探索程式碼庫。 | 透過 MCP 進行語義程式碼搜尋。 |
| memsearch | 在不同會話、代理程式及模型切換之間會遺失專案記憶。 | 具備持久決策與經驗教訓的長期專案。 |
前五項工具可減少進入或保留在上下文中的內容;後兩項則讓有用的上下文更容易被調用。
RTK 會在 Claude 看到原始命令輸出前先對其進行壓縮
RTK 是一款用於減少常見開發者指令所消耗代幣數量的 CLI 代理程式。其 GitHub 說明指出,它能將常見開發指令的 LLM 代幣消耗量減少 60-90%,並以單一 Rust 二進位檔形式發佈。
在日常使用 Claude Code 的過程中,諸如 `git status`、`pytest` 以及目錄清單等指令,往往會將完整的環境資訊和狀態描述傾倒至上下文視窗中。而模型通常只需要更簡短的回答:哪些檔案有所變更、哪個測試失敗、拉取請求卡在何處,或是目錄中存在哪些關鍵檔案。
RTK 位於 shell 與 Claude 之間。它能透過 Claude Code 掛鉤重寫指令,並回傳壓縮後的輸出結果。
原始的git status 輸出:
On branch feat/payment-retry
Your branch is up to date with 'origin/feat/payment-retry'.
Changes not staged for commit:
modified:   src/webhook/handler.ts
modified:   src/queue/dlq.ts
modified:   tests/webhook.test.ts
Untracked files:
docs/notes.md
no changes added to commit
真正重要的內容:
3 modified, 1 untracked
- src/webhook/handler.ts
- src/queue/dlq.ts
- tests/webhook.test.ts
pytest 也是同樣的情況。原始輸出充斥著通過的案例和環境雜訊:
============================= test session starts =============================
platform darwin -- Python 3.12.4, pytest-8.4.1
collected 128 items
tests/test_auth.py …
tests/test_webhook.py …F…
tests/test_queue.py …
================================== FAILURES ==================================
________________ test_retry_to_dlq __________________
E   AssertionError: expected status code 202, got 500
經過壓縮後,訊息便一目瞭然:
128 tests collected, 1 failed
FAIL tests/test_webhook.py::test_retry_to_dlq
AssertionError: expected status code 202, got 500
當您的上下文膨脹源自 shell 指令而非程式碼擷取時,RTK 是最容易上手的起點。
「上下文模式」會將龐大的工具輸出隔離在主聊天視窗之外
「上下文模式」專為工具返回的原始區塊而設計:測試日誌、瀏覽器 DOM 快照、GitHub 載入內容、MCP 工具輸出以及抓取的網頁。其 GitHub 說明特別強調針對 AI 編碼代理的上下文視窗優化,並報告工具輸出量減少了 98%。
 「上下文模式」GitHub 儲存庫卡片,展示隔離的工具輸出及上下文優化定位
其運作方式是將龐大的工具輸出隔離至本機沙盒並建立索引,隨後僅將摘要與檢索標籤傳入 Claude 的對話中。
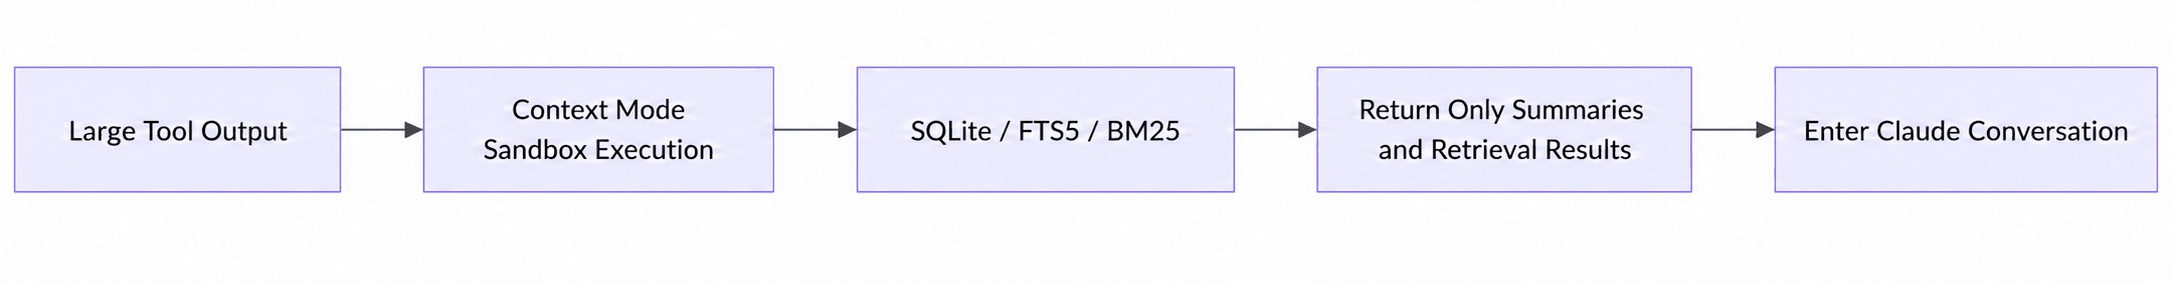 Context Mode 流程圖,展示大量工具輸出如何經過沙盒執行、SQLite 或 FTS 索引、摘要及檢索結果
此流程極具實用價值,因為程式設計代理通常只需了解失敗的節點、失效的選擇器或相關的堆疊追蹤,而非完整的 DOM 或每一行通過測試的程式碼。Context Mode 將完整輸出保留在本地,同時防止其佔據主要對話空間。
這類似於生產環境中的混合搜尋系統如何將儲存與檢索分離。您將原始資料存放在某個持久儲存位置,然後僅檢索其中重要的部分。
code-review-graph 會在 Claude 探索程式碼前先映射程式碼結構
code-review-graph 解決了另一個問題:Claude 並非總是需要更多文字;它需要的是更完善的映射。
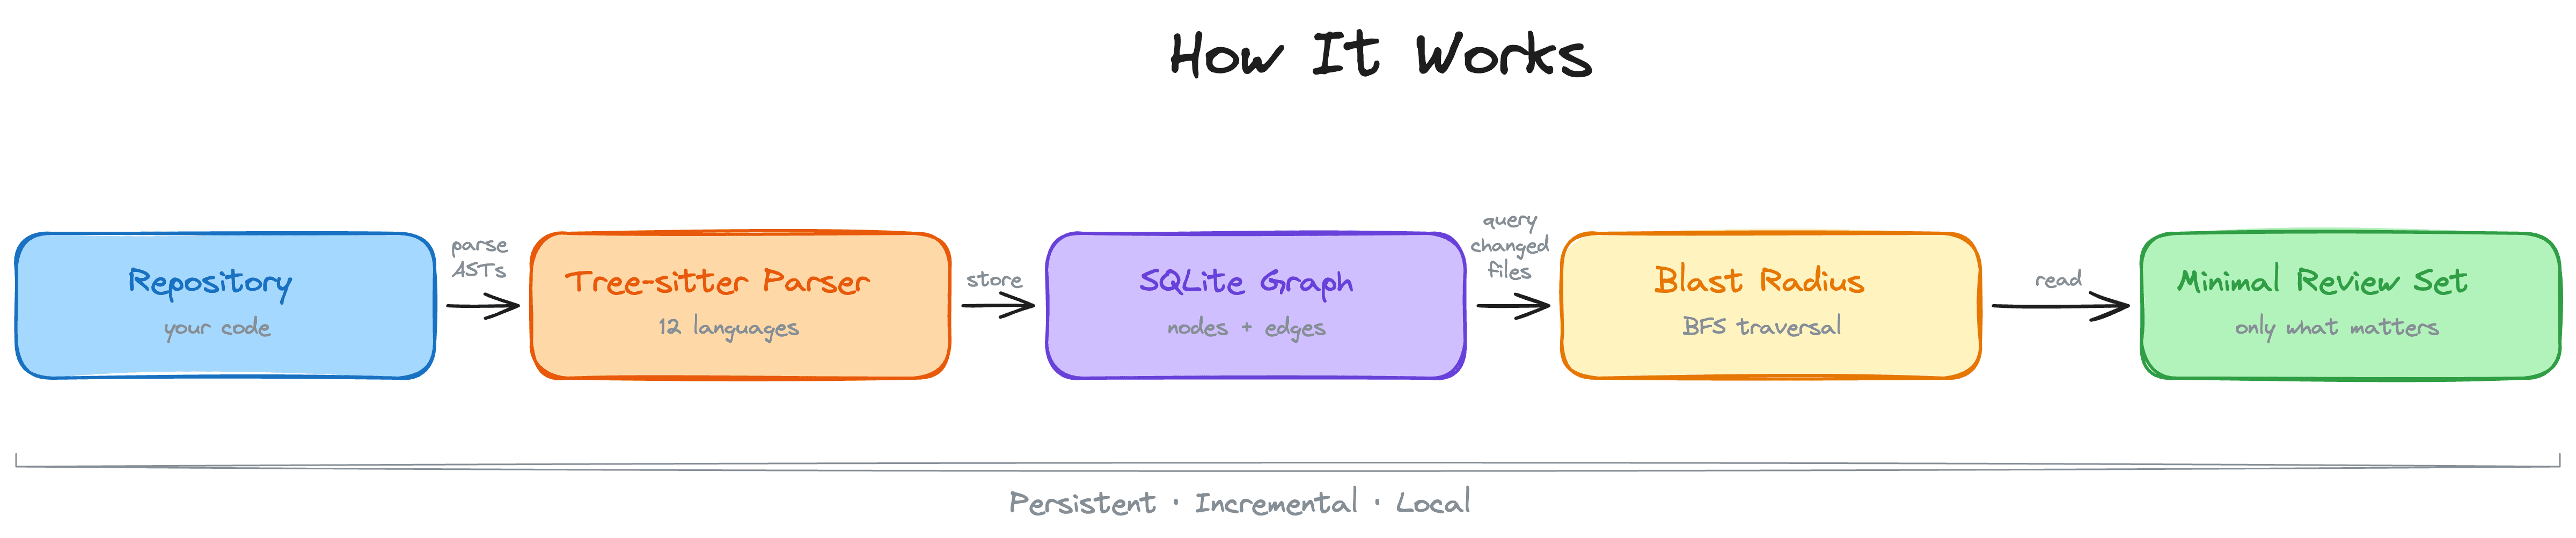 原文中使用的 code-review-graph 標誌圖片
在大型儲存庫中,一個簡單的問題可能會觸發耗費資源的探索:
修改這段登入邏輯後,哪些檔案和測試會受到影響?
若沒有程式碼圖,Claude 的典型運作方式是:
read auth.ts
grep login
read middleware
read tests
keep guessing
code-review-graph 會預先建構程式碼庫的結構地圖。它利用 Tree-sitter 解析函式、類別、匯入、呼叫關係、繼承以及測試依賴關係,然後將圖譜寫入 SQLite。
這使其在程式碼審查與影響範圍分析中極具價值。與其讓 Claude 透過反覆讀取來重新發現依賴關係圖,不如先讓它查詢結構。
這與語義搜尋相近,但並不完全相同。結構圖回答「什麼依賴於什麼?」;語義檢索則回答「哪些程式碼在概念上與這個問題相關?」在實際的程式碼助理工作流程中,您通常需要兩者兼備。
Token Savior 在傳送完整檔案前,先向 Claude 提供符號摘要
Token Savior 的核心理念很簡單:預設情況下不要傳送完整檔案。先傳送索引或符號摘要,然後僅在任務需要更多細節時才展開內容。
 Token Savior 的 GitHub 儲存庫卡片,顯示其 MCP 伺服器描述與專案統計資料
若您詢問支付 webhook 是在何處處理的,模型通常不需要每個相關檔案的每一行程式碼。它首先需要知道某個檔案或符號是否相關。
Token Savior 以分層方式提供程式碼:
| 層級 | Claude 接收的內容 | 展開時 |
|---|---|---|
| 摘要 | 索引、符號名稱及簡短描述。 | 預設的第一個回應。 |
| 程式碼片段 | 圍繞相關符號的較小程式碼區段。 | 當摘要可能相關時。 |
| 完整檔案 | 完整的檔案內容。 | 僅在編輯或深度推理時才需要。 |
這反映了開發人員實際閱讀程式碼的方式:先快速掃描、確認相關性,然後僅在必要時才開啟完整檔案。這也類似於RAG 應用程式中採用的漸進式檢索模式:先進行範圍足夠廣泛的檢索以掌握方向,然後在生成內容前縮小上下文範圍。
Caveman 能減少 Claude 自身回應的冗長問題
多數語境工具著重於輸入模型的內容,而 Caveman 則針對 Claude 的輸出結果進行優化。
Caveman 是一款 Claude Code 技能/外掛程式,能剔除填充語、客套話、包裝句、過度解釋及重複結構。其目標並非刪除知識,而是讓答案更精煉。
未使用 Caveman 時:
您的 React 元件之所以會重新渲染,很可能是因為……
使用 Caveman 後:
每次渲染都會產生新的物件參考。內嵌物件 prop = new ref = 重新渲染。請使用 useMemo 包裹。
這點至關重要,因為 Claude 自身的回答會成為未來的上下文。若每個回答都包含冗長的解釋,下一輪對話的起始文本量就會超出實際需求。簡短的回答不僅能改善當前對話,更能提升下一輪對話的品質。
對於正在思考AI 代理程式情境工程的團隊而言,Caveman 提醒我們:輸出策略是情境策略的一部分。
claude-context 透過 MCP 實現語義化程式碼搜尋
claude-context 透過語義檢索解決了重複探索程式碼庫的問題。它會為儲存庫建立索引,將程式碼片段儲存於向量資料庫中,並透過模型上下文協定 (Model Context Protocol) 提供搜尋功能。
 GitHub 上展示的 Claude Context 儲存庫原文中熱門話題
在龐大的程式碼庫中,你經常會向 Claude 提出這樣的問題:
「幫我找出程式碼中哪些部分可能與這個錯誤有關。」
若沒有檢索層,Claude 的預設做法通常是:
list the directory
grep around
read a bunch of files
keep guessing
claude-context 將這項工作移至檢索層處理。它會將儲存庫分割成片段、生成嵌入向量、將其儲存於由 Milvus 支援的程式碼索引中,並在模型開始盲目讀取檔案之前,先檢索相關的程式碼片段。
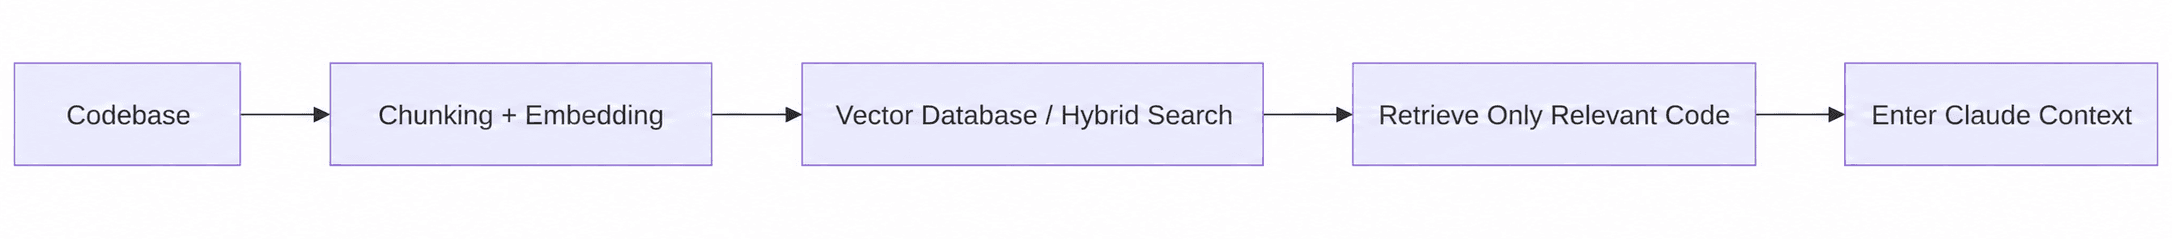 claude-context 工作流程示意圖,展示程式碼庫分塊、嵌入向量、向量資料庫與混合搜尋、相關程式碼檢索,以及 Claude 上下文注入
這正是 AI 編碼工具開始呈現搜尋系統特徵之處。您需要區塊化、嵌入向量、元資料、詞彙匹配、排序以及資料新鮮度。這些正是生產環境中 RAG 檢索、混合檢索路由以及 嵌入向量模型選擇背後的相同基礎元件。
memsearch 能在不同會話與代理之間保留有用的記憶
memsearch 則著眼於問題的另一面:不是該忘記什麼,而是如何回憶起重要的內容。
 memsearch 標誌圖片取自原文
假設你在週一告訴 Claude:
我們的 webhook 在失敗時無法重試——失敗的事件需要送入死信佇列。
到了週三,你開啟一個新會話並詢問:
在 webhook 層面,我們還能優化哪些部分?
由於缺乏持久化記憶體,Claude 會將週一的決定視為從未發生過。你只好再次解釋。
memsearch 將記憶體儲存為本機、可供人類閱讀的 Markdown 檔案,並使用 Milvus 作為可重建的檢索索引。此設計既能讓人類編輯記憶體內容,同時也讓代理程式能夠對其進行搜尋。
在檢索時,memsearch 採用漸進式回憶機制:先進行搜尋,如有需要則展開內容,僅在必要時才深入檢視原始對話紀錄。
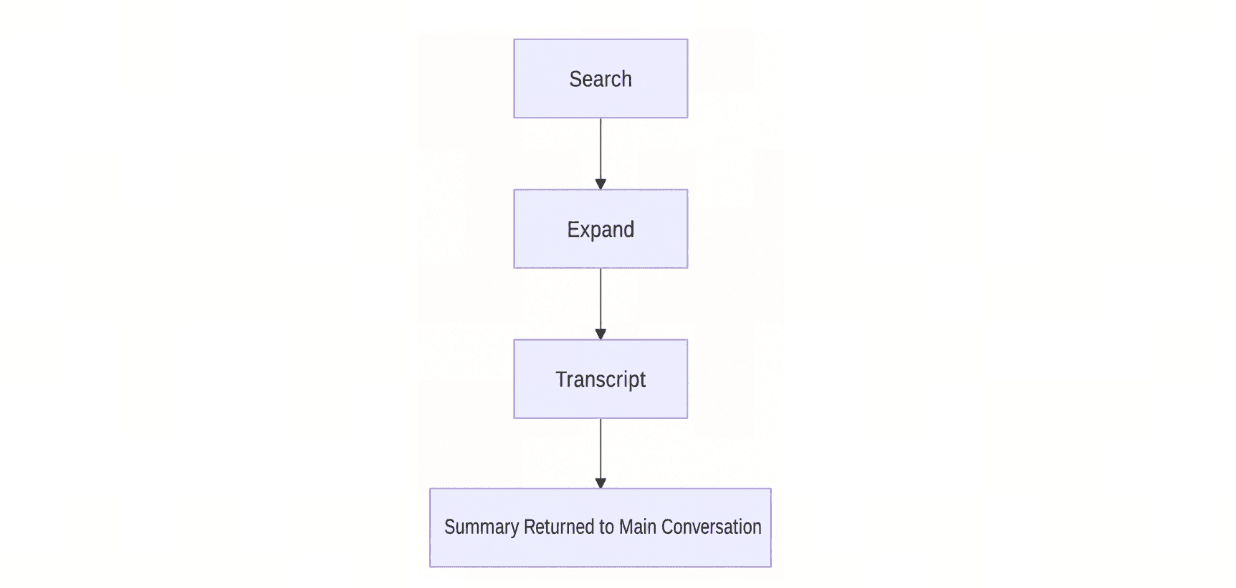 memsearch 漸進式檢索流程示意圖,展示搜尋、擴展、對話紀錄,以及回歸主對話的摘要
這種「Markdown 優先」模式對於跨會話、跨模型及跨代理的團隊非常有用。它也自然地與長期 AI 代理記憶、共享的多代理記憶,以及代理系統中防止「語境腐化」的更廣泛問題相結合。
這些工具如何協同運作?
這七種工具是互補的,而非可互換的。請將它們視為層級結構來使用。
| 層級 | 使用這些工具 | 原因 |
|---|---|---|
| 消除指令雜訊 | RTK | 在大量終端輸出傳送至 Claude 之前進行壓縮。 |
| 沙盒原始工具輸出 | 語境模式 | 將大型日誌、DOM 及工具載荷保留在主要對話之外。 |
| 繪製程式碼結構 | code-review-graph | 無需盲目讀取檔案,即可解答依賴關係與影響範圍相關的問題。 |
| 逐步閱讀程式碼 | 標記拯救者 | 從符號摘要開始,僅在必要時才展開。 |
| 壓縮 Claude 的回答 | 穴居人 | 防止模型自身的輸出成為未來語境的冗贅。 |
| 檢索相關程式碼 | claude-context | 使用語義與混合式程式碼搜尋,取代重複的 grep 迴圈。 |
| 重複利用穩健的決策 | memsearch | 跨工作階段、代理程式及模型切換,回溯專案歷史紀錄。 |
實用的部署順序如下:
- 首先消除明顯的雜訊。若殼層輸出與工具載荷佔據了您的大部分上下文,請加入 RTK 或上下文模式。
- 修正儲存庫導覽。若需檢視程式結構,可加入 code-review-graph;若需語義化程式碼檢索,則可加入 claude-context。
- 控制剩餘內容。使用 Token Savior 和 Caveman 來保持檔案讀取與模型回應的緊湊性。
- 保留持久性知識。當重複解釋成為瓶頸時,請使用 memsearch。
保持聯繫
- 加入Milvus Discord 社群,向其他開發者提問並交流情境管理模式。
- 若您需要協助設計用於程式碼、記憶體或 RAG 工作負載的檢索層,歡迎預約免費的 Milvus 諮詢時段。
- 若您希望跳過基礎架構設定,Zilliz Cloud(託管式 Milvus)提供免費方案供您入門。
常見問題
如何在不損失有用上下文的情況下,減少 Claude Code 的標記使用量?
首先壓縮雜訊最嚴重的輸入:終端機輸出、原始工具資料以及重複讀取的程式碼。接著加入 claude-context 或 code-review-graph 等檢索工具,讓 Claude 能直接擷取相關程式碼,而非從頭開始探索儲存庫。
對於大型儲存庫,我應該使用 claude-context 還是 code-review-graph?
當您需要語義化程式碼搜尋時,請使用 claude-context,特別是在您不知道確切檔案或符號名稱的情況下。當您需要結構性答案(例如呼叫關係、匯入、測試依賴項以及審查影響範圍)時,請使用 code-review-graph。
在 Claude Code 中,「記憶檢索」與「程式碼檢索」有何不同?
是的。程式碼檢索是用來尋找相關的專案檔案或符號;記憶檢索則用於回憶持久的決策、使用者偏好、除錯歷史紀錄以及跨會話的經驗教訓。memsearch 專注於記憶;claude-context 則專注於程式碼檢索。
這些工具會取代提示詞快取或更大的上下文視窗嗎?
不。提示詞快取和大範圍上下文視窗有助於提升容量與降低成本,但它們並不能決定哪些資訊值得關注。上下文管理工具則能從源頭提升輸入模型的資訊品質與密度。
 cccm 11zon
Try Managed Milvus for Free
Zilliz Cloud is hassle-free, powered by Milvus and 10x faster.
Get Started




Like the article? Spread the word