Что такое векторная база данных и как она работает
Векторная база данных индексирует и хранит векторные эмбеддинги для быстрого поиска и нахождения сходных данных, предоставляя такие возможности, как операции CRUD, фильтрация по метаданным и горизонтальное масштабирование, специально разработанные для AI-приложений.
Введение: рост векторных баз данных в эпоху ИИ
На заре ImageNet для ручной разметки набора данных потребовалось 25 000 специалистов. Это ошеломляющее число подчёркивает фундаментальную проблему ИИ: ручная категоризация неструктурированных данных просто не масштабируется. При миллиардах изображений, видео, документов и аудиофайлов, создаваемых ежедневно, потребовалась смена парадигмы в том, как компьютеры понимают контент и взаимодействуют с ним.
Традиционные реляционные базы данных отлично справляются с управлением структурированными данными с предопределёнными форматами и выполнением точных операций поиска. В отличие от них, векторные базы данных специализируются на хранении и поиске неструктурированных данных — таких типов, как изображения, аудио, видео и текстовый контент, — с помощью многомерных числовых представлений, известных как векторные эмбеддинги. Векторные базы данных поддерживают большие языковые модели, обеспечивая эффективный поиск и управление данными. Современные векторные базы данных превосходят традиционные системы в 2–10 раз благодаря аппаратно-ориентированной оптимизации (AVX512, SIMD, GPU, NVMe SSD), высокооптимизированным алгоритмам поиска (HNSW, IVF, DiskANN) и колоночной архитектуре хранения. Их облачная архитектура с разделением компонентов обеспечивает независимое масштабирование поиска, вставки данных и индексации, позволяя системам эффективно обрабатывать миллиарды векторов, сохраняя производительность для корпоративных AI-приложений в таких компаниях, как Salesforce, PayPal, eBay и NVIDIA.
Это представляет собой то, что эксперты называют «семантическим разрывом»: традиционные базы данных работают с точными совпадениями и предопределёнными связями, в то время как человеческое понимание контента является нюансированным, контекстуальным и многомерным. Этот разрыв становится всё более проблематичным по мере того, как AI-приложения требуют:
Поиска концептуальных сходств, а не точных совпадений
Понимания контекстуальных связей между различными фрагментами контента
Понимания семантической сути информации за пределами ключевых слов
Обработки мультимодальных данных в единой структуре
Векторные базы данных стали ключевой технологией для преодоления этого разрыва и важнейшим компонентом современной AI-инфраструктуры. Они повышают производительность моделей машинного обучения, облегчая такие задачи, как кластеризация и классификация.
Понимание векторных эмбеддингов: основа
Векторные эмбеддинги служат важнейшим мостом через семантический разрыв. Эти многомерные числовые представления отражают семантическую суть неструктурированных данных в форме, которую компьютеры могут эффективно обрабатывать. Современные модели эмбеддингов преобразуют исходный контент — будь то текст, изображения или аудио — в плотные векторы, где схожие понятия группируются вместе в векторном пространстве, независимо от поверхностных различий.
Например, правильно построенные эмбеддинги разместили бы такие понятия, как «автомобиль», «машина» и «транспортное средство», рядом в векторном пространстве, несмотря на их разные лексические формы. Это свойство позволяет семантическому поиску, рекомендательным системам и AI-приложениям понимать контент не просто на уровне сопоставления шаблонов.
Возможности эмбеддингов распространяются на разные модальности. Современные векторные базы данных поддерживают различные типы неструктурированных данных — текст, изображения, аудио — в единой системе, обеспечивая кросс-модальный поиск и связи, которые ранее невозможно было эффективно моделировать. Эти возможности векторных баз данных имеют решающее значение для AI-технологий, таких как чат-боты и системы распознавания изображений, и поддерживают такие передовые приложения, как семантический поиск и рекомендательные системы.
Однако хранение, индексирование и поиск эмбеддингов в больших масштабах создаёт уникальные вычислительные проблемы, для решения которых традиционные базы данных не были созданы.
Векторные базы данных: основные понятия
Векторные базы данных представляют собой смену парадигмы в том, как мы храним и запрашиваем неструктурированные данные. В отличие от традиционных реляционных систем баз данных, которые отлично справляются с управлением структурированными данными с предопределёнными форматами, векторные базы данных специализируются на обработке неструктурированных данных через числовые векторные представления.
По своей сути векторные базы данных предназначены для решения фундаментальной задачи: обеспечение эффективного поиска по сходству в огромных наборах неструктурированных данных. Они достигают этого с помощью трёх ключевых компонентов:
Векторные эмбеддинги: многомерные числовые представления, отражающие семантическое значение неструктурированных данных (текста, изображений, аудио и т.д.)
Специализированное индексирование: алгоритмы, оптимизированные для многомерных векторных пространств, которые обеспечивают быстрый приближённый поиск. Векторная база данных индексирует векторы, чтобы повысить скорость и эффективность поиска по сходству, используя различные алгоритмы машинного обучения для создания индексов на основе векторных эмбеддингов.
Метрики расстояния: математические функции, количественно определяющие сходство между векторами
Основной операцией в векторной базе данных является запрос k ближайших соседей (KNN), который находит k векторов, наиболее похожих на заданный вектор запроса. Для крупномасштабных приложений такие базы данных обычно реализуют алгоритмы приближённого поиска ближайшего соседа (ANN), жертвуя небольшой точностью ради значительного выигрыша в скорости поиска.
Математические основы сходства векторов
Понимание векторных баз данных требует усвоения математических принципов, лежащих в основе сходства векторов. Вот основополагающие концепции:
Векторные пространства и эмбеддинги
Векторный эмбеддинг — это массив чисел с плавающей запятой фиксированной длины (размерность может составлять от 100 до 32 768 измерений!), который представляет неструктурированные данные в числовом формате. Эти эмбеддинги располагают похожие объекты ближе друг к другу в многомерном векторном пространстве.
Например, слова «king» и «queen» будут иметь векторные представления, расположенные ближе друг к другу, чем любое из них к слову «automobile», в хорошо обученном пространстве словесных эмбеддингов.
Метрики расстояния
Выбор метрики расстояния фундаментально влияет на то, как вычисляется сходство. К распространённым метрикам расстояния относятся:
Евклидово расстояние: расстояние по прямой между двумя точками в евклидовом пространстве.
Косинусное сходство: измеряет косинус угла между двумя векторами, фокусируясь на направлении, а не на величине.
Скалярное произведение: для нормализованных векторов показывает, насколько два вектора сонаправлены.
Манхэттенское расстояние (норма L1): сумма абсолютных разностей между координатами.
Различные варианты использования могут требовать разных метрик расстояния. Например, косинусное сходство часто хорошо работает для текстовых эмбеддингов, тогда как евклидово расстояние может лучше подходить для некоторых типов эмбеддингов изображений.
Семантическое сходство между векторами в векторном пространстве
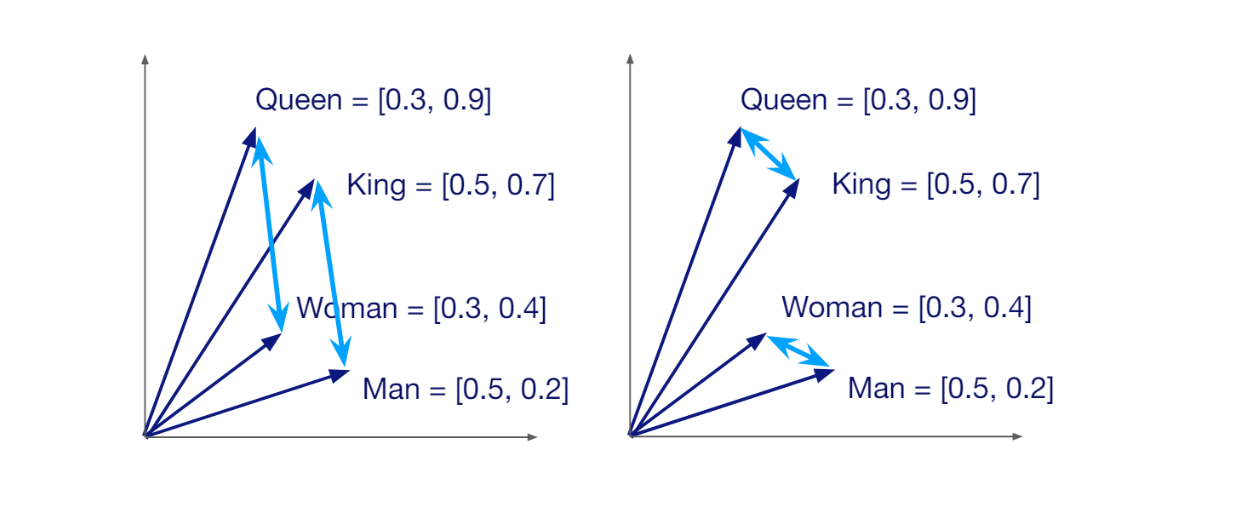 Семантическое сходство между векторами в векторном пространстве
Понимание этих математических основ подводит к важному вопросу реализации: значит, достаточно просто добавить векторный индекс к любой базе данных, верно?
Просто добавить векторный индекс в реляционную базу данных недостаточно, как и использовать автономную библиотеку векторных индексов. Хотя векторные индексы обеспечивают важнейшую возможность эффективно находить похожие векторы, им не хватает инфраструктуры, необходимой для production-приложений:
Они не предоставляют операций CRUD для управления векторными данными
В них отсутствуют возможности хранения и фильтрации метаданных
Они не обеспечивают встроенного масштабирования, репликации или отказоустойчивости
Они требуют создания собственной инфраструктуры для хранения и управления данными
Векторные базы данных появились для устранения этих ограничений, предоставляя полные возможности управления данными, предназначенные специально для векторных эмбеддингов. Они сочетают семантическую мощь векторного поиска с эксплуатационными возможностями систем баз данных.
В отличие от традиционных баз данных, которые работают с точными совпадениями, векторные базы данных ориентированы на семантический поиск — нахождение векторов, «наиболее похожих» на вектор запроса в соответствии с определёнными метриками расстояния. Это фундаментальное различие определяет уникальную архитектуру и алгоритмы, лежащие в основе этих специализированных систем.
Другие специализированные хранилища следуют той же логике — высокочастотные упорядоченные по времени данные о событиях обычно хранятся в базе данных временных рядов, такой как QuestDB, а векторная база данных хранит эмбеддинги, полученные из этих данных.
Архитектура векторных баз данных: техническая структура
Современные векторные базы данных реализуют сложную многоуровневую архитектуру, которая разделяет обязанности, обеспечивает масштабируемость и поддерживаемость. Эта техническая структура выходит далеко за рамки простых поисковых индексов, создавая системы, способные обрабатывать производственные AI-нагрузки. Векторные базы данных работают, обрабатывая и извлекая информацию для AI- и ML-приложений, используя алгоритмы приближённого поиска ближайших соседей, преобразуя различные типы исходных данных в векторы и эффективно управляя разнообразными типами данных с помощью семантического поиска.
Четырёхуровневая архитектура
Production-векторная база данных обычно состоит из четырёх основных архитектурных уровней:
Уровень хранения: управляет постоянным хранением векторных данных и метаданных, реализует специализированные стратегии кодирования и сжатия, а также оптимизирует шаблоны ввода-вывода для векторного доступа.
Уровень индексации: поддерживает несколько алгоритмов индексирования, управляет их созданием и обновлением, а также реализует аппаратно-зависимые оптимизации для повышения производительности.
Уровень запросов: обрабатывает входящие запросы, определяет стратегии выполнения, управляет обработкой результатов и реализует кэширование для повторяющихся запросов.
Сервисный уровень: управляет клиентскими подключениями, обрабатывает маршрутизацию запросов, обеспечивает мониторинг и журналирование, а также реализует безопасность и мультиарендность.
Рабочий процесс векторного поиска
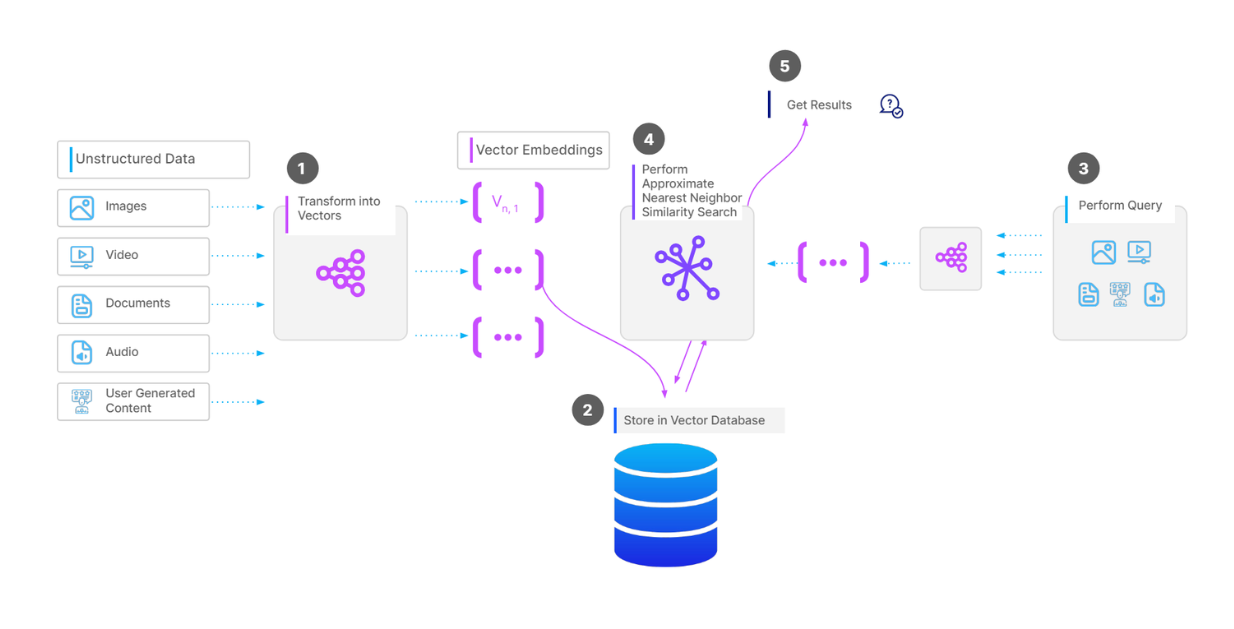 Полный рабочий процесс операции векторного поиска.png
Типичная реализация векторной базы данных следует следующему рабочему процессу:
Модель машинного обучения преобразует неструктурированные данные (текст, изображения, аудио) в векторные эмбеддинги
Эти векторные эмбеддинги сохраняются в базе данных вместе с соответствующими метаданными
Когда пользователь выполняет запрос, он преобразуется в векторный эмбеддинг с использованием той же модели
База данных сравнивает вектор запроса с сохранёнными векторами с помощью алгоритма приближённого поиска ближайшего соседа
Система возвращает top-K наиболее релевантных результатов на основе сходства векторов
При необходимости на этапе постобработки могут применяться дополнительные фильтры или повторное ранжирование
Этот конвейер обеспечивает эффективный семантический поиск по огромным коллекциям неструктурированных данных, что было бы невозможно при традиционных подходах к базам данных.
Согласованность в векторных базах данных
Обеспечение согласованности в распределённых векторных базах данных является сложной задачей из-за компромисса между производительностью и корректностью. Хотя в крупномасштабных системах обычно используется итоговая согласованность (eventual consistency), для критически важных приложений, таких как обнаружение мошенничества и рекомендации в реальном времени, требуются модели строгой согласованности. Такие методы, как запись на основе кворума и распределённый консенсус (например, Raft, Paxos), обеспечивают целостность данных без чрезмерных потерь производительности.
Production-реализации используют архитектуру с общим хранилищем, предусматривающую разделение хранения и вычислений. Это разделение следует принципу разъединения плоскости данных и плоскости управления, при этом каждый уровень может масштабироваться независимо для оптимального использования ресурсов.
Управление подключениями, безопасностью и мультиарендностью
Поскольку такие базы данных используются в многопользовательских и мультиарендных средах, защита данных и управление контролем доступа имеют решающее значение для обеспечения конфиденциальности.
Такие меры безопасности, как шифрование (как при хранении, так и при передаче), защищают конфиденциальные данные, например эмбеддинги и метаданные. Аутентификация и авторизация гарантируют, что доступ к системе имеют только авторизованные пользователи, с детализированными правами для управления доступом к конкретным данным.
Контроль доступа определяет роли и разрешения для ограничения доступа к данным. Это особенно важно для баз данных, хранящих конфиденциальную информацию, например данные клиентов или проприетарные модели ИИ.
Мультиарендность предполагает изоляцию данных каждого арендатора для предотвращения несанкционированного доступа при одновременном совместном использовании ресурсов. Это достигается с помощью шардирования, секционирования или защиты на уровне строк, что обеспечивает масштабируемый и безопасный доступ для разных команд или клиентов.
Внешние системы управления идентификацией и доступом (IAM) интегрируются с векторными базами данных для применения политик безопасности и обеспечения соответствия отраслевым стандартам.
Преимущества векторных баз данных
Векторные базы данных предлагают ряд преимуществ по сравнению с традиционными базами данных, что делает их идеальным выбором для работы с векторными данными. Вот некоторые из ключевых преимуществ:
Эффективный поиск по сходству: одна из отличительных особенностей векторных баз данных — способность выполнять эффективный семантический поиск. В отличие от традиционных баз данных, полагающихся на точные совпадения, векторные базы данных отлично находят точки данных, похожие на заданный вектор запроса. Эта возможность имеет решающее значение для таких приложений, как рекомендательные системы, где поиск элементов, похожих на прошлые взаимодействия пользователя, может значительно улучшить пользовательский опыт.
Работа с многомерными данными: векторные базы данных специально разработаны для эффективного управления данными высокой размерности. Это делает их особенно подходящими для приложений в области обработки естественного языка, компьютерного зрения и геномики, где данные часто существуют в пространствах высокой размерности. Используя передовые алгоритмы индексирования и поиска, векторные базы данных могут быстро извлекать релевантные точки данных даже в сложных наборах векторных эмбеддингов.
Масштабируемость: масштабируемость — критически важное требование для современных AI-приложений, и векторные базы данных созданы для эффективного масштабирования. Работая с миллионами или миллиардами векторов, векторные базы данных справляются с растущими требованиями AI-приложений благодаря горизонтальному масштабированию. Это гарантирует стабильную производительность даже при увеличении объёмов данных.
Гибкость: векторные базы данных предлагают замечательную гибкость с точки зрения представления данных. Они могут хранить и обрабатывать различные типы данных, включая числовые признаки, эмбеддинги текстов или изображений и даже сложные данные, такие как молекулярные структуры. Такая универсальность делает векторные базы данных мощным инструментом для широкого круга приложений — от анализа текстов до научных исследований.
Приложения реального времени: многие векторные базы данных оптимизированы для запросов в реальном времени или близком к реальному. Это особенно важно для приложений, требующих быстрых ответов, — таких как обнаружение мошенничества, рекомендации в реальном времени и интерактивные AI-системы. Возможность быстрого поиска по сходству гарантирует, что такие приложения смогут предоставлять своевременные и релевантные результаты.
Варианты использования векторных баз данных
Векторные базы данных находят широкое применение в различных отраслях, демонстрируя свою универсальность и мощь. Вот некоторые примечательные варианты использования:
Обработка естественного языка: в области обработки естественного языка (NLP) векторные базы данных играют решающую роль. Они используются для таких задач, как классификация текстов, анализ тональности и машинный перевод. Преобразуя текст в многомерные векторные эмбеддинги, векторные базы данных обеспечивают эффективный поиск по сходству и семантическое понимание, повышая производительность NLP-моделей.
Компьютерное зрение: векторные базы данных также широко используются в приложениях компьютерного зрения. Такие задачи, как распознавание изображений, обнаружение объектов и сегментация изображений, выигрывают от способности векторных баз данных обрабатывать многомерные эмбеддинги изображений. Это позволяет быстро и точно находить визуально похожие изображения, что делает векторные базы данных незаменимыми в таких областях, как автономное вождение, медицинская визуализация и управление цифровыми активами.
Геномика: в геномике векторные базы данных используются для хранения и анализа генетических последовательностей, белковых структур и других молекулярных данных. Высокая размерность таких данных делает векторные базы данных идеальным выбором для управления большими геномными наборами данных и запросов к ним. Исследователи могут выполнять векторный поиск для нахождения генетических последовательностей со схожими паттернами, что помогает в обнаружении генетических маркеров и понимании сложных биологических процессов.
Рекомендательные системы: векторные базы данных являются краеугольным камнем современных рекомендательных систем. Храня взаимодействия пользователей и признаки элементов в виде векторных эмбеддингов, такие базы данных могут быстро находить элементы, похожие на те, с которыми пользователь взаимодействовал ранее. Эта возможность повышает точность и релевантность рекомендаций, улучшая удовлетворённость и вовлечённость пользователей.
Чат-боты и виртуальные ассистенты: векторные базы данных используются в чат-ботах и виртуальных ассистентах для предоставления контекстуальных ответов на запросы пользователей в реальном времени. Преобразуя ввод пользователя в векторные эмбеддинги, такие системы могут выполнять поиск по сходству, чтобы находить наиболее релевантные ответы. Это позволяет чат-ботам и виртуальным ассистентам давать более точные и контекстуально уместные ответы, улучшая общий пользовательский опыт.
Используя уникальные возможности векторных баз данных, организации из разных отраслей могут создавать более интеллектуальные, отзывчивые и масштабируемые AI-приложения.
Алгоритмы векторного поиска: от теории к практике
Векторные базы данных требуют специализированных алгоритмов индексирования для обеспечения эффективного поиска по сходству в пространствах высокой размерности. Выбор алгоритма напрямую влияет на точность, скорость, использование памяти и масштабируемость.
Графовые подходы
HNSW (алгоритм иерархического навигационного малого мира) создаёт навигационные структуры, соединяя похожие векторы, что обеспечивает эффективный обход при поиске. HNSW ограничивает максимальное количество связей на узел и область поиска, чтобы сбалансировать производительность и точность, что делает его одним из наиболее широко используемых алгоритмов поиска по сходству векторов.
Cagra — это графовый индекс, оптимизированный специально для ускорения на GPU. Он строит навигационные графовые структуры, согласованные с паттернами обработки на GPU, что обеспечивает массовое параллельное сравнение векторов. Эффективность Cagra обусловлена способностью балансировать полноту и производительность с помощью настраиваемых параметров, таких как степень графа и ширина поиска. Использование GPU инференс-класса с Cagra может быть более экономичным, чем дорогостоящее оборудование для обучения, обеспечивая при этом высокую пропускную способность, особенно для крупномасштабных векторных коллекций. Однако стоит отметить, что GPU-индексы, такие как Cagra, не обязательно снижают задержку по сравнению с CPU-индексами, если только система не работает в условиях высокой нагрузки запросов.
Методы квантования
Продуктовое квантование (PQ) разбивает многомерные векторы на меньшие подвекторы, квантуя каждый из них отдельно. Это значительно сокращает потребности в хранилище (часто более чем на 90%), но приводит к некоторой потере точности.
Скалярное квантование (SQ) преобразует 32-битные числа с плавающей запятой в 8-битные целые числа, снижая использование памяти на 75% при минимальном влиянии на точность.
Индексирование на диске: экономически эффективное масштабирование
Для крупномасштабных векторных коллекций (100 млн+ векторов) индексы в памяти становятся непозволительно дорогими. Например, 100 миллионов векторов размерностью 1024 потребовали бы примерно 400 ГБ оперативной памяти. Именно здесь алгоритмы индексирования на диске, такие как DiskANN, обеспечивают значительную экономию средств.
DiskANN, основанный на графовом алгоритме Vamana, обеспечивает эффективный векторный поиск, храня большую часть индекса на NVMe SSD, а не в оперативной памяти. Такой подход даёт несколько преимуществ с точки зрения затрат:
Снижение затрат на оборудование: организации могут разворачивать векторный поиск в больших масштабах на стандартном оборудовании с умеренными объёмами ОЗУ
Снижение эксплуатационных расходов: меньший объём оперативной памяти означает более низкое энергопотребление и затраты на охлаждение в центрах обработки данных
Линейное масштабирование затрат: затраты на память растут линейно с объёмом данных, при этом производительность остаётся относительно стабильной
Оптимизированные паттерны ввода-вывода: специализированная конструкция DiskANN минимизирует чтения с диска благодаря продуманным стратегиям обхода графа
Расплатой за это обычно становится небольшое увеличение задержки запросов (часто всего на 2–3 мс) по сравнению с чисто резидентными подходами, что приемлемо для многих производственных сценариев.
Специализированные типы индексов
Индексы бинарных эмбеддингов специализированы для компьютерного зрения, формирования цифровых отпечатков изображений и рекомендательных систем, где данные могут быть представлены в виде бинарных признаков. Эти индексы служат для разных потребностей приложений. Для дедупликации изображений, цифровых водяных знаков и обнаружения нарушений авторских прав, где критически важным является точное совпадение, оптимизированные бинарные индексы обеспечивают точное обнаружение сходств. Для высоконагруженных рекомендательных систем, контентно-ориентированного поиска изображений и крупномасштабного сопоставления признаков, где скорость важнее идеальной полноты, бинарные индексы дают исключительные преимущества в производительности.
Индексы разреженных векторов оптимизированы для векторов, где большинство элементов равны нулю и лишь немногие имеют ненулевые значения. В отличие от плотных векторов (где большинство или все измерения содержат значимые значения), разреженные векторы эффективно представляют данные со множеством измерений, но небольшим числом активных признаков. Такое представление особенно распространено в обработке текста, где документ может использовать лишь небольшое подмножество всех возможных слов словаря. Индексы разреженных векторов отлично подходят для задач обработки естественного языка, таких как семантический поиск документов, полнотекстовые запросы и тематическое моделирование. Эти индексы особенно ценны для корпоративного поиска по большим коллекциям документов, для поиска в юридических документах, где необходимо эффективно находить конкретные термины и понятия, а также для академических исследовательских платформ, индексирующих миллионы статей со специализированной терминологией.
Расширенные возможности запросов
В основе векторных баз данных лежит их способность выполнять эффективный семантический поиск. Возможности векторного поиска варьируются от базового сопоставления по сходству до продвинутых методов повышения релевантности и разнообразия результатов.
Базовый поиск ANN
Поиск приближённого ближайшего соседа (ANN) — это базовый метод поиска в векторных базах данных. В отличие от точного поиска k ближайших соседей (kNN), который сравнивает вектор запроса с каждым вектором в базе данных, ANN-поиск использует индексные структуры для быстрого выявления подмножества векторов, которые, скорее всего, окажутся наиболее похожими, что кардинально повышает производительность.
Ключевые компоненты ANN-поиска включают:
Векторы запроса: векторное представление того, что вы ищете
Индексные структуры: заранее созданные структуры данных, организующие векторы для эффективного поиска
Типы метрик: математические функции, такие как евклидова (L2), косинусная или скалярное произведение, которые измеряют сходство между векторами
Результаты Top-K: заданное количество наиболее похожих векторов для возврата
Векторные базы данных предоставляют оптимизации для повышения эффективности поиска:
Пакетный векторный поиск: поиск с несколькими векторами запроса параллельно
Секционированный поиск: ограничение поиска определёнными секциями данных
Постраничный вывод: использование параметров limit и offset для получения больших наборов результатов
Выбор полей вывода: управление тем, какие поля сущностей возвращаются вместе с результатами
Продвинутые методы поиска
Поиск по диапазону
Поиск по диапазону повышает релевантность результатов, ограничивая их векторами, чьи оценки сходства попадают в определённый диапазон. В отличие от стандартного ANN-поиска, который возвращает top-K наиболее похожих векторов, поиск по диапазону определяет «кольцевую область» с помощью:
Внешней границы (радиуса), задающей максимально допустимое расстояние
Внутренней границы (range_filter), которая может исключать слишком похожие векторы
Такой подход особенно полезен, когда нужно найти «похожие, но не идентичные» объекты, например рекомендации товаров, связанных с тем, что пользователь уже просматривал, но не являющихся его точными копиями.
Поиск с фильтрацией
Поиск с фильтрацией сочетает векторное сходство с ограничениями по метаданным, сужая результаты до векторов, соответствующих определённым критериям. Например, в каталоге товаров можно найти визуально похожие товары, но ограничить результаты конкретным брендом или ценовым диапазоном.
Высокомасштабируемые векторные базы данных поддерживают два подхода к фильтрации:
Стандартная фильтрация: применяет фильтры по метаданным перед векторным поиском, значительно сокращая пул кандидатов
Итеративная фильтрация: сначала выполняет векторный поиск, затем применяет фильтры к каждому результату, пока не будет достигнуто желаемое количество совпадений
Текстовое совпадение
Текстовое совпадение обеспечивает точный поиск документов по конкретным терминам, дополняя поиск по векторному сходству возможностями точного текстового сопоставления. В отличие от семантического поиска, который находит концептуально похожий контент, текстовое совпадение фокусируется на поиске точных вхождений терминов запроса.
Например, поиск товаров может комбинировать текстовое совпадение для нахождения товаров, в которых явно упоминается «водонепроницаемый», с векторным сходством для нахождения визуально похожих товаров, что гарантирует соблюдение как требований семантической релевантности, так и конкретных характеристик.
Группирующий поиск
Группирующий поиск объединяет результаты по указанному полю для повышения разнообразия результатов. Например, в коллекции документов, где каждый абзац является отдельным вектором, группировка гарантирует, что результаты будут получены из разных документов, а не из нескольких абзацев одного и того же документа.
Этот метод полезен для:
Систем поиска документов, где требуется представленность из разных источников
Рекомендательных систем, которым необходимо предлагать разнообразные варианты
Поисковых систем, где разнообразие результатов так же важно, как и сходство
Гибридный поиск
Гибридный поиск объединяет результаты из нескольких векторных полей, каждое из которых может представлять различные аспекты данных или использовать разные модели эмбеддингов. Это позволяет:
Комбинировать разреженные и плотные векторы: сочетание семантического понимания (плотные векторы) с сопоставлением по ключевым словам (разреженные векторы) для более полного текстового поиска
Мультимодальный поиск: нахождение совпадений по различным типам данных, например поиск товаров с использованием как изображений, так и текстовых запросов
Реализации гибридного поиска используют сложные стратегии повторного ранжирования для объединения результатов:
Взвешенное ранжирование: отдаёт приоритет результатам из определённых векторных полей
Комбинирование взаимных рангов: уравновешивает результаты по всем векторным полям без особого акцента на каком-либо из них
Полнотекстовый поиск
Возможности полнотекстового поиска в современных векторных базах данных устраняют разрыв между традиционным текстовым поиском и векторным сходством. Такие системы:
Автоматически преобразуют текстовые запросы в разреженные эмбеддинги
Находят документы, содержащие конкретные термины или фразы
Ранжируют результаты на основе как релевантности терминов, так и семантического сходства
Дополняют векторный поиск, находя точные совпадения, которые семантический поиск может пропустить
Такой гибридный подход особенно ценен для комплексных систем информационного поиска, которым требуется как точное сопоставление терминов, так и семантическое понимание.
Инженерная оптимизация производительности: ключевые метрики
Оптимизация производительности векторных баз данных требует понимания ключевых метрик и компромиссов между ними.
Компромисс между полнотой и пропускной способностью
Полнота (recall) измеряет долю истинных ближайших соседей среди возвращаемых результатов. Более высокая полнота требует более тщательного поиска, что снижает пропускную способность (количество запросов в секунду). Production-системы балансируют эти метрики в зависимости от требований приложения, обычно достигая полноты 80–99% в зависимости от сценария использования.
При оценке производительности векторных баз данных стандартизированные среды бенчмаркинга, такие как ANN-Benchmarks, предоставляют ценные сравнительные данные. Эти инструменты измеряют ключевые метрики, включая:
Полноту поиска: долю запросов, для которых истинные ближайшие соседи найдены среди возвращаемых результатов
Количество запросов в секунду (QPS): скорость обработки запросов базой данных в стандартизированных условиях
Производительность при различных размерах и размерностях наборов данных
Альтернативой является система с открытым исходным кодом под названием VDB Bench. VectorDBBench — это инструмент бенчмаркинга с открытым исходным кодом, предназначенный для оценки и сравнения производительности основных векторных баз данных, таких как Milvus и Zilliz Cloud, с использованием собственных наборов данных. Он также помогает разработчикам выбрать наиболее подходящую векторную базу данных для их сценариев использования.
Эти бенчмарки позволяют организациям определить наиболее подходящую реализацию векторной базы данных для своих конкретных требований с учётом баланса между точностью, скоростью и масштабируемостью.
Управление памятью
Эффективное управление памятью позволяет векторным базам данных масштабироваться до миллиардов векторов, сохраняя производительность:
Динамическое выделение памяти регулирует использование памяти в зависимости от характеристик рабочей нагрузки
Политики кэширования сохраняют часто запрашиваемые векторы в памяти
Методы сжатия векторов значительно снижают требования к памяти
Для наборов данных, превышающих объём памяти, дисковые решения предоставляют важнейшую возможность. Эти алгоритмы оптимизируют паттерны ввода-вывода для NVMe SSD с помощью таких методов, как лучевой поиск (beam search) и навигация по графу.
Продвинутая фильтрация и гибридный поиск
Векторные базы данных сочетают семантическое сходство с традиционной фильтрацией, создавая мощные возможности запросов:
Предварительная фильтрация применяет ограничения по метаданным до векторного поиска, сокращая множество кандидатов для сравнения по сходству
Последующая фильтрация сначала выполняет векторный поиск, а затем применяет фильтры к результатам
Индексирование метаданных повышает производительность фильтрации за счёт специализированных индексов для различных типов данных
Высокопроизводительные векторные базы данных поддерживают сложные шаблоны запросов, сочетающие несколько векторных полей со скалярными ограничениями. Мультивекторные запросы находят сущности, похожие одновременно на несколько эталонных точек, тогда как запросы с отрицательными векторами исключают векторы, похожие на указанные примеры.
Масштабирование векторных баз данных в продакшене
Векторные базы данных требуют продуманных стратегий развёртывания для обеспечения оптимальной производительности при различных масштабах:
Развёртывания малого масштаба (миллионы векторов) могут эффективно работать на одной машине с достаточным объёмом памяти
Развёртывания среднего масштаба (десятки и сотни миллионов) выигрывают от вертикального масштабирования с использованием инстансов с большим объёмом памяти и SSD-хранилищ
Развёртывания на миллиарды векторов требуют горизонтального масштабирования на нескольких узлах со специализированными ролями
Шардирование и репликация образуют основу масштабируемой архитектуры векторных баз данных:
Горизонтальное шардирование разделяет коллекции между несколькими узлами
Репликация создаёт резервные копии данных, повышая как отказоустойчивость, так и пропускную способность запросов
Современные системы динамически корректируют коэффициенты репликации на основе паттернов запросов и требований к надёжности.
Влияние на реальный мир
Гибкость высокопроизводительных векторных баз данных очевидна в их вариантах развёртывания. Системы могут работать в самых разных средах: от лёгких установок на ноутбуках для прототипирования до масштабных распределённых кластеров, управляющих десятками миллиардов векторов. Такая масштабируемость позволила организациям переходить от концепции к производству, не меняя технологий баз данных.
Такие компании, как Salesforce, PayPal, eBay, NVIDIA, IBM и Airbnb, теперь полагаются на векторные базы данных, такие как open-source Milvus, для обеспечения работы крупномасштабных AI-приложений. Эти внедрения охватывают разнообразные сценарии — от сложных систем рекомендаций товаров до модерации контента, обнаружения мошенничества и автоматизации поддержки клиентов, — и все они построены на основе векторного поиска.
В последние годы векторные базы данных стали жизненно важными для решения проблемы галлюцинаций, распространённой в больших языковых моделях, предоставляя доменно-специфические, актуальные или конфиденциальные данные. Например, Zilliz Cloud хранит специализированные данные в виде векторных эмбеддингов. Когда пользователь задаёт вопрос, сервис преобразует запрос в векторы, выполняет ANN-поиск для нахождения наиболее релевантных результатов и объединяет их с исходным вопросом, создавая полный контекст для больших языковых моделей. Эта структура служит основой для разработки надёжных приложений на базе LLM, которые дают более точные и контекстуально релевантные ответы.
Заключение
Появление векторных баз данных — это не просто новая технология; это фундаментальный сдвиг в том, как мы подходим к управлению данными для AI-приложений. Устраняя разрыв между неструктурированными данными и вычислительными системами, векторные базы данных стали важнейшим компонентом современной AI-инфраструктуры, обеспечивая работу приложений, которые понимают и обрабатывают информацию всё более похожими на человеческие способами.
Ключевые преимущества векторных баз данных перед традиционными системами баз данных включают:
Поиск в пространствах высокой размерности: эффективный поиск по сходству для многомерных векторов, используемых в приложениях машинного обучения и генеративного ИИ
Масштабируемость: горизонтальное масштабирование для эффективного хранения и поиска в больших векторных коллекциях
Гибкость с гибридным поиском: работа с различными типами векторных данных, включая разреженные и плотные векторы
Производительность: значительно более быстрый поиск по сходству векторов по сравнению с традиционными базами данных
Настраиваемое индексирование: поддержка пользовательских схем индексирования, оптимизированных под конкретные сценарии использования и типы данных
По мере того как AI-приложения становятся всё более сложными, требования к векторным базам данных продолжают меняться. Современные системы должны балансировать между производительностью, точностью, масштабируемостью и экономической эффективностью, бесшовно интегрируясь с более широкой экосистемой ИИ. Для организаций, стремящихся внедрить ИИ в масштабе, понимание технологии векторных баз данных — это не просто технический вопрос, а стратегическая необходимость.
Попробуйте Managed Milvus бесплатно
Zilliz Cloud работает без проблем, поддерживается Milvus и в 10 раз быстрее.
Начать




Like the article? Spread the word