As 7 melhores ferramentas de código aberto para a gestão do contexto do código do Claude
Pode fornecer ao Claude Code uma janela de contexto de 1M tokens e, mesmo assim, obter respostas cada vez piores com o passar do tempo. A questão não é apenas o tamanho do contexto. É a qualidade do contexto.
As sessões do Claude Code deterioram-se quando os registos do terminal, a saída bruta das ferramentas, as leituras repetidas de ficheiros, as respostas prolixas e o histórico do projeto esquecido competem pela atenção. Em fluxos de trabalho de agentes de longa duração, esse ruído transforma-se num ciclo vicioso: o modelo perde o fio à meada, adiciona-se mais turnos para corrigir a resposta e esses turnos adicionais acrescentam ainda mais ruído.
Isto é o que se denomina «desfocagem do contexto»: o modelo tem espaço suficiente para armazenar informação, mas a informação importante fica enterrada sob contexto de baixo sinal. Janelas maiores podem tornar isto mais fácil de ignorar, porque os programadores deixam de pensar cuidadosamente sobre o que introduzem no prompt.
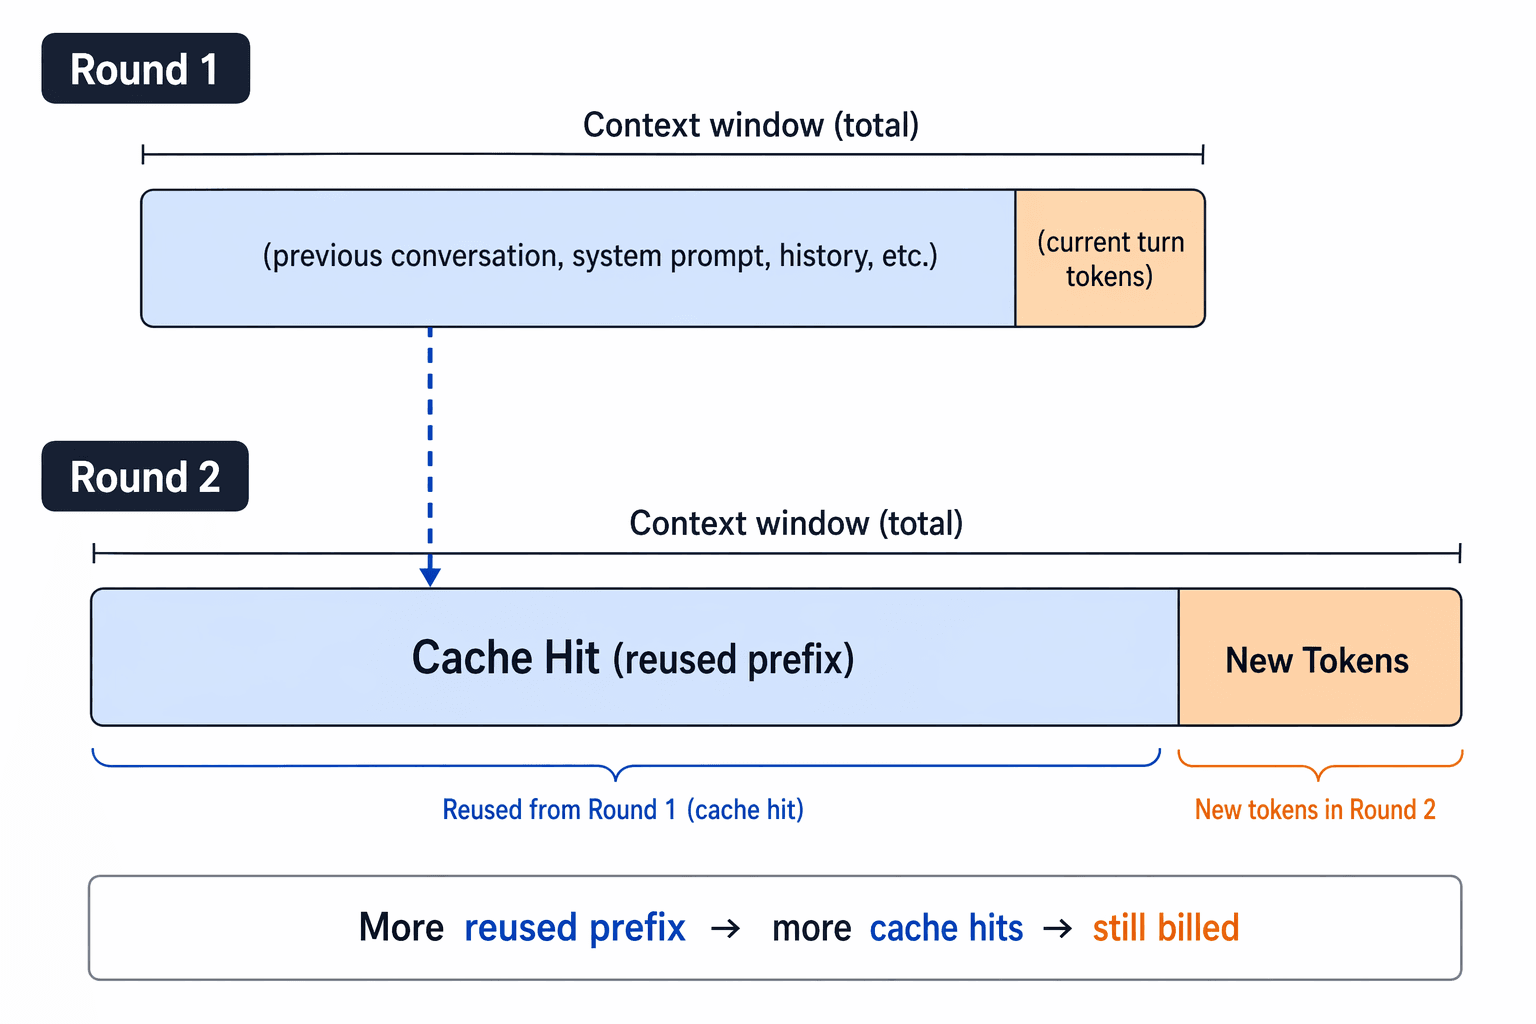 Diagrama de armazenamento em cache de prompts que mostra como os prefixos reutilizados podem ainda assim adicionar contexto faturado ao longo das iterações
O armazenamento em cache de prompts pode reduzir o custo dos prefixos repetidos, mas não transforma a janela de contexto numa gaveta de tralha. Continua a pagar pelos novos tokens e continua a precisar que o modelo raciocine com base na informação correta.
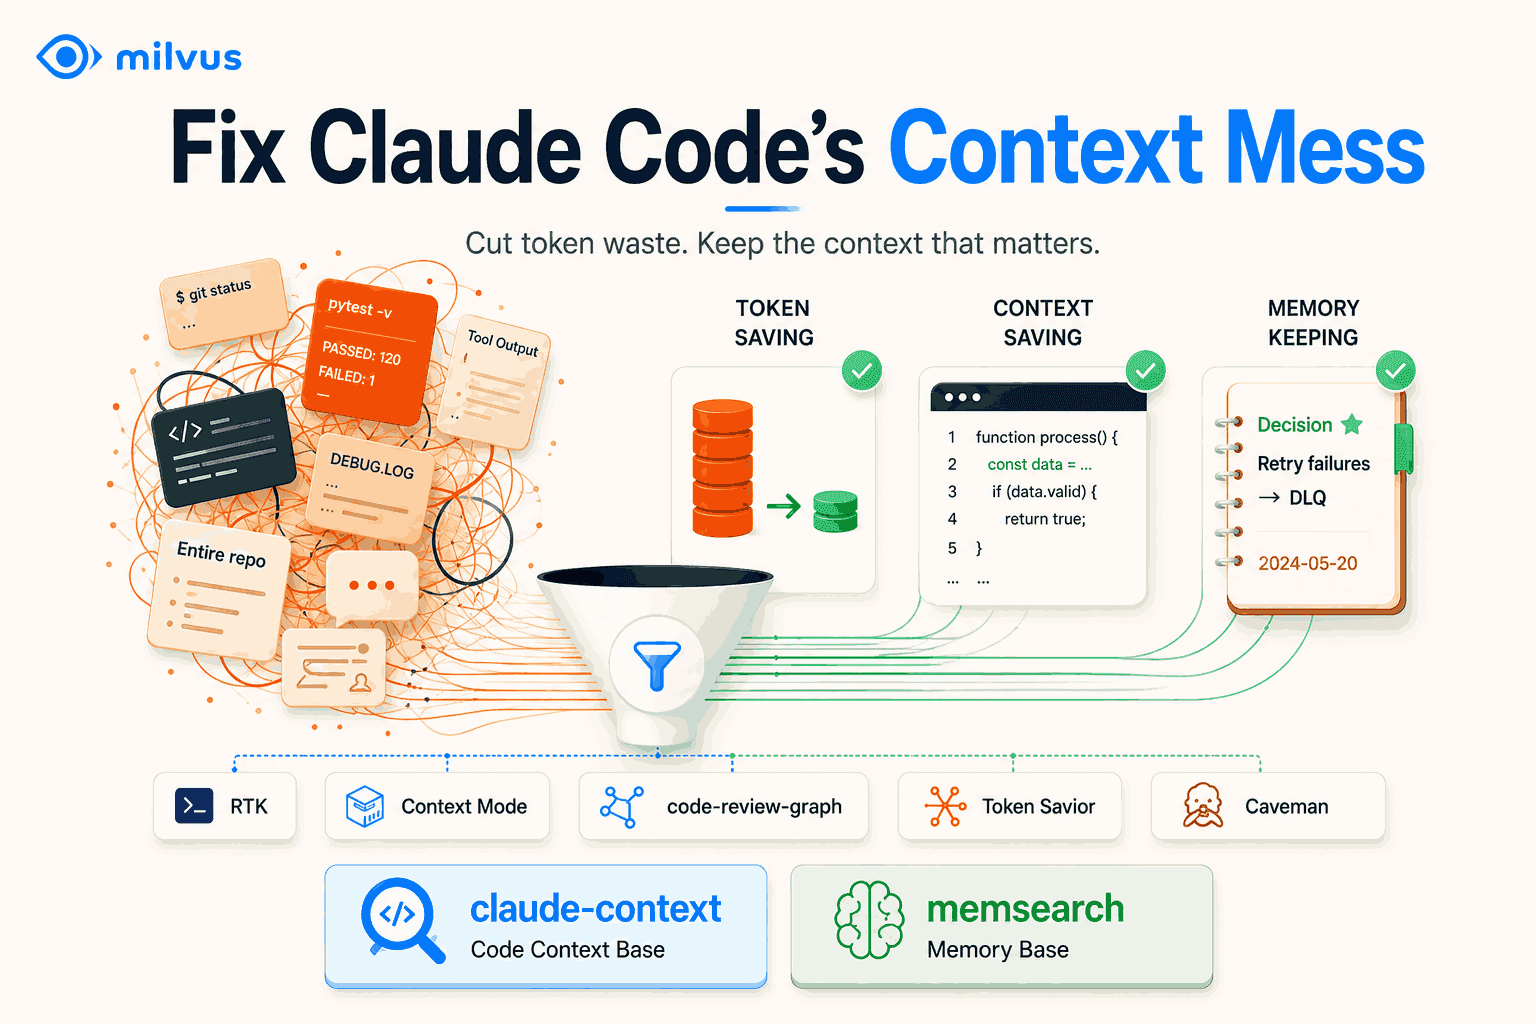
Este artigo analisa sete ferramentas de código aberto que abordam a perda de foco no contexto a partir de diferentes camadas: saída do terminal, saída de ferramentas, navegação na base de código, leitura de ficheiros, verbosidade do modelo, recuperação semântica de código e memória entre sessões. Explica também como estas ideias se relacionam com o design de bases de dados vetoriais, a pesquisa de similaridade vetorial e sistemas de recuperação como o Milvus.
O que causa a perda de foco no contexto do Claude Code?
A perda de contexto no Claude Code decorre geralmente de cinco modos de falha: excesso de texto bruto de instruções, saída ruidosa das ferramentas, exploração repetida da base de código, respostas longas do modelo e lacunas de memória entre sessões ou agentes.
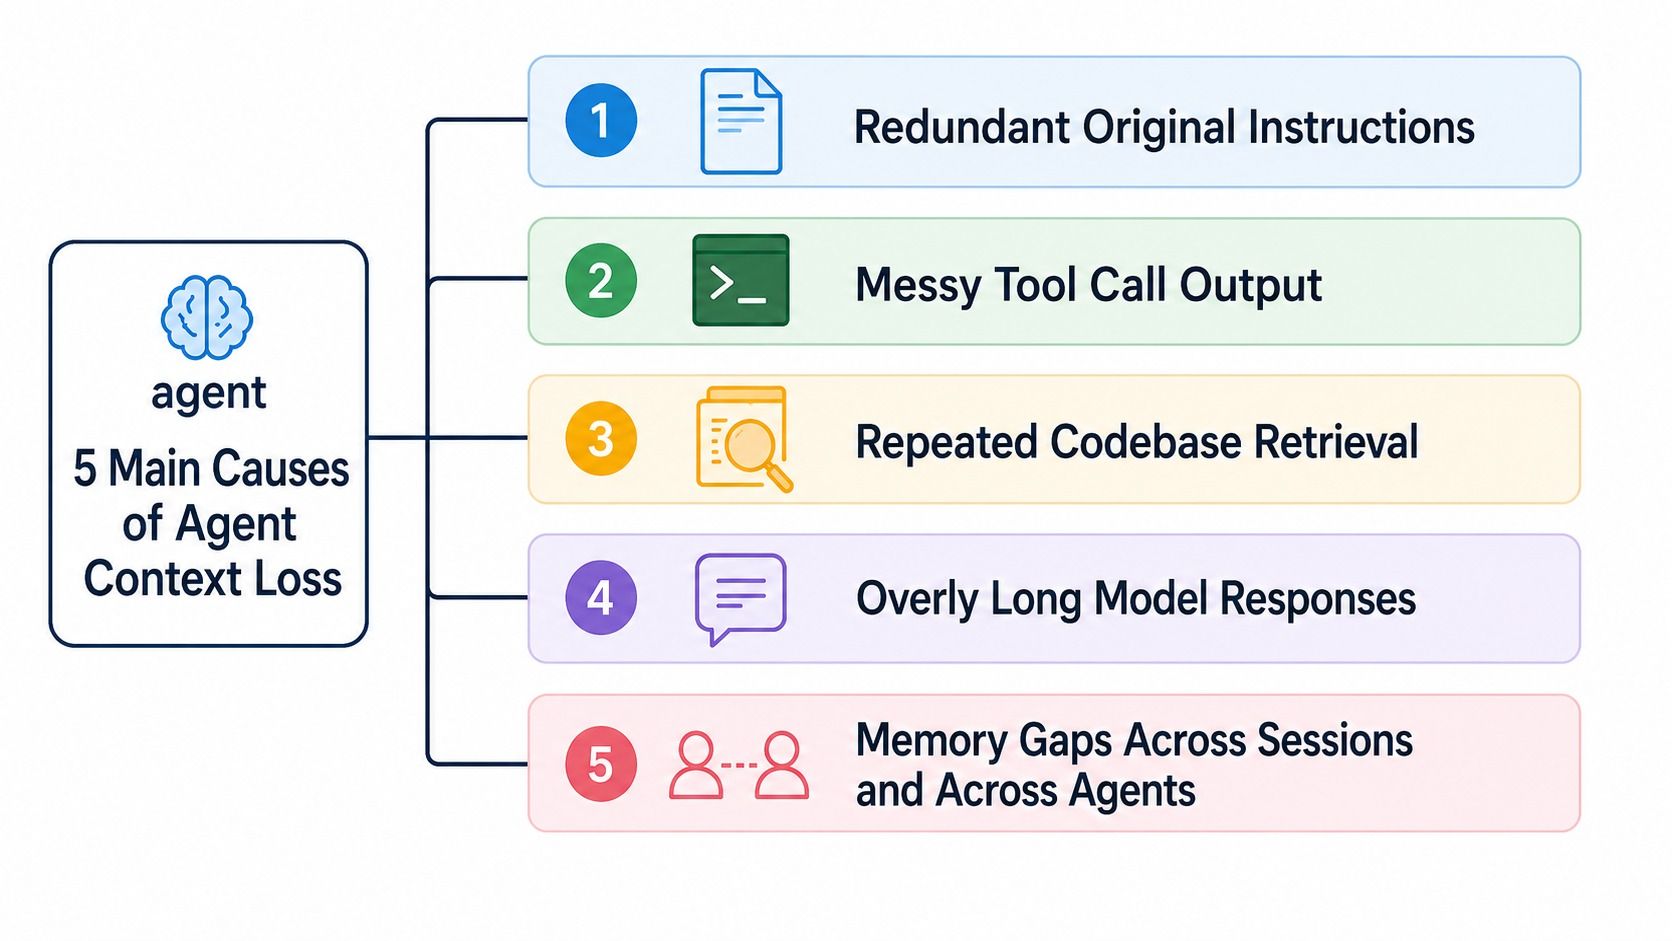 Cinco causas da perda de contexto do Claude Code: instruções redundantes, saída desorganizada da ferramenta, recuperação repetida da base de código, respostas longas e lacunas de memória
| Modo de falha de contexto | Como se manifesta no Claude Code | Categoria de ferramentas que ajuda |
|---|---|---|
| Os registos do terminal são ruidosos | git, pytest, gh, e as CLIs na nuvem apresentam mais texto do que o modelo necessita. | Compressão da saída da CLI |
| As saídas das ferramentas inundam a janela | Os registos de teste, os dumps do DOM e as saídas do MCP aparecem no chat como enormes blocos de dados brutos. | Isolamento das saídas das ferramentas |
| A navegação na base de código repete-se | O Claude lista diretórios, executa comandos grep, lê ficheiros e repete a mesma exploração em todas as sessões. | Gráfico de código ou recuperação semântica |
| A leitura de ficheiros é demasiado abrangente | O modelo lê um ficheiro inteiro quando apenas precisava de um símbolo ou de um resumo. | Leitura progressiva do código |
| O Claude fala demais | A própria resposta acrescenta contexto desnecessário para as próximas trocas de mensagens. | Compressão da resposta |
| A memória não é mantida | Tem de voltar a explicar as decisões do projeto sempre que inicia uma nova sessão. | Memória «Markdown-first» |
Uma boa pilha de gestão de contexto deve fazer três coisas: manter o lixo fora, recuperar o conhecimento certo do projeto quando necessário e preservar decisões duradouras entre sessões.
Qual ferramenta de contexto do Claude Code deve utilizar primeiro?
Começa pela camada que cria mais ruído no teu fluxo de trabalho. Se o problema for a saída do teu terminal, começa pelo RTK. Se o Claude estiver sempre a vaguear por um repositório grande, começa pelo claude-context ou pelo code-review-graph. Se o teu verdadeiro problema for ter de explicar as mesmas decisões todos os dias, começa pelo memsearch.
| Ferramenta | Principal problema que resolve | Melhor adequação |
|---|---|---|
| RTK | Saída ruidosa do terminal proveniente de comandos comuns de programadores. | Desenvolvedores que executam muitos comandos da CLI no Claude Code. |
| Modo de Contexto | Grandes quantidades de saídas brutas de ferramentas a entrar na conversa principal. | Utilizadores intensivos do Playwright, GitHub, registos ou ferramentas MCP. |
| code-review-graph | Exploração às cegas da base de código em repositórios de grande dimensão. | Revisões, análise de dependências e questões sobre o «blast-radius». |
| Token Savior | Leitura completa de ficheiros quando bastaria um resumo de símbolos. | Ficheiros grandes, pesquisas repetidas de símbolos e leitura incremental de código. |
| Caveman | Os próprios hábitos de respostas prolixas do Claude. | Utilizadores que pretendem resultados concisos e um contexto futuro mais reduzido. |
| claude-context | Reexplorar a base de código em cada sessão. | Pesquisa semântica de código através do MCP. |
| memsearch | Perda da memória do projeto entre sessões, agentes e mudanças de modelo. | Projetos de longa duração com decisões e lições duradouras. |
As primeiras cinco ferramentas reduzem o que entra ou permanece no contexto. As duas últimas facilitam a recuperação de contexto útil.
O RTK comprime a saída bruta dos comandos antes de o Claude a ver
O RTK é um proxy de CLI destinado a reduzir o uso de tokens em comandos comuns de desenvolvimento. A sua descrição no GitHub indica que reduz o consumo de tokens do LLM em 60-90% em comandos comuns de desenvolvimento e é fornecido como um único binário em Rust.
Na utilização quotidiana do Claude Code, comandos como git status, pytest e listagens de diretórios costumam descarregar informações completas do ambiente e descrições de estado na janela de contexto. O modelo normalmente precisa apenas de uma resposta mais sucinta: quais os ficheiros que foram alterados, qual o teste que falhou, onde o PR está bloqueado ou quais os ficheiros-chave que existem no diretório.
O RTK situa-se entre o shell e o Claude. Consegue reescrever comandos através de hooks do Claude Code e devolver resultados comprimidos.
Saída bruta do ` git status `:
On branch feat/payment-retry
Your branch is up to date with 'origin/feat/payment-retry'.
Changes not staged for commit:
modified:   src/webhook/handler.ts
modified:   src/queue/dlq.ts
modified:   tests/webhook.test.ts
Untracked files:
docs/notes.md
no changes added to commit
O que realmente importa:
3 modified, 1 untracked
- src/webhook/handler.ts
- src/queue/dlq.ts
- tests/webhook.test.ts
O mesmo se passa com o ` pytest`. A saída em bruto está repleta de casos bem-sucedidos e ruído do ambiente:
============================= test session starts =============================
platform darwin -- Python 3.12.4, pytest-8.4.1
collected 128 items
tests/test_auth.py …
tests/test_webhook.py …F…
tests/test_queue.py …
================================== FAILURES ==================================
________________ test_retry_to_dlq __________________
E   AssertionError: expected status code 202, got 500
Quando comprimida, a mensagem é imediata:
128 tests collected, 1 failed
FAIL tests/test_webhook.py::test_retry_to_dlq
AssertionError: expected status code 202, got 500
O RTK é o ponto de partida mais fácil quando o excesso de contexto provém de comandos do shell, em vez da recuperação de código.
O Modo de Contexto isola saídas gigantescas de ferramentas fora do chat principal
O Modo de Contexto foi concebido para os blocos em bruto que as ferramentas devolvem: registos de teste, instantâneos do DOM do navegador, cargas úteis do GitHub, resultados de ferramentas MCP e páginas extraídas. A sua descrição no GitHub destaca a otimização da janela de contexto para agentes de codificação com IA e relata uma redução de 98% na saída das ferramentas.
 Cartão do repositório do Modo de Contexto no GitHub a mostrar a saída das ferramentas isolada numa sandbox e o posicionamento da otimização do contexto
A sua abordagem consiste em isolar grandes saídas de ferramentas numa sandbox local e num índice, passando depois apenas resumos e identificadores de recuperação para a conversa no Claude.
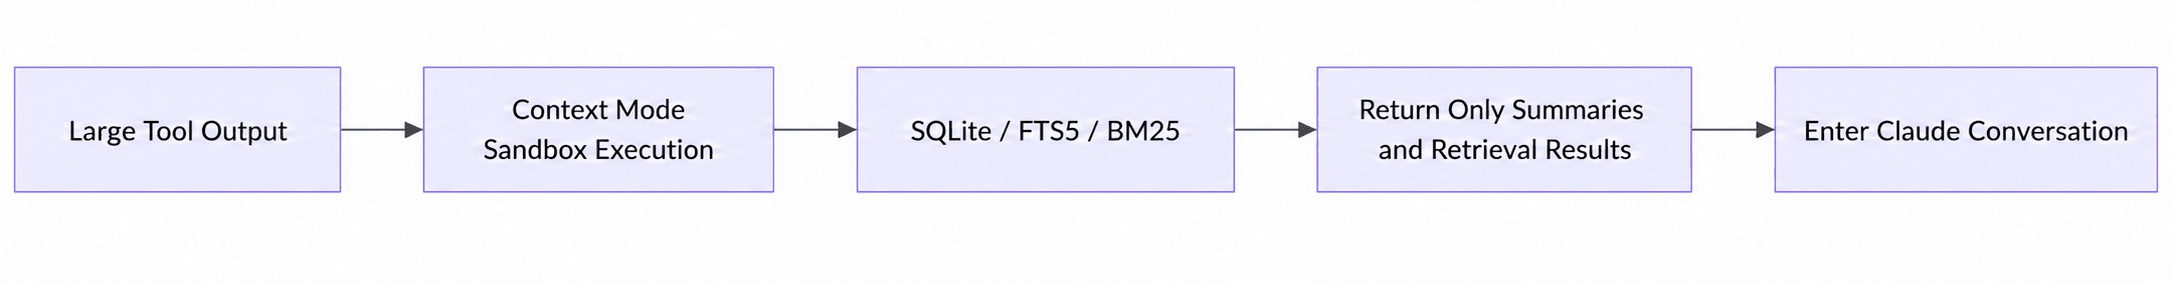 Fluxo do Context Mode a mostrar a saída volumosa das ferramentas a passar pela execução na sandbox, pelos índices SQLite ou FTS, pelos resumos e pelos resultados de recuperação
Este fluxo é útil porque um agente de codificação necessita frequentemente do nó com falha, do seletor avariado ou do rastreio de pilha relevante, e não de todo o DOM ou de cada linha de teste bem-sucedida. O «Context Mode» mantém a saída completa disponível localmente, evitando ao mesmo tempo que esta domine a conversa principal.
Isto é semelhante à forma como os sistemas de pesquisa híbridos de produção separam o armazenamento da recuperação. Mantém-se os dados brutos num local durável e, em seguida, recupera-se apenas a parte que importa.
O `code-review-graph` mapeia a estrutura do código antes de o Claude a percorrer
O `code-review-graph` aborda um problema diferente: o Claude nem sempre precisa de mais texto; precisa de um mapa melhor.
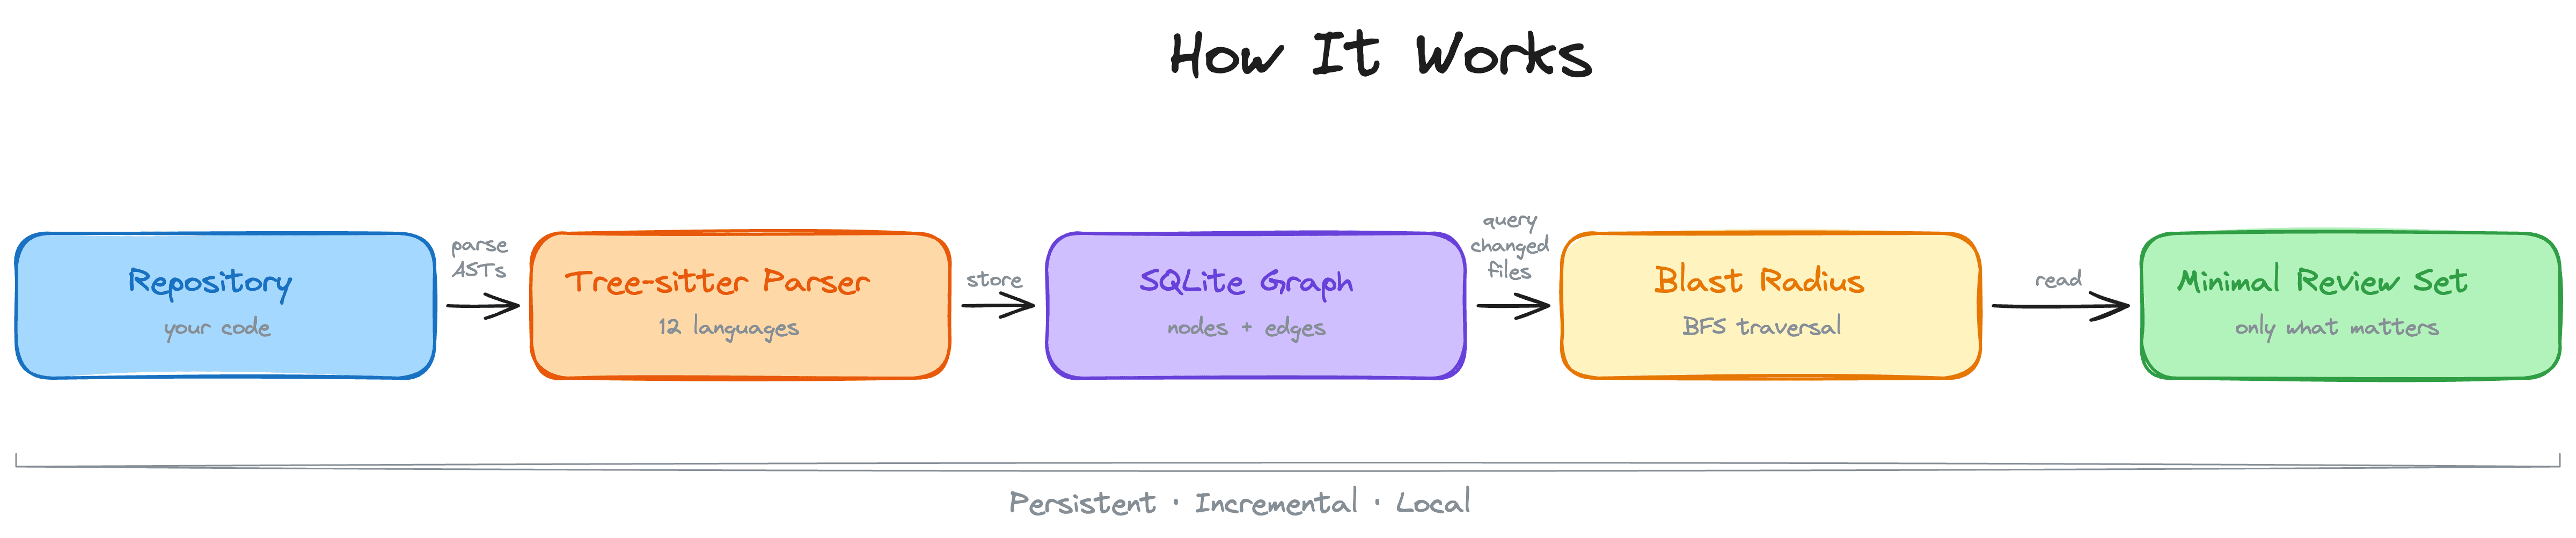 Imagem do logótipo do code-review-graph utilizada no artigo original
Num repositório de grandes dimensões, uma pergunta simples pode desencadear uma exploração dispendiosa:
Depois de alterar esta lógica de início de sessão, que ficheiros e testes são afetados?
Sem um gráfico de código, o procedimento típico do Claude é:
read auth.ts
grep login
read middleware
read tests
keep guessing
O code-review-graph cria previamente um mapa estrutural da base de código. Utiliza o Tree-sitter para analisar funções, classes, importações, relações de chamada, herança e dependências de testes, e depois grava o gráfico no SQLite.
Isso torna-o útil para a revisão de código e a análise do «raio de impacto». Em vez de pedir ao Claude para redescobrir o gráfico de dependências através de leituras repetidas, permite-se que ele consulte a estrutura primeiro.
Isto é semelhante à pesquisa semântica, mas não é idêntico. Um gráfico estrutural responde à pergunta «o que depende de quê?». A recuperação semântica responde à pergunta «que código está conceptualmente relacionado com esta questão?». Em fluxos de trabalho reais com assistentes de código, muitas vezes são necessários ambos.
O Token Savior fornece resumos de símbolos ao Claude antes dos ficheiros completos
A ideia central do Token Savior é simples: não enviar o ficheiro completo por predefinição. Enviar primeiro um índice ou um resumo de símbolos e, só depois, expandir quando a tarefa necessitar de mais detalhes.
 Cartão do repositório GitHub do Token Savior a mostrar a descrição do servidor MCP e as estatísticas do projeto
Se perguntar onde é tratado um webhook de pagamento, o modelo muitas vezes não precisa de todas as linhas de todos os ficheiros relacionados. Primeiro, precisa de saber se um ficheiro ou símbolo é relevante.
O Token Savior fornece código em camadas:
| Camada | O que o Claude recebe | Quando se expande |
|---|---|---|
| Resumo | Índice, nomes de símbolos e breves descrições. | Primeira resposta por predefinição. |
| Fragmento | Uma secção de código mais curta em torno do símbolo relevante. | Quando o resumo for provavelmente relevante. |
| Ficheiro completo | O conteúdo completo do ficheiro. | Apenas quando a edição ou o raciocínio aprofundado assim o exigirem. |
Isto reflete a forma como os programadores realmente lêem o código. Faz-se uma análise rápida, confirma-se a relevância e, só então, abre-se o ficheiro completo quando necessário. Também se assemelha ao padrão de recuperação progressiva utilizado em aplicações RAG: recuperar informação de forma suficientemente abrangente para se orientar e, em seguida, restringir o contexto antes da geração.
O Caveman reduz o excesso de respostas do próprio Claude
A maioria das ferramentas de contexto concentra-se no que entra no modelo. O Caveman centra-se no que o Claude produz.
O Caveman é uma funcionalidade/plug-in do Claude Code que elimina preenchimentos, formalidades, frases de enfeite, explicações excessivas e estruturas repetitivas. O objetivo não é remover conhecimento; é tornar a resposta mais concisa.
Sem o Caveman:
A razão pela qual o teu componente React está a ser renderizado novamente é provavelmente porque…
Com o Caveman:
Nova referência de objeto a cada renderização. Prop de objeto inline = nova referência = nova renderização. Envolver em useMemo.
Isto é importante porque as próprias respostas do Claude tornam-se contexto futuro. Se cada resposta incluir uma explicação longa, a próxima ronda começa com mais texto do que o necessário. Respostas mais curtas podem melhorar a próxima ronda tanto quanto melhoram a atual.
Para equipas que estão a pensar em engenharia de contexto para agentes de IA, o Caveman serve como lembrete de que a política de saída faz parte da política de contexto.
O claude-context adiciona pesquisa semântica de código através do MCP
O claude-context resolve o problema da exploração repetida da base de código com a recuperação semântica. Indexa um repositório, armazena fragmentos de código numa base de dados vetorial e disponibiliza a pesquisa através do Model Context Protocol.
 Repositório do Claude Context apresentado no GitHub Trending no artigo original
Numa base de código grande, faz-se constantemente perguntas ao Claude como:
Ajuda-me a descobrir quais as partes do código que podem estar relacionadas com este bug.
Sem uma camada de recuperação, a abordagem padrão do Claude é frequentemente:
list the directory
grep around
read a bunch of files
keep guessing
O claude-context transfere esse trabalho para uma camada de recuperação. Divide o repositório em fragmentos, gera embeddings, armazena-os num índice de código suportado pelo Milvus e recupera fragmentos de código relevantes antes de o modelo começar a ler ficheiros aleatoriamente.
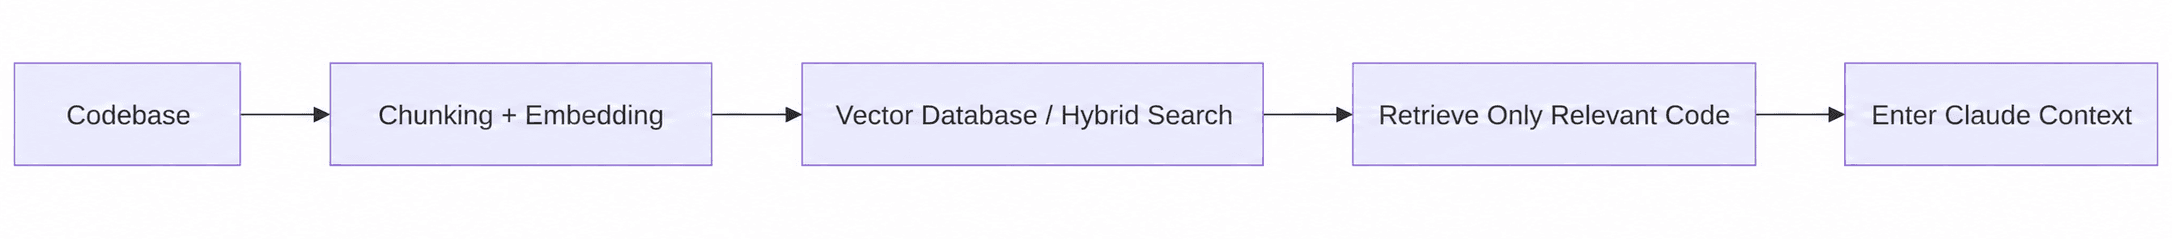 Fluxo do claude-context a mostrar a divisão da base de código em partes, representações, base de dados vetorial e pesquisa híbrida, recuperação de código relevante e injeção de contexto no Claude
É aqui que as ferramentas de codificação com IA começam a assemelhar-se a sistemas de pesquisa. São necessários segmentação, embeddings, metadados, correspondência lexical, classificação e atualidade. Estes são os mesmos blocos de construção subjacentes à recuperação RAG em produção, ao encaminhamento de recuperação híbrida e à seleção de modelos de embedding.
O memsearch mantém a memória útil entre sessões e agentes
O memsearch aborda o lado oposto do problema: não o que esquecer, mas como recordar o que é importante.
 Imagem do logótipo do memsearch retirada do artigo original
Imagine que diz ao Claude na segunda-feira:
O nosso webhook não pode tentar novamente em caso de falha — os eventos com falha têm de ir para uma fila de mensagens perdidas.
Na quarta-feira, abres uma nova sessão e perguntas:
O que mais podemos otimizar na camada do webhook?
Sem memória duradoura, o Claude trata a decisão de segunda-feira como se nunca tivesse acontecido. Explicas-lhe tudo de novo.
O memsearch armazena a memória como ficheiros Markdown locais e legíveis por humanos e utiliza o Milvus como um índice de recuperação reconstruível. Esse design mantém a memória editável por humanos, ao mesmo tempo que a torna pesquisável por agentes.
No momento da recuperação, o memsearch utiliza a recuperação progressiva: primeiro pesquisa, depois expande se necessário e, só então, aprofunda até à transcrição original quando for realmente necessário.
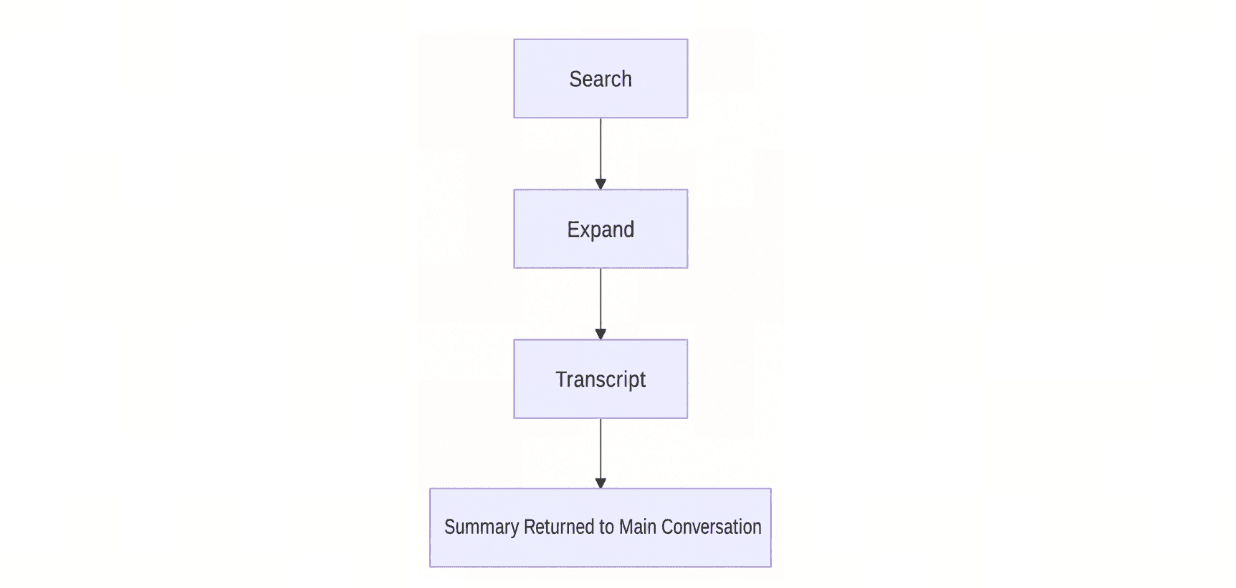 Fluxo de recuperação progressiva do memsearch, mostrando pesquisa, expansão, transcrição e retorno resumido à conversa principal
Este padrão «Markdown-first» é útil para equipas que trabalham em várias sessões, modelos e agentes. Também se integra naturalmente com a memória de longo prazo dos agentes de IA, a memória partilhada entre múltiplos agentes e o problema mais amplo de prevenir a deterioração do contexto em sistemas de agentes.
Como é que estas ferramentas funcionam em conjunto?
As sete ferramentas são complementares, não intercambiáveis. Utilize-as como camadas.
| Camada | Utilize estas ferramentas | Porquê |
|---|---|---|
| Remover ruído de comando | RTK | Comprimir a saída de grande volume do terminal antes de chegar ao Claude. |
| Teste a saída bruta da ferramenta | Modo de contexto | Manter registos de grande dimensão, DOMs e cargas úteis das ferramentas fora da conversa principal. |
| Mapeamento da estrutura do código | gráfico-de-revisão-de-código | Responda a questões sobre dependências e alcance de impacto sem ter de ler ficheiros às cegas. |
| Leia o código progressivamente | Token Savior | Comece com resumos de símbolos e, em seguida, expanda apenas conforme necessário. |
| Comprimir as respostas do Claude | Caveman | Evite que a própria saída do modelo se torne um excesso de contexto futuro. |
| Recuperar código relevante | claude-context | Utilizar a pesquisa semântica e híbrida de código em vez de loops repetidos de grep. |
| Reutilize decisões duradouras | memsearch | Recuperar o histórico do projeto entre sessões, agentes e mudanças de modelo. |
Uma ordem prática de implementação é:
- Elimine primeiro o ruído óbvio. Adicione o RTK ou o Modo de Contexto se a saída do shell e as cargas úteis das ferramentas dominarem o seu contexto.
- Corrija a navegação no repositório. Adicione o code-review-graph para a estrutura ou o claude-context para a recuperação semântica de código.
- Controle o que resta. Utilize o Token Savior e o Caveman para manter compactas as leituras de ficheiros e as respostas do modelo.
- Preserve o conhecimento duradouro. Utilize o memsearch quando as explicações repetidas se tornarem o gargalo.
Mantenha-se em contacto
- Junte-se à comunidade Milvus no Discord para fazer perguntas e comparar padrões de gestão de contexto com outros programadores.
- Marque uma sessão gratuita do Milvus Office Hours se precisar de ajuda a conceber uma camada de recuperação para cargas de trabalho de código, memória ou RAG.
- Se preferir evitar a configuração da infraestrutura, o Zilliz Cloud (Milvus gerido) oferece um plano gratuito para começar.
Perguntas frequentes
Como posso reduzir o uso de tokens do Claude Code sem perder contexto útil?
Comece por comprimir as entradas mais ruidosas: saída do terminal, cargas úteis brutas das ferramentas e leituras repetidas de código. Em seguida, adicione ferramentas de recuperação, como o claude-context ou o code-review-graph, para que o Claude possa extrair código relevante em vez de explorar o repositório a partir do zero.
Devo usar o claude-context ou o code-review-graph para um repositório grande?
Utilize o claude-context quando precisar de uma pesquisa semântica de código, especialmente quando não souber o nome exato do ficheiro ou do símbolo. Utilize o code-review-graph quando precisar de respostas estruturais, tais como relações de chamadas, importações, dependências de teste e o âmbito da revisão.
A recuperação de memória é diferente da recuperação de código no Claude Code?
Sim. A recuperação de código encontra ficheiros ou símbolos relevantes do projeto. A recuperação de memória recorda decisões duradouras, preferências do utilizador, histórico de depuração e lições entre sessões. O memsearch centra-se na memória; o claude-context centra-se na recuperação de código.
Estas ferramentas substituem o armazenamento em cache de prompts ou uma janela de contexto mais ampla?
Não. O armazenamento em cache de prompts e as janelas de contexto amplas ajudam em termos de capacidade e custo, mas não determinam quais as informações que merecem atenção. As ferramentas de gestão de contexto melhoram, em primeiro lugar, a qualidade e a densidade do que entra no modelo.
 cccm 11zon
Experimente o Milvus gerenciado gratuitamente
O Zilliz Cloud é descomplicado, powered by Milvus e 10x mais rápido.
Começar




Like the article? Spread the word