Claude 코드 컨텍스트 관리를 위한 최고의 오픈소스 도구 7가지
Claude Code에 1M 토큰 규모의 컨텍스트 윈도우를 제공하더라도 시간이 지날수록 답변의 질이 떨어질 수 있습니다. 문제는 단순히 컨텍스트의 크기뿐만이 아닙니다. 컨텍스트의 질도 문제입니다.
터미널 로그, 원시 도구 출력, 반복적인 파일 읽기, 장황한 응답, 잊혀진 프로젝트 이력 등이 모두 주의를 끌려고 경쟁할 때 Claude Code 세션의 성능은 저하됩니다. 장시간 실행되는 에이전트 워크플로우에서 이러한 잡음은 악순환으로 이어집니다. 모델이 맥락을 잃으면, 답변을 수정하기 위해 대화 턴을 더 추가하게 되고, 그 추가된 턴들이 또 다른 잡음을 더하는 식입니다.
이것이 바로 ‘컨텍스트 초점 상실(context defocus)’입니다. 모델은 정보를 저장할 충분한 공간을 가지고 있지만, 중요한 정보는 신호 강도가 낮은 컨텍스트 아래에 묻혀 버립니다. 컨텍스트 창이 커지면 개발자들이 프롬프트에 어떤 내용을 넣을지 신중하게 고려하지 않게 되므로, 이러한 문제를 간과하기 쉬워집니다.
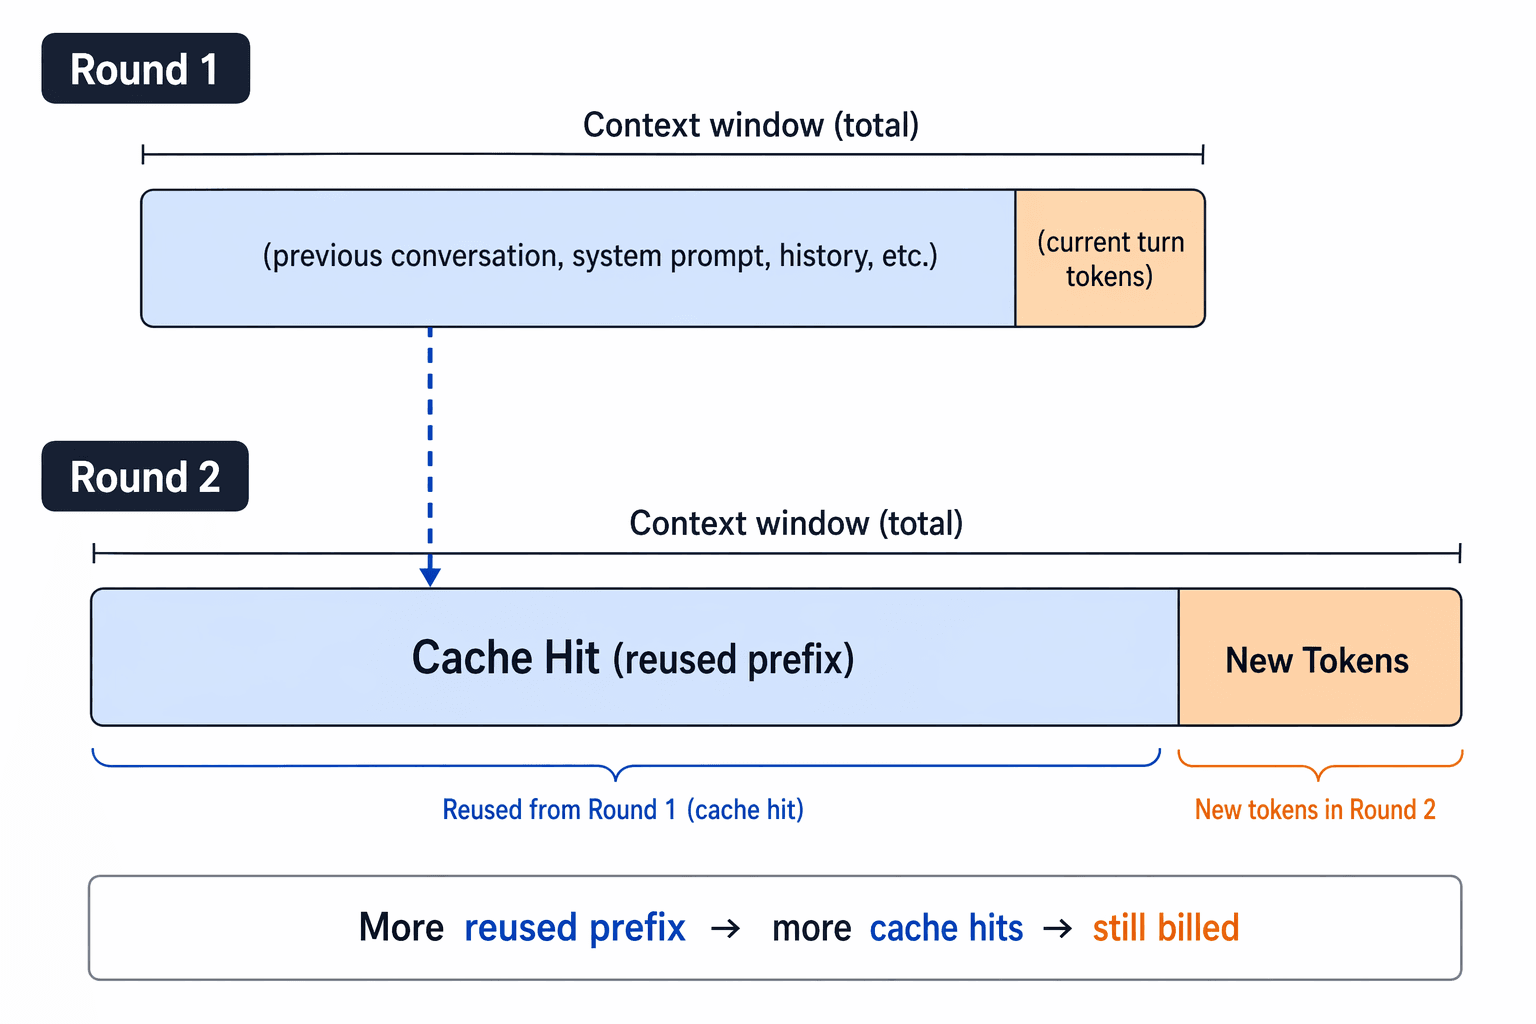 재사용된 접두사가 턴을 거치며 여전히 과금 대상 컨텍스트를 추가할 수 있음을 보여주는 프롬프트 캐싱 다이어그램
프롬프트 캐싱은 반복되는 접두사의 비용을 줄일 수 있지만, 컨텍스트 윈도우를 잡동사니 서랍으로 만들지는 않습니다. 새로운 토큰에 대해서는 여전히 비용을 지불해야 하며, 모델이 올바른 정보를 바탕으로 추론할 수 있도록 해야 합니다.
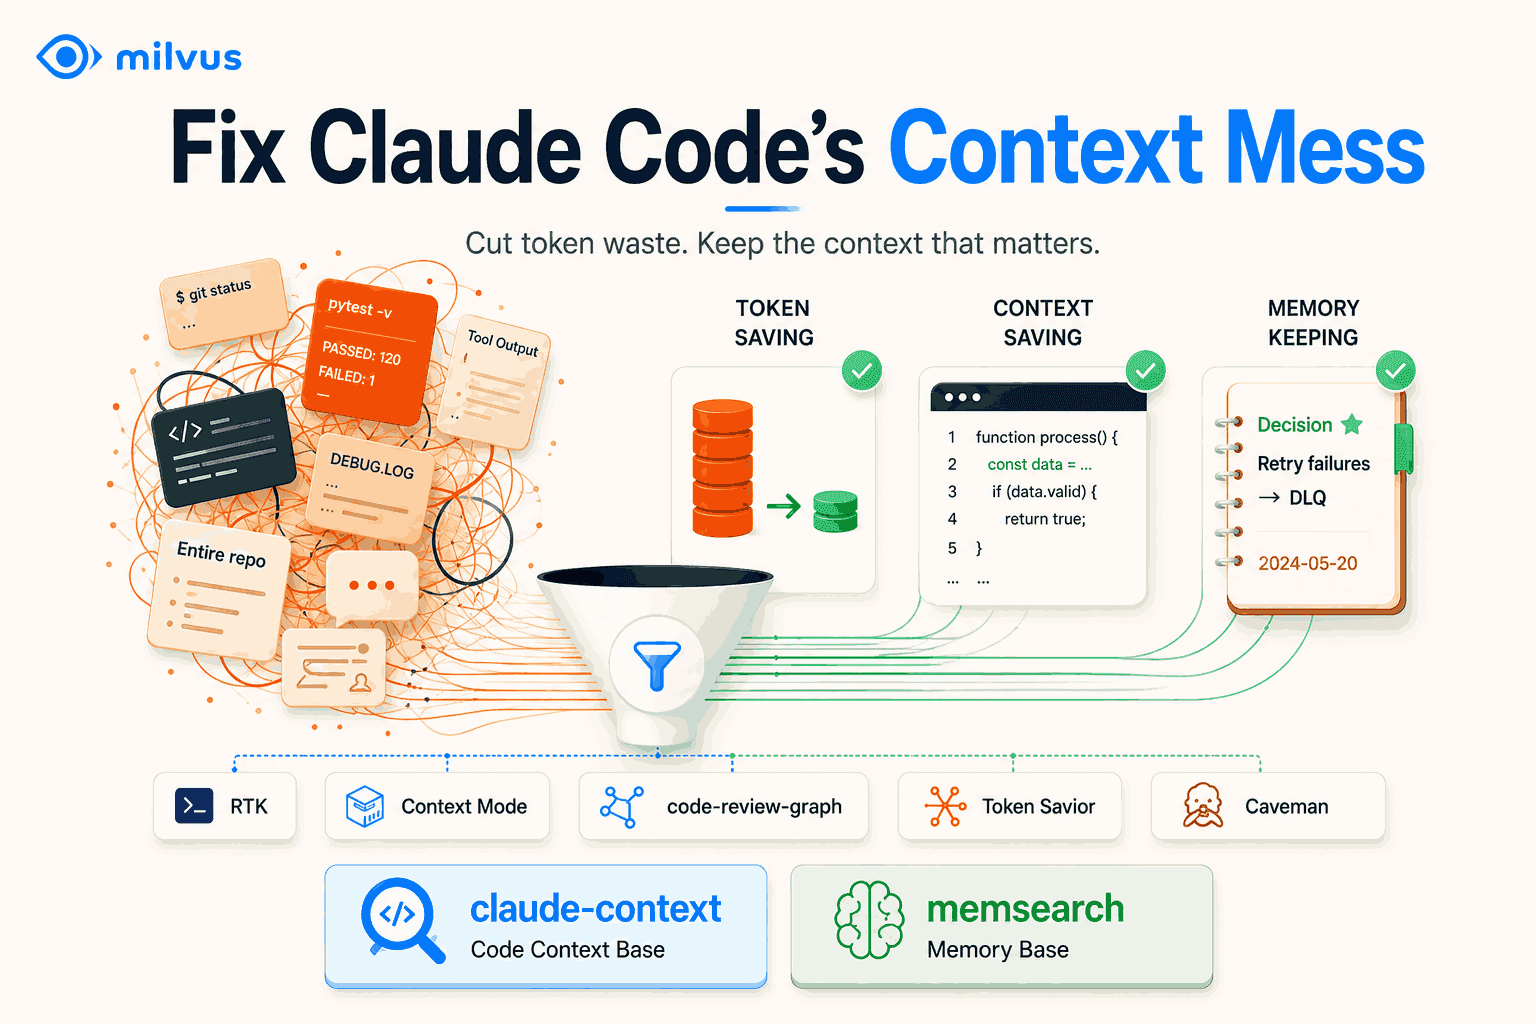
이 글에서는 터미널 출력, 도구 출력, 코드베이스 탐색, 파일 읽기, 모델 설명 수준, 의미적 코드 검색, 세션 간 메모리 등 다양한 계층에서 컨텍스트 집중력 저하 문제를 해결하는 7가지 오픈소스 도구를 살펴봅니다. 또한 이러한 아이디어가 벡터 데이터베이스 설계, 벡터 유사도 검색, Milvus와 같은 검색 시스템에 어떻게 적용되는지 설명합니다.
Claude Code의 컨텍스트 집중력 저하는 무엇으로 인해 발생하나요?
Claude Code의 문맥 상실 현상은 대개 다섯 가지 오류 모드에서 비롯됩니다: 과도한 원시 명령어 텍스트, 잡음이 많은 도구 출력, 반복적인 코드베이스 탐색, 긴 모델 응답, 세션이나 에이전트 간 메모리 공백입니다.
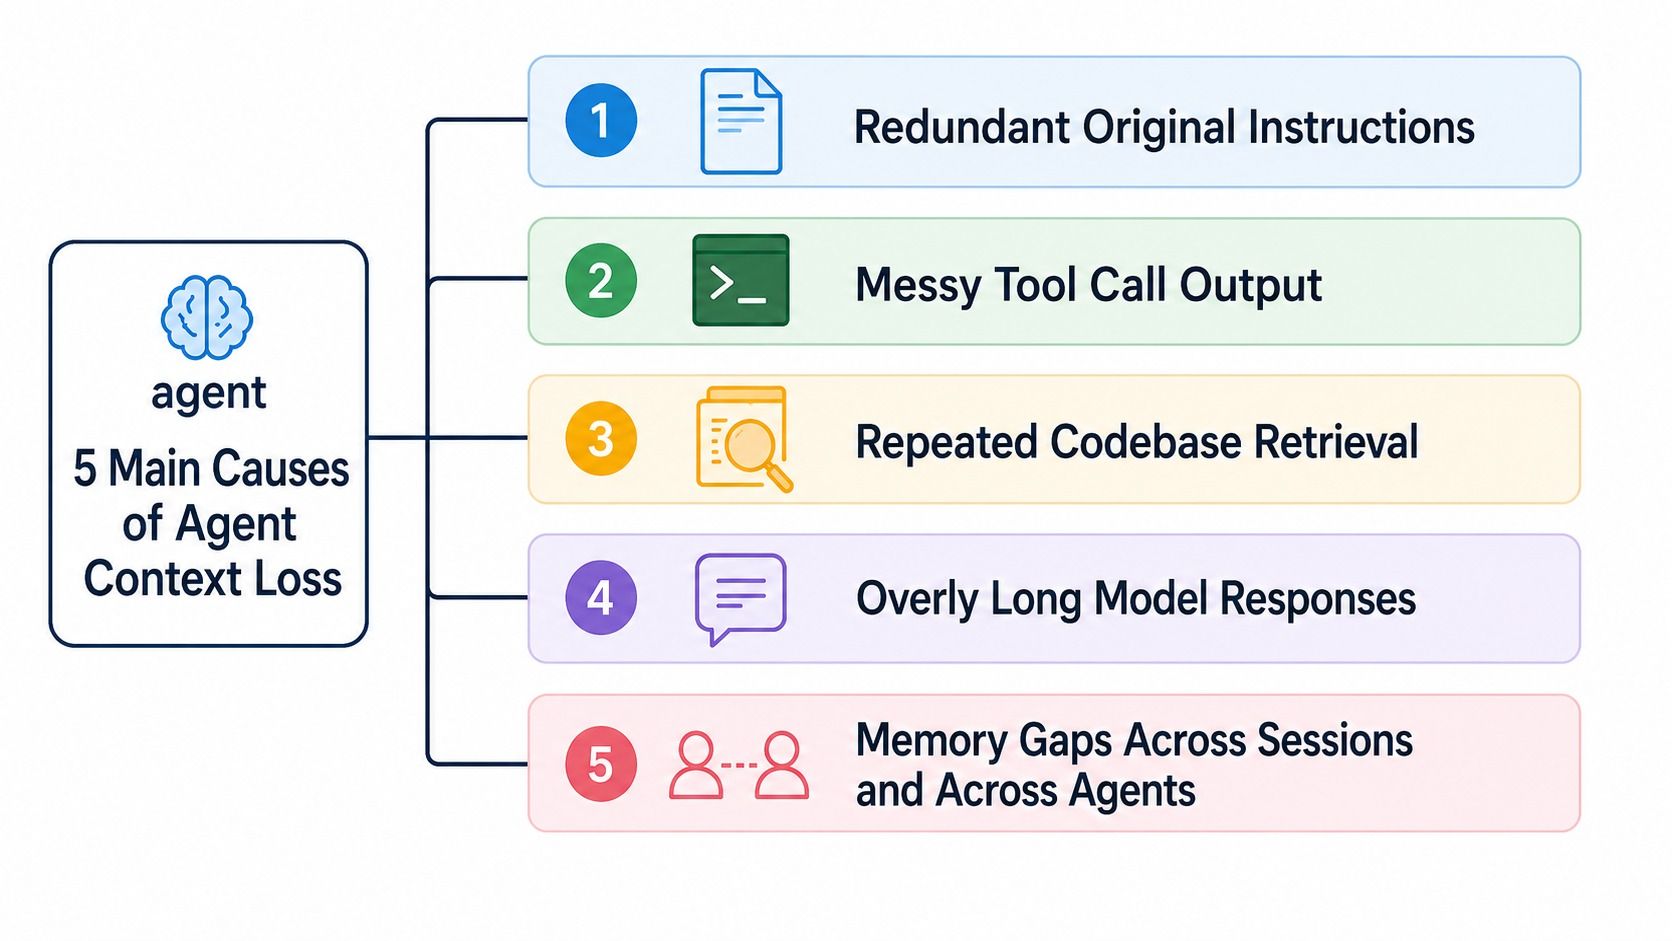 Claude Code 컨텍스트 손실의 5가지 원인: 중복된 지시문, 불규칙한 도구 출력, 반복적인 코드베이스 탐색, 긴 응답, 메모리 공백
| 컨텍스트 오류 유형 | Claude Code에서 나타나는 현상 | 도움이 되는 도구 카테고리 |
|---|---|---|
| 터미널 로그가 잡음이 많음 | git, pytest, gh 및 클라우드 CLI는 모델에 필요한 것보다 더 많은 텍스트를 출력합니다. | CLI 출력 압축 |
| 도구 출력이 창을 가득 채웁니다 | 테스트 로그, DOM 덤프, MCP 출력이 거대한 원시 블록 형태로 채팅창에 표시됩니다. | 도구 출력 샌드박싱 |
| 코드베이스 탐색이 반복됨 | Claude는 디렉터리를 나열하고, grep을 실행하며, 파일을 읽고, 매 세션마다 동일한 탐색 과정을 반복합니다. | 코드 그래프 또는 의미 기반 검색 |
| 파일 읽기 범위가 너무 넓음 | 모델은 하나의 심볼이나 요약만 필요함에도 불구하고 파일 전체를 읽습니다. | 점진적인 코드 읽기 |
| 클로드가 말을 너무 많이 한다 | 답변 자체가 향후 대화에 불필요한 맥락을 추가한다. | 응답 압축 |
| 메모리가 유지되지 않습니다 | 새로운 세션을 시작할 때마다 프로젝트 결정 사항을 다시 설명해야 한다. | 마크다운 우선 기억 |
좋은 맥락 관리 스택은 세 가지 역할을 수행해야 합니다: 불필요한 정보를 걸러내고, 필요에 따라 올바른 프로젝트 지식을 검색하며, 세션 간에 결정 사항을 지속적으로 보존하는 것입니다.
어떤 Claude Code 컨텍스트 도구를 먼저 사용해야 할까요?
워크플로우에서 가장 많은 잡음을 일으키는 계층부터 시작하세요. 터미널 출력이 문제라면 RTK부터 시작하세요. Claude가 방대한 리포지토리를 이리저리 헤매고 다닌다면 claude-context나 code-review-graph부터 시작하세요. 매일 같은 결정을 반복해서 설명해야 하는 것이 진짜 골칫거리라면 memsearch부터 시작하세요.
| 도구 | 해결하는 주요 문제 | 가장 적합한 경우 |
|---|---|---|
| RTK | 일반적인 개발자 명령어로 인해 발생하는 잡음이 많은 터미널 출력. | Claude Code 내에서 많은 CLI 명령어를 실행하는 개발자. |
| 컨텍스트 모드 | 메인 대화창으로 유입되는 방대한 양의 원시 도구 출력 결과. | Playwright, GitHub, 로그 또는 MCP 도구를 많이 사용하는 사용자. |
| code-review-graph | 대규모 저장소에서 코드베이스를 무작위로 탐색하는 경우. | 리뷰, 종속성 분석 및 영향 범위 관련 질문. |
| 토큰 세이버 | 심볼 요약만으로도 충분한데도 전체 파일을 읽는 경우. | 대용량 파일, 반복적인 심볼 조회, 증분식 코드 읽기. |
| Caveman | Claude의 장황한 응답 습관. | 간결한 출력과 더 작은 향후 컨텍스트를 원하는 사용자. |
| claude-context | 매 세션마다 코드베이스를 다시 탐색해야 하는 경우. | MCP를 통한 의미 기반 코드 검색. |
| memsearch | 세션, 에이전트, 모델 전환 시 프로젝트 기록이 소실됩니다. | 지속적인 결정과 교훈이 담긴 장기 프로젝트. |
처음 다섯 가지 도구는 컨텍스트에 입력되거나 남아 있는 내용을 줄여줍니다. 마지막 두 가지는 유용한 컨텍스트를 더 쉽게 떠올릴 수 있게 해줍니다.
RTK는 Claude가 명령어 출력을 확인하기 전에 원시 출력을 압축합니다.
RTK는 일반적인 개발자 명령어의 토큰 사용량을 줄여주는 CLI 프록시입니다. GitHub 설명에 따르면, 일반적인 개발자 명령어에서 LLM 토큰 소비량을 60~90% 줄여주며, 단일 Rust 바이너리 형태로 제공됩니다.
일상적인 Claude Code 사용 시, ` git status`, ` pytest`, 디렉터리 목록 표시와 같은 명령어는 종종 전체 환경 정보와 상태 설명을 컨텍스트 창에 쏟아냅니다. 모델은 대개 ‘어떤 파일이 변경되었는지’, ‘어떤 테스트가 실패했는지’, ‘PR이 어디에서 막혔는지’, 또는 ‘디렉터리에 어떤 주요 파일이 존재하는지’와 같은 간결한 답변만 필요로 합니다.
RTK는 셸과 Claude 사이에 위치합니다. RTK는 Claude Code 후크를 통해 명령어를 재작성하고 압축된 출력을 반환할 수 있습니다.
git status 의 원본 출력:
On branch feat/payment-retry
Your branch is up to date with 'origin/feat/payment-retry'.
Changes not staged for commit:
modified:   src/webhook/handler.ts
modified:   src/queue/dlq.ts
modified:   tests/webhook.test.ts
Untracked files:
docs/notes.md
no changes added to commit
실제로 중요한 내용:
3 modified, 1 untracked
- src/webhook/handler.ts
- src/queue/dlq.ts
- tests/webhook.test.ts
pytest 도 마찬가지입니다. 원본 출력에는 통과된 사례와 불필요한 환경 정보가 가득합니다:
============================= test session starts =============================
platform darwin -- Python 3.12.4, pytest-8.4.1
collected 128 items
tests/test_auth.py …
tests/test_webhook.py …F…
tests/test_queue.py …
================================== FAILURES ==================================
________________ test_retry_to_dlq __________________
E   AssertionError: expected status code 202, got 500
압축된 형태에서는 신호가 즉시 파악됩니다:
128 tests collected, 1 failed
FAIL tests/test_webhook.py::test_retry_to_dlq
AssertionError: expected status code 202, got 500
코드 검색이 아닌 쉘 명령어로 인해 컨텍스트가 부풀어 오를 때, RTK는 가장 쉬운 시작점입니다.
컨텍스트 모드는 메인 채팅 창 밖에서 방대한 도구 출력 결과를 샌드박스로 처리합니다.
컨텍스트 모드는 테스트 로그, 브라우저 DOM 스냅샷, GitHub 페이로드, MCP 도구 출력, 스크랩된 페이지 등 도구가 반환하는 원시 블록을 처리하도록 설계되었습니다. GitHub 설명에는 AI 코딩 에이전트를 위한 컨텍스트 창 최적화가 강조되어 있으며, 도구 출력이 98% 감소했다고 보고하고 있습니다.
 샌드박스 처리된 도구 출력물과 컨텍스트 최적화 위치를 보여주는 컨텍스트 모드 GitHub 저장소 카드
이 모드의 접근 방식은 대용량 도구 출력을 로컬 샌드박스와 인덱스에 격리한 후, 요약본과 검색 핸들만 Claude 대화로 전달하는 것입니다.
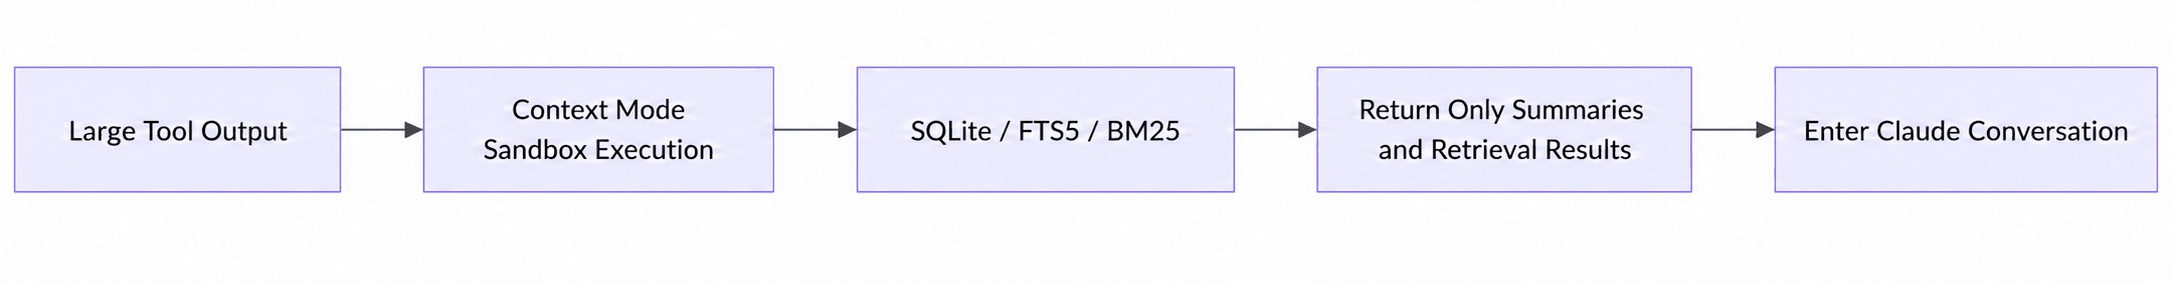 대용량 도구 출력이 샌드박스 실행, SQLite 또는 FTS 인덱스, 요약, 검색 결과를 거쳐 이동하는 과정을 보여주는 컨텍스트 모드 흐름도
이 흐름은 코딩 에이전트가 전체 DOM이나 통과한 모든 테스트 라인이 아니라, 실패한 노드, 오류가 발생한 선택기, 또는 관련 스택 트레이스를 필요로 하는 경우가 많기 때문에 유용합니다. Context Mode는 전체 출력을 로컬에 보관해 두면서도, 이것이 메인 대화를 지배하는 것을 방지합니다.
이는 실제 운영 중인 하이브리드 검색 시스템이 저장과 검색을 분리하는 방식과 유사합니다. 원시 데이터를 내구성이 있는 곳에 보관한 다음, 중요한 부분만 검색해 오는 방식입니다.
code-review-graph는 Claude가 코드 구조를 탐색하기 전에 해당 구조를 매핑합니다
code-review-graph는 다른 문제를 해결합니다. Claude에게는 항상 더 많은 텍스트가 필요한 것이 아니라, 더 나은 지도가 필요합니다.
 원본 기사에서 사용된 code-review-graph 로고 이미지
대규모 리포지토리에서는 간단한 질문 하나만으로도 비용이 많이 드는 탐색이 유발될 수 있습니다:
이 로그인 로직을 변경한 후, 어떤 파일과 테스트에 영향을 미치나요?
코드 그래프가 없다면, Claude의 일반적인 처리 방식은 다음과 같습니다:
read auth.ts
grep login
read middleware
read tests
keep guessing
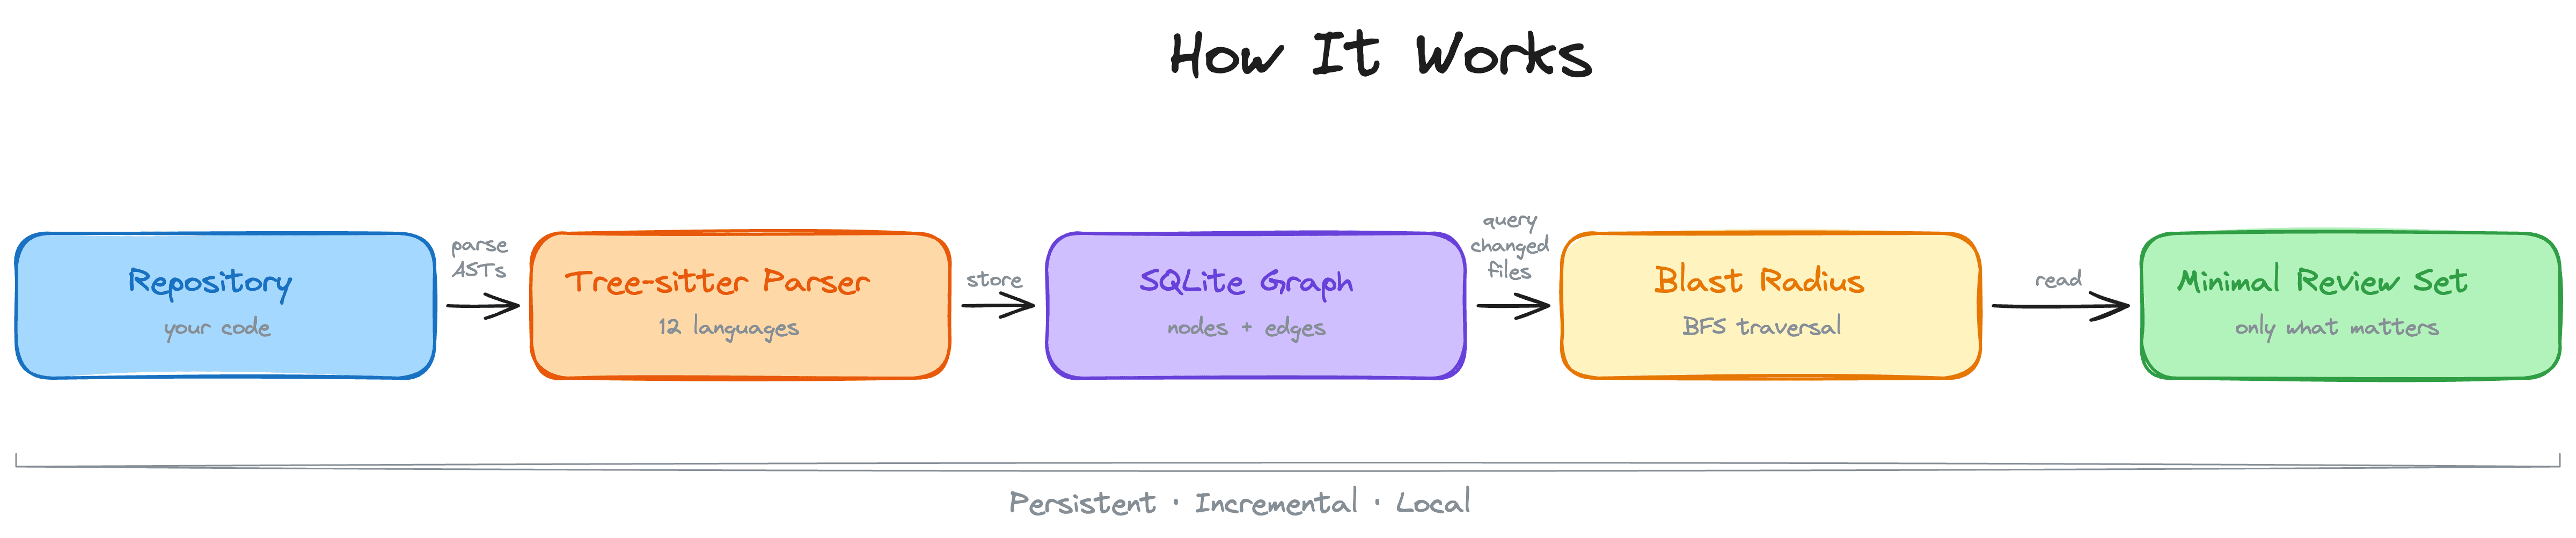
code-review-graph는 코드베이스의 구조적 맵을 미리 구축합니다. Tree-sitter를 사용하여 함수, 클래스, 임포트, 호출 관계, 상속 및 테스트 종속성을 분석한 다음, 이 그래프를 SQLite에 저장합니다.
이를 통해 코드 리뷰 및 영향 범위 분석에 유용하게 활용됩니다. Claude에게 반복적인 읽기를 통해 의존성 그래프를 다시 찾아내도록 요청하는 대신, 먼저 구조를 쿼리하도록 할 수 있습니다.
이는 시맨틱 검색과 유사하지만 동일하지는 않습니다. 구조 그래프는 “무엇이 무엇에 의존하는가?”라는 질문에 답하는 반면, 시맨틱 검색은 “이 질문과 개념적으로 관련된 코드는 무엇인가?”라는 질문에 답합니다. 실제 코드 어시스턴트 워크플로우에서는 두 가지 모두를 필요로 하는 경우가 많습니다.
Token Savior는 전체 파일을 보내기 전에 Claude에 심볼 요약 정보를 제공합니다
Token Savior의 핵심 아이디어는 간단합니다. 기본적으로 전체 파일을 전송하지 않는 것입니다. 먼저 인덱스나 심볼 요약 정보를 전송한 다음, 작업에 더 자세한 정보가 필요할 때만 확장합니다.
 Token Savior의 GitHub 리포지토리 카드에는 MCP 서버 설명과 프로젝트 통계가 표시되어 있습니다
결제 웹훅이 어디에서 처리되는지 묻는 경우, 모델은 대개 관련 파일의 모든 줄을 필요로 하지 않습니다. 먼저 해당 파일이나 심볼이 관련이 있는지 여부를 파악해야 합니다.
Token Savior는 코드를 계층별로 제공합니다:
| 계층 | Claude가 수신하는 내용 | 확장 시 |
|---|---|---|
| 요약 | 인덱스, 심볼 이름 및 간단한 설명. | 기본 첫 번째 응답. |
| 코드 조각 | 관련 심볼을 중심으로 한 작은 코드 섹션. | 요약이 관련성이 있을 것으로 예상되는 경우. |
| 전체 파일 | 파일 전체 내용. | 편집이나 심층적인 추론이 필요한 경우에만 표시됩니다. |
이는 개발자가 실제로 코드를 읽는 방식을 반영합니다. 개발자는 코드를 훑어보고 관련성을 확인한 뒤, 필요한 경우에만 전체 파일을 엽니다. 또한 이는 RAG 애플리케이션에서 사용되는 점진적 검색 패턴과도 유사합니다. 즉, 전체적인 맥락을 파악할 수 있을 만큼 폭넓게 검색한 다음, 생성 전에 컨텍스트를 좁혀 나가는 방식입니다.
Caveman은 Claude의 응답 부피를 줄여줍니다
대부분의 컨텍스트 도구는 모델에 입력되는 내용에 초점을 맞춥니다. Caveman은 Claude가 출력하는 내용을 대상으로 합니다.
Caveman은 Claude Code 스킬/플러그인으로, 불필요한 내용, 예의상 표현, 포장 문장, 과도한 설명, 반복적인 구조를 제거합니다. 목표는 지식을 제거하는 것이 아니라 답변의 밀도를 높이는 것입니다.
Caveman 미사용 시:
React 컴포넌트가 다시 렌더링되는 이유는 아마도…
Caveman 사용 시:
렌더링할 때마다 새로운 객체 참조가 생성됩니다. 인라인 객체 prop = 새로운 참조 = 재렌더링. useMemo로 감싸세요.
이 점이 중요한 이유는 Claude의 답변 자체가 향후 컨텍스트가 되기 때문입니다. 모든 답변에 긴 설명이 포함된다면, 다음 대화는 필요 이상으로 많은 텍스트로 시작하게 됩니다. 답변을 짧게 작성하면 현재 대화의 질을 높일 뿐만 아니라 다음 대화의 질도 향상시킬 수 있습니다.
AI 에이전트를 위한 컨텍스트 엔지니어링을 고려 중인 팀들에게, Caveman은 출력 정책이 컨텍스트 정책의 일부임을 상기시켜 줍니다.
claude-context는 MCP를 통해 의미론적 코드 검색 기능을 추가합니다
claude-context는 의미 기반 검색을 통해 코드베이스 탐색의 중복 문제를 해결합니다. 이 도구는 리포지토리를 색인화하고, 코드 청크를 벡터 데이터베이스에 저장하며, Model Context Protocol을 통해 검색 기능을 제공합니다.
 원본 기사에서 GitHub 트렌딩에 소개된 Claude Context 저장소
대규모 코드베이스에서는 다음과 같은 질문을 Claude에게 끊임없이 던지게 됩니다:
이 버그와 관련이 있을 만한 코드 부분을 찾아주세요.
검색 레이어가 없다면, Claude의 기본 접근 방식은 대개 다음과 같습니다:
list the directory
grep around
read a bunch of files
keep guessing
claude-context는 이러한 작업을 검색 레이어로 이전합니다. 이 도구는 리포지토리를 청크로 분할하고, 임베딩을 생성하여 Milvus 기반 코드 인덱스에 저장한 뒤, 모델이 무작정 파일을 읽기 시작하기 전에 관련 코드 청크를 검색해 냅니다.
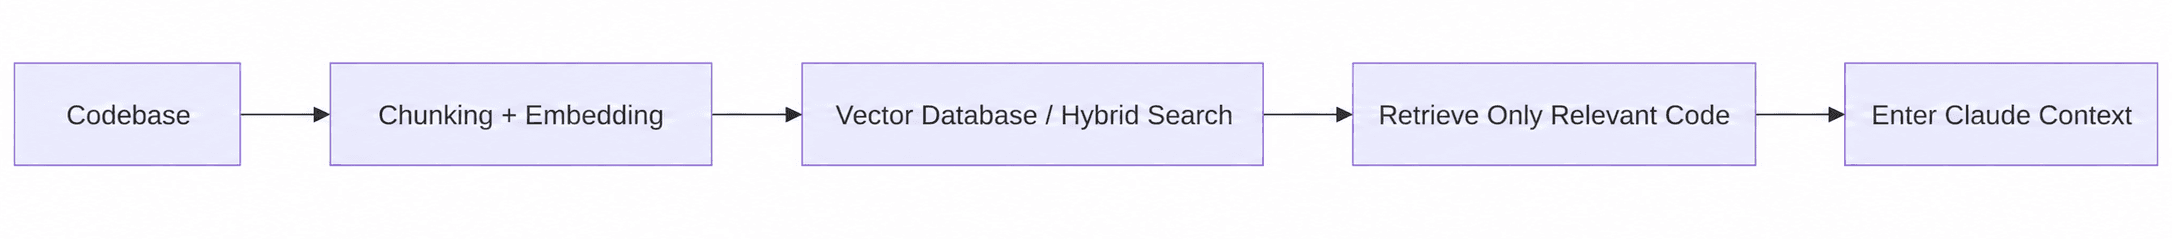 코드베이스 청크화, 임베딩, 벡터 데이터베이스 및 하이브리드 검색, 관련 코드 검색, Claude 컨텍스트 주입을 보여주는 claude-context 흐름도
바로 이 지점에서 AI 코딩 도구는 검색 시스템과 유사한 모습을 띠기 시작합니다. 청크화, 임베딩, 메타데이터, 어휘 매칭, 순위 지정, 최신성 확보가 필요합니다. 이는 실제 운영 환경의 RAG 검색, 하이브리드 검색 라우팅, 임베딩 모델 선택의 기반이 되는 구성 요소와 동일합니다.
memsearch는 세션과 에이전트 간에 유용한 정보를 기억합니다
memsearch는 문제의 반대편, 즉 무엇을 잊어야 할지가 아니라 중요한 정보를 어떻게 다시 불러올지에 초점을 맞춥니다.
 원본 기사에서 가져온 memsearch 로고 이미지
월요일에 Claude에게 다음과 같이 지시한다고 상상해 보세요:
“우리 웹훅은 실패 시 재시도할 수 없습니다. 실패한 이벤트는 데드 레터 큐로 보내야 합니다.”
수요일, 새로운 세션을 열고 다음과 같이 묻습니다:
웹훅 계층에서 또 무엇을 최적화할 수 있을까요?
지속적인 메모리가 없다면, 클로드는 월요일에 내린 결정을 마치 없었던 일처럼 취급합니다. 그래서 다시 설명해 줍니다.
memsearch는 메모리를 사람이 읽을 수 있는 로컬 마크다운 파일로 저장하고, Milvus를 재구축 가능한 검색 인덱스로 사용합니다. 이러한 설계 덕분에 사람이 메모리를 편집할 수 있으면서도 에이전트가 검색할 수 있게 됩니다.
검색 시, memsearch는 점진적 리콜 방식을 사용합니다. 먼저 검색하고, 필요한 경우 내용을 확장한 다음, 꼭 필요한 경우에만 원본 대화록으로 드릴다운합니다.
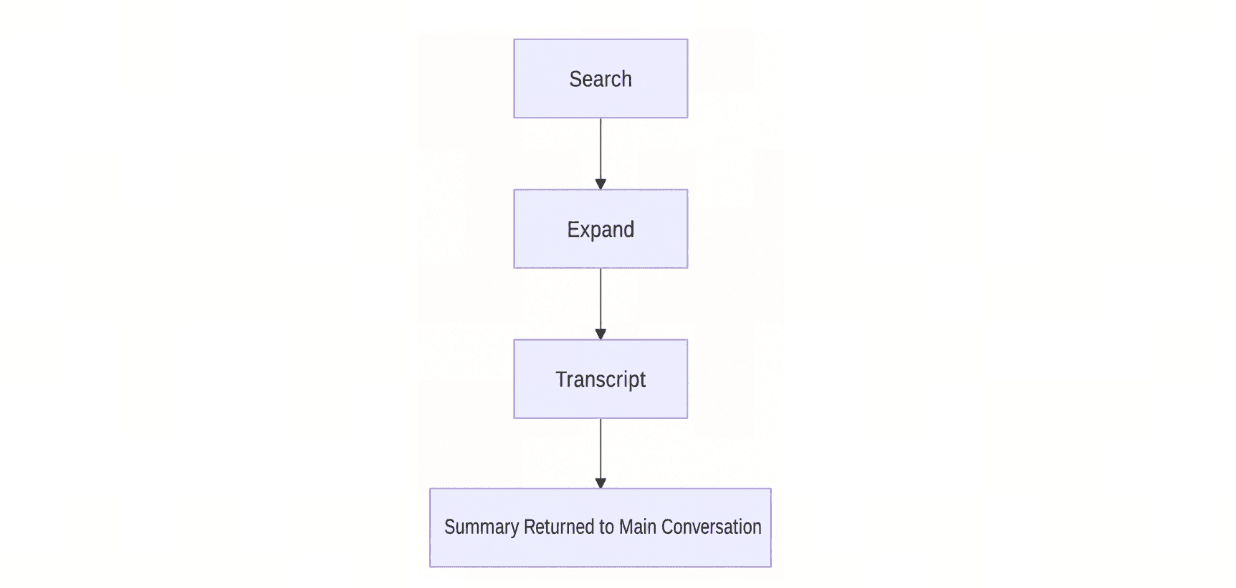 검색, 확장, 대화록, 요약된 내용을 메인 대화로 되돌리는 과정을 보여주는 memsearch 점진적 검색 흐름
이러한 ‘마크다운 우선’ 패턴은 세션, 모델, 에이전트를 넘나들며 작업하는 팀에 유용합니다. 또한 장기 AI 에이전트 메모리, 공유된 다중 에이전트 메모리, 그리고 에이전트 시스템에서 발생하는 컨텍스트 부패(context rot)를 방지하는 더 광범위한 문제와도 자연스럽게 연계됩니다.
이러한 도구들은 어떻게 함께 작동할까요?
이 일곱 가지 도구는 상호 보완적이며, 서로 대체할 수 있는 것이 아닙니다. 이를 계층 구조로 활용하십시오.
| 계층 | 다음 도구 사용 | 이유 |
|---|---|---|
| 명령 노이즈 제거 | RTK | 대용량 터미널 출력이 Claude에 도달하기 전에 압축합니다. |
| 샌드박스에서 원시 도구 출력 | 컨텍스트 모드 | 대용량 로그, DOM 및 도구 페이로드를 메인 대화 외부에 보관합니다. |
| 코드 구조 매핑 | 코드-리뷰-그래프 | 파일을 무작정 읽지 않고도 의존성 및 파급 범위 관련 질문에 답변할 수 있습니다. |
| 코드를 단계적으로 읽으세요 | 토큰 세이버 | 심볼 요약부터 시작하여, 필요한 경우에만 확장합니다. |
| Claude의 답변 압축 | Caveman | 모델 자체의 출력이 향후 컨텍스트를 불필요하게 부풀리는 것을 방지하세요. |
| 관련 코드 검색 | claude-context | 반복적인 grep 루프 대신 의미론적 및 하이브리드 코드 검색을 사용하십시오. |
| 지속 가능한 결정 재사용 | memsearch | 세션, 에이전트 및 모델 전환을 넘나들며 프로젝트 이력을 불러오세요. |
실용적인 적용 순서는 다음과 같습니다:
- 먼저 명백한 노이즈를 제거하세요. 셸 출력 및 도구 페이로드가 컨텍스트를 지배하는 경우 RTK 또는 컨텍스트 모드를 추가하세요.
- 리포지토리 탐색 기능을 개선하세요. 구조 분석을 위해 code-review-graph를, 의미 기반 코드 검색을 위해 claude-context를 추가하세요.
- 남아 있는 내용을 제어하세요. Token Savior와 Caveman을 사용하여 파일 읽기 및 모델 응답을 간결하게 유지하세요.
- 지속적인 지식을 보존하세요. 반복적인 설명이 병목 현상이 될 때는 memsearch를 사용하세요.
소통하기
- Milvus Discord 커뮤니티에 가입하여 질문을 하고 다른 개발자들과 컨텍스트 관리 패턴을 공유해 보세요.
- 코드, 메모리 또는 RAG 워크로드를 위한 검색 계층 설계에 도움이 필요하시면무료 Milvus Office Hours 세션을 예약하세요.
- 인프라 설정을 건너뛰고 싶다면, Zilliz Cloud (관리형 Milvus)에서 제공하는 무료 티어를 통해 시작해 보세요.
자주 묻는 질문
유용한 컨텍스트를 잃지 않으면서 Claude Code 토큰 사용량을 줄이려면 어떻게 해야 하나요?
터미널 출력, 원시 도구 페이로드, 반복되는 코드 읽기 등 노이즈가 가장 심한 입력부터 압축하는 것부터 시작하세요. 그런 다음 claude-context나 code-review-graph와 같은 검색 도구를 추가하여, Claude가 리포지토리를 처음부터 탐색하는 대신 관련 코드를 가져올 수 있도록 하세요.
대규모 저장소의 경우 claude-context와 code-review-graph 중 무엇을 사용해야 하나요?
의미론적 코드 검색이 필요한 경우, 특히 정확한 파일명이나 심볼명을 모르는 경우에는 claude-context를 사용하세요. 호출 관계, 임포트, 테스트 의존성, 리뷰 영향 범위와 같은 구조적인 답변이 필요한 경우에는 code-review-graph를 사용하세요.
Claude Code에서 메모리 검색은 코드 검색과 다른가요?
네. 코드 검색은 관련 프로젝트 파일이나 심볼을 찾아냅니다. 메모리 검색은 지속적 결정, 사용자 기본 설정, 디버깅 기록, 세션 간 학습 내용을 불러옵니다. memsearch는 메모리에 중점을 두고, claude-context는 코드 검색에 중점을 둡니다.
이 도구들이 프롬프트 캐싱이나 더 큰 컨텍스트 윈도우를 대체하나요?
아니요. 프롬프트 캐싱과 넓은 컨텍스트 창은 용량과 비용 관리에 도움이 되지만, 어떤 정보에 주목해야 할지는 결정하지 않습니다. 컨텍스트 관리 도구는 애초에 모델로 입력되는 정보의 품질과 밀도를 향상시킵니다.
 cccm 11zon
Like the article? Spread the word