Apa Sebenarnya Database Vektor dan Bagaimana Cara Kerjanya
Basis data vektor mengindeks dan menyimpan embedding vektor untuk pengambilan cepat dan pencarian kemiripan, dengan kemampuan seperti operasi CRUD, pemfilteran metadata, dan penskalaan horizontal yang dirancang khusus untuk aplikasi AI.
Pendahuluan: Kebangkitan Basis Data Vektor di Era AI
Pada masa-masa awal ImageNet, dibutuhkan 25.000 kurator manusia untuk melabeli dataset secara manual. Angka yang mengejutkan ini menyoroti tantangan mendasar dalam AI: mengkategorikan data tak terstruktur secara manual tidak akan pernah bisa diskalakan. Dengan miliaran gambar, video, dokumen, dan file audio yang dihasilkan setiap hari, diperlukan perubahan paradigma dalam cara komputer memahami dan berinteraksi dengan konten.
Sistem basis data relasional tradisional unggul dalam mengelola data terstruktur dengan format yang telah ditentukan dan menjalankan operasi pencarian presisi. Sebaliknya, basis data vektor mengkhususkan diri dalam menyimpan dan mengambil jenis data tak terstruktur, seperti gambar, audio, video, dan konten tekstual, melalui representasi numerik berdimensi tinggi yang dikenal sebagai embedding vektor. Basis data vektor mendukung model bahasa besar dengan menyediakan pengambilan dan pengelolaan data yang efisien. Basis data vektor modern mengungguli sistem tradisional 2-10x melalui optimasi yang sadar perangkat keras (AVX512, SIMD, GPU, NVMe SSD), algoritma pencarian yang sangat dioptimalkan (HNSW, IVF, DiskANN), dan desain penyimpanan berorientasi kolom. Arsitektur cloud-native yang terpisah memungkinkan penskalaan independen pada komponen pencarian, penyisipan data, dan pengindeksan, memungkinkan sistem menangani miliaran vektor sambil mempertahankan kinerja untuk aplikasi AI perusahaan di perusahaan seperti Salesforce, PayPal, eBay, dan NVIDIA.
Ini mewakili apa yang para ahli sebut sebagai "kesenjangan semantik"—basis data tradisional beroperasi pada kecocokan persis dan hubungan yang telah ditentukan, sementara pemahaman manusia tentang konten bersifat bernuansa, kontekstual, dan multidimensi. Kesenjangan ini menjadi semakin bermasalah karena aplikasi AI menuntut:
Menemukan kemiripan konseptual daripada kecocokan persis
Memahami hubungan kontekstual antara berbagai bagian konten
Menangkap esensi semantik informasi di luar kata kunci
Memproses data multimodal dalam kerangka kerja terpadu
Basis data vektor telah muncul sebagai teknologi penting untuk menjembatani kesenjangan ini, menjadi komponen esensial dalam infrastruktur AI modern. Mereka meningkatkan kinerja model pembelajaran mesin dengan memfasilitasi tugas-tugas seperti clustering dan klasifikasi.
Memahami Embedding Vektor: Fondasi
Embedding vektor berfungsi sebagai jembatan penting melintasi kesenjangan semantik. Representasi numerik berdimensi tinggi ini menangkap esensi semantik data tak terstruktur dalam bentuk yang dapat diproses secara efisien oleh komputer. Model embedding modern mengubah konten mentah—baik teks, gambar, atau audio—menjadi vektor padat di mana konsep serupa mengelompok bersama dalam ruang vektor, terlepas dari perbedaan permukaan.
Misalnya, embedding yang dibangun dengan benar akan menempatkan konsep seperti "mobil", "oto", dan "kendaraan" berdekatan dalam ruang vektor, meskipun memiliki bentuk leksikal yang berbeda. Properti ini memungkinkan pencarian semantik, sistem rekomendasi, dan aplikasi AI untuk memahami konten di luar pencocokan pola sederhana.
Kekuatan embedding meluas melintasi modalitas. Basis data vektor canggih mendukung berbagai jenis data tak terstruktur—teks, gambar, audio—dalam sistem terpadu, memungkinkan pencarian dan hubungan lintas-modal yang sebelumnya mustahil untuk dimodelkan secara efisien. Kemampuan basis data vektor ini sangat penting untuk teknologi berbasis AI seperti chatbot dan sistem pengenalan gambar, mendukung aplikasi canggih seperti pencarian semantik dan sistem rekomendasi.
Namun, menyimpan, mengindeks, dan mengambil embedding dalam skala besar menghadirkan tantangan komputasi unik yang tidak dirancang untuk diatasi oleh basis data tradisional.
Basis Data Vektor: Konsep Inti
Basis data vektor mewakili pergeseran paradigma dalam cara kita menyimpan dan menanyakan data tak terstruktur. Berbeda dengan sistem basis data relasional tradisional yang unggul dalam mengelola data terstruktur dengan format yang telah ditentukan, basis data vektor mengkhususkan diri dalam menangani data tak terstruktur melalui representasi vektor numerik.
Pada intinya, basis data vektor dirancang untuk memecahkan masalah mendasar: memungkinkan pencarian kemiripan yang efisien di seluruh kumpulan data besar yang tak terstruktur. Mereka mencapai ini melalui tiga komponen kunci:
Embedding Vektor: Representasi numerik berdimensi tinggi yang menangkap makna semantik dari data tak terstruktur (teks, gambar, audio, dll.)
Pengindeksan Khusus: Algoritma yang dioptimalkan untuk ruang vektor berdimensi tinggi yang memungkinkan pencarian perkiraan yang cepat. Basis data vektor mengindeks vektor untuk meningkatkan kecepatan dan efisiensi pencarian kemiripan, menggunakan berbagai algoritma ML untuk membuat indeks pada embedding vektor.
Metrik Jarak: Fungsi matematika yang mengukur kemiripan antara vektor
Operasi utama dalam basis data vektor adalah kueri k-tetangga terdekat (KNN), yang menemukan k vektor yang paling mirip dengan vektor kueri tertentu. Untuk aplikasi skala besar, basis data ini biasanya mengimplementasikan algoritma tetangga terdekat perkiraan (ANN), menukar sejumlah kecil akurasi dengan peningkatan signifikan dalam kecepatan pencarian.
Fondasi Matematis Kemiripan Vektor
Memahami basis data vektor memerlukan pemahaman prinsip-prinsip matematis di balik kemiripan vektor. Berikut adalah konsep-konsep dasarnya:
Ruang Vektor dan Embedding
Sebuah embedding vektor adalah larik bilangan floating-point dengan panjang tetap (dapat berkisar dari 100-32.768 dimensi!) yang mewakili data tak terstruktur dalam format numerik. Embedding ini menempatkan item serupa lebih dekat bersama dalam ruang vektor berdimensi tinggi.
Misalnya, kata "raja" dan "ratu" akan memiliki representasi vektor yang lebih dekat satu sama lain daripada keduanya dengan "mobil" dalam ruang embedding kata yang dilatih dengan baik.
Metrik Jarak
Pilihan metrik jarak secara fundamental mempengaruhi bagaimana kemiripan dihitung. Metrik jarak umum meliputi:
Jarak Euclidean: Jarak garis lurus antara dua titik dalam ruang Euclidean.
Kemiripan Kosinus: Mengukur kosinus sudut antara dua vektor, berfokus pada orientasi daripada magnitudo
Produk Titik: Untuk vektor yang dinormalisasi, mewakili seberapa sejajar dua vektor.
Jarak Manhattan (Norma L1): Jumlah perbedaan absolut antara koordinat.
Kasus penggunaan yang berbeda mungkin memerlukan metrik jarak yang berbeda. Misalnya, kemiripan kosinus sering bekerja dengan baik untuk embedding teks, sementara jarak Euclidean mungkin lebih cocok untuk jenis embedding gambar tertentu.
Kemiripan semantik antara vektor dalam ruang vektor
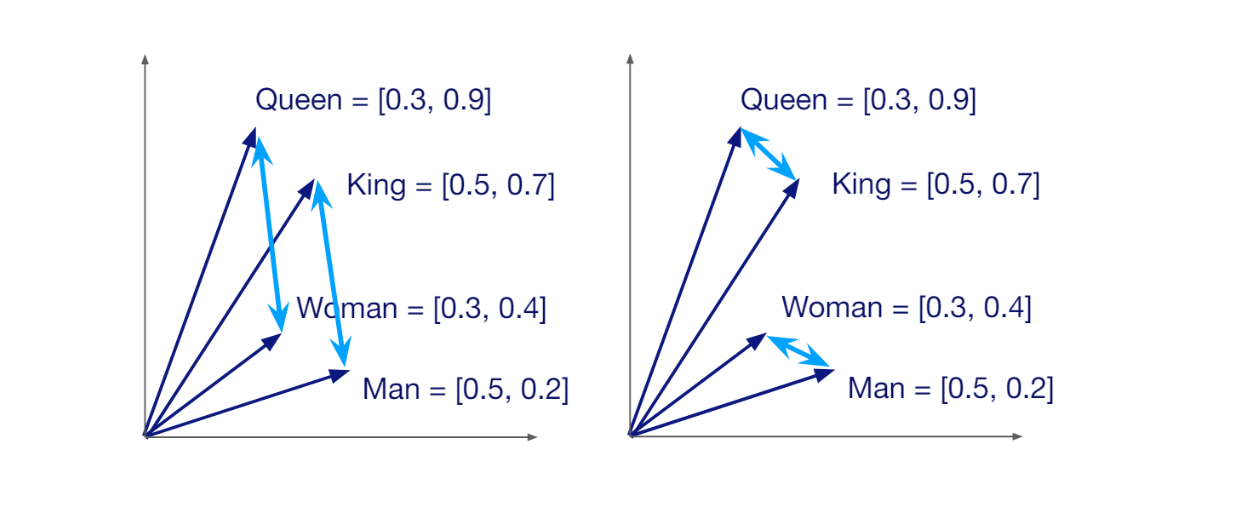 Kemiripan semantik antara vektor dalam ruang vektor
Memahami fondasi matematis ini mengarah pada pertanyaan penting tentang implementasi: Jadi, cukup tambahkan indeks vektor ke basis data apa pun, kan?
Hanya menambahkan indeks vektor ke basis data relasional tidaklah cukup, juga tidak menggunakan pustaka indeks vektor yang berdiri sendiri. Meskipun indeks vektor menyediakan kemampuan penting untuk menemukan vektor serupa secara efisien, mereka tidak memiliki infrastruktur yang diperlukan untuk aplikasi produksi:
Mereka tidak menyediakan operasi CRUD untuk mengelola data vektor
Mereka tidak memiliki penyimpanan metadata dan kemampuan pemfilteran
Mereka tidak menawarkan penskalaan, replikasi, atau toleransi kesalahan bawaan
Mereka memerlukan infrastruktur khusus untuk persistensi dan pengelolaan data
Basis data vektor muncul untuk mengatasi keterbatasan
Try Managed Milvus for Free
Zilliz Cloud is hassle-free, powered by Milvus and 10x faster.
Get Started


Like the article? Spread the word