

準備來源資料
本頁說明在開始將資料批量插入您的集合之前,您應考慮的事項。
開始之前
目標集合需要將來源資料映射至其資料結構。下圖顯示了符合要求的來源資料如何映射至目標集合的資料結構。
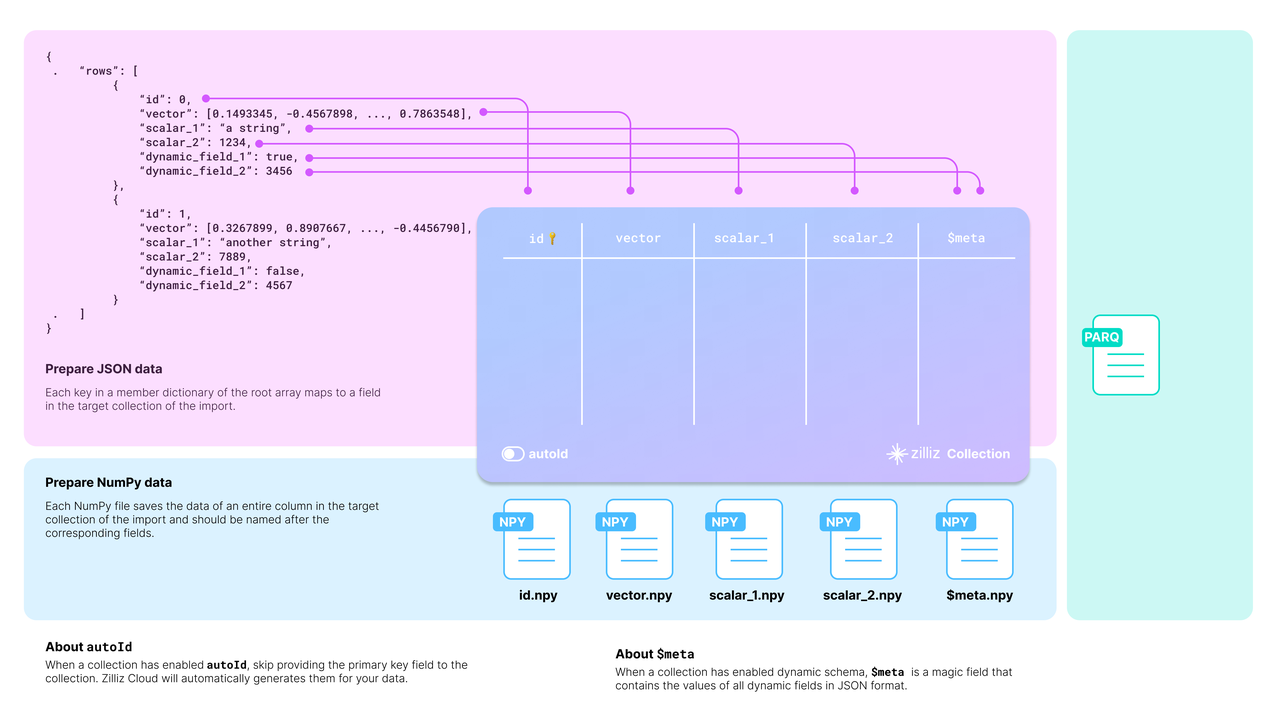 將資料映射至資料結構
您應仔細檢視您的資料,並據此設計目標集合的資料結構。
以上圖中的 JSON 資料為例,行清單中有兩個實體,每行包含六個欄位。集合模式有選擇性地包含其中四個:id、vector、scalar_1 以及scalar_2。
設計資料結構時,還有兩點需要考慮:
是否啟用 AutoID
id欄位是集合的主要欄位。若要讓主要欄位自動遞增,您可以在資料結構中啟用AutoID。在此情況下,您應將來源資料中各行的id欄位排除在外。
是否啟用動態欄位
若模式啟用動態欄位,目標集合亦可儲存未包含於其預定義模式中的欄位。$meta欄位是一個預留的 JSON 欄位,用於以鍵值對的形式儲存動態欄位及其值。在上圖中,欄位dynamic_field_1和dynamic_field_2及其值將以鍵值對的形式儲存於$meta欄位中。
以下程式碼示範如何為上圖所示的集合設定資料結構。
如需更多資訊,請參閱 create_schema() 以及 add_field() SDK 參考文件。
如需更多資訊,請參閱SDK 參考文件中的 CollectionSchema SDK 參考文件中的相關內容。
from pymilvus import MilvusClient, DataType

# You need to work out a collection schema out of your dataset.
schema = MilvusClient.create_schema(
    auto_id=False,
    enable_dynamic_field=True
)

DIM = 512

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True),
schema.add_field(field_name="bool", datatype=DataType.BOOL),
schema.add_field(field_name="int8", datatype=DataType.INT8),
schema.add_field(field_name="int16", datatype=DataType.INT16),
schema.add_field(field_name="int32", datatype=DataType.INT32),
schema.add_field(field_name="int64", datatype=DataType.INT64),
schema.add_field(field_name="float", datatype=DataType.FLOAT),
schema.add_field(field_name="double", datatype=DataType.DOUBLE),
schema.add_field(field_name="varchar", datatype=DataType.VARCHAR, max_length=512),
schema.add_field(field_name="json", datatype=DataType.JSON),
schema.add_field(field_name="array_str", datatype=DataType.ARRAY, max_capacity=100, element_type=DataType.VARCHAR, max_length=128)
schema.add_field(field_name="array_int", datatype=DataType.ARRAY, max_capacity=100, element_type=DataType.INT64)
schema.add_field(field_name="float_vector", datatype=DataType.FLOAT_VECTOR, dim=DIM),
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=DIM),
schema.add_field(field_name="float16_vector", datatype=DataType.FLOAT16_VECTOR, dim=DIM),
# schema.add_field(field_name="bfloat16_vector", datatype=DataType.BFLOAT16_VECTOR, dim=DIM),
schema.add_field(field_name="sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR)

schema.verify()

print(schema)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.bulkwriter.BulkImport;
import io.milvus.bulkwriter.RemoteBulkWriter;
import io.milvus.bulkwriter.RemoteBulkWriterParam;
import io.milvus.bulkwriter.common.clientenum.BulkFileType;
import io.milvus.bulkwriter.common.clientenum.CloudStorage;
import io.milvus.bulkwriter.connect.S3ConnectParam;
import io.milvus.bulkwriter.connect.StorageConnectParam;
import io.milvus.bulkwriter.request.describe.MilvusDescribeImportRequest;
import io.milvus.bulkwriter.request.import_.MilvusImportRequest;
import io.milvus.bulkwriter.request.list.MilvusListImportJobsRequest;
import io.milvus.common.utils.Float16Utils;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.*;

import java.io.IOException;
import java.nio.ByteBuffer;
import java.util.*;
import java.util.concurrent.TimeUnit;

private static final String MINIO_ENDPOINT = CloudStorage.MINIO.getEndpoint("http://127.0.0.1:9000");
private static final String BUCKET_NAME = "a-bucket";
private static final String ACCESS_KEY = "minioadmin";
private static final String SECRET_KEY = "minioadmin";

private static final Integer DIM = 512;
private static final Gson GSON_INSTANCE = new Gson();

private static CreateCollectionReq.CollectionSchema createSchema() {
    CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(true)
        .build();
    schema.addField(AddFieldReq.builder()
            .fieldName("id")
            .dataType(io.milvus.v2.common.DataType.Int64)
            .isPrimaryKey(Boolean.TRUE)
            .autoID(false)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("bool")
            .dataType(DataType.Bool)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("int8")
            .dataType(DataType.Int8)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("int16")
            .dataType(DataType.Int16)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("int32")
            .dataType(DataType.Int32)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("int64")
            .dataType(DataType.Int64)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("float")
            .dataType(DataType.Float)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("double")
            .dataType(DataType.Double)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("varchar")
            .dataType(DataType.VarChar)
            .maxLength(512)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("json")
            .dataType(io.milvus.v2.common.DataType.JSON)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("array_int")
            .dataType(io.milvus.v2.common.DataType.Array)
            .maxCapacity(100)
            .elementType(io.milvus.v2.common.DataType.Int64)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("array_str")
            .dataType(io.milvus.v2.common.DataType.Array)
            .maxCapacity(100)
            .elementType(io.milvus.v2.common.DataType.VarChar)
            .maxLength(128)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("float_vector")
            .dataType(io.milvus.v2.common.DataType.FloatVector)
            .dimension(DIM)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("binary_vector")
            .dataType(io.milvus.v2.common.DataType.BinaryVector)
            .dimension(DIM)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("float16_vector")
            .dataType(io.milvus.v2.common.DataType.Float16Vector)
            .dimension(DIM)
            .build());
    schema.addField(AddFieldReq.builder()
            .fieldName("sparse_vector")
            .dataType(io.milvus.v2.common.DataType.SparseFloatVector)
            .build());

    return schema;
}
原始檔中的 StructArray 欄位
不同來源檔案格式對StructArray欄位的處理方式各不相同。匯入讀取器預期會遇到以下其中一種形狀:
| 格式 | StructArray 欄位形狀 |
|---|---|
| JSON、JSONL | 該欄位值為一組物件清單,每個 Struct 元素對應一個物件,其鍵名取自子欄位名稱:"chunks": [{"text": "...", "section": "index", "emb": [0.1, 0.2]}, ...] 。 |
| CSV | 該儲存格所包含的 JSON 文字與 JSON 格式相同。針對匯入工作所設定的 `nullkey `,或 JSON 中的 `null `,皆標示為 StructArray 的 null 值。 |
| Parquet | 每個 StructArray 欄位對應一欄,資料型別為list<struct<...>> ,每個子欄位對應一個結構體子節點。標量子欄位為標量子節點;向量子欄位為其元素型別的清單(例如list<float32> );而陣列子欄位(Milvus 3.0.6 及後續版本)則為list<T> 子節點。 |
| NumPy | 不支援。NumPy 檔案會針對每個頂層欄位儲存一個檔案,且無法表示 StructArray 欄位。若集合包含 StructArray 欄位,請使用 JSON、CSV 或 Parquet 檔案。 |
以下規則適用於所有受支援格式中的 StructArray 值:
在每個 Struct 元素內應使用子欄位名稱,而非路徑(例如
chunks[text])。名為chunks[text]的扁平欄位或金鑰將被拒絕。Struct 元素本身不得為 null,例如
[null, {...}]。只有當 StructArray 欄位為可為 null 時,整個 StructArray 值才可為 null。在 Milvus 3.0.6 之前,每個 Struct 元素都必須提供所有子欄位。非集合子欄位的鍵或 Parquet 子元素(包括已刪除的子欄位)將被忽略。
自 Milvus 3.0.6 起,若某個元素可為 null 的子欄位缺少鍵值,或其
null值為 null,則會將其匯入為該 Struct 元素的 null 值;因此,在該子欄位新增之前所寫入的檔案,匯入時將省略該子欄位。 若在其他位置出現 `null`,則會導致匯入失敗。對於陣列子欄位,若子欄位允許,則 `null` 為空的內層陣列,而內層陣列中的 `null` 則為空的內層值。自 Milvus 3.0.6 起,對於包含元素可為空子欄位或標量陣列子欄位的集合,系統將拒絕執行二進位日誌匯入(例如備份還原)以及快照來源匯入。
pymilvusBulkWriter在所有受支援的格式中均支援上述 StructArray 結構,包括元素可為空的子欄位以及可為空的 StructArray 值。請在寫入器的 `add_row() ` 呼叫中使用相同的列結構。
有關模式層面的限制,請參閱StructArray 限制。
設定 BulkWriter
BulkWriter是一款專為將原始資料集轉換為適合透過 RESTful 匯入 API 匯入的格式而設計的工具。它提供兩種類型的寫入器:
- LocalBulkWriter:讀取指定的資料集,並將其轉換為易於使用的格式。
- RemoteBulkWriter:執行與 LocalBulkWriter 相同的任務,但會額外將轉換後的資料檔案傳輸至指定的遠端物件儲存桶。
RemoteBulkWriter與LocalBulkWriter的差異在於,RemoteBulkWriter會將轉換後的資料檔案傳輸至目標物件儲存桶。
設定 LocalBulkWriter
LocalBulkWriter會將來源資料集的資料列依序追加,並將其寫入指定格式的本地檔案中。
from pymilvus.bulk_writer import LocalBulkWriter, BulkFileType
# Use `from pymilvus import LocalBulkWriter, BulkFileType`
# when you use pymilvus earlier than 2.4.2

writer = LocalBulkWriter(
    schema=schema,
    local_path='.',
    segment_size=512 * 1024 * 1024, # Default value
    file_type=BulkFileType.PARQUET
)
import io.milvus.bulkwriter.LocalBulkWriter;
import io.milvus.bulkwriter.LocalBulkWriterParam;
import io.milvus.bulkwriter.common.clientenum.BulkFileType;

LocalBulkWriterParam localBulkWriterParam = LocalBulkWriterParam.newBuilder()
    .withCollectionSchema(schema)
    .withLocalPath(".")
    .withChunkSize(512 * 1024 * 1024)
    .withFileType(BulkFileType.PARQUET)
    .build();

LocalBulkWriter localBulkWriter = new LocalBulkWriter(localBulkWriterParam);
建立LocalBulkWriter 時,您應:
- 在 `
schema` 中引用已建立的資料結構。 - 將 `
local_path` 設定為輸出目錄。 - 將 `
file_type` 設定為輸出檔案類型。 - 若您的資料集包含大量記錄,建議您透過將 `
segment_size` 設定為適當的值來對資料進行分段。
有關參數設定的詳細資訊,請參閱 SDK 參考文件中的LocalBulkWriter。
建立LocalBulkWriter 時,您應:
- 在 `
CollectionSchema()` 中引用已建立的架構。 - 在 `
withLocalPath()` 中設定輸出目錄。 - 在 `
withFileType()` 中設定輸出檔案類型。 - 若您的資料集包含大量記錄,建議您將 `
withChunkSize()` 設定為適當的值,以對資料進行分段處理。
有關參數設定的詳細資訊,請參閱 SDK 參考手冊中的 LocalBulkWriter。
設定 RemoteBulkWriter
RemoteBulkWriter不會將追加的資料提交至本機檔案,而是提交至遠端儲存桶。因此,您應在建立RemoteBulkWriter 之前先設定一個ConnectParam物件。
from pymilvus.bulk_writer import RemoteBulkWriter
# Use `from pymilvus import RemoteBulkWriter`
# when you use pymilvus earlier than 2.4.2

# Third-party constants
ACCESS_KEY="minioadmin"
SECRET_KEY="minioadmin"
BUCKET_NAME="a-bucket"

# Connections parameters to access the remote bucket
conn = RemoteBulkWriter.S3ConnectParam(
    endpoint="localhost:9000", # the default MinIO service started along with Milvus
    access_key=ACCESS_KEY,
    secret_key=SECRET_KEY,
    bucket_name=BUCKET_NAME,
    secure=False
)

from pymilvus.bulk_writer import BulkFileType
# Use `from pymilvus import BulkFileType`
# when you use pymilvus earlier than 2.4.2

writer = RemoteBulkWriter(
    schema=schema,
    remote_path="/",
    connect_param=conn,
    file_type=BulkFileType.PARQUET
)

print('bulk writer created.')
private static RemoteBulkWriter createRemoteBulkWriter(CreateCollectionReq.CollectionSchema collectionSchema) throws IOException {
    StorageConnectParam connectParam = S3ConnectParam.newBuilder()
            .withEndpoint(MINIO_ENDPOINT)
            .withBucketName(BUCKET_NAME)
            .withAccessKey(ACCESS_KEY)
            .withSecretKey(SECRET_KEY)
            .build();
    RemoteBulkWriterParam bulkWriterParam = RemoteBulkWriterParam.newBuilder()
            .withCollectionSchema(collectionSchema)
            .withRemotePath("/")
            .withConnectParam(connectParam)
            .withFileType(BulkFileType.PARQUET)
            .build();
    return new RemoteBulkWriter(bulkWriterParam);
}
準備好連線參數後,您可於RemoteBulkWriter中如下所示進行引用:
from pymilvus.bulk_writer import BulkFileType
# Use `from pymilvus import BulkFileType`
# when you use pymilvus earlier than 2.4.2

writer = RemoteBulkWriter(
    schema=schema,
    remote_path="/",
    connect_param=conn,
    file_type=BulkFileType.PARQUET
)
import io.milvus.bulkwriter.RemoteBulkWriter;
import io.milvus.bulkwriter.RemoteBulkWriterParam;

RemoteBulkWriterParam remoteBulkWriterParam = RemoteBulkWriterParam.newBuilder()
    .withCollectionSchema(schema)
    .withConnectParam(storageConnectParam)
    .withChunkSize(512 * 1024 * 1024)
    .withRemotePath("/")
    .withFileType(BulkFileType.PARQUET)
    .build();

RemoteBulkWriter remoteBulkWriter = new RemoteBulkWriter(remoteBulkWriterParam);
建立RemoteBulkWriter的參數與LocalBulkWriter 幾乎相同,唯獨connect_param 參數有所不同。有關參數設定的詳細資訊,請參閱 SDK 參考文件中的RemoteBulkWriter和ConnectParam。
建立RemoteBulkWriter的參數與LocalBulkWriter 幾乎相同,唯獨StorageConnectParam 不同。有關參數設定的詳細資訊,請參閱 SDK 參考文件中的 RemoteBulkWriter 和 StorageConnectParam。
開始寫入
BulkWriter具有兩個方法:append_row() 用於從來源資料集新增一行,以及commit() 用於將新增的行提交至本機檔案或遠端儲存桶。
BulkWriter具有兩個方法:appendRow() 會從來源資料集新增一行資料,而commit() 則會將新增的資料行提交至本機檔案或遠端儲存桶。
為示範之用,以下程式碼會追加隨機生成的資料。
import random, string, json
import numpy as np
import tensorflow as tf

def generate_random_str(length=5):
    letters = string.ascii_uppercase
    digits = string.digits

    return ''.join(random.choices(letters + digits, k=length))

# optional input for binary vector:
# 1. list of int such as [1, 0, 1, 1, 0, 0, 1, 0]
# 2. numpy array of uint8
def gen_binary_vector(to_numpy_arr):
    raw_vector = [random.randint(0, 1) for i in range(DIM)]
    if to_numpy_arr:
        return np.packbits(raw_vector, axis=-1)
    return raw_vector

# optional input for float vector:
# 1. list of float such as [0.56, 1.859, 6.55, 9.45]
# 2. numpy array of float32
def gen_float_vector(to_numpy_arr):
    raw_vector = [random.random() for _ in range(DIM)]
    if to_numpy_arr:
        return np.array(raw_vector, dtype="float32")
    return raw_vector

# # optional input for bfloat16 vector:
# # 1. list of float such as [0.56, 1.859, 6.55, 9.45]
# # 2. numpy array of bfloat16
# def gen_bf16_vector(to_numpy_arr):
#     raw_vector = [random.random() for _ in range(DIM)]
#     if to_numpy_arr:
#         return tf.cast(raw_vector, dtype=tf.bfloat16).numpy()
#     return raw_vector

# optional input for float16 vector:
# 1. list of float such as [0.56, 1.859, 6.55, 9.45]
# 2. numpy array of float16
def gen_fp16_vector(to_numpy_arr):
    raw_vector = [random.random() for _ in range(DIM)]
    if to_numpy_arr:
        return np.array(raw_vector, dtype=np.float16)
    return raw_vector

# optional input for sparse vector:
# only accepts dict like {2: 13.23, 45: 0.54} or {"indices": [1, 2], "values": [0.1, 0.2]}
# note: no need to sort the keys
def gen_sparse_vector(pair_dict: bool):
    raw_vector = {}
    dim = random.randint(2, 20)
    if pair_dict:
        raw_vector["indices"] = [i for i in range(dim)]
        raw_vector["values"] = [random.random() for _ in range(dim)]
    else:
        for i in range(dim):
            raw_vector[i] = random.random()
    return raw_vector

for i in range(10000):
    writer.append_row({
        "id": np.int64(i),
        "bool": True if i % 3 == 0 else False,
        "int8": np.int8(i%128),
        "int16": np.int16(i%1000),
        "int32": np.int32(i%100000),
        "int64": np.int64(i),
        "float": np.float32(i/3),
        "double": np.float64(i/7),
        "varchar": f"varchar_{i}",
        "json": json.dumps({"dummy": i, "ok": f"name_{i}"}),
        "array_str": np.array([f"str_{k}" for k in range(5)], np.dtype("str")),
        "array_int": np.array([k for k in range(10)], np.dtype("int64")),
        "float_vector": gen_float_vector(True),
        "binary_vector": gen_binary_vector(True),
        "float16_vector": gen_fp16_vector(True),
        # "bfloat16_vector": gen_bf16_vector(True),
        "sparse_vector": gen_sparse_vector(True),
        f"dynamic_{i}": i,
    })
    if (i+1)%1000 == 0:
        writer.commit()
        print('committed')

print(writer.batch_files)
private static byte[] genBinaryVector() {
    Random ran = new Random();
    int byteCount = DIM / 8;
    ByteBuffer vector = ByteBuffer.allocate(byteCount);
    for (int i = 0; i < byteCount; ++i) {
        vector.put((byte) ran.nextInt(Byte.MAX_VALUE));
    }
    return vector.array();
}

private static List<Float> genFloatVector() {
    Random ran = new Random();
    List<Float> vector = new ArrayList<>();
    for (int i = 0; i < DIM; ++i) {
        vector.add(ran.nextFloat());
    }
    return vector;
}

private static byte[] genFloat16Vector() {
    List<Float> originalVector = genFloatVector();
    return Float16Utils.f32VectorToFp16Buffer(originalVector).array();
}

private static SortedMap<Long, Float> genSparseVector() {
    Random ran = new Random();
    SortedMap<Long, Float> sparse = new TreeMap<>();
    int dim = ran.nextInt(18) + 2; // [2, 20)
    for (int i = 0; i < dim; ++i) {
        sparse.put((long)ran.nextInt(1000000), ran.nextFloat());
    }
    return sparse;
}

private static List<String> genStringArray(int length) {
    List<String> arr = new ArrayList<>();
    for (int i = 0; i < length; i++) {
        arr.add("str_" + i);
    }
    return arr;
}

private static List<Long> genIntArray(int length) {
    List<Long> arr = new ArrayList<>();
    for (long i = 0; i < length; i++) {
        arr.add(i);
    }
    return arr;
}

private static RemoteBulkWriter createRemoteBulkWriter(CreateCollectionReq.CollectionSchema collectionSchema) throws IOException {
    StorageConnectParam connectParam = S3ConnectParam.newBuilder()
            .withEndpoint(MINIO_ENDPOINT)
            .withBucketName(BUCKET_NAME)
            .withAccessKey(ACCESS_KEY)
            .withSecretKey(SECRET_KEY)
            .build();
    RemoteBulkWriterParam bulkWriterParam = RemoteBulkWriterParam.newBuilder()
            .withCollectionSchema(collectionSchema)
            .withRemotePath("/")
            .withConnectParam(connectParam)
            .withFileType(BulkFileType.PARQUET)
            .build();
    return new RemoteBulkWriter(bulkWriterParam);
}

private static List<List<String>> uploadData() throws Exception {
    CreateCollectionReq.CollectionSchema collectionSchema = createSchema();
    try (RemoteBulkWriter remoteBulkWriter = createRemoteBulkWriter(collectionSchema)) {
        for (int i = 0; i < 10000; ++i) {
            JsonObject rowObject = new JsonObject();

            rowObject.addProperty("id", i);
            rowObject.addProperty("bool", i % 3 == 0);
            rowObject.addProperty("int8", i % 128);
            rowObject.addProperty("int16", i % 1000);
            rowObject.addProperty("int32", i % 100000);
            rowObject.addProperty("int64", i);
            rowObject.addProperty("float", i / 3);
            rowObject.addProperty("double", i / 7);
            rowObject.addProperty("varchar", "varchar_" + i);
            rowObject.addProperty("json", String.format("{\"dummy\": %s, \"ok\": \"name_%s\"}", i, i));
            rowObject.add("array_str", GSON_INSTANCE.toJsonTree(genStringArray(5)));
            rowObject.add("array_int", GSON_INSTANCE.toJsonTree(genIntArray(10)));
            rowObject.add("float_vector", GSON_INSTANCE.toJsonTree(genFloatVector()));
            rowObject.add("binary_vector", GSON_INSTANCE.toJsonTree(genBinaryVector()));
            rowObject.add("float16_vector", GSON_INSTANCE.toJsonTree(genFloat16Vector()));
            rowObject.add("sparse_vector", GSON_INSTANCE.toJsonTree(genSparseVector()));
            rowObject.addProperty("dynamic", "dynamic_" + i);

            remoteBulkWriter.appendRow(rowObject);

            if ((i+1)%1000 == 0) {
                remoteBulkWriter.commit(false);
            }
        }

        List<List<String>> batchFiles = remoteBulkWriter.getBatchFiles();
        System.out.println(batchFiles);
        return batchFiles;
    } catch (Exception e) {
        throw e;
    }
}

public static void main(String[] args) throws Exception {
    List<List<String>> batchFiles = uploadData();
}
驗證結果
若要檢查結果,您可以透過列印寫入器的batch_files 屬性來取得實際的輸出路徑。
若要檢查結果,您可以透過印出寫入器的getBatchFiles() 方法來取得實際的輸出路徑。
print(writer.batch_files)

# [['d4220a9e-45be-4ccb-8cb5-bf09304b9f23/1.parquet'],
#  ['d4220a9e-45be-4ccb-8cb5-bf09304b9f23/2.parquet']]
// localBulkWriter.getBatchFiles();
remoteBulkWriter.getBatchFiles();

//

// Close the BulkWriter
try {
    localBulkWriter.close();
    remoteBulkWriter.close();
} catch (Exception e) {
    // TODO: handle exception
    e.printStackTrace();
}
BulkWriter會產生一個 UUID,並使用該 UUID 在指定的輸出目錄中建立子資料夾,將所有生成的檔案放置於該子資料夾中。請點擊此處下載已準備好的範例資料。
可能的資料夾結構如下:
# JSON
├── folder
│   └── 45ae1139-1d87-4aff-85f5-0039111f9e6b
│       └── 1.json

# Parquet
├── folder
│   └── 45ae1139-1d87-4aff-85f5-0039111f9e6b
│       └── 1.parquet
