

Présentation de Model RankerCompatible with Milvus 2.6.x
La recherche vectorielle traditionnelle classe les résultats uniquement en fonction de la similarité mathématique, c'est-à-dire du degré de correspondance entre les vecteurs dans un espace à haute dimension. Bien qu'efficace, cette approche passe souvent à côté de la véritable pertinence sémantique. Prenons l'exemple d'une recherche sur les « meilleures pratiques d'optimisation des bases de données » : vous pourriez obtenir des documents présentant une forte similarité vectorielle et mentionnant fréquemment ces termes, mais qui ne fournissent pas réellement de stratégies d'optimisation exploitables.
Model Ranker transforme la recherche Milvus en intégrant des modèles linguistiques avancés qui comprennent les relations sémantiques entre les requêtes et les documents. Au lieu de se fier uniquement à la similitude vectorielle, il évalue le sens et le contexte du contenu pour fournir des résultats plus intelligents et plus pertinents.
Limites
Les classements par modèle ne peuvent pas être utilisés avec les recherches groupées.
Les champs utilisés pour le reclassement par modèle doivent être de type texte (
VARCHAR).Chaque « Model Ranker » ne peut utiliser qu’un seul champ de type «
VARCHAR» à la fois pour l’évaluation.
Fonctionnement
Les classificateurs de modèles intègrent des capacités de compréhension des modèles linguistiques au processus de recherche Milvus via un workflow bien défini :
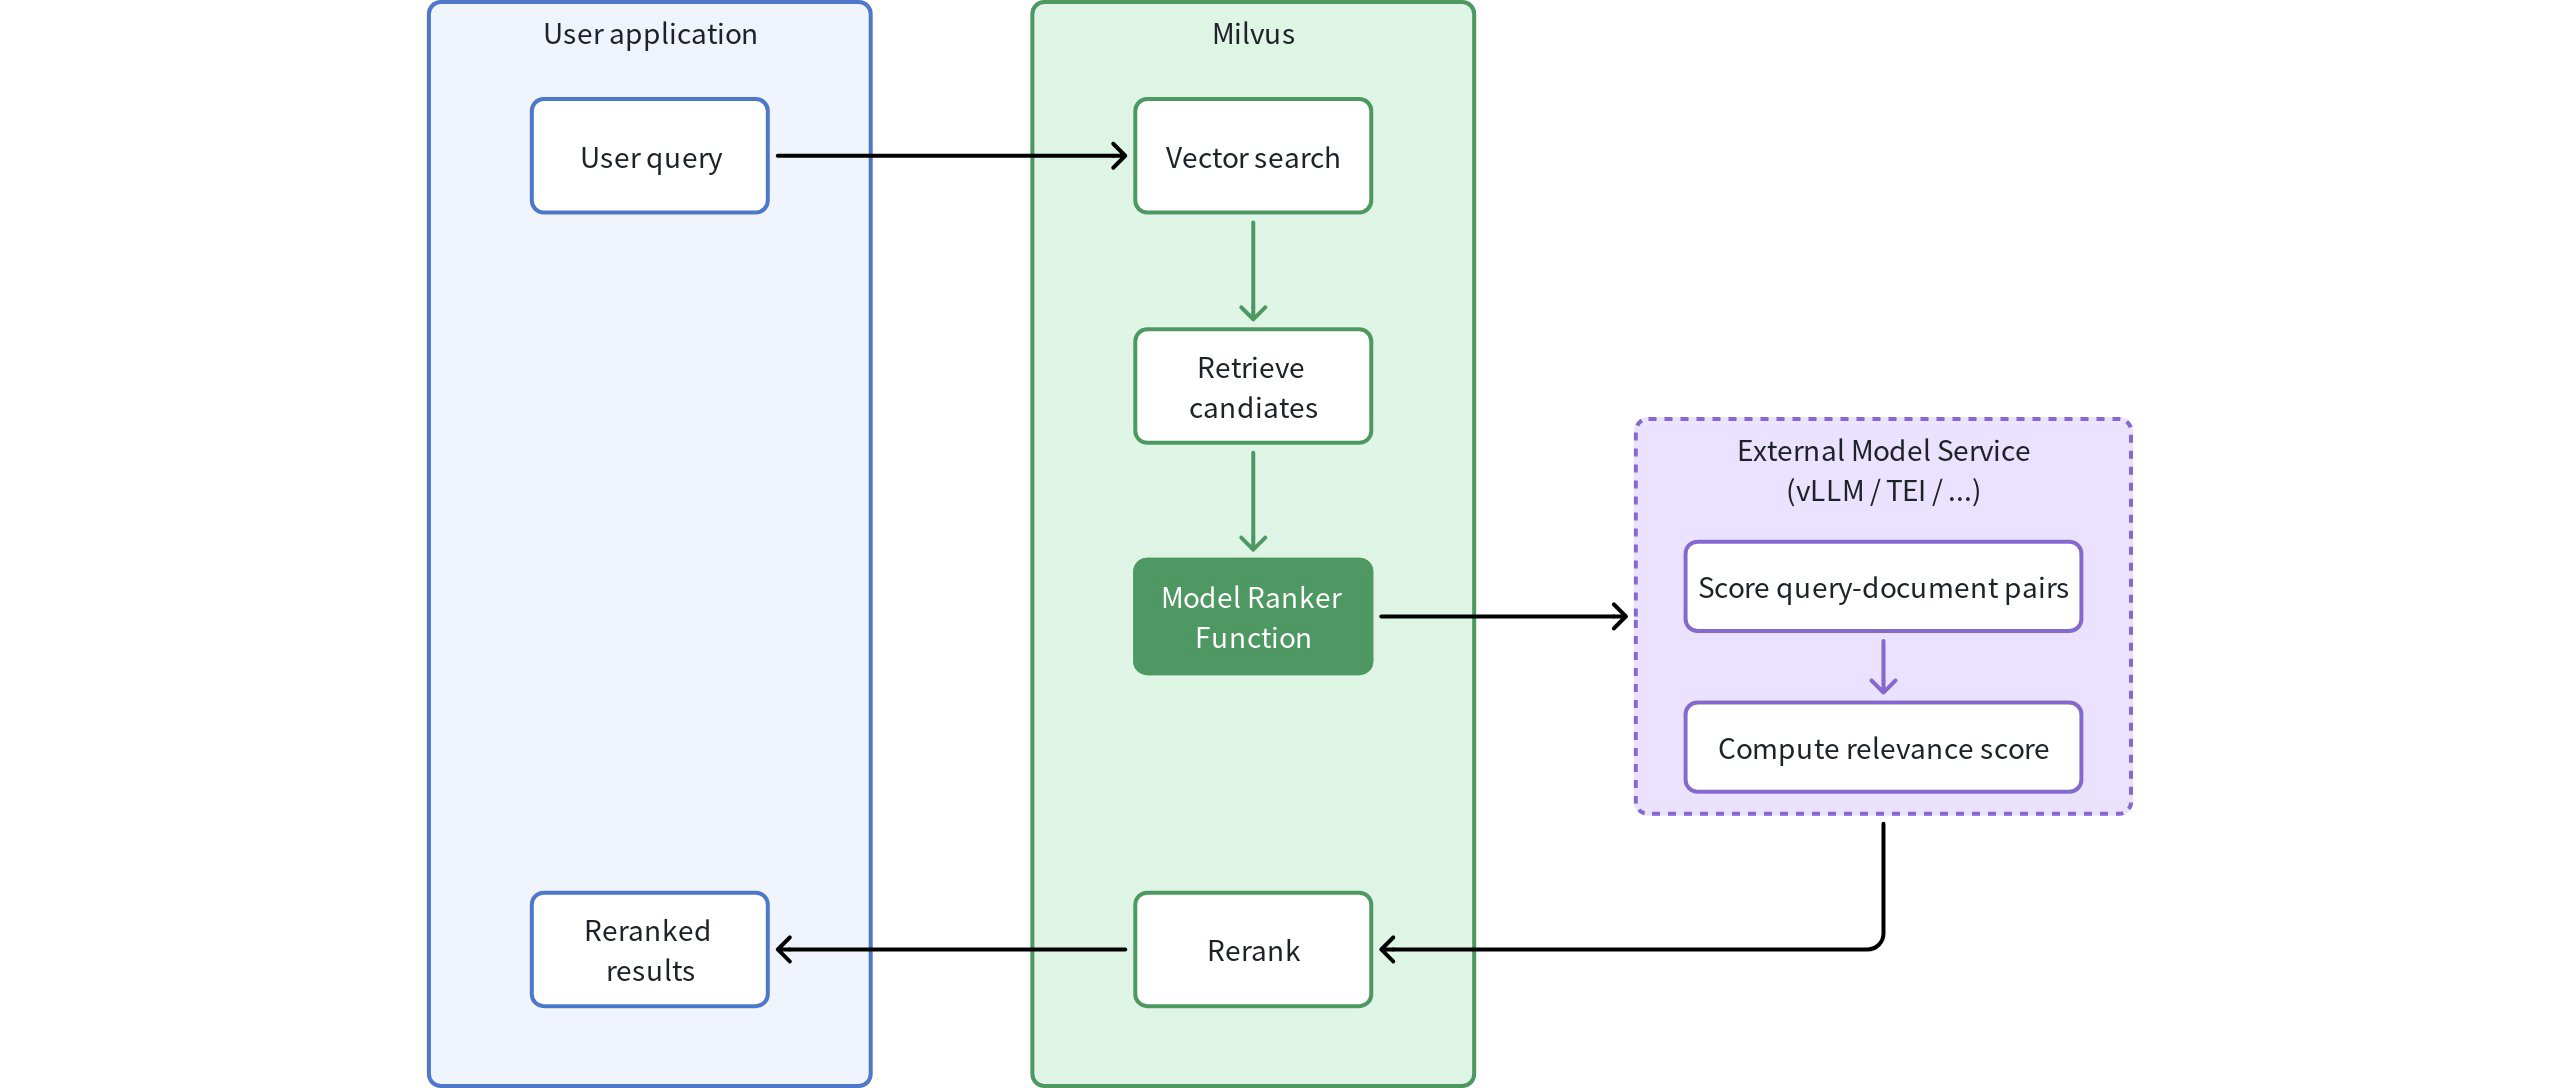 Présentation des classificateurs de modèles
Requête initiale: votre application envoie une requête à Milvus
Recherche vectorielle: Milvus effectue une recherche vectorielle standard pour identifier les documents candidats
Récupération des documents candidats: le système identifie l'ensemble initial de documents candidats en fonction de la similarité vectorielle
Évaluation du modèle: la fonction « Model Ranker » traite les paires requête-document :
Envoie la requête d’origine et les documents candidats à un service de modèle externe
Le modèle linguistique évalue la pertinence sémantique entre la requête et chaque document
Chaque document se voit attribuer un score de pertinence basé sur la compréhension sémantique
Réclassement intelligent: les documents sont réorganisés en fonction des scores de pertinence générés par le modèle
Résultats améliorés: votre application reçoit des résultats classés par pertinence sémantique plutôt que par simple similarité vectorielle
Choisissez un fournisseur de modèles adapté à vos besoins
Milvus prend en charge les fournisseurs de services de modèles suivants pour le reclassement, chacun présentant des caractéristiques distinctes :
Fournisseur |
Idéal pour |
Caractéristiques |
Exemple d'utilisation |
|---|---|---|---|
vLLM |
Applications complexes nécessitant une compréhension sémantique approfondie et une personnalisation poussée |
|
Plateforme de recherche juridique déployant des modèles spécifiques au domaine qui comprennent la terminologie juridique et les relations entre les jurisprudences |
TEI |
Mise en œuvre rapide avec une utilisation efficace des ressources |
|
Système de gestion de contenu nécessitant des capacités de reclassement efficaces répondant à des exigences standard |
Cohere |
Applications d’entreprise privilégiant la fiabilité et la facilité d’intégration |
|
Plateforme de commerce électronique nécessitant une recherche à haute disponibilité avec des performances API constantes et des catalogues de produits multilingues |
Voyage AI |
Applications RAG présentant des exigences spécifiques en matière de performances et de contexte |
|
Base de données de recherche comportant des documents de longueurs variables, nécessitant un contrôle précis des performances et une compréhension sémantique spécialisée |
SiliconFlow |
Applications traitant de longs documents avec des priorités en matière de rentabilité |
|
Système de recherche de documentation technique traitant des manuels et des articles volumineux nécessitant une segmentation intelligente et un contrôle des chevauchements |
DashScope |
Applications utilisant les modèles de reclassement d’Alibaba Cloud ou de Qwen |
|
Applications RAG souhaitant reclasser des candidats à l’aide de modèles de reclassement hébergés sur Alibaba Cloud |
Hugging Face |
Applications utilisant les modèles de similarité de phrases hébergés par Hugging Face |
|
Applications de recherche sémantique souhaitant reclasser des textes candidats à l’aide d’un modèle Hugging Face sans avoir à exploiter un service d’inférence distinct |
Pour plus d'informations sur la mise en œuvre de chaque service de modèle, consultez la documentation dédiée :
Mise en œuvre
Avant de mettre en œuvre Model Ranker, assurez-vous de disposer des éléments suivants :
Une collection Milvus comportant un champ «
VARCHAR» contenant le texte à reclasserUn service de modèle externe en cours d’exécution et accessible depuis votre instance Milvus
Une connectivité réseau appropriée entre Milvus et le service de modèle de votre choix
Les « Model Rankers » s’intègrent de manière transparente aussi bien aux opérations de recherche vectorielle standard qu’aux opérations de recherche hybride. La mise en œuvre consiste à créer un objet Function qui définit votre configuration de reclassement, puis à le transmettre aux opérations de recherche.
Créer un « Model Ranker »
Pour implémenter le reclassement par modèle, définissez d’abord un objet Function avec la configuration appropriée. Dans cet exemple, nous utilisons TEI comme fournisseur de services :
from pymilvus import MilvusClient, Function, FunctionType

# Connect to your Milvus server
client = MilvusClient(
    uri="http://localhost:19530"  # Replace with your Milvus server URI
)

# Create a model ranker function
model_ranker = Function(
    name="semantic_ranker",  # Function identifier
    input_field_names=["document"],  # VARCHAR field to use for reranking
    function_type=FunctionType.RERANK,  # Must be set to RERANK
    params={
        "reranker": "model",  # Specify model reranker. Must be "model"
        "provider": "tei",  # Choose provider: "tei", "vllm", etc.
        "queries": ["machine learning for time series"],  # Query text
        "endpoint": "http://model-service:8080",  # Model service endpoint
        # "maxBatch": 32  # Optional: batch size for processing
    }
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.ranker.ModelRanker;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

ModelRanker ranker = ModelRanker.builder()
        .name("semantic_ranker")
        .inputFieldNames(Collections.singletonList("document"))
        .provider("tei")
        .queries(Collections.singletonList("machine learning for time series"))
        .endpoint("http://model-service:8080")
        .build();
// nodejs
// go
# restful
Paramètre |
Obligatoire ? |
Description |
Valeur / Exemple |
|---|---|---|---|
|
Oui |
Identifiant de votre fonction utilisé lors des recherches. |
|
|
Oui |
Nom du champ de texte à utiliser pour le reclassement. Doit être un champ de type « |
|
|
Oui |
Spécifie le type de fonction en cours de création. Doit être défini sur « |
|
|
Oui |
Dictionnaire contenant la configuration de la fonction de reclassement basée sur un modèle. Les paramètres (clés) disponibles varient en fonction du fournisseur de services. |
|
|
Oui |
Doit être défini sur « |
|
|
Oui |
Le fournisseur de services de modèles à utiliser pour le reclassement. |
|
|
Oui |
Liste des chaînes de requête utilisées par le modèle de reclassement pour calculer les scores de pertinence. Le nombre de chaînes de requête doit correspondre exactement au nombre de requêtes de votre opération de recherche (même lorsque vous utilisez des vecteurs de requête à la place du texte), sinon une erreur sera signalée. |
|
|
Oui |
URL du service de modèle. |
|
|
Non |
Nombre maximal de documents à traiter en un seul lot. Des valeurs plus élevées augmentent le débit mais nécessitent davantage de mémoire. |
|
Appliquer à la recherche vectorielle standard
Après avoir défini votre modèle de classement, vous pouvez l'appliquer lors des opérations de recherche en le transmettant au paramètre « ranker » :
# Use the model ranker in standard vector search
results = client.search(
    collection_name,
    data=[your_query_vector], # Number of query vectors must match that specified in model_ranker.params["queries"]
    anns_field="vector_field",
    limit=10,
    output_fields=["document"],  # Include the text field in outputs
    ranker=model_ranker,  # Apply the model ranker here
    consistency_level="Bounded"
)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

SearchReq searchReq = SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .data(Collections.singletonList(new EmbeddedText("machine learning for time series")))
        .annsField("vector_field")
        .limit(10)
        .outputFields(Collections.singletonList(document))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .consistencyLevel(ConsistencyLevel.BOUNDED)
        .build();
SearchResp searchResp = client.search(searchReq);
// nodejs
// go
# restful
