

Milvus 部署选项概述
Milvus 是一款高性能、可扩展的向量数据库。它支持各种规模的应用场景,从在 Jupyter Notebook 中本地运行的演示,到处理数百亿个向量的大规模 Kubernetes 集群。目前,Milvus 提供三种部署选项:Milvus Lite、Milvus Standalone 和 Milvus Distributed。
Milvus Lite
Milvus Lite是一个可导入到应用程序中的 Python 库。作为 Milvus 的精简版,它非常适合在 Jupyter Notebook 中进行快速原型开发,或在资源有限的智能设备上运行。 Milvus Lite 支持其他 Milvus 部署方式相同的 API。与 Milvus Lite 交互的客户端代码也可与其他部署模式下的 Milvus 实例配合使用。
要将 Milvus Lite 集成到您的应用程序中,请运行 `pip install pymilvus ` 进行安装,并使用 `MilvusClient("./demo.db") ` 语句基于本地文件实例化向量数据库,该文件将持久化所有数据。更多详细信息,请参阅《运行 Milvus Lite》。
Milvus Standalone
Milvus Standalone 是一种单机服务器部署方案。Milvus Standalone 的所有组件均打包在一个Docker 镜像中,便于部署。 如果您有生产环境的工作负载,但希望避免使用 Kubernetes,那么在内存充足的单台机器上运行 Milvus Standalone 是一个不错的选择。默认情况下,Milvus Standalone 使用Woodpecker(嵌入式)作为消息队列,因此无需单独运维消息服务。
Milvus Distributed
Milvus Distributed 可部署在Kubernetes集群上。该部署采用云原生架构,其中数据摄取负载和搜索查询由隔离的节点分别处理,从而为关键组件提供了冗余保障。它具备最高的可扩展性和可用性,同时允许灵活定制各组件的资源分配。 对于在生产环境中运行大规模向量搜索系统的企业用户而言,Milvus Distributed 是首选方案。默认情况下,Milvus Distributed 将Woodpecker作为消息队列运行,并作为独立服务与 Milvus 并行部署。
根据您的用例选择合适的部署方式
部署模式的选择通常取决于应用程序的开发阶段:
快速原型开发
如果您希望快速构建原型或用于学习目的,例如检索增强生成(RAG)演示、AI 聊天机器人、多模态搜索,那么 Milvus Lite 本身或 Milvus Lite 与 Milvus Standalone 的组合都是合适的选择。 您可以在笔记本中使用 Milvus Lite 进行快速原型设计,并探索各种方法,例如 RAG 中的不同分块策略。如果您希望将使用 Milvus Lite 构建的应用程序部署到小规模生产环境中以服务真实用户,或者在更大规模的数据集(例如超过几百万个向量)上验证该想法,则 Milvus Standalone 是合适的选择。 由于所有 Milvus 部署都采用相同的客户端 API,因此 Milvus Lite 的应用逻辑仍可复用。此外,存储在 Milvus Lite 中的数据也可通过命令行工具迁移至 Milvus Standalone。
小规模生产部署
对于早期生产环境,当项目仍处于探索产品与市场契合度的阶段,且敏捷性比可扩展性更为重要时,Milvus Standalone 是最佳选择。在机器资源充足的情况下,它仍可扩展至 1 亿个向量,同时所需的 DevOps 工作量远低于维护 K8s 集群。
大规模生产部署
随着业务快速增长,数据规模超过单台服务器的容量,此时应考虑采用 Milvus Distributed。您可以继续在开发或预生产环境中使用 Milvus Standalone 以保持便利性,同时运维运行 Milvus Distributed 的 K8s 集群。 这种架构不仅能支持您处理数百亿向量,还能根据具体工作负载(例如高读取、低写入,或高写入、低读取等场景)灵活调整节点规格。
边缘设备上的本地搜索
若需在边缘设备上对私有或敏感数据进行搜索,您可在设备上部署 Milvus Lite,无需依赖云端服务即可进行文本或图像搜索。这适用于专有文档搜索或设备端物体检测等场景。
Milvus 的部署模式选择取决于您项目的阶段和规模。从快速原型设计到大规模企业部署,Milvus 都能为各种需求提供灵活而强大的解决方案。
- 对于规模较小、最多几百万个向量的数据集,建议使用Milvus Lite。
- Milvus Standalone适用于中等规模的数据集,可扩展至 1 亿个向量。
- Milvus Distributed专为大规模部署设计,能够处理从 1 亿到数百亿向量规模的数据集。
无论采用何种部署模式,每个 Milvus 实例都依赖于消息队列、对象存储和元数据存储——默认使用Woodpecker、MinIO 和etcd。如需了解这些依赖项、进行配置调整或连接外部服务,请参阅“数据基础设施”。
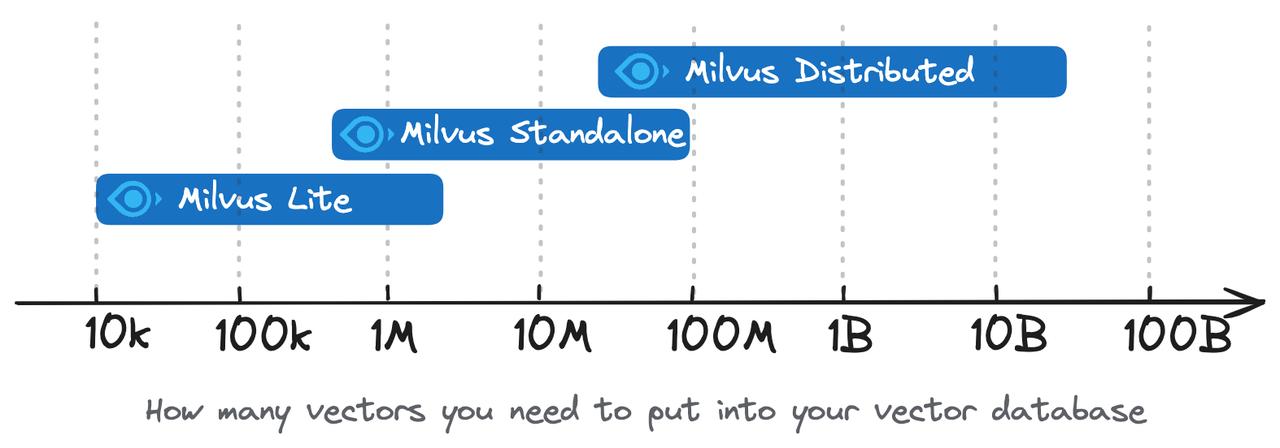 根据您的用例选择部署选项
功能对比
| 功能 | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / 客户端库 | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| 数据类型 | 稠密向量 稀疏向量 二进制向量 布尔值 整数 浮点数 可变长度字符串 数组 JSON | 稠密向量 稀疏向量 二进制向量 布尔值 整数 浮点数 VarChar 数组 JSON | 稠密向量 稀疏向量 二进制向量 布尔值 整数 浮点数 VarChar 数组 JSON |
| 搜索功能 | 向量搜索(ANN 搜索) 元数据过滤 范围搜索 标量查询 按主键获取实体 混合搜索 | 向量搜索(ANN搜索) 元数据过滤 范围搜索 标量查询 按主键获取实体 混合搜索 | 向量搜索(ANN搜索) 元数据过滤 范围搜索 标量查询 按主键获取实体 混合搜索 |
| CRUD 操作 | ✔️ | ✔️ | ✔️ |
| 高级数据管理 | 不适用 | 访问控制 分区 分区 Key | 访问控制 分区 分区 Key 物理资源分组 |
| 一致性级别 | 强 | 强 有限过时 会话 最终 | 强 有限过时 会话 最终 |
| 消息队列 | 不适用 | Woodpecker(嵌入式) | Woodpecker(服务) |
