

Milvus 部署選項概覽
Milvus 是一款高效能且可擴展的向量資料庫。它支援各種規模的使用情境,從在 Jupyter Notebook 中本地執行的示範,到處理數百億個向量的大型 Kubernetes 叢集皆可。目前,Milvus 提供三種部署選項:Milvus Lite、Milvus Standalone 以及 Milvus Distributed。
Milvus Lite
Milvus Lite是一個可導入至您應用程式的 Python 函式庫。作為 Milvus 的輕量級版本,它非常適合在 Jupyter Notebook 中進行快速原型開發,或在資源有限的智慧裝置上運行。 Milvus Lite 支援與其他 Milvus 部署模式相同的 API。與 Milvus Lite 互動的客戶端程式碼,亦可與其他部署模式下的 Milvus 實例協同運作。
若要將 Milvus Lite 整合至您的應用程式中,請執行 `pip install pymilvus ` 進行安裝,並使用 `MilvusClient("./demo.db") ` 語句,透過本地檔案建立向量資料庫以持久化所有資料。更多詳細資訊,請參閱《執行 Milvus Lite》。
Milvus 獨立版
Milvus Standalone 是一種單機伺服器部署模式。Milvus Standalone 的所有元件均封裝於單一Docker 映像檔中,使部署更加便捷。 若您有生產環境的工作負載,但不希望使用 Kubernetes,則在具備充足記憶體的單一機器上運行 Milvus 獨立版是一個不錯的選擇。預設情況下,Milvus 獨立版會運行Woodpecker(內嵌版)作為其訊息佇列,因此無需額外管理獨立的訊息傳遞服務。
Milvus 分散式
Milvus Distributed 可部署於Kubernetes叢集上。此部署採用雲原生架構,其中資料導入負載與搜尋查詢由隔離的節點分別處理,並為關鍵元件提供冗餘機制。它具備最高的可擴展性與可用性,同時也提供自訂各元件資源分配的靈活性。 對於在生產環境中運行大規模向量搜尋系統的企業用戶而言,Milvus Distributed 是首選方案。預設情況下,Milvus Distributed 會將Woodpecker作為其訊息佇列,並與 Milvus 一併部署為專用服務。
根據您的使用情境選擇合適的部署模式
部署模式的選擇通常取決於應用程式的開發階段:
快速原型開發
若您希望快速建構原型或進行學習,例如檢索增強生成(RAG)示範、AI 聊天機器人、多模態搜尋等,Milvus Lite 本身或 Milvus Lite 與 Milvus Standalone 的組合皆為合適選擇。 您可以在筆記本中使用 Milvus Lite 進行快速原型開發,並探索各種方法,例如 RAG 中的不同分塊策略。若您希望將使用 Milvus Lite 建置的應用程式部署於小規模生產環境以服務真實使用者,或在更大規模的資料集(例如超過數百萬個向量)上驗證構想,則 Milvus Standalone 是合適的選擇。 由於所有 Milvus 部署皆採用相同的客戶端 API,因此 Milvus Lite 的應用程式邏輯仍可共用。此外,儲存於 Milvus Lite 中的資料亦可透過命令列工具遷移至 Milvus Standalone。
小規模生產環境部署
對於早期生產階段,當專案仍在尋求產品與市場的契合度,且敏捷性比可擴展性更為重要時,Milvus Standalone 是最佳選擇。在具備足夠的機器資源下,它仍可擴展至 1 億個向量,同時所需的 DevOps 維護工作遠少於維護 K8s 叢集。
大規模生產部署
隨著業務快速成長,且資料規模超過單一伺服器的容量,此時便該考慮採用 Milvus Distributed。您可繼續在開發或預備環境中使用 Milvus Standalone 以維持便利性,並同時運作執行 Milvus Distributed 的 K8s 叢集。 此架構不僅能支援數百億向量的處理,還能根據特定工作負載(例如高讀取、低寫入,或高寫入、低讀取等情境)靈活調整節點規格。
邊緣裝置上的本地搜尋
若需在邊緣裝置上搜尋私有或敏感資料,您可直接在裝置上部署 Milvus Lite,無需依賴雲端服務即可進行文字或圖像搜尋。此方案適用於專有文件搜尋或裝置端物件偵測等情境。
Milvus 的部署模式選擇取決於您的專案階段與規模。無論是快速原型開發還是大規模企業部署,Milvus 都能針對各種需求提供靈活且強大的解決方案。
- 若資料集規模較小(最多數百萬個向量),建議使用Milvus Lite。
- Milvus Standalone適用於中型資料集,可擴展至 1 億個向量。
- Milvus Distributed專為大規模部署設計,可處理從 1 億到數十億向量不等的資料集。
無論採用何種部署模式,每個 Milvus 實例皆仰賴訊息佇列、物件儲存及元資料儲存庫——預設分別為Woodpecker、MinIO 及etcd。若要瞭解這些依賴項、進行調整或連接外部服務,請參閱「資料基礎架構」。
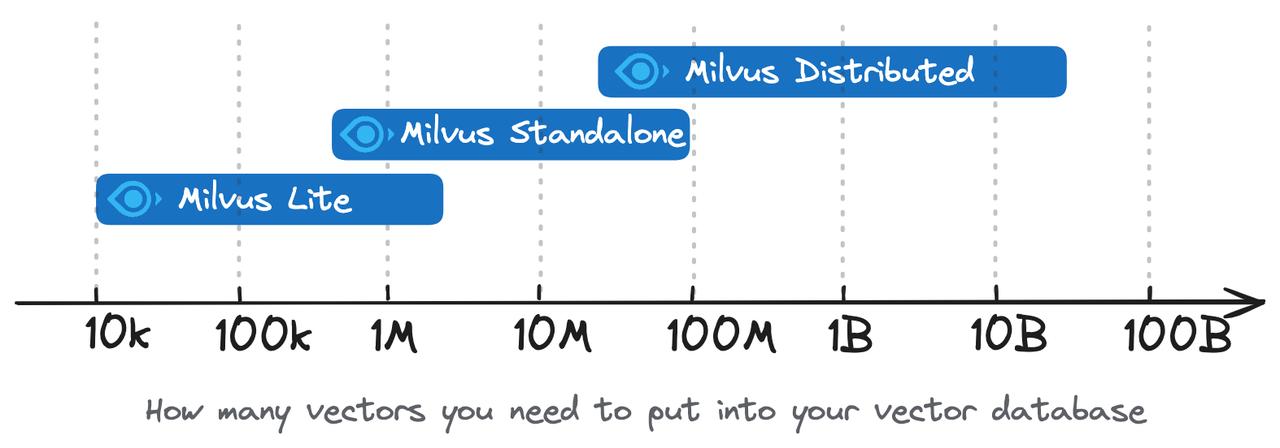 根據您的使用情境選擇部署選項
功能比較
| 功能 | Milvus Lite | Milvus 獨立版 | Milvus 分散式 |
|---|---|---|---|
| SDK / 客戶端函式庫 | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| 資料類型 | 密集向量 稀疏向量 二進位向量 布林值 整數 浮點數 變長字串 陣列 JSON | 密集向量 稀疏向量 二進位向量 布林值 整數 浮點數 VarChar 陣列 JSON | 密集向量 稀疏向量 二進位向量 布林值 整數 浮點數 VarChar 陣列 JSON |
| 搜尋功能 | 向量搜尋(ANN 搜尋) 元數據篩選 範圍搜尋 標量查詢 透過主鍵取得實體 混合搜尋 | 向量搜尋 (ANN 搜尋) 元數據篩選 範圍搜尋 標量查詢 透過主鍵取得實體 混合搜尋 | 向量搜尋 (ANN 搜尋) 元數據篩選 範圍搜尋 標量查詢 透過主鍵取得實體 混合搜尋 |
| CRUD 操作 | ✔️ | ✔️ | ✔️ |
| 進階資料管理 | 不適用 | 存取控制 分區 分區金鑰 | 存取控制 區隔 區隔金鑰 實體資源分組 |
| 一致性層級 | 強 | 強 有限過時 會話 最終 | 強 有界過時 會話 最終 |
| 訊息佇列 | 不適用 | Woodpecker(嵌入式) | Woodpecker(服務) |
