

Обзор вариантов развертывания Milvus
Milvus — это высокопроизводительная и масштабируемая векторная база данных. Она поддерживает сценарии использования различного масштаба: от локальных демонстрационных версий, запускаемых в Jupyter Notebooks, до масштабных кластеров Kubernetes, обрабатывающих десятки миллиардов векторов. В настоящее время существует три варианта развертывания Milvus: Milvus Lite, Milvus Standalone и Milvus Distributed.
Milvus Lite
Milvus Lite — это библиотека на языке Python, которую можно импортировать в ваши приложения. Являясь облегчённой версией Milvus, она идеально подходит для быстрого прототипирования в Jupyter Notebooks или запуска на интеллектуальных устройствах с ограниченными ресурсами. Milvus Lite поддерживает те же API, что и другие варианты развертывания Milvus. Клиентский код, взаимодействующий с Milvus Lite, также может работать с экземплярами Milvus в других режимах развертывания.
Чтобы интегрировать Milvus Lite в свои приложения, выполните команду ` pip install pymilvus ` для его установки и используйте оператор ` MilvusClient("./demo.db") ` для создания экземпляра векторной базы данных с локальным файлом, в котором сохраняются все ваши данные. Более подробную информацию см. в разделе «Запуск Milvus Lite».
Milvus Standalone
Milvus Standalone — это развёртывание сервера на одной машине. Все компоненты Milvus Standalone упакованы в один образ Docker, что упрощает развёртывание. Если у вас есть рабочая нагрузка в производственной среде, но вы предпочитаете не использовать Kubernetes, хорошим вариантом будет запуск Milvus Standalone на одной машине с достаточным объемом памяти. По умолчанию Milvus Standalone использует Woodpecker (встроенный) в качестве очереди сообщений, поэтому нет необходимости в отдельном сервисе обмена сообщениями.
Milvus Distributed
Milvus Distributed можно развернуть в кластерах Kubernetes. Это решение отличается облачной архитектурой, в которой нагрузка на прием данных и поисковые запросы обрабатываются отдельно изолированными узлами, что обеспечивает избыточность критически важных компонентов. Оно обеспечивает максимальную масштабируемость и доступность, а также гибкость в настройке выделенных ресурсов для каждого компонента. Milvus Distributed — лучший выбор для корпоративных пользователей, эксплуатирующих крупномасштабные системы векторного поиска в производственной среде. По умолчанию Milvus Distributed использует Woodpecker в качестве очереди сообщений, развернутой в виде отдельного сервиса наряду с Milvus.
Выберите подходящий режим развертывания для вашего сценария использования
Выбор режима развертывания, как правило, зависит от этапа разработки вашего приложения:
Для быстрого прототипирования
Если вы хотите быстро создать что-то в качестве прототипа или в учебных целях, например, демонстрации технологии Retrieval Augmented Generation (RAG), ИИ-чат-ботов, мультимодального поиска, вам подойдет как Milvus Lite, так и комбинация Milvus Lite и Milvus Standalone. Вы можете использовать Milvus Lite в ноутбуках для быстрого прототипирования и изучения различных подходов, таких как разные стратегии разбиения на фрагменты в RAG. Возможно, вам захочется развернуть приложение, созданное с помощью Milvus Lite, в небольшой производственной среде для обслуживания реальных пользователей или для проверки идеи на более крупных наборах данных, например, содержащих более нескольких миллионов векторов. В этом случае подходит Milvus Standalone. Логику приложения для Milvus Lite по-прежнему можно использовать совместно, так как все развертывания Milvus имеют одинаковый клиентский API. Данные, хранящиеся в Milvus Lite, также можно перенести в Milvus Standalone с помощью инструмента командной строки.
Развертывание в небольшой производственной среде
Для ранних этапов производственного развертывания, когда проект все еще находится в поиске соответствия продукта рынку и гибкость важнее масштабируемости, Milvus Standalone является лучшим выбором. При наличии достаточных вычислительных ресурсов он может масштабироваться до 100 млн векторов, при этом требуя гораздо меньших затрат на DevOps, чем обслуживание кластера K8s.
Крупномасштабное производственное развертывание
По мере быстрого роста вашего бизнеса и превышения объема данных емкости одного сервера приходит время рассмотреть возможность использования Milvus Distributed. Вы можете продолжать использовать Milvus Standalone в среде разработки или тестирования из-за его удобства, а также управлять кластером K8s, на котором работает Milvus Distributed. Это позволит вам обрабатывать десятки миллиардов векторов, а также обеспечит гибкость в настройке размера узлов под конкретные рабочие нагрузки, такие как сценарии с высокой частотой чтения и редкой записью или с высокой частотой записи и низкой частотой чтения.
Локальный поиск на периферийных устройствах
Для поиска по конфиденциальным или чувствительным данным на периферийных устройствах вы можете развернуть Milvus Lite непосредственно на устройстве, не прибегая к облачным сервисам для текстового или изобразительного поиска. Это подходит для таких задач, как поиск по собственным документам или обнаружение объектов непосредственно на устройстве.
Выбор режима развертывания Milvus зависит от этапа и масштаба вашего проекта. Milvus предоставляет гибкое и мощное решение для различных задач — от быстрого прототипирования до крупномасштабного развертывания в корпоративной среде.
- Milvus Lite рекомендуется для небольших наборов данных, объём которых не превышает нескольких миллионов векторов.
- Milvus Standalone подходит для наборов данных среднего размера, масштабируемых до 100 миллионов векторов.
- Milvus Distributed предназначен для крупномасштабных развертываний и способен обрабатывать наборы данных от 100 миллионов до десятков миллиардов векторов.
Независимо от режима развертывания каждый экземпляр Milvus использует очередь сообщений, хранилище объектов и хранилище метаданных — по умолчанию Woodpecker, MinIO и etcd. Чтобы узнать об этих зависимостях, настроить их или подключить внешние сервисы, см. раздел «Инфраструктура данных».
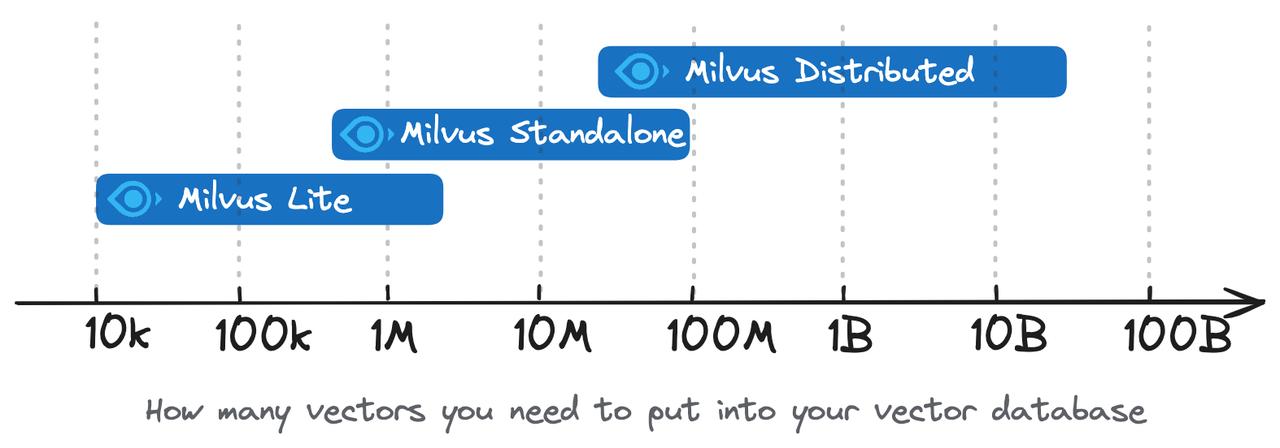 Выберите вариант развертывания, подходящий для вашего сценария использования
Сравнение функциональных возможностей
| Функция | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / Клиентская библиотека | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| Типы данных | Плотный вектор Редкий вектор Двоичный вектор Булево значение Целое число Число с плавающей запятой VarChar Массив JSON | Плотный вектор Редкий вектор Двоичный вектор Булево значение Целое число Число с плавающей запятой VarChar Массив JSON | Плотный вектор Редкий вектор Двоичный вектор Булево значение Целое число Число с плавающей запятой VarChar Массив JSON |
| Возможности поиска | Векторный поиск (поиск по ANN) Фильтрация по метаданным Поиск по диапазону Скалярный запрос Получение сущностей по первичному ключу Гибридный поиск | Векторный поиск (поиск с использованием ANN) Фильтрация по метаданным Поиск по диапазону Скалярный запрос Получение сущностей по первичному ключу Гибридный поиск | Векторный поиск (поиск по ANN) Фильтрация по метаданным Поиск по диапазону Скалярный запрос Получение сущностей по первичному ключу Гибридный поиск |
| Операции CRUD | ✔️ | ✔️ | ✔️ |
| Расширенное управление данными | Н/Д | Контроль доступа Раздел Ключ раздела | Управление доступом Раздел Ключ раздела Группировка физических ресурсов |
| Уровни согласованности | Сильный | Сильный Ограниченная устарелость Сессия Конечный | Сильный Ограниченная устарелость Сеансовый Конечный |
| Очередь сообщений | Не применимо | Woodpecker (встроенный) | Woodpecker (сервис) |
