

Объяснение понятия «индекс»
Индекс — это дополнительная структура, построенная поверх данных. Его внутренняя структура зависит от используемого алгоритма поиска ближайших соседей. Индекс ускоряет поиск, но требует дополнительного времени на предварительную обработку, а также занимает дополнительное пространство и объем оперативной памяти во время поиска. Кроме того, использование индекса, как правило, снижает коэффициент полноты (хотя этот эффект и незначителен, он все же имеет значение). Поэтому в этой статье объясняется, как минимизировать затраты на использование индекса и одновременно максимизировать его преимущества.
Обзор
В Milvus индексы привязаны к полям, и доступные типы индексов зависят от типов данных целевых полей. Как профессиональная векторная база данных, Milvus ориентирована на повышение как производительности векторного поиска, так и скалярной фильтрации, поэтому предлагает различные типы индексов.
В приведенной ниже таблице представлено соотношение между типами данных полей и применимыми типами индексов.
Тип данных поля |
Применимые типы индексов |
|---|---|
FLOAT_VECTOR |
|
|
|
BINARY_VECTOR |
|
SPARSE_FLOAT_VECTOR |
SPARSE_INVERTED_INDEX |
VARCHAR |
|
BOOL |
|
|
|
|
INVERTED |
ARRAY (элементы типов BOOL, INT8/16/32/64 и VARCHAR) |
BITMAP (рекомендуется) |
ARRAY (элементы типов BOOL, INT8/16/32/64, FLOAT, DOUBLE и VARCHAR) |
ПЕРЕВЕРНУТЫЙ |
JSON |
INVERTED |
В данной статье рассматривается, как выбрать подходящие векторные индексы. Для скалярных полей всегда можно использовать рекомендуемый тип индекса.
Выбор подходящего типа индекса для векторного поиска может существенно повлиять на производительность и использование ресурсов. При выборе типа индекса для векторного поля необходимо учитывать различные факторы, включая базовую структуру данных, использование памяти и требования к производительности.
Структура векторного индекса
Как показано на приведенной ниже схеме, тип индекса в Milvus состоит из трех основных компонентов: структуры данных, квантования и рефинера. Квантование и рефинер являются опциональными, но широко используются благодаря значительному соотношению выгоды к затратам.
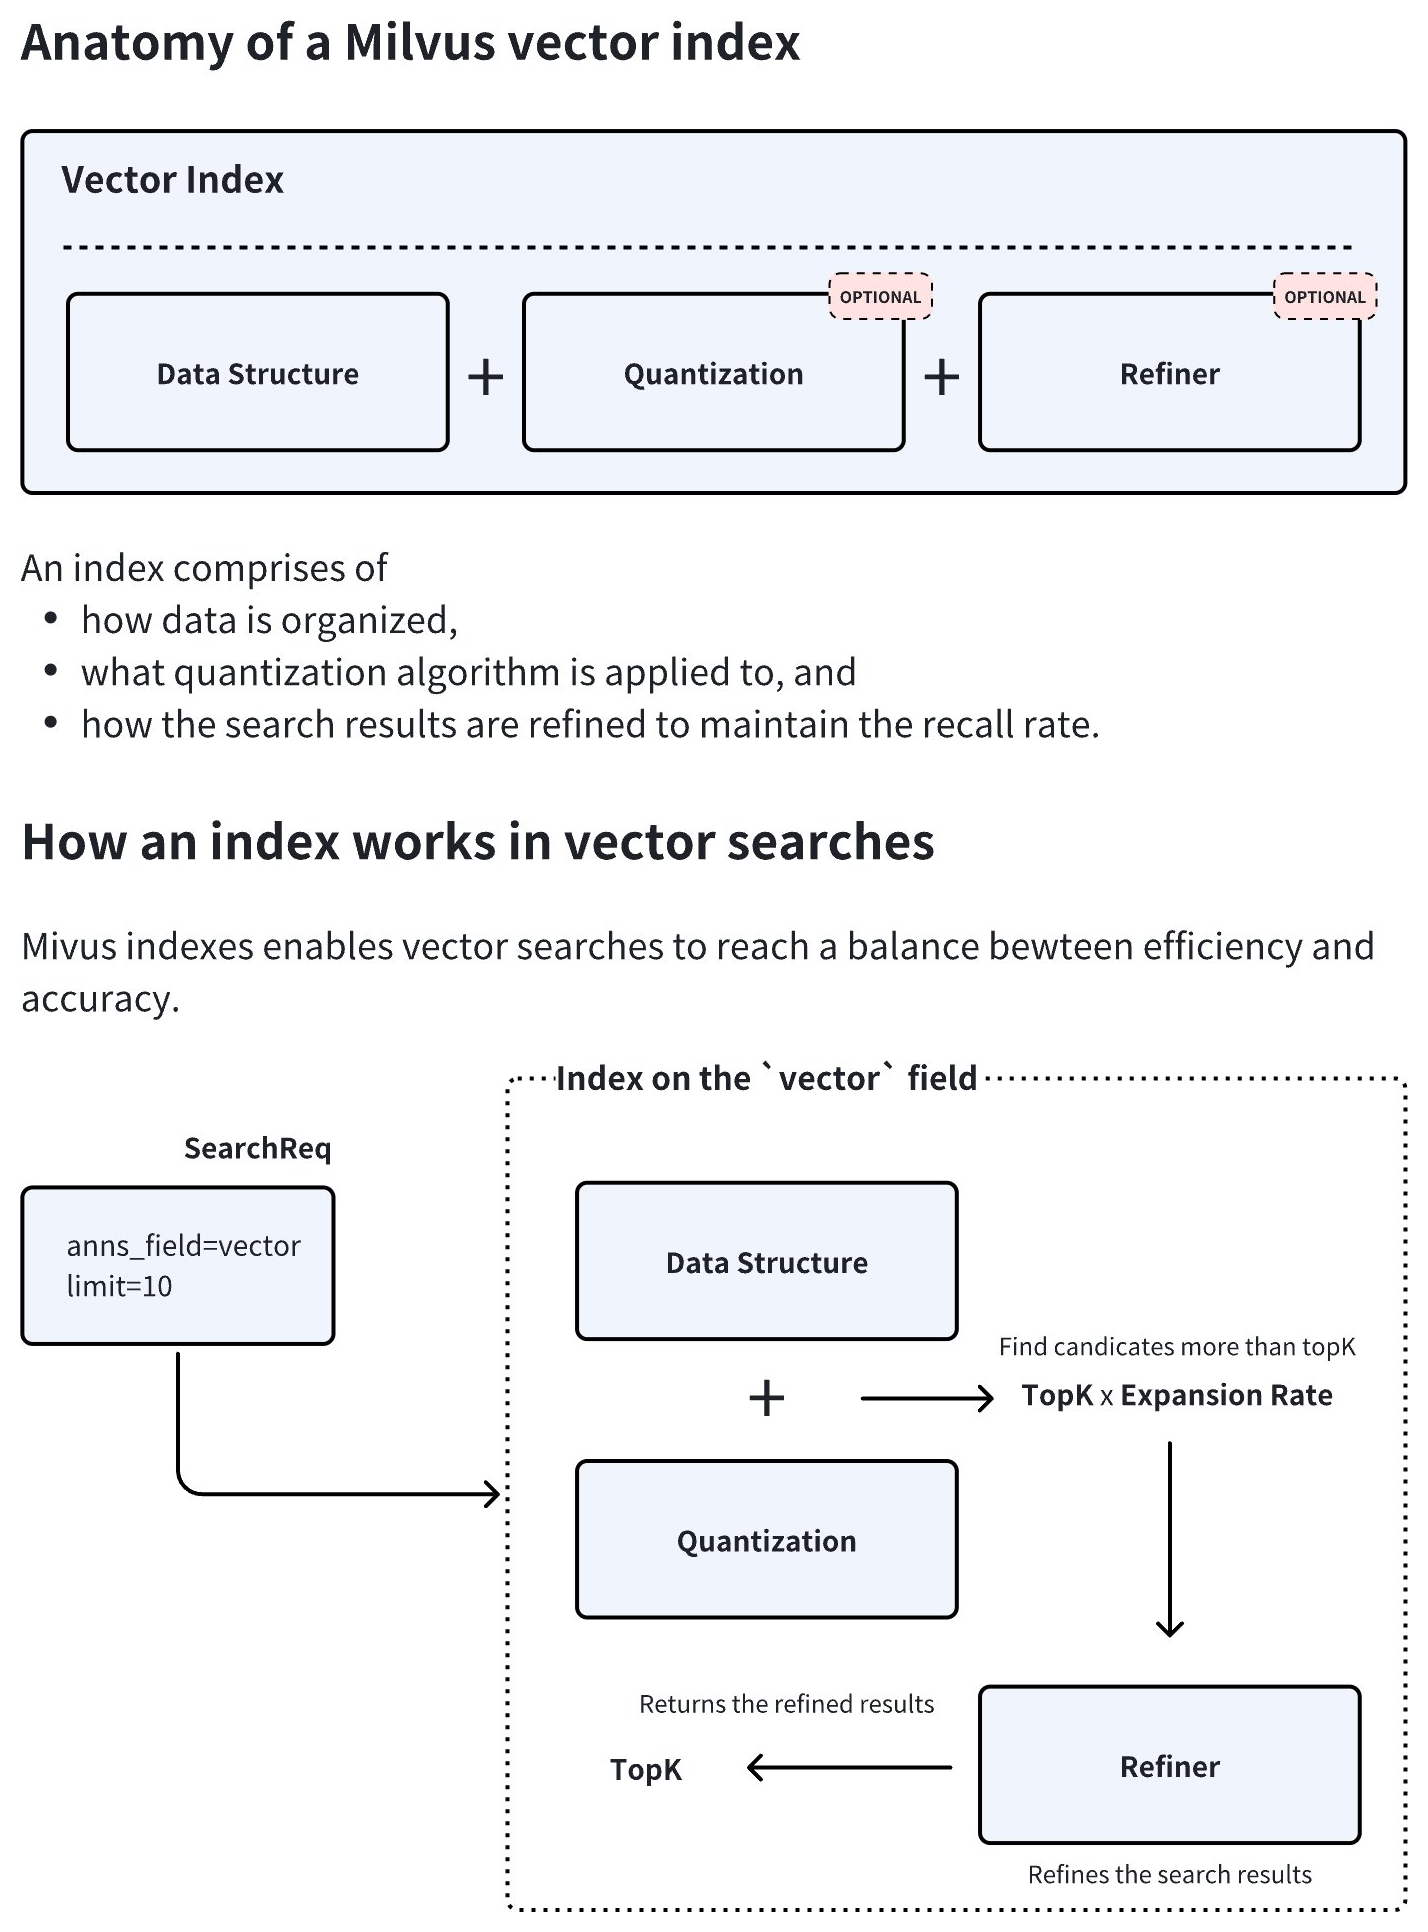 Структура векторного индекса
При создании индекса Milvus комбинирует выбранную структуру данных и метод квантования для определения оптимального коэффициента расширения. Во время выполнения запроса система извлекает topK × expansion rate векторы-кандидаты, применяет рефайнер для пересчёта расстояний с более высокой точностью и, наконец, возвращает наиболее точные topK результаты. Этот гибридный подход обеспечивает баланс между скоростью и точностью, ограничивая ресурсоёмкое уточнение отфильтрованным подмножеством кандидатов.
Структура данных
Структура данных составляет базовый уровень индекса. К распространённым типам относятся:
Инвертированный файл (IVF)
Типы индексов серии IVF позволяют Milvus группировать векторы в корзины посредством разбиения на основе центроидов. Как правило, можно с уверенностью предположить, что все векторы в корзине, скорее всего, будут близки к вектору запроса, если центроид корзины близок к вектору запроса. Исходя из этого предположения, Milvus сканирует только векторные вложения в тех сегментах, центроиды которых находятся рядом с вектором запроса, вместо того чтобы просматривать весь набор данных. Эта стратегия снижает вычислительные затраты, сохраняя при этом приемлемую точность.
Такой тип структуры данных индекса идеально подходит для крупномасштабных наборов данных, требующих высокой пропускной способности.
Графовая структура
Графовая структура данных для векторного поиска, такая как Hierarchical Navigable Small World (HNSW), строит многоуровневый граф, в котором каждый вектор соединяется со своими ближайшими соседями. Запросы перемещаются по этой иерархии, начиная с верхних уровней с более крупной сеткой и переходя на нижние уровни, что обеспечивает эффективную сложность поиска, равную логарифму времени.
Этот тип индексной структуры данных отлично подходит для высокоразмерных пространств и сценариев, требующих запросов с низкой задержкой.
Квантование
Квантование сокращает объем занимаемой памяти и вычислительные затраты за счет более грубого представления:
Скалярная квантование (например, SQ8) позволяет Milvus сжимать каждое измерение вектора до одного байта (8 бит), сокращая использование памяти на 75 % по сравнению с 32-битными числами с плавающей запятой при сохранении приемлемой точности.
Продуктное квантование (PQ) позволяет Milvus разбивать векторы на подвекторы и кодировать их с помощью кластеризации на основе кодовой книги. Это обеспечивает более высокие коэффициенты сжатия (например, 4–32x) за счет незначительного снижения полноты поиска, что делает его подходящим для сред с ограниченным объемом памяти.
Рефинер
Квантование по своей сути сопровождается потерями. Чтобы сохранить коэффициент воспроизведения, квантование последовательно генерирует больше кандидатов из топ-K, чем необходимо, что позволяет рефинерам использовать более высокую точность для дальнейшего отбора результатов из топ-K из числа этих кандидатов, повышая таким образом коэффициент воспроизведения.
Например, рефайнер FP32 работает с кандидатами в результатах поиска, возвращаемыми квантованием, пересчитывая расстояния с точностью FP32 вместо квантованных значений.
Это имеет решающее значение для приложений, требующих компромисса между эффективностью поиска и точностью, таких как семантический поиск или системы рекомендаций, где незначительные изменения расстояний существенно влияют на качество результатов.
Резюме
Эта многоуровневая архитектура — грубая фильтрация с помощью структур данных, эффективные вычисления за счет квантования и настройка точности посредством уточнения — позволяет Milvus адаптивно оптимизировать компромисс между точностью и производительностью.
Компромиссы в производительности
При оценке производительности крайне важно соблюдать баланс между временем сборки, количеством запросов в секунду (QPS) и коэффициентом охватываемости. Общие правила следующие:
Типы индексов на основе графов обычно превосходят варианты IVF по показателю QPS.
Варианты IVF особенно подходят для сценариев с большим значением topK (например, более 2 000).
PQ, как правило, обеспечивает лучший коэффициент восстановления при аналогичных коэффициентах сжатия по сравнению с SQ, хотя последний демонстрирует более высокую производительность.
Использование жестких дисков для части индекса (как в DiskANN) помогает управлять большими наборами данных, но также создает потенциальные узкие места по IOPS.
Емкость
Емкость обычно определяется соотношением между объемом данных и доступной оперативной памятью. При рассмотрении вопроса о емкости учитывайте следующее:
Если четверть ваших исходных данных помещается в память, рассмотрите возможность использования DiskANN из-за его стабильной задержки.
Если все исходные данные помещаются в память, рассмотрите возможность использования типов индексов на основе памяти и mmap.
Вы можете использовать типы индексов с применением квантования и mmap, чтобы пожертвовать точностью ради максимальной емкости.
Mmap не всегда является оптимальным решением. Если большая часть данных хранится на диске, DiskANN обеспечивает лучшую задержку.
Показатель восстановления
Показатель «recall» обычно зависит от коэффициента фильтрации, который относится к данным, отфильтрованным перед поиском. При работе с показателем «recall» учитывайте следующее:
Если коэффициент фильтрации составляет менее 85%, индексные типы на основе графов превосходят варианты IVF.
Если коэффициент фильтрации составляет от 85% до 95%, используйте варианты IVF.
Если коэффициент фильтрации превышает 98%, используйте метод Brute-Force (FLAT) для получения наиболее точных результатов поиска.
Вышеуказанные рекомендации не всегда верны. Рекомендуется настроить коэффициент восстановления с использованием различных типов индексов, чтобы определить, какой из них работает лучше всего.
Производительность
Производительность поиска обычно определяется показателем «top-K», который обозначает количество записей, возвращаемых в результате поиска. При оценке производительности учитывайте следующее:
Для поиска с небольшим top-K (например, 2 000), требующего высокого коэффициента полноты, типы индексов на основе графов превосходят варианты IVF.
Для поиска с большим значением top-K (по сравнению с общим количеством векторных вложений) варианты IVF являются лучшим выбором, чем типы индексов на основе графов.
Для поиска со средним значением top-K и высоким коэффициентом фильтрации варианты IVF являются более подходящим выбором.
Матрица принятия решений: выбор наиболее подходящего типа индекса
Приведенная ниже таблица представляет собой матрицу принятия решений, к которой вы можете обратиться при выборе подходящего типа индекса.
Сценарий |
Рекомендуемый индекс |
Примечания |
|---|---|---|
Объем исходных данных помещается в память |
HNSW, IVF + уточнение |
Используйте HNSW для низкого показателя « |
Исходные данные на диске, SSD |
DiskANN |
Оптимально для запросов, чувствительных к задержке. |
Исходные данные на диске, ограниченный объем ОЗУ |
IVFPQ/SQ + mmap |
Обеспечивает баланс между доступом к памяти и к диску. |
Высокий коэффициент фильтрации (>95 %) |
Метод перебора (FLAT) |
Избегает накладных расходов на индекс при работе с очень небольшими наборами кандидатов. |
Большой набор кандидатов ( |
IVF |
Обрезка кластеров сокращает вычислительную нагрузку. |
Чрезвычайно высокий коэффициент охвата (>99%) |
Метод перебора (FLAT) + графические процессоры |
-- |
Оценка использования памяти
В этом разделе основное внимание уделяется расчету объема памяти, потребляемого конкретным типом индекса, и приводится множество технических деталей. Вы можете смело пропустить этот раздел, если он не соответствует вашим интересам.
На объем памяти, занимаемый индексом, влияют его структура данных, степень сжатия за счет квантования и используемый рефайнер. В целом, индексы на основе графов обычно занимают больше памяти из-за структуры графа (например, HNSW), что, как правило, влечет за собой заметные накладные расходы на векторное пространство. Напротив, IVF и его варианты более эффективны с точки зрения использования памяти, поскольку накладные расходы на векторное пространство в них меньше. Однако передовые методы, такие как DiskANN, позволяют размещать части индекса, например граф или рефайнер, на диске, что снижает нагрузку на память при сохранении производительности.
В частности, объем памяти, занимаемый индексом, можно рассчитать следующим образом:
Использование памяти индексом IVF
Индексы IVF обеспечивают баланс между эффективностью использования памяти и производительностью поиска за счет разбиения данных на кластеры. Ниже приведена разбивка объёма памяти, используемого 1 миллионом 128-мерных векторов, индексированных с использованием вариантов IVF.
Расчет объема памяти, занимаемого центроидами.
Типы индексов серии IVF позволяют Milvus группировать векторы в корзины с помощью разбиения на основе центроидов. Каждый центроид включается в индекс в виде исходного векторного вложения. При разделении векторов на 2 000 кластеров объем используемой памяти можно рассчитать следующим образом:
2,000 clusters × 128 dimensions × 4 bytes = 1.0 MBРассчитайте объем памяти, используемый для присвоения кластеров.
Каждое вложение вектора присваивается кластеру и хранится в виде целочисленных идентификаторов. Для 2 000 кластеров достаточно 2-байтового целого числа. Объем используемой памяти можно рассчитать следующим образом:
1,000,000 vectors × 2 bytes = 2.0 MBРассчитаем степень сжатия, обусловленную квантованием.
Варианты IVF обычно используют PQ и SQ8, и объем используемой памяти можно оценить следующим образом:
Использование PQ с 8 субквантователями
1,000,000 vectors × 8 bytes = 8.0 MBПри использовании SQ8
1,000,000 vectors × 128 dimensions × 1 byte = 128 MB
В следующей таблице приведены расчетные значения объёма занимаемой памяти для различных конфигураций:
Конфигурация
Расчет объема памяти
Объем памяти
IVF-PQ (без уточнения)
1,0 МБ + 2,0 МБ + 8,0 МБ
11,0 МБ
IVF-PQ + 10 % уточнений исходных данных
1,0 МБ + 2,0 МБ + 8,0 МБ + 51,2 МБ
62,2 МБ
IVF-SQ8 (без уточнения)
1,0 МБ + 2,0 МБ + 128 МБ
131,0 МБ
IVF-FLAT (полные исходные векторы)
1,0 МБ + 2,0 МБ + 512 МБ
515,0 МБ
Рассчитайте накладные расходы на уточнение.
Варианты IVF часто используются в паре с рефайнером для повторного ранжирования кандидатов. Для поиска, возвращающего 10 лучших результатов с коэффициентом расширения 5, накладные расходы на уточнение можно оценить следующим образом:
10 (topK) x 5 (expansion rate) = 50 candidates
50 candidates x 128 dimensions x 4 bytes = 25.6 KB
Использование памяти индекса на основе графа
Типы индексов на основе графов, такие как HNSW, требуют значительного объема памяти для хранения как структуры графа, так и исходных векторных вложений. Ниже приведена подробная разбивка объема памяти, занимаемого 1 миллионом 128-мерных векторов, проиндексированных с использованием типа индекса HNSW.
Рассчитаем объем памяти, занимаемый структурой графа.
Каждый вектор в HNSW поддерживает связи со своими соседями. При степени графа (количестве ребер на узел) равной 32 объем занимаемой памяти можно рассчитать следующим образом:
1,000,000 vectors × 32 links × 4 bytes (for 32-bit integer storage) = 128 MBРассчитаем объем памяти, занимаемый исходными векторными вложениями.
Объем памяти, занимаемый хранением несжатых векторов FP32, можно рассчитать следующим образом:
1,000,000 vectors × 128 dimensions × 4 bytes = 512 MBПри использовании HNSW для индексирования 1 миллиона 128-мерных векторных вложений общий объем используемой памяти составит 128 МБ (граф) + 512 МБ (векторы) = 640 МБ.
Рассчитаем степень сжатия, достигаемую за счет квантования.
Квантование уменьшает размер векторов. Например, использование PQ с 8 субквантователями (8 байт на вектор) приводит к значительной степени сжатия. Объем памяти, занимаемый сжатыми векторными вложениями, можно рассчитать следующим образом:
1,000,000 vectors × 8 bytes = 8 MBЭто обеспечивает 64-кратный коэффициент сжатия по сравнению с исходными векторными вложениями, и общий объем памяти, используемый типом индекса HNSWPQ, составит 128 МБ (граф) + 8 МБ (сжатый вектор) = 136 МБ.
Рассчитайте накладные расходы на уточнение.
Процессы уточнения, такие как повторное ранжирование с использованием исходных векторов, приводят к временной загрузке высокоточных данных в память. Для поиска, возвращающего 10 лучших результатов с коэффициентом расширения 5, накладные расходы на уточнение можно оценить следующим образом:
10 (topK) x 5 (expansion rate) = 50 candidates
50 candidates x 128 dimensions x 4 bytes = 25.6 KB
Другие соображения
В то время как индексы IVF и графовые индексы оптимизируют использование памяти за счет квантования, файлы с отображением в память (mmap) и DiskANN предназначены для сценариев, в которых объемы наборов данных превышают доступный объем оперативной памяти (RAM).
DiskANN
DiskANN — это индекс на основе графа Vamana, который связывает точки данных для эффективной навигации во время поиска, одновременно применяя квантование (PQ) для уменьшения размера векторов и обеспечения быстрого приближенного вычисления расстояний между векторами.
Граф Vamana хранится на диске, что позволяет DiskANN обрабатывать большие наборы данных, которые в противном случае были бы слишком большими, чтобы поместиться в памяти. Это особенно полезно для наборов данных, содержащих миллиарды точек.
Файлы с отображением в память (mmap)
Отображение в память (mmap) обеспечивает прямой доступ к памяти для больших файлов на диске, позволяя Milvus хранить индексы и данные как в памяти, так и на жестких дисках. Такой подход помогает оптимизировать операции ввода-вывода за счет снижения накладных расходов на вызовы ввода-вывода в зависимости от частоты доступа, тем самым расширяя емкость хранилища для коллекций без существенного ухудшения производительности поиска.
В частности, вы можете настроить Milvus так, чтобы он выполнял отображение в память необработанных данных в определённых полях вместо их полной загрузки в память. Таким образом, вы получаете прямой доступ к полям из памяти, не беспокоясь о проблемах с памятью, и расширяете ёмкость коллекции.
