

Visão geral das opções de implementação do Milvus
O Milvus é uma base de dados vetorial altamente performante e escalável. Suporta casos de utilização de uma ampla variedade de dimensões, desde demonstrações executadas localmente no Jupyter Notebooks até clusters de Kubernetes em grande escala que processam dezenas de milhares de milhões de vetores. Atualmente, existem três opções de implementação do Milvus: Milvus Lite, Milvus Standalone e Milvus Distributed.
Milvus Lite
O Milvus Lite é uma biblioteca Python que pode ser importada para as suas aplicações. Sendo uma versão leve do Milvus, é ideal para prototipagem rápida em Jupyter Notebooks ou para execução em dispositivos inteligentes com recursos limitados. O Milvus Lite suporta as mesmas APIs que outras implementações do Milvus. O código do lado do cliente que interage com o Milvus Lite também pode funcionar com instâncias do Milvus noutros modos de implementação.
Para integrar o Milvus Lite nas suas aplicações, execute « pip install pymilvus » para o instalar e utilize a instrução « MilvusClient("./demo.db") » para instanciar uma base de dados vetorial com um ficheiro local que armazena todos os seus dados. Para mais detalhes, consulte «Executar o Milvus Lite».
Milvus Standalone
O Milvus Standalone é uma implementação de servidor numa única máquina. Todos os componentes do Milvus Standalone estão reunidos numa única imagem Docker, o que facilita a implementação. Se tiver uma carga de trabalho de produção, mas preferir não utilizar o Kubernetes, executar o Milvus Standalone numa única máquina com memória suficiente é uma boa opção. Por predefinição, o Milvus Standalone executa o Woodpecker (incorporado) como a sua fila de mensagens, pelo que não é necessário operar um serviço de mensagens separado.
Milvus Distributed
O Milvus Distributed pode ser implementado em clusters do Kubernetes. Esta implementação apresenta uma arquitetura nativa da nuvem, na qual a carga de ingestão e as consultas de pesquisa são tratadas separadamente por nós isolados, permitindo redundância para componentes críticos. Oferece a máxima escalabilidade e disponibilidade, bem como flexibilidade na personalização dos recursos alocados em cada componente. O Milvus Distributed é a melhor escolha para utilizadores empresariais que executam sistemas de pesquisa vetorial em grande escala em produção. Por predefinição, o Milvus Distributed utiliza o Woodpecker como fila de mensagens, implementado como um serviço dedicado a par do Milvus.
Escolha a implantação certa para o seu caso de utilização
A seleção de um modo de implementação depende normalmente da fase de desenvolvimento da sua aplicação:
Para prototipagem rápida
Se pretender criar rapidamente algo como protótipo ou para fins de aprendizagem, como demonstrações de Retrieval Augmented Generation (RAG), chatbots de IA, pesquisa multimodal, o próprio Milvus Lite ou uma combinação do Milvus Lite com o Milvus Standalone é adequado. Pode utilizar o Milvus Lite em notebooks para prototipagem rápida e explorar várias abordagens, tais como diferentes estratégias de segmentação no RAG. Poderá querer implementar a aplicação criada com o Milvus Lite numa produção em pequena escala para servir utilizadores reais, ou validar a ideia em conjuntos de dados maiores, por exemplo, com mais do que alguns milhões de vetores. Nesse caso, o Milvus Standalone é a opção adequada. A lógica da aplicação para o Milvus Lite pode continuar a ser partilhada, uma vez que todas as implementações do Milvus têm a mesma API do lado do cliente. Os dados armazenados no Milvus Lite também podem ser transferidos para o Milvus Standalone através de uma ferramenta de linha de comandos.
Implementação em produção em pequena escala
Para a fase inicial de produção, quando o projeto ainda está à procura do ajuste produto-mercado e a agilidade é mais importante do que a escalabilidade, o Milvus Standalone é a melhor escolha. Pode ainda escalar até 100 milhões de vetores, desde que haja recursos de máquina suficientes, ao mesmo tempo que requer muito menos DevOps do que a manutenção de um cluster K8s.
Implementação em produção em grande escala
À medida que o seu negócio cresce rapidamente e a escala de dados excede a capacidade de um único servidor, é altura de considerar o Milvus Distributed. Pode continuar a utilizar o Milvus Standalone para ambientes de desenvolvimento ou de teste, devido à sua conveniência, e operar o cluster K8s que executa o Milvus Distributed. Isto permite-lhe atingir dezenas de milhares de milhões de vetores, além de proporcionar flexibilidade na adaptação do tamanho dos nós à sua carga de trabalho específica, como casos de elevada leitura e gravação pouco frequente ou de elevada gravação e baixa leitura.
Pesquisa local em dispositivos de borda
Para efetuar pesquisas em dispositivos de borda que contenham dados privados ou sensíveis, pode implementar o Milvus Lite no próprio dispositivo sem depender de um serviço baseado na nuvem para realizar pesquisas de texto ou imagens. Esta solução é adequada para casos como a pesquisa de documentos proprietários ou a deteção de objetos no próprio dispositivo.
A escolha do modo de implementação do Milvus depende da fase e da escala do seu projeto. O Milvus oferece uma solução flexível e poderosa para diversas necessidades, desde a prototipagem rápida até à implementação empresarial em grande escala.
- O Milvus Lite é recomendado para conjuntos de dados mais pequenos, até alguns milhões de vetores.
- O Milvus Standalone é adequado para conjuntos de dados de tamanho médio, com capacidade para até 100 milhões de vetores.
- O Milvus Distributed foi concebido para implementações em grande escala, sendo capaz de lidar com conjuntos de dados de 100 milhões até dezenas de milhares de milhões de vetores.
Independentemente do modo de implementação, todas as instâncias do Milvus dependem de uma fila de mensagens, de um armazenamento de objetos e de um repositório de metadados — por predefinição, o Woodpecker, o MinIO e o etcd. Para saber mais sobre estas dependências, ajustá-las ou ligar serviços externos, consulte Infraestrutura de Dados.
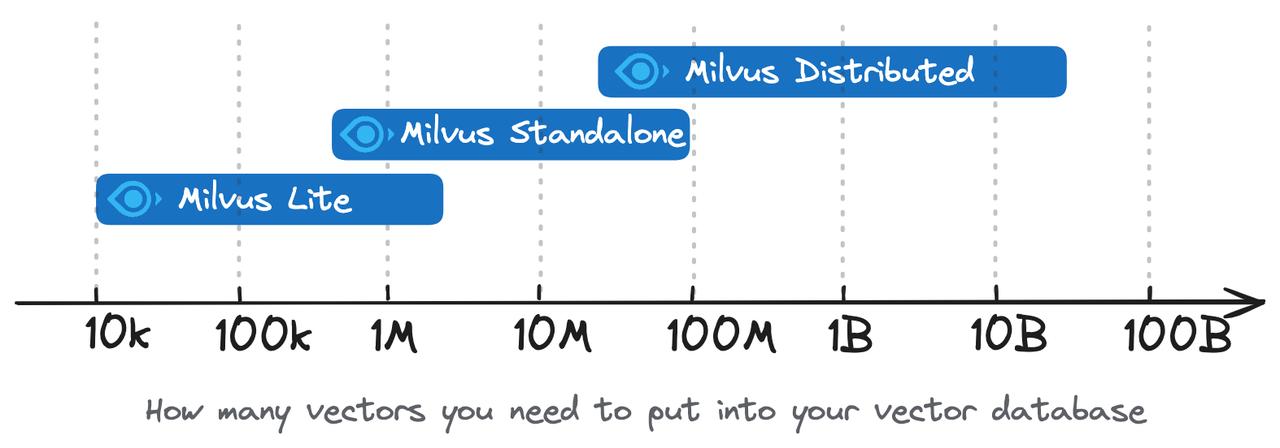 Selecione a opção de implementação adequada ao seu caso de utilização
Comparação de funcionalidades
| Funcionalidade | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / Biblioteca do cliente | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| Tipos de dados | Vetor denso Vetor esparso Vetor binário Booleano Inteiro Ponto flutuante VarChar Matriz JSON | Vetor denso Vetor esparso Vetor binário Booleano Inteiro Ponto flutuante VarChar Matriz JSON | Vetor denso Vetor esparso Vetor binário Booleano Inteiro Ponto flutuante VarChar Matriz JSON |
| Funcionalidades de pesquisa | Pesquisa vetorial (Pesquisa ANN) Filtragem por metadados Pesquisa por intervalo Consulta escalar Obter entidades pela chave primária Pesquisa híbrida | Pesquisa vetorial (Pesquisa ANN) Filtragem de metadados Pesquisa por intervalo Consulta escalar Obter entidades pela chave primária Pesquisa híbrida | Pesquisa vetorial (Pesquisa ANN) Filtragem de metadados Pesquisa por intervalo Consulta escalar Obter entidades pela chave primária Pesquisa híbrida |
| Operações CRUD | ✔️ | ✔️ | ✔️ |
| Gestão avançada de dados | N/A | Partição de controlo de acesso Partição de Chave de partição | Partição de controlo de acesso Chave de partição Agrupamento de recursos físicos |
| Níveis de consistência | Forte | Forte Desatualização limitada Sessão Eventual | Forte Desatualização limitada Sessão Eventual |
| Fila de mensagens | N/A | Woodpecker (incorporado) | Woodpecker (serviço) |
