

Milvus 배포 옵션 개요
Milvus는 고성능의 확장 가능한 벡터 데이터베이스입니다. Jupyter Notebook에서 로컬로 실행되는 데모부터 수백억 개의 벡터를 처리하는 대규모 Kubernetes 클러스터에 이르기까지, 다양한 규모의 사용 사례를 지원합니다. 현재 Milvus에는 Milvus Lite, Milvus Standalone, Milvus Distributed의 세 가지 배포 옵션이 있습니다.
Milvus Lite
Milvus Lite는 애플리케이션에 임포트할 수 있는 Python 라이브러리입니다. Milvus의 경량 버전으로서, Jupyter Notebook에서 신속한 프로토타이핑을 수행하거나 리소스가 제한된 스마트 기기에서 실행하는 데 이상적입니다. Milvus Lite는 다른 Milvus 배포 방식과 동일한 API를 지원합니다. Milvus Lite와 상호작용하는 클라이언트 측 코드는 다른 배포 모드의 Milvus 인스턴스에서도 작동할 수 있습니다.
Milvus Lite를 애플리케이션에 통합하려면 ` pip install pymilvus `를 실행하여 설치하고, ` MilvusClient("./demo.db") ` 문을 사용하여 모든 데이터를 영구적으로 저장하는 로컬 파일을 기반으로 벡터 데이터베이스를 인스턴스화하십시오. 자세한 내용은 Milvus Lite 실행을 참조하십시오.
Milvus Standalone
Milvus Standalone은 단일 머신 서버 배포 방식입니다. Milvus Standalone의 모든 구성 요소가 단일 Docker 이미지에 포함되어 있어 배포가 편리합니다. 프로덕션 워크로드를 처리해야 하지만 쿠버네티스를 사용하지 않으려는 경우, 충분한 메모리를 갖춘 단일 머신에서 Milvus Standalone을 실행하는 것이 좋은 선택입니다. 기본적으로 Milvus Standalone은 메시지 큐로 Woodpecker (임베디드)를 사용하므로 별도의 메시징 서비스를 운영할 필요가 없습니다.
Milvus Distributed
Milvus Distributed는 쿠버네티스 클러스터에 배포할 수 있습니다. 이 배포 방식은 클라우드 네이티브 아키텍처를 특징으로 하며, 데이터 수집 부하와 검색 쿼리가 격리된 노드에서 각각 처리되므로 핵심 구성 요소에 대한 중복성을 확보할 수 있습니다. 또한 최고의 확장성과 가용성을 제공할 뿐만 아니라, 각 구성 요소에 할당된 리소스를 유연하게 맞춤 설정할 수 있습니다. Milvus Distributed는 프로덕션 환경에서 대규모 벡터 검색 시스템을 운영하는 기업 사용자에게 최적의 선택입니다. 기본적으로 Milvus Distributed는 Woodpecker를 메시지 큐로 사용하며, 이는 Milvus와 함께 전용 서비스로 배포됩니다.
사용 사례에 적합한 배포 방식 선택
배포 모드의 선택은 일반적으로 애플리케이션의 개발 단계에 따라 달라집니다:
신속한 프로토타이핑의 경우
RAG(Retrieval Augmented Generation) 데모, AI 챗봇, 다중 모달 검색 등과 같이 프로토타입을 빠르게 구축하거나 학습 목적으로 활용하려는 경우, Milvus Lite 단독 또는 Milvus Lite와 Milvus Standalone의 조합이 적합합니다. 노트북에서 Milvus Lite를 사용하여 신속한 프로토타이핑을 진행하고, RAG의 다양한 청킹 전략과 같은 여러 접근 방식을 탐색할 수 있습니다. Milvus Lite로 구축한 애플리케이션을 소규모 프로덕션 환경에 배포하여 실제 사용자에게 서비스를 제공하거나, 수백만 개 이상의 벡터로 구성된 대규모 데이터셋에서 아이디어를 검증하고자 할 경우 Milvus Standalone이 적합합니다. 모든 Milvus 배포 환경은 동일한 클라이언트 측 API를 사용하므로, Milvus Lite용 애플리케이션 로직은 그대로 공유할 수 있습니다. 또한 Milvus Lite에 저장된 데이터는 명령줄 도구를 사용하여 Milvus Standalone으로 이관할 수 있습니다.
소규모 프로덕션 배포
프로젝트가 아직 제품-시장 적합성을 모색 중이고 확장성보다 민첩성이 더 중요한 초기 단계의 운영 환경에서는 Milvus Standalone이 최선의 선택입니다. 충분한 서버 리소스가 확보된다면 최대 1억 개의 벡터까지 확장할 수 있으며, K8s 클러스터를 유지 관리하는 데 비해 훨씬 적은 DevOps 작업만으로도 운영이 가능합니다.
대규모 프로덕션 배포
비즈니스가 급속히 성장하고 데이터 규모가 단일 서버의 용량을 초과하게 되면, Milvus Distributed를 고려해야 할 시점입니다. 편의성을 위해 개발 또는 스테이징 환경에서는 Milvus Standalone을 계속 사용하면서, Milvus Distributed를 실행하는 K8s 클러스터를 운영할 수 있습니다. 이를 통해 수백억 개의 벡터까지 처리할 수 있을 뿐만 아니라, 읽기 빈도가 높고 쓰기 빈도가 낮은 경우나 쓰기 빈도가 높고 읽기 빈도가 낮은 경우 등 특정 워크로드에 맞춰 노드 크기를 유연하게 조정할 수 있습니다.
엣지 디바이스에서의 로컬 검색
엣지 디바이스에서 비공개 또는 민감한 데이터를 검색해야 하는 경우, 클라우드 기반 서비스에 의존하지 않고 디바이스에 Milvus Lite를 배포하여 텍스트나 이미지 검색을 수행할 수 있습니다. 이는 독점 문서 검색이나 디바이스 내 객체 탐지 등의 경우에 적합합니다.
Milvus 배포 모드의 선택은 프로젝트의 단계와 규모에 따라 달라집니다. Milvus는 신속한 프로토타이핑부터 대규모 기업 배포에 이르기까지 다양한 요구 사항에 대응할 수 있는 유연하고 강력한 솔루션을 제공합니다.
- Milvus Lite는 최대 수백만 개의 벡터로 구성된 소규모 데이터셋에 권장됩니다.
- Milvus Standalone은 최대 1억 개의 벡터까지 확장 가능한 중규모 데이터셋에 적합합니다.
- Milvus Distributed는 대규모 배포를 위해 설계되었으며, 1억 개에서 수백억 개에 이르는 벡터 데이터셋을 처리할 수 있습니다.
배포 모드에 관계없이 모든 Milvus 인스턴스는 메시지 큐, 오브젝트 스토리지 및 메타데이터 저장소(기본적으로 Woodpecker, MinIO 및 etcd)에 의존합니다. 이러한 종속성에 대해 알아보거나, 이를 조정하거나, 외부 서비스를 연결하려면 데이터 인프라를 참조하십시오.
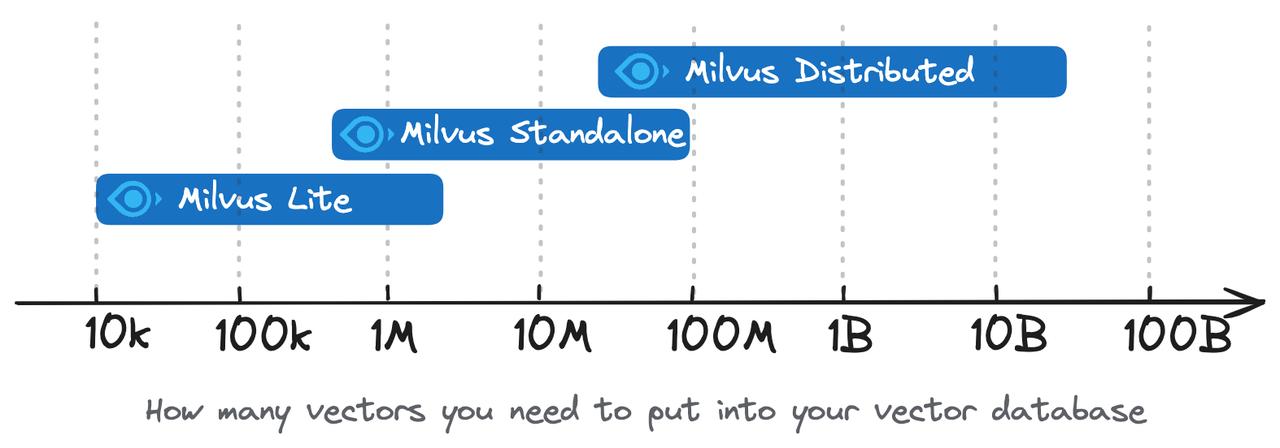 사용 사례에 맞는 배포 옵션 선택
기능 비교
| 기능 | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / 클라이언트 라이브러리 | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| 데이터 유형 | 밀집 벡터 희소 벡터 이진 벡터 부울 정수 부동 소수점 VarChar 배열 JSON | 밀집 벡터 희소 벡터 이진 벡터 부울 정수 부동 소수점 VarChar 배열 JSON | 밀집 벡터 희소 벡터 이진 벡터 부울 정수 부동 소수점 VarChar 배열 JSON |
| 검색 기능 | 벡터 검색(ANN 검색) 메타데이터 필터링 범위 검색 스칼라 쿼리 기본 키로 엔티티 가져오기 하이브리드 검색 | 벡터 검색 (ANN 검색) 메타데이터 필터링 범위 검색 스칼라 쿼리 기본 키를 통한 엔티티 가져오기 하이브리드 검색 | 벡터 검색 (ANN 검색) 메타데이터 필터링 범위 검색 스칼라 쿼리 기본 키를 통한 엔티티 가져오기 하이브리드 검색 |
| CRUD 작업 | ✔️ | ✔️ | ✔️ |
| 고급 데이터 관리 | 해당 없음 | 액세스 제어 파티션 파티션 키 | 액세스 제어 파티션 파티션 키 물리적 리소스 그룹화 |
| 일관성 수준 | 강력 | 강력 제한된 신선도 세션 최종 | 강력 제한된 비실시간성 세션 최종 |
| 메시지 큐 | 해당 없음 | Woodpecker (임베디드) | Woodpecker (서비스) |
