

Milvusの導入オプションの概要
Milvusは、高性能かつスケーラブルなベクトルデータベースです。Jupyter Notebook上でローカルに実行するデモから、数百億のベクトルを処理する大規模なKubernetesクラスターまで、幅広い規模のユースケースに対応しています。現在、Milvusには「Milvus Lite」、「Milvus Standalone」、「Milvus Distributed」の3つのデプロイメントオプションがあります。
Milvus Lite
Milvus Liteは、アプリケーションにインポートできるPythonライブラリです。Milvusの軽量版として、Jupyter Notebookでの迅速なプロトタイピングや、リソースが限られたスマートデバイス上での実行に最適です。 Milvus Liteは、他のMilvusデプロイメントと同じAPIをサポートしています。Milvus Liteと連携するクライアント側のコードは、他のデプロイメントモードのMilvusインスタンスでも動作します。
Milvus Liteをアプリケーションに統合するには、pip install pymilvus を実行してインストールし、MilvusClient("./demo.db") ステートメントを使用して、すべてのデータを永続化するローカルファイルを持つベクトルデータベースをインスタンス化します。詳細については、「Milvus Liteの実行」を参照してください。
Milvus Standalone
Milvus Standalone は、単一マシンでのサーバー展開です。Milvus Standalone のすべてのコンポーネントは単一のDocker イメージにパッケージ化されており、展開が容易です。 本番環境のワークロードがあるものの、Kubernetesの使用を避けたい場合は、十分なメモリを備えた単一のマシン上でMilvus Standaloneを実行するのが良い選択肢です。デフォルトでは、Milvus StandaloneはメッセージキューとしてWoodpecker(組み込み)を実行するため、別途メッセージングサービスを運用する必要はありません。
Milvus Distributed
Milvus Distributedは、Kubernetesクラスタ上にデプロイ可能です。このデプロイ方式はクラウドネイティブなアーキテクチャを採用しており、データ取り込み負荷と検索クエリが分離されたノードによって個別に処理されるため、重要なコンポーネントの冗長性を確保できます。最高のスケーラビリティと可用性を提供するとともに、各コンポーネントに割り当てるリソースを柔軟にカスタマイズすることも可能です。 Milvus Distributedは、本番環境で大規模なベクトル検索システムを運用するエンタープライズユーザーにとって最適な選択肢です。デフォルトでは、Milvus DistributedはメッセージキューとしてWoodpeckerを実行し、Milvusと並行して専用サービスとしてデプロイされます。
ユースケースに適したデプロイメントを選択する
デプロイモードの選択は、通常、アプリケーションの開発段階によって異なります:
迅速なプロトタイピングの場合
プロトタイプとして、あるいは学習目的で迅速に何かを構築したい場合(例:Retrieval Augmented Generation(RAG)のデモ、AIチャットボット、マルチモーダリティ検索など)、Milvus Lite単体、またはMilvus LiteとMilvus Standaloneの組み合わせが適しています。 Milvus Liteをノートブックで使用して迅速なプロトタイピングを行い、RAGにおけるさまざまなチャンキング戦略など、多様なアプローチを検証できます。Milvus Liteで構築したアプリケーションを小規模な本番環境でデプロイして実際のユーザーにサービスを提供したり、数百万ベクトルを超えるような大規模なデータセットでアイデアの検証を行いたい場合は、Milvus Standaloneが適しています。 すべてのMilvusデプロイメントはクライアント側のAPIが共通であるため、Milvus Liteのアプリケーションロジックは引き続き共有可能です。また、Milvus Liteに保存されたデータは、コマンドラインツールを使用してMilvus Standaloneに移行することもできます。
小規模な本番環境へのデプロイ
プロジェクトがまだプロダクト・マーケット・フィットを模索している初期段階の本番環境において、スケーラビリティよりも俊敏性が重視される場合は、Milvus Standaloneが最適な選択肢となります。十分なマシンリソースがあれば、最大1億ベクトルまでスケールアップが可能であり、K8sクラスターの維持管理に比べてDevOpsの負担も大幅に軽減されます。
大規模な本番環境への導入
ビジネスの急速な成長に伴い、データ規模が単一サーバーの容量を超えるようになったら、Milvus Distributedの導入を検討すべき時期です。開発環境やステージング環境では、利便性の高さから引き続きMilvus Standaloneを使用しつつ、Milvus Distributedを実行するK8sクラスターを運用することができます。 これにより、数百億ベクトル規模まで対応できるだけでなく、読み取りが頻繁で書き込みが稀なケースや、書き込みが頻繁で読み取りが稀なケースなど、特定のワークロードに合わせてノードサイズを柔軟に調整することも可能です。
エッジデバイスでのローカル検索
エッジデバイス上のプライベートなデータや機密情報を検索する場合、クラウドベースのサービスに依存することなく、デバイス上にMilvus Liteをデプロイしてテキストや画像の検索を行うことができます。これは、独自のドキュメント検索や、デバイス上での物体検出などのケースに適しています。
Milvusの導入モードの選択は、プロジェクトの段階や規模によって異なります。Milvusは、迅速なプロトタイピングから大規模なエンタープライズ導入まで、さまざまなニーズに対応する柔軟かつ強力なソリューションを提供します。
- Milvus Liteは、数百万ベクトルまでの小規模なデータセットに推奨されます。
- Milvus Standaloneは、最大1億ベクトルまで拡張可能な中規模のデータセットに適しています。
- Milvus Distributedは、1億から数百億ベクトル規模のデータセットを処理できる大規模な導入向けに設計されています。
導入モードにかかわらず、すべてのMilvusインスタンスは、メッセージキュー、オブジェクトストレージ、およびメタデータストア(デフォルトではWoodpecker、MinIO、etcd)に依存しています。これらの依存関係について確認したり、調整したり、外部サービスを接続したりするには、「データインフラストラクチャ」を参照してください。
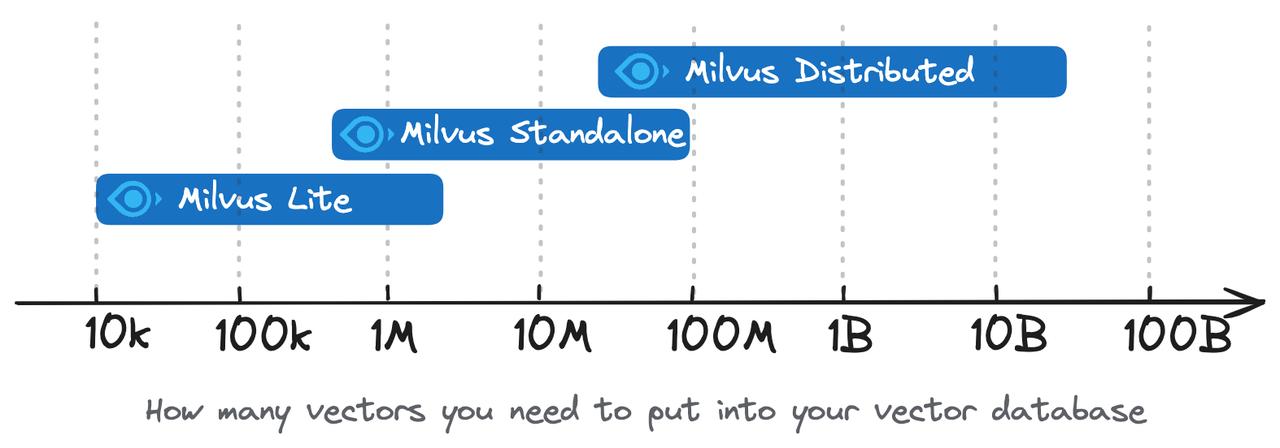 ユースケースに応じたデプロイオプションを選択してください
機能の比較
| 機能 | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / クライアントライブラリ | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| データ型 | 密ベクトル 疎ベクトル バイナリベクトル ブール値 整数 浮動小数点 VarChar 配列 JSON | 密ベクトル 疎ベクトル バイナリベクトル ブール値 整数 浮動小数点数 VarChar 配列 JSON | 密ベクトル 疎ベクトル バイナリベクトル ブール値 整数 浮動小数点数 VarChar 配列 JSON |
| 検索機能 | ベクトル検索(ANN 検索) メタデータフィルタリング 範囲検索 スカラークエリ 主キーによるエンティティの取得 ハイブリッド検索 | ベクトル検索(ANN検索) メタデータフィルタリング 範囲検索 スカラークエリ 主キーによるエンティティの取得 ハイブリッド検索 | ベクトル検索(ANN検索) メタデータフィルタリング 範囲検索 スカラークエリ 主キーによるエンティティの取得 ハイブリッド検索 |
| CRUD操作 | ✔️ | ✔️ | ✔️ |
| 高度なデータ管理 | 該当なし | アクセス制御 パーティション パーティションキー | アクセス制御 パーティション パーティションキー 物理リソースのグループ化 |
| 一貫性レベル | 強力 | Strong Bounded Staleness Session Eventual | Strong Bounded Staleness Session Eventual |
| メッセージキュー | 該当なし | Woodpecker (組み込み) | Woodpecker (サービス) |
