

Hugging Face RankerCompatible with Milvus v2.6.20+
La ricerca vettoriale ordina i risultati in base alla distanza vettoriale, ma l'ordine iniziale potrebbe non riflettere l'adeguatezza delle risposte fornite dal testo di ciascun candidato alla query. Hugging Face Ranker invia la query e il testo dei candidati ai provider di inferenza Hugging Face ospitati e utilizza i punteggi dell'sentence-similarity e per riordinare i candidati restituiti da Milvus.
Questa integrazione utilizza il router Hugging Face ospitato. Per effettuare una nuova classificazione utilizzando un servizio Text Embeddings Inference (TEI) distribuito separatamente, consultare TEI Ranker.
Limiti
- La funzione deve fare riferimento esattamente a un campo non nullo di
VARCHARininput_field_names. - Il numero di stringhe in
queriesdeve essere uguale al numero di query di ricerca (nq).
Come funziona
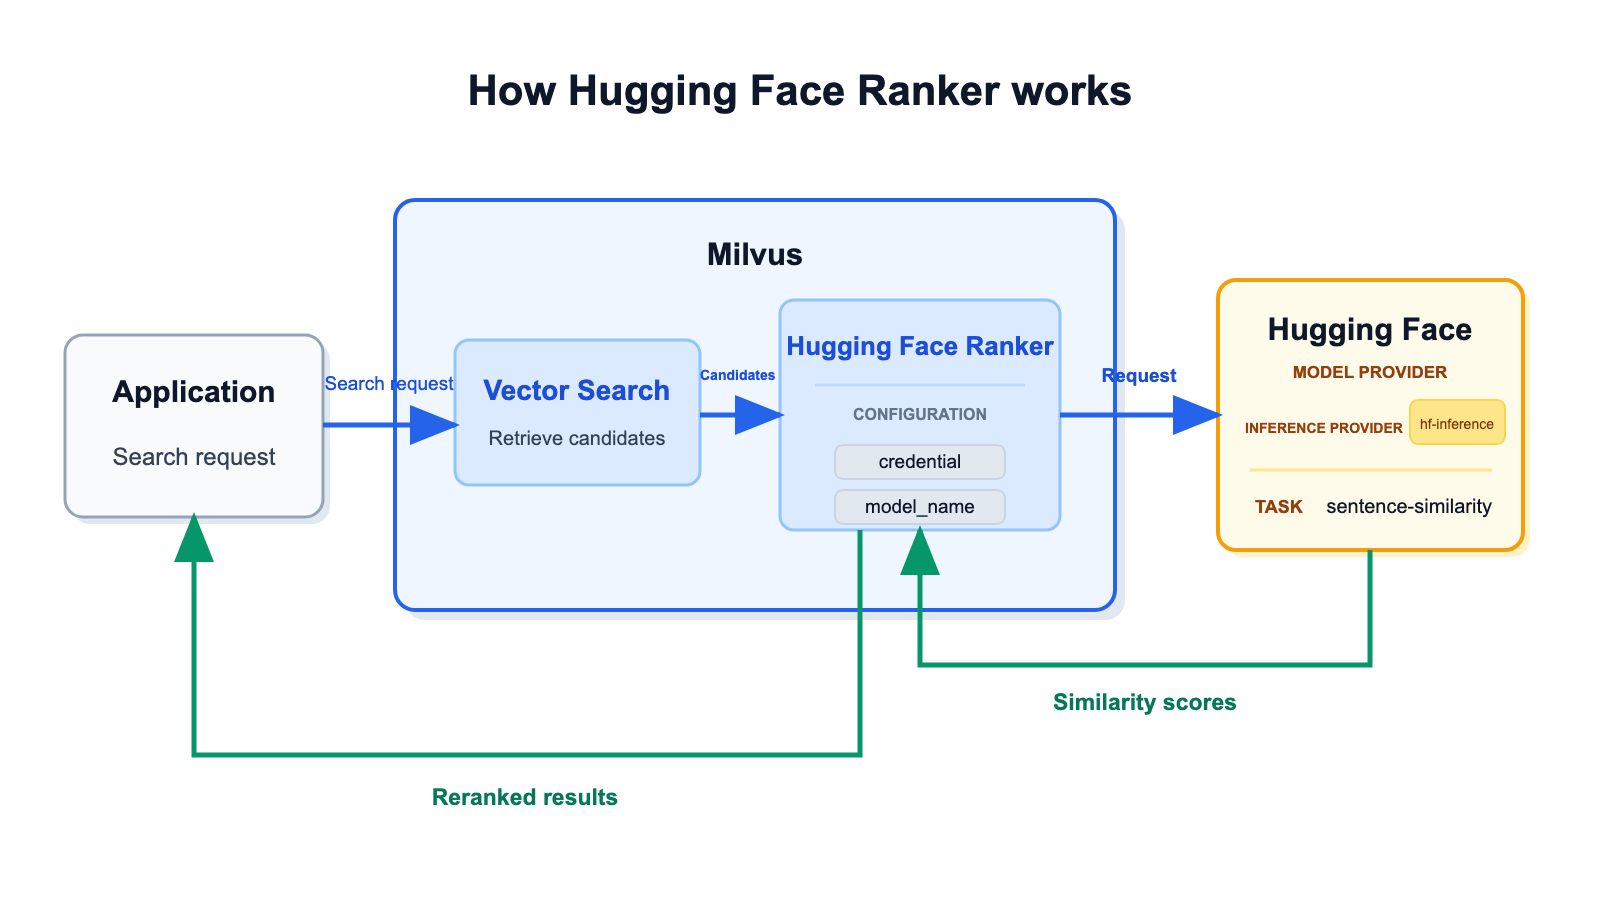 Flusso di lavoro di Hugging Face Ranker
Hugging Face Ranker viene eseguito dopo la ricerca vettoriale iniziale:
- Recupera le entità candidate. Milvus effettua la ricerca nel campo vettoriale configurato e raccoglie le entità candidate.
- Preparazione del testo per il re-ranking. La funzione legge il testo della query da
params.queriese il testo dei candidati dal campoVARCHARspecificato ininput_field_names. - Richiesta dei punteggi di similarità. Milvus invia la query come
source_sentencee i testi candidati comesentencestramitehf-inferencealla pipeline Hugging Facesentence-similarity. - Riorganizza i candidati in base al punteggio. Hugging Face restituisce un punteggio per ciascun candidato. Milvus ordina i candidati dal punteggio più alto a quello più basso e restituisce i risultati riorganizzati.
Come vengono calcolati i punteggi di similarità
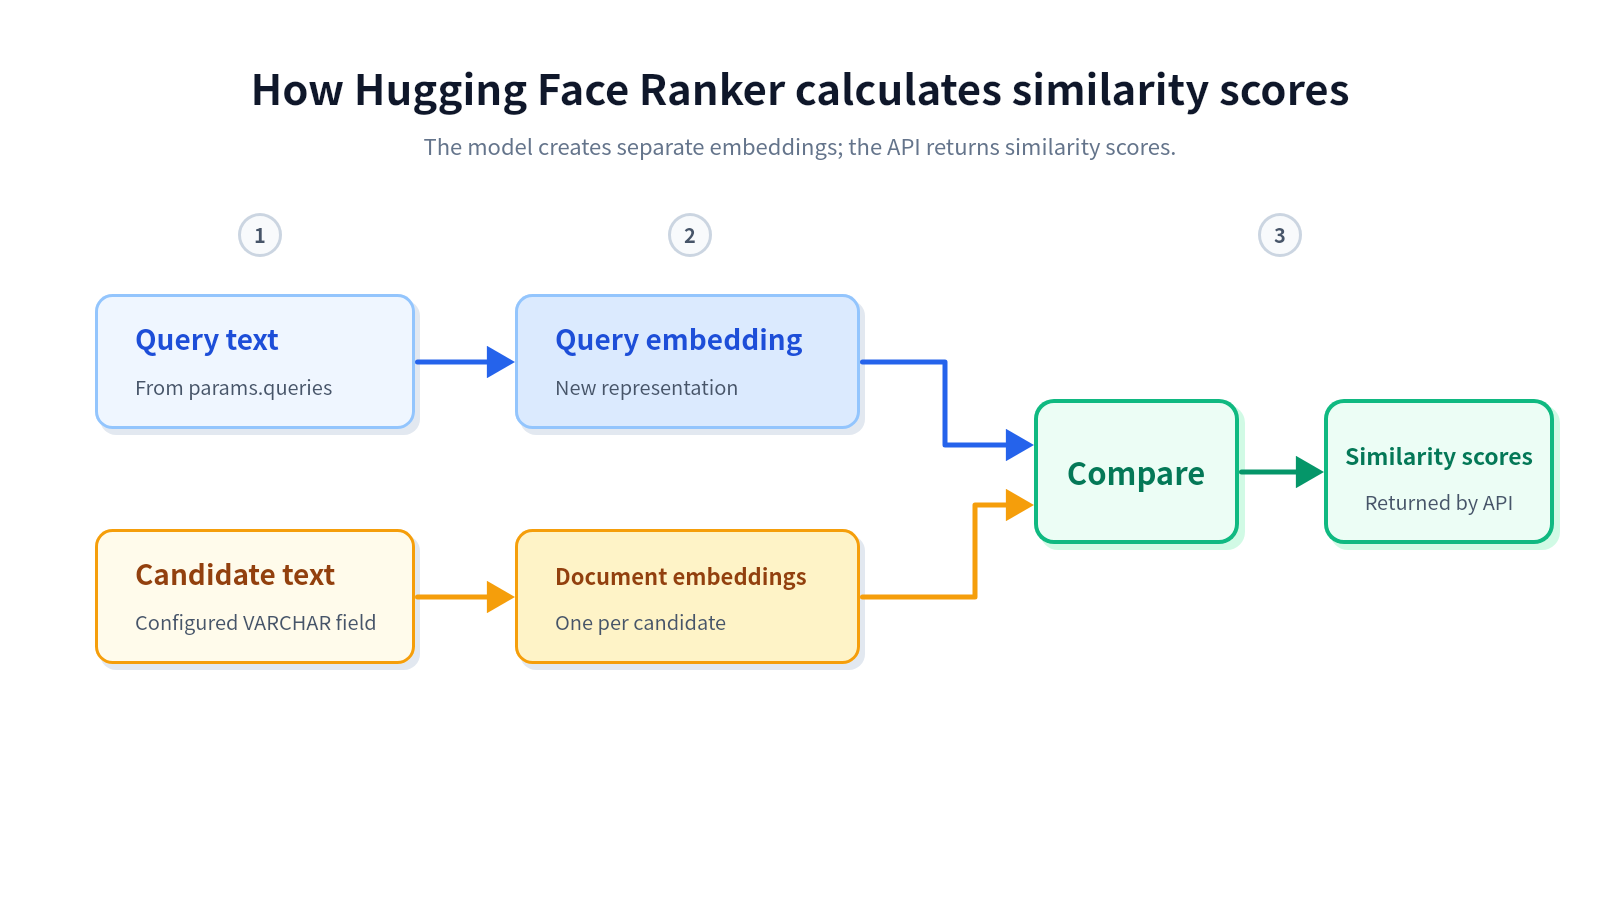 Come Hugging Face Ranker calcola i punteggi di similarità
Il modello di Hugging Face calcola i punteggi in tre fasi:
- Preparare gli input di testo. Il Ranker legge il testo della query da
params.queriese il testo dei candidati dal campoVARCHARconfigurato. - Creazione di rappresentazioni separate del modello. Milvus invia la query come
source_sentencee i testi dei candidati comesentences. Il modello codifica internamente la query e ciascun candidato separatamente. - Confronta e restituisci i punteggi. Il modello confronta la rappresentazione della query con ciascuna rappresentazione dei candidati e restituisce un punteggio di similarità per ciascun candidato.
Gli embedding o le rappresentazioni utilizzati dal modello Hugging Face costituiscono una fase intermedia dell’elaborazione del modello. Hugging Face restituisce punteggi, non vettori. Il recupero iniziale dei vettori e il riordino dei risultati da parte del modello utilizzano quindi rappresentazioni separate e possono avvalersi di modelli diversi.
Prima di iniziare
Prima di utilizzare Hugging Face Ranker, assicurati di disporre di:
- Milvus 2.6.20 o versioni successive della linea di rilascio 2.6.
- PyMilvus 2.6.16 o versione successiva.
- Un token di accesso utente Hugging Face in grado di richiamare i provider di inferenza.
- Un modello attualmente gestito da
hf-inferenceper ilsentence-similarityattività. - Una collezione che memorizza il testo candidato in un campo di
VARCHARnon nullo.
Milvus non controlla se un modello Hugging Face rimanga disponibile tramite hf-inference, né se il modello soddisfi i requisiti di stabilità, latenza e qualità dell’output. Verificare il modello su Hugging Face e valutarlo in base al proprio carico di lavoro prima di utilizzarlo in produzione.
Gli esempi utilizzano sentence-transformers/all-MiniLM-L6-v2 solo a scopo dimostrativo della configurazione. Il modello non costituisce una raccomandazione né una certificazione da parte di Milvus.
Configurazione delle credenziali
È possibile configurare il token di accesso utente di Hugging Face su milvus.yaml o tramite una variabile d’ambiente.
L'ordine di precedenza delle credenziali è:
Function credential label -> provider credential label in milvus.yaml -> environment variable
Opzione 1: File di configurazione
Definire il token nella sezione di primo livello credential, quindi indirizzare il provider di ranking Hugging Face all’etichetta delle credenziali:
# milvus.yaml
credential:
  huggingface_apikey:
    apikey: <YOUR_HUGGING_FACE_TOKEN>

function:
  rerank:
    model:
      providers:
        huggingface:
          credential: huggingface_apikey
          # url: https://router.huggingface.co
Un parametro ` credential ` a livello di funzione può sovrascrivere l'etichetta a livello di provider. Il suo valore deve essere un'etichetta di credenziale definita in milvus.yaml, non il token stesso.
Opzione 2: Variabile d’ambiente
Se né la configurazione della funzione né quella del provider specificano un'etichetta di credenziale, impostare ` MILVUS_HUGGINGFACE_API_KEY ` nell'ambiente del servizio Milvus:
# docker-compose.yaml
standalone:
  environment:
    MILVUS_HUGGINGFACE_API_KEY: <YOUR_HUGGING_FACE_TOKEN>
Utilizzare Hugging Face Ranker
Hugging Face Ranker viene definito e applicato al momento della ricerca. È possibile modificare o omettere il ranker per ogni ricerca senza modificare lo schema della raccolta.
Passaggio 1: Preparare una raccolta
L'esempio seguente crea una collezione con un campo di testo per il riclassamento e un campo vettoriale per il recupero iniziale:
from pymilvus import DataType, Function, FunctionType, MilvusClient

client = MilvusClient(uri="http://localhost:19530")

collection_name = "hugging_face_rerank_demo"
schema = client.create_schema()
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=1000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=4)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE",
)

client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
)

client.insert(
    collection_name=collection_name,
    data=[
        {
            "id": 1,
            "document": "Recent renewable energy developments include improved solar efficiency.",
            "dense": [0.10, 0.20, 0.30, 0.40],
        },
        {
            "id": 2,
            "document": "Climate policy and carbon markets have evolved rapidly in recent years.",
            "dense": [0.11, 0.19, 0.28, 0.39],
        },
        {
            "id": 3,
            "document": "New battery technology helps stabilize wind and solar power generation.",
            "dense": [0.90, 0.10, 0.05, 0.02],
        },
        {
            "id": 4,
            "document": "Vector databases support similarity search for machine learning applications.",
            "dense": [0.01, 0.02, 0.03, 0.04],
        },
    ],
)
Passaggio 2: definire la funzione di riclassificazione
Definire una funzione ` RERANK ` che legga il testo dei candidati da ` document ` e utilizzi il testo della query in ` queries`:
hugging_face_ranker = Function(
    name="hugging_face_semantic_ranker",
    input_field_names=["document"],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "model",
        "provider": "huggingface",
        "model_name": "sentence-transformers/all-MiniLM-L6-v2",
        "hf_provider": "hf-inference",
        "queries": ["renewable energy developments"],
        "credential": "huggingface_apikey",
        "max_client_batch_size": 32,
    },
)
Se si utilizzano solo le credenziali a livello di provider o la variabile d’ambiente, omettere credential dai parametri della funzione.
La tabella seguente descrive i parametri di Hugging Face Ranker:
| Parametro | Obbligatorio? | Descrizione |
|---|---|---|
reranker | Sì | L'implementazione del reranking. Impostare questo valore su model. |
provider | Sì | Il fornitore del modello. Impostare questo valore su huggingface. |
model_name | Sì | L'ID del modello Hugging Face per un modello fornito tramite hf-inference per il task sentence-similarity. |
queries | Sì | Stringhe di query utilizzate per il riclassamento. Fornire esattamente una stringa per ogni query di ricerca, anche quando il recupero iniziale utilizza vettori di query. |
hf_provider | No | Il percorso del provider di inferenza di Hugging Face. Il valore predefinito e l'unico supportato in Milvus 2.6.20 è hf-inference. |
credential | No | L'etichetta di una credenziale definita nella sezione di primo livello credential di milvus.yaml. Questo valore non è il token stesso. |
max_client_batch_size | No | Il numero massimo di testi candidati inviati in una singola richiesta a Hugging Face. Il valore predefinito è 32 e il valore deve essere maggiore di 0. |
Passaggio 3: Effettuare la ricerca con il ranker
Passare la funzione tramite il parametro ranker di search():
query_vector = [0.12, 0.21, 0.29, 0.41]

results = client.search(
    collection_name=collection_name,
    data=[query_vector],
    anns_field="dense",
    limit=3,
    output_fields=["document"],
    ranker=hugging_face_ranker,
    consistency_level="Strong",
)

print(results)
Milvus recupera innanzitutto i candidati da dense, quindi utilizza il testo della query in queries e il testo dei candidati in document per calcolare i punteggi di similarità delle frasi. I candidati restituiti vengono ordinati in base ai punteggi di Hugging Face.
Risoluzione dei problemi
Il modello non è disponibile per la similarità delle frasi
Aprire la pagina del modello su Hugging Face e controllare la sezione "Inference Providers ". Verificare che hf-inference fornisca il modello per sentence-similarity. In caso contrario, selezionare un altro modello che supporti l'attività.
Il numero di stringhe di query non corrisponde alla richiesta di ricerca
Il numero di stringhe in queries deve essere uguale al numero di query di ricerca (nq). Per una ricerca con un solo vettore di query, fornire esattamente una stringa di query.
Il testo del candidato manca o è nullable
Assicurarsi che input_field_names contenga esattamente un campo VARCHAR non nullo e che ogni entità candidata contenga del testo in quel campo.
Milvus segnala la mancanza delle credenziali di Hugging Face
Verificare che l'etichetta delle credenziali della funzione esista in milvus.yaml, che l'etichetta a livello di provider sia valida o che MILVUS_HUGGINGFACE_API_KEY sia presente nell'ambiente di servizio di Milvus.
Prossimi passi
- Per informazioni sul comportamento e sui limiti del Model Ranker condiviso, consultare Panoramica su Model Ranker.
- Per generare embedding tramite i provider di inferenza Hugging Face ospitati, consultare Hugging Face.
- Per applicare il ranker alla ricerca ibrida, consultare Ricerca ibrida multivettoriale.
