

Panoramica su Model RankerCompatible with Milvus 2.6.x
La ricerca vettoriale tradizionale ordina i risultati esclusivamente in base alla somiglianza matematica, ovvero al grado di corrispondenza tra i vettori in uno spazio ad alta dimensionalità. Sebbene efficiente, questo approccio spesso trascura la vera rilevanza semantica. Si consideri, ad esempio , la ricerca di "best practice per l'ottimizzazione dei database": si potrebbero ottenere documenti con un'elevata somiglianza vettoriale che menzionano frequentemente questi termini, ma che in realtà non forniscono strategie di ottimizzazione concrete.
Model Ranker trasforma la ricerca in Milvus integrando modelli linguistici avanzati in grado di comprendere le relazioni semantiche tra query e documenti. Anziché basarsi esclusivamente sulla somiglianza vettoriale, valuta il significato e il contesto dei contenuti per fornire risultati più intelligenti e pertinenti.
Limiti
I Model Ranker non possono essere utilizzati con le ricerche raggruppate.
I campi utilizzati per il riordino dei modelli devono essere di tipo testo (
VARCHAR).Ogni Model Ranker può utilizzare un solo campo
VARCHARalla volta per la valutazione.
Come funziona
I "Model Ranker" integrano le funzionalità di comprensione dei modelli linguistici nel processo di ricerca di Milvus attraverso un flusso di lavoro ben definito:
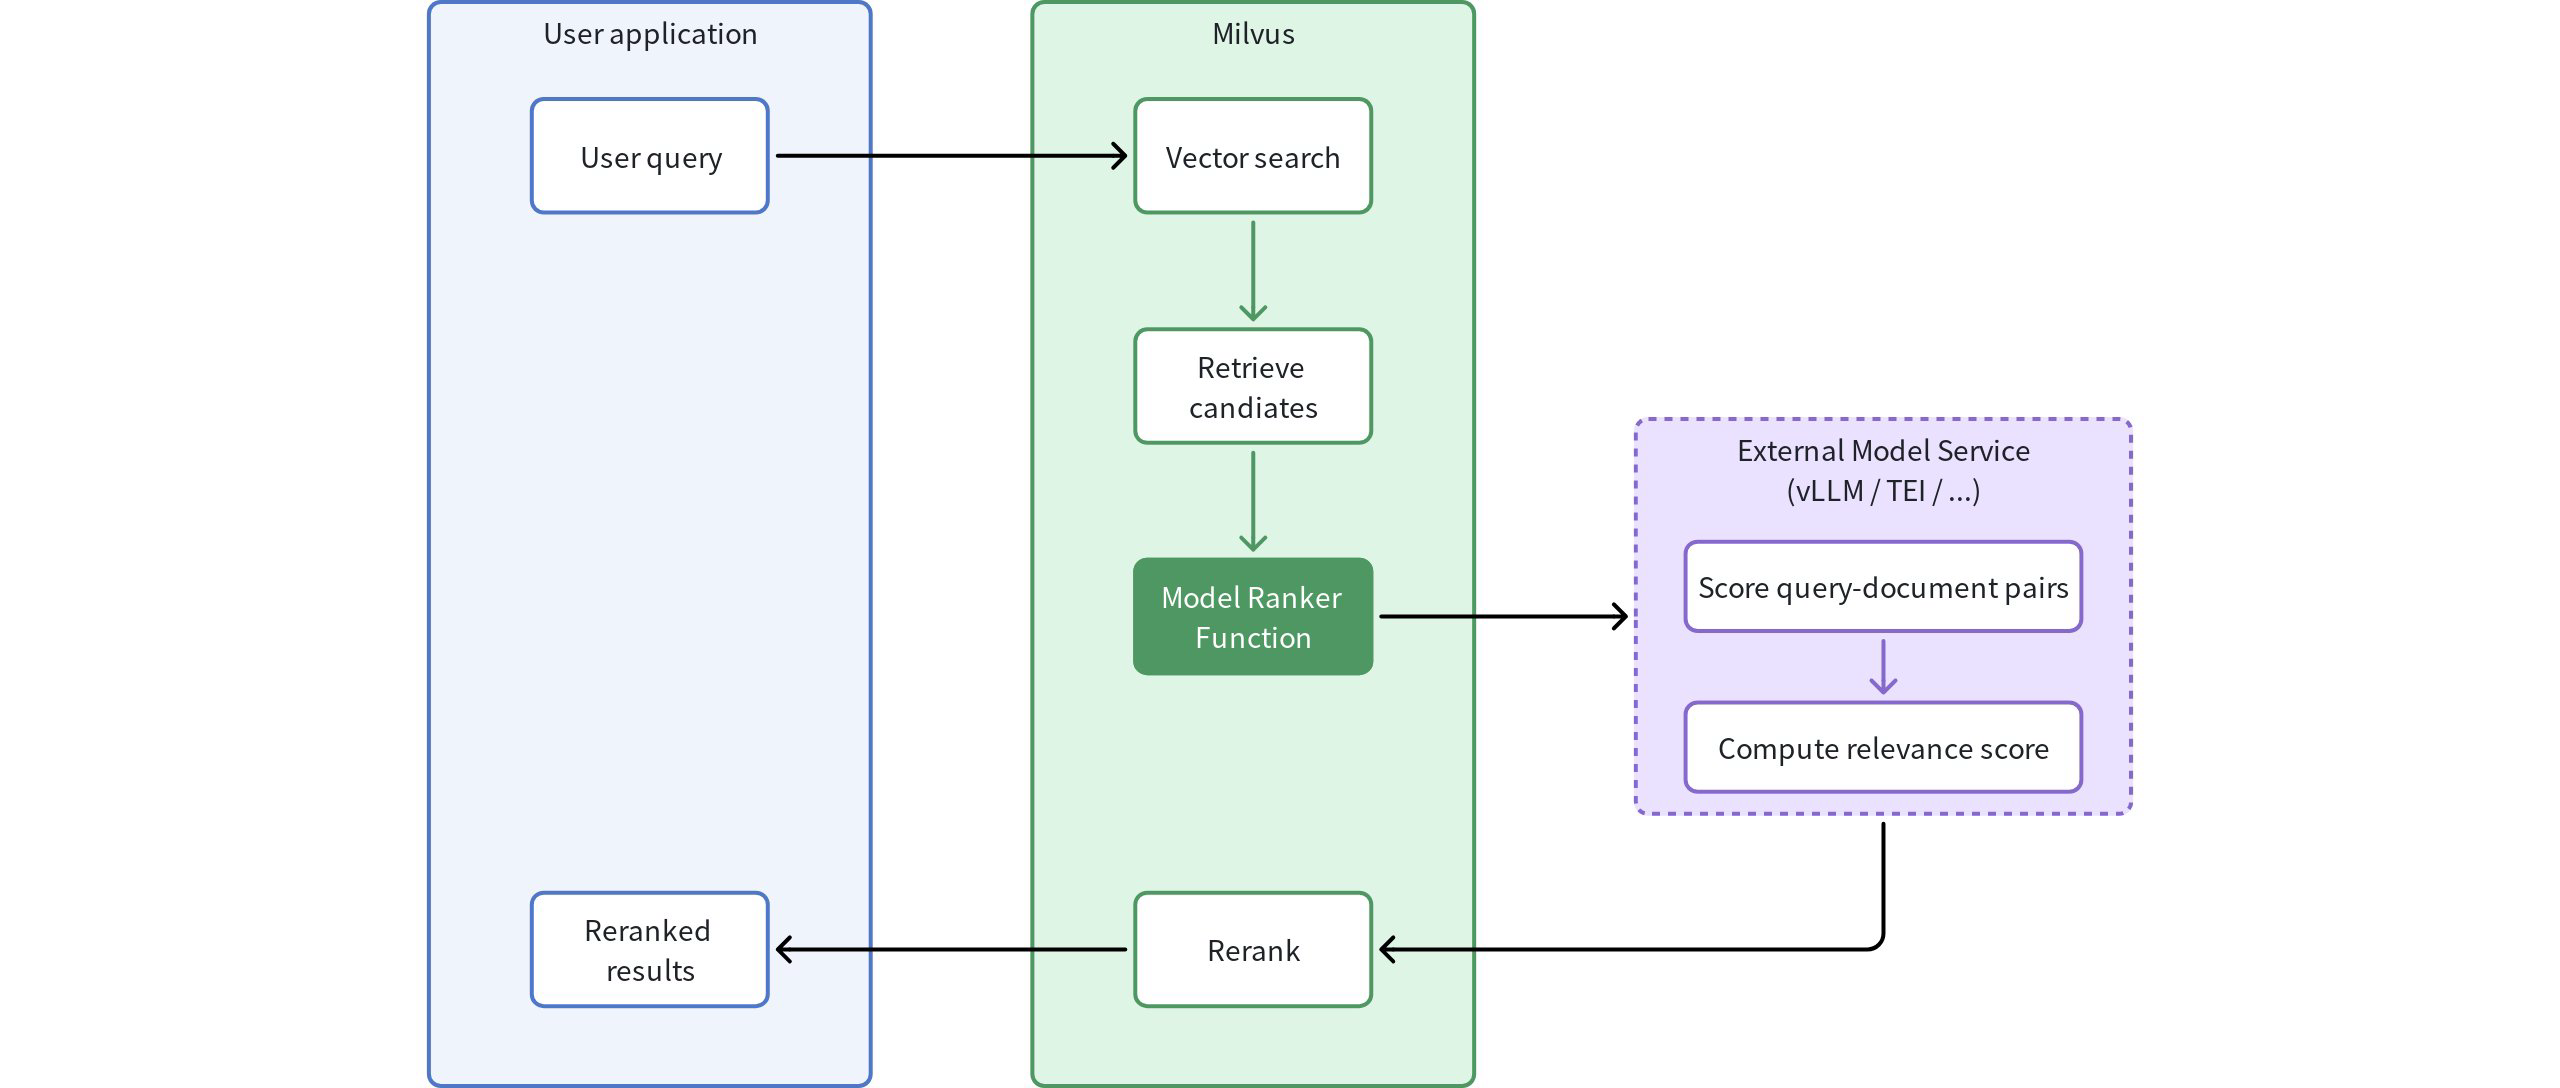 Panoramica sul Model Ranker
Query iniziale: l’applicazione invia una query a Milvus
Ricerca vettoriale: Milvus esegue una ricerca vettoriale standard per identificare i documenti candidati
Recupero dei documenti candidati: il sistema identifica l’insieme iniziale di documenti candidati in base alla somiglianza vettoriale
Valutazione del modello: la funzione Model Ranker elabora le coppie query-documento:
Invia la query originale e i documenti candidati a un servizio di modelli esterno
Il modello linguistico valuta la rilevanza semantica tra la query e ciascun documento
A ciascun documento viene assegnato un punteggio di rilevanza basato sulla comprensione semantica
Riorganizzazione intelligente: i documenti vengono riordinati in base ai punteggi di rilevanza generati dal modello
Risultati migliorati: la tua applicazione riceve risultati ordinati in base alla rilevanza semantica anziché alla sola somiglianza vettoriale
Scegli un fornitore di modelli adatto alle tue esigenze
Milvus supporta i seguenti fornitori di servizi di modelli per il riordino, ciascuno con caratteristiche distinte:
Fornitore |
Ideale per |
Caratteristiche |
Caso d'uso esemplificativo |
|---|---|---|---|
vLLM |
Applicazioni complesse che richiedono una comprensione semantica approfondita e personalizzazione |
|
Piattaforma di ricerca giuridica che implementa modelli specifici di settore in grado di comprendere la terminologia giuridica e le relazioni tra i precedenti giurisprudenziali |
TEI |
Implementazione rapida con un uso efficiente delle risorse |
|
Sistema di gestione dei contenuti che necessita di funzionalità di riclassificazione efficienti con requisiti standard |
Cohere |
Applicazioni aziendali che danno priorità all’affidabilità e alla facilità di integrazione |
|
Piattaforma di e-commerce che richiede una ricerca ad alta disponibilità con prestazioni API costanti e cataloghi prodotti multilingue |
Voyage AI |
Applicazioni RAG con requisiti specifici in termini di prestazioni e contesto |
|
Database di ricerca con documenti di lunghezza variabile che richiedono un controllo ottimizzato delle prestazioni e una comprensione semantica specializzata |
SiliconFlow |
Applicazioni che elaborano documenti lunghi con priorità di efficienza in termini di costi |
|
Sistema di ricerca nella documentazione tecnica per l’elaborazione di manuali e articoli di grandi dimensioni che richiedono una segmentazione intelligente e il controllo delle sovrapposizioni |
Hugging Face |
Applicazioni che utilizzano i modelli di similarità delle frasi di Hugging Face in hosting |
|
Applicazioni di ricerca semantica che desiderano riorganizzare i testi candidati utilizzando un modello Hugging Face senza dover gestire un servizio di inferenza separato |
Per informazioni dettagliate sull’implementazione di ciascun servizio di modello, consultare la documentazione dedicata:
Implementazione
Prima di implementare Model Ranker, assicurati di disporre di:
Una collezione Milvus con un campo "
VARCHAR" contenente il testo da riclassificareUn servizio di modelli esterno in esecuzione accessibile alla propria istanza Milvus
Una connettività di rete adeguata tra Milvus e il servizio di modelli scelto
I Model Ranker si integrano perfettamente sia con le operazioni di ricerca vettoriale standard che con quelle ibride. L’implementazione prevede la creazione di un oggetto Function che definisce la configurazione di riclassificazione e il suo passaggio alle operazioni di ricerca.
Creazione di un Model Ranker
Per implementare il riclassificatore di modelli, definire innanzitutto un oggetto Function con la configurazione appropriata. In questo esempio, utilizziamo TEI come fornitore di servizi:
from pymilvus import MilvusClient, Function, FunctionType

# Connect to your Milvus server
client = MilvusClient(
    uri="http://localhost:19530"  # Replace with your Milvus server URI
)

# Create a model ranker function
model_ranker = Function(
    name="semantic_ranker",  # Function identifier
    input_field_names=["document"],  # VARCHAR field to use for reranking
    function_type=FunctionType.RERANK,  # Must be set to RERANK
    params={
        "reranker": "model",  # Specify model reranker. Must be "model"
        "provider": "tei",  # Choose provider: "tei", "vllm", etc.
        "queries": ["machine learning for time series"],  # Query text
        "endpoint": "http://model-service:8080",  # Model service endpoint
        # "maxBatch": 32  # Optional: batch size for processing
    }
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.ranker.ModelRanker;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

ModelRanker ranker = ModelRanker.builder()
        .name("semantic_ranker")
        .inputFieldNames(Collections.singletonList("document"))
        .provider("tei")
        .queries(Collections.singletonList("machine learning for time series"))
        .endpoint("http://model-service:8080")
        .build();
// nodejs
// go
# restful
Parametro |
Obbligatorio? |
Descrizione |
Valore / Esempio |
|---|---|---|---|
|
Sì |
Identificatore della funzione da utilizzare durante l'esecuzione delle ricerche. |
|
|
Sì |
Nome del campo di testo da utilizzare per il riclassamento. Deve essere un campo di tipo " |
|
|
Sì |
Specifica il tipo di funzione che si sta creando. Deve essere impostato su " |
|
|
Sì |
Un dizionario contenente la configurazione per la funzione di riclassificazione basata sul modello. I parametri disponibili (chiavi) variano a seconda del fornitore di servizi. |
|
|
Sì |
Deve essere impostato su |
|
|
Sì |
Il fornitore di servizi del modello da utilizzare per il riclassamento. |
|
|
Sì |
Elenco delle stringhe di query utilizzate dal modello di riclassificazione per calcolare i punteggi di rilevanza. Il numero di stringhe di query deve corrispondere esattamente al numero di query presenti nell’operazione di ricerca (anche quando si utilizzano vettori di query anziché testo); in caso contrario, verrà segnalato un errore. |
|
|
Sì |
URL del servizio del modello. |
|
|
No |
Numero massimo di documenti da elaborare in un singolo batch. Valori più elevati aumentano la produttività ma richiedono più memoria. |
|
Applica alla ricerca vettoriale standard
Dopo aver definito il proprio modello di classificazione, è possibile applicarlo durante le operazioni di ricerca passandolo al parametro `ranker`:
# Use the model ranker in standard vector search
results = client.search(
    collection_name,
    data=[your_query_vector], # Number of query vectors must match that specified in model_ranker.params["queries"]
    anns_field="vector_field",
    limit=10,
    output_fields=["document"],  # Include the text field in outputs
    ranker=model_ranker,  # Apply the model ranker here
    consistency_level="Bounded"
)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

SearchReq searchReq = SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .data(Collections.singletonList(new EmbeddedText("machine learning for time series")))
        .annsField("vector_field")
        .limit(10)
        .outputFields(Collections.singletonList(document))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .consistencyLevel(ConsistencyLevel.BOUNDED)
        .build();
SearchResp searchResp = client.search(searchReq);
// nodejs
// go
# restful
