

Panoramica delle opzioni di implementazione di Milvus
Milvus è un database vettoriale altamente performante e scalabile. Supporta casi d'uso di dimensioni molto diverse, dalle demo eseguite localmente in Jupyter Notebook ai cluster Kubernetes su larga scala che gestiscono decine di miliardi di vettori. Attualmente, sono disponibili tre opzioni di distribuzione di Milvus: Milvus Lite, Milvus Standalone e Milvus Distributed.
Milvus Lite
Milvus Lite è una libreria Python che può essere importata nelle vostre applicazioni. Essendo una versione leggera di Milvus, è ideale per la prototipazione rapida in Jupyter Notebook o per l’esecuzione su dispositivi smart con risorse limitate. Milvus Lite supporta le stesse API delle altre distribuzioni di Milvus. Il codice lato client che interagisce con Milvus Lite può funzionare anche con istanze di Milvus in altre modalità di distribuzione.
Per integrare Milvus Lite nelle vostre applicazioni, eseguite il comando ` pip install pymilvus ` per installarlo e utilizzate l’istruzione ` MilvusClient("./demo.db") ` per istanziare un database vettoriale con un file locale che conserva tutti i vostri dati. Per ulteriori dettagli, consultate la sezione “Eseguire Milvus Lite”.
Milvus Standalone
Milvus Standalone è una distribuzione server su singola macchina. Tutti i componenti di Milvus Standalone sono raggruppati in un’unica immagine Docker, rendendo la distribuzione più semplice. Se si dispone di un carico di lavoro di produzione ma si preferisce non utilizzare Kubernetes, l’esecuzione di Milvus Standalone su una singola macchina con memoria sufficiente rappresenta una valida opzione. Per impostazione predefinita, Milvus Standalone esegue Woodpecker (integrato) come coda di messaggi, quindi non è necessario gestire un servizio di messaggistica separato.
Milvus Distributed
Milvus Distributed può essere distribuito su cluster Kubernetes. Questa distribuzione presenta un’architettura cloud-native, in cui il carico di acquisizione e le query di ricerca sono gestiti separatamente da nodi isolati, consentendo la ridondanza dei componenti critici. Offre la massima scalabilità e disponibilità, oltre alla flessibilità nella personalizzazione delle risorse allocate a ciascun componente. Milvus Distributed è la scelta ideale per gli utenti aziendali che gestiscono sistemi di ricerca vettoriale su larga scala in produzione. Per impostazione predefinita, Milvus Distributed utilizza Woodpecker come coda di messaggi, distribuito come servizio dedicato insieme a Milvus.
Scegliete la modalità di implementazione più adatta al vostro caso d’uso
La scelta della modalità di implementazione dipende in genere dalla fase di sviluppo della tua applicazione:
Per la prototipazione rapida
Se desideri realizzare rapidamente un prototipo o per scopi didattici, come demo di Retrieval Augmented Generation (RAG), chatbot basati sull’IA, ricerca multimodale, è indicato l’uso di Milvus Lite da solo o in combinazione con Milvus Standalone. È possibile utilizzare Milvus Lite nei notebook per la prototipazione rapida ed esplorare vari approcci, come diverse strategie di chunking nella RAG. Potreste voler distribuire l’applicazione realizzata con Milvus Lite in un ambiente di produzione su piccola scala per servire utenti reali, oppure convalidare l’idea su set di dati più grandi, ad esempio più di qualche milione di vettori. In questo caso, Milvus Standalone è la scelta appropriata. La logica applicativa di Milvus Lite può comunque essere condivisa, poiché tutte le implementazioni di Milvus dispongono della stessa API lato client. I dati memorizzati in Milvus Lite possono inoltre essere trasferiti a Milvus Standalone tramite uno strumento da riga di comando.
Implementazione in produzione su piccola scala
Per la fase iniziale di produzione, quando il progetto è ancora alla ricerca dell’adeguamento del prodotto al mercato e l’agilità è più importante della scalabilità, Milvus Standalone rappresenta la scelta migliore. È comunque in grado di scalare fino a 100 milioni di vettori, a condizione che siano disponibili risorse hardware sufficienti, richiedendo al contempo un impegno DevOps molto inferiore rispetto alla gestione di un cluster K8s.
Implementazione in produzione su larga scala
Man mano che la vostra attività cresce rapidamente e la mole di dati supera la capacità di un singolo server, è il momento di prendere in considerazione Milvus Distributed. Potete continuare a utilizzare Milvus Standalone per l’ambiente di sviluppo o di staging per la sua praticità, e gestire il cluster K8s su cui gira Milvus Distributed. Ciò vi consentirà di gestire decine di miliardi di vettori, oltre a offrirvi la flessibilità di adattare le dimensioni dei nodi al vostro carico di lavoro specifico, ad esempio in casi caratterizzati da un elevato numero di letture e poche scritture, oppure da un elevato numero di scritture e poche letture.
Ricerca locale su dispositivi edge
Per effettuare ricerche su dati privati o sensibili presenti sui dispositivi edge, è possibile distribuire Milvus Lite direttamente sul dispositivo senza dover ricorrere a un servizio basato su cloud per la ricerca di testo o immagini. Questa soluzione è adatta a casi quali la ricerca di documenti proprietari o il rilevamento di oggetti direttamente sul dispositivo.
La scelta della modalità di implementazione di Milvus dipende dalla fase e dalla portata del progetto. Milvus offre una soluzione flessibile e potente per diverse esigenze, dalla prototipazione rapida all’implementazione aziendale su larga scala.
- Milvus Lite è consigliato per set di dati più piccoli, fino a pochi milioni di vettori.
- Milvus Standalone è adatto a set di dati di medie dimensioni, scalabili fino a 100 milioni di vettori.
- Milvus Distributed è progettato per implementazioni su larga scala, in grado di gestire set di dati da 100 milioni fino a decine di miliardi di vettori.
Indipendentemente dalla modalità di implementazione, ogni istanza di Milvus si basa su una coda di messaggi, un sistema di archiviazione oggetti e un archivio di metadati — per impostazione predefinita Woodpecker, MinIO ed etcd. Per saperne di più su queste dipendenze, ottimizzarle o collegare servizi esterni, consulta la sezione Infrastruttura dei dati.
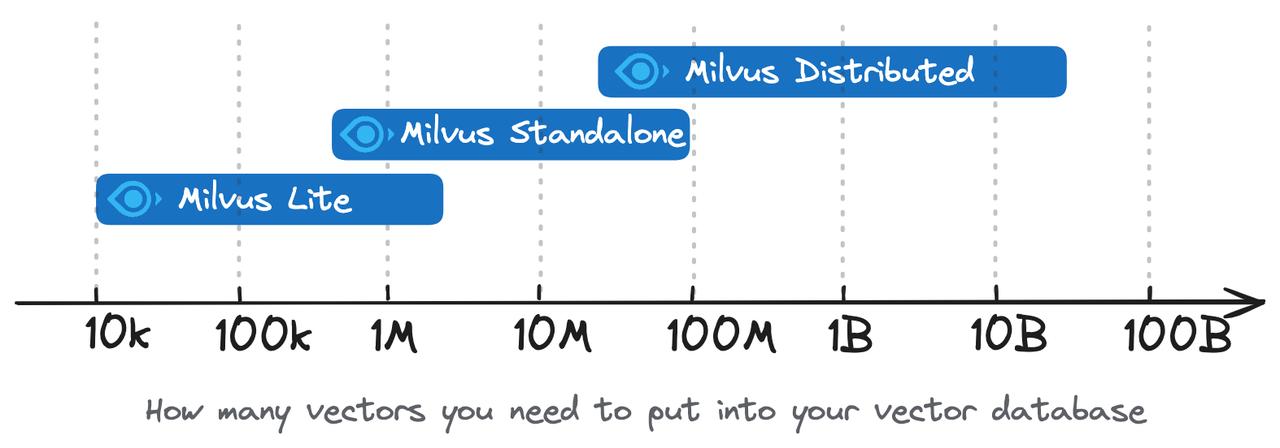 Seleziona l’opzione di implementazione più adatta al tuo caso d’uso
Confronto delle funzionalità
| Funzionalità | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / Libreria client | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| Tipi di dati | Vettore denso Vettore spars Vettore binario Booleano Intero Virgola mobile VarChar Array JSON | Vettore denso Vettore spars Vettore binario Booleano Intero Virgola mobile VarChar Array JSON | Vettore denso Vettore sparso Vettore binario Booleano Intero Virgola mobile VarChar Array JSON |
| Funzionalità di ricerca | Ricerca vettoriale (ricerca ANN) Filtraggio dei metadati Ricerca per intervallo Query scalare Recupero delle entità tramite chiave primaria Ricerca ibrida | Ricerca vettoriale (Ricerca ANN) Filtraggio dei metadati Ricerca per intervallo Query scalare Recupero delle entità tramite chiave primaria Ricerca ibrida | Ricerca vettoriale (Ricerca ANN) Filtraggio dei metadati Ricerca per intervallo Query scalare Recupero delle entità tramite chiave primaria Ricerca ibrida |
| Operazioni CRUD | ✔️ | ✔️ | ✔️ |
| Gestione avanzata dei dati | N/A | Controllo degli accessi Partizione Chiave di partizione | e del controllo degli accessi Partizione Chiave di partizione Raggruppamento delle risorse fisiche |
| Livelli di coerenza | Forte | Forte Staleness limitata Sessione Eventuale | Forte Staleness limitata Sessione Eventuale |
| Coda dei messaggi | N/A | Woodpecker (integrato) | Woodpecker (servizio) |
