

Spiegazione dell'indice
Un indice è una struttura aggiuntiva costruita sui dati. La sua struttura interna dipende dall'algoritmo di ricerca del vicino più prossimo approssimativo utilizzato. Un indice accelera la ricerca, ma comporta un aumento del tempo di pre-elaborazione, dello spazio e della RAM necessari durante la ricerca. Inoltre, l'uso di un indice in genere riduce il tasso di richiamo (sebbene l'effetto sia trascurabile, è comunque rilevante). Pertanto, questo articolo spiega come ridurre al minimo i costi legati all’uso di un indice massimizzandone al contempo i benefici.
Panoramica
In Milvus, gli indici sono specifici per i campi e i tipi di indice applicabili variano a seconda dei tipi di dati dei campi di destinazione. In quanto database vettoriale professionale, Milvus si concentra sul miglioramento sia delle prestazioni delle ricerche vettoriali che del filtraggio scalare, motivo per cui offre vari tipi di indice.
La tabella seguente elenca la relazione di mappatura tra i tipi di dati dei campi e i tipi di indice applicabili.
Tipo di dati del campo |
Tipi di indice applicabili |
|---|---|
FLOAT_VECTOR |
|
|
|
VETTORE_BINARIO |
|
SPARSE_FLOAT_VECTOR |
SPARSE_INDICE_INVERTITO |
VARCHAR |
|
BOOL |
|
|
|
|
INVERTITO |
ARRAY (elementi dei tipi BOOL, INT8/16/32/64 e VARCHAR) |
BITMAP (consigliato) |
ARRAY (elementi dei tipi BOOL, INT8/16/32/64, FLOAT, DOUBLE e VARCHAR) |
INVERTITO |
JSON |
INVERTITO |
Questo articolo si concentra su come selezionare gli indici vettoriali appropriati. Per i campi scalari, è sempre possibile utilizzare il tipo di indice consigliato.
La scelta di un tipo di indice appropriato per una ricerca vettoriale può influire in modo significativo sulle prestazioni e sull'utilizzo delle risorse. Quando si sceglie un tipo di indice per un campo vettoriale, è essenziale considerare vari fattori, tra cui la struttura dei dati sottostante, l'utilizzo della memoria e i requisiti di prestazione.
Anatomia dell’indice vettoriale
Come illustrato nel diagramma sottostante, un tipo di indice in Milvus è costituito da tre componenti principali: struttura dei dati, quantizzazione e refiner. La quantizzazione e il refiner sono opzionali, ma sono ampiamente utilizzati grazie a un equilibrio significativo tra vantaggi e costi.
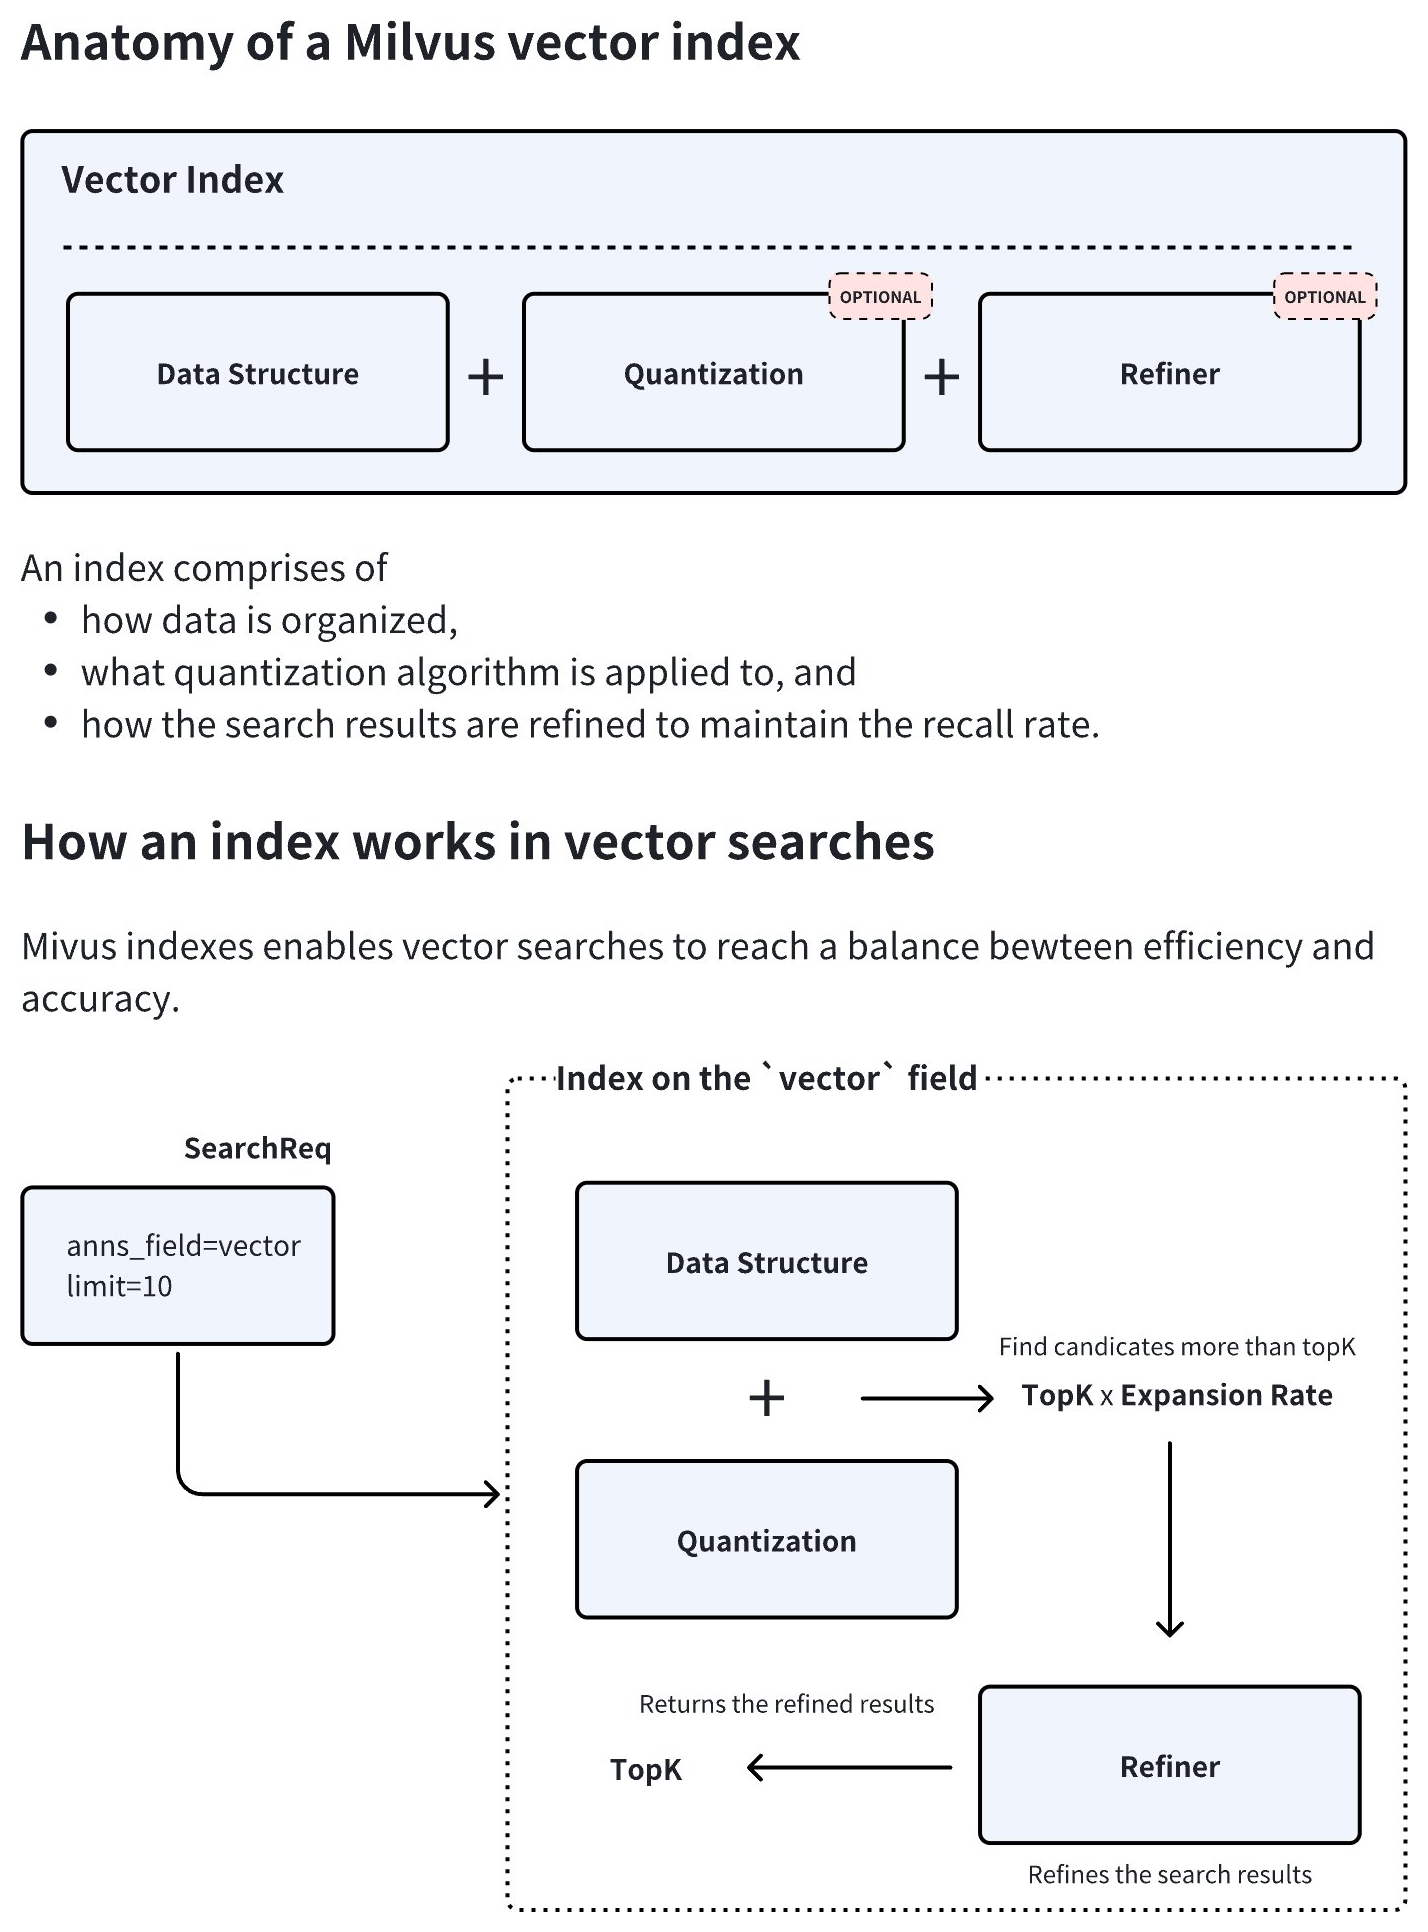 Anatomia dell’indice vettoriale
Durante la creazione dell’indice, Milvus combina la struttura dati e il metodo di quantizzazione scelti per determinare un tasso di espansione ottimale. Al momento della query, il sistema recupera un topK × expansion rate e vettori candidati, applica il rifinitore per ricalcolare le distanze con maggiore precisione e, infine, restituisce i risultati più accurati topK. Questo approccio ibrido bilancia velocità e accuratezza limitando il raffinamento, che richiede un elevato impiego di risorse, a un sottoinsieme filtrato di candidati.
Struttura dei dati
La struttura dei dati costituisce il livello fondamentale dell’indice. Tra i tipi più comuni figurano:
File invertito (IVF)
I tipi di indice della serie IVF consentono a Milvus di raggruppare i vettori in bucket tramite una partizione basata sui centroidi. In genere è lecito supporre che tutti i vettori presenti in un bucket siano probabilmente vicini al vettore di query se il centroide del bucket è vicino al vettore di query. Partendo da questa premessa, Milvus esamina solo le rappresentazioni vettoriali presenti nei bucket in cui i centri di massa sono vicini al vettore di query, anziché analizzare l’intero set di dati. Questa strategia riduce i costi computazionali mantenendo al contempo un’accuratezza accettabile.
Questo tipo di struttura dati dell’indice è ideale per set di dati su larga scala che richiedono un throughput elevato.
Struttura basata su grafi
Una struttura di dati basata su grafi per la ricerca vettoriale, come Hierarchical Navigable Small World (HNSW), costruisce un grafo a livelli in cui ogni vettore si collega ai propri vicini più prossimi. Le query navigano in questa gerarchia, partendo dai livelli superiori più generici e passando ai livelli inferiori, consentendo un'efficiente complessità di ricerca in tempo logaritmico.
Questo tipo di struttura dati a indice eccelle negli spazi ad alta dimensionalità e negli scenari che richiedono query a bassa latenza.
Quantizzazione
La quantizzazione riduce l’impronta di memoria e i costi computazionali attraverso una rappresentazione più approssimativa:
La quantizzazione scalare (ad es. SQ8) consente a Milvus di comprimere ogni dimensione vettoriale in un singolo byte (8 bit), riducendo l’utilizzo di memoria del 75% rispetto ai valori in virgola mobile a 32 bit, pur mantenendo una precisione ragionevole.
La quantizzazione del prodotto (PQ) consente a Milvus di suddividere i vettori in sottovettori e di codificarli utilizzando il clustering basato su codebook. Ciò consente di ottenere rapporti di compressione più elevati (ad es. da 4 a 32 volte) a costo di una riduzione marginale del recall, rendendola adatta ad ambienti con limitazioni di memoria.
Raffinatore
La quantizzazione comporta intrinsecamente una perdita di informazioni. Per mantenere il tasso di richiamo, la quantizzazione produce costantemente un numero di candidati top-K superiore al necessario, consentendo ai raffinatori di utilizzare una precisione maggiore per selezionare ulteriormente i risultati top-K tra questi candidati, migliorando così il tasso di richiamo.
Ad esempio, il raffinatore FP32 opera sui candidati dei risultati di ricerca restituiti dalla quantizzazione ricalcolando le distanze utilizzando la precisione FP32 anziché i valori quantizzati.
Ciò è fondamentale per le applicazioni che richiedono un compromesso tra efficienza di ricerca e precisione, come la ricerca semantica o i sistemi di raccomandazione, in cui variazioni minime di distanza incidono significativamente sulla qualità dei risultati.
Sintesi
Questa architettura a più livelli – filtraggio grossolano tramite strutture dati, calcolo efficiente tramite quantizzazione e messa a punto della precisione tramite affinamento – consente a Milvus di ottimizzare in modo adattivo il compromesso tra accuratezza e prestazioni.
Compromessi in termini di prestazioni
Nel valutare le prestazioni, è fondamentale bilanciare il tempo di compilazione, le query al secondo (QPS) e il tasso di richiamo. Le regole generali sono le seguenti:
I tipi di indice basati su grafi di solito superano le varianti IVF in termini di QPS.
Le varianti IVF sono particolarmente adatte a scenari con un topK elevato (ad esempio, superiore a 2.000).
PQ offre in genere un tasso di richiamo migliore a tassi di compressione simili rispetto a SQ, sebbene quest’ultimo garantisca prestazioni più veloci.
L'utilizzo di dischi rigidi per una parte dell'indice (come in DiskANN) aiuta a gestire set di dati di grandi dimensioni, ma introduce anche potenziali colli di bottiglia a livello di IOPS.
Capacità
La capacità di solito riguarda il rapporto tra la dimensione dei dati e la RAM disponibile. Quando si ha a che fare con la capacità, considerare quanto segue:
Se un quarto dei dati grezzi rientra nella memoria, prendere in considerazione DiskANN per la sua latenza stabile.
Se tutti i dati grezzi rientrano nella memoria, prendete in considerazione i tipi di indice basati sulla memoria e mmap.
È possibile utilizzare i tipi di indice con quantizzazione applicata e mmap per sacrificare la precisione a favore della massima capacità.
Mmap non è sempre la soluzione ideale. Quando la maggior parte dei dati si trova su disco, DiskANN offre una latenza migliore.
Recall
Il richiamo di solito dipende dal rapporto di filtraggio, che si riferisce ai dati che vengono filtrati prima delle ricerche. Quando si parla di richiamo, considera quanto segue:
Se il rapporto di filtraggio è inferiore all’85%, i tipi di indice basati su grafo offrono prestazioni migliori rispetto alle varianti IVF.
Se il rapporto di filtraggio è compreso tra l’85% e il 95%, utilizzare le varianti IVF.
Se il rapporto di filtraggio è superiore al 98%, utilizzare Brute-Force (FLAT) per ottenere risultati di ricerca più accurati.
Le indicazioni di cui sopra non sono sempre valide. Si consiglia di ottimizzare il richiamo con diversi tipi di indice per determinare quale sia il più efficace.
Prestazioni
Le prestazioni di una ricerca dipendono solitamente dal top-K, ovvero dal numero di record restituiti dalla ricerca. Quando si valutano le prestazioni, tenere presente quanto segue:
Per una ricerca con un top-K ridotto (ad es. 2.000) che richiede un alto tasso di richiamo, i tipi di indice basati su grafi offrono prestazioni migliori rispetto alle varianti IVF.
Per una ricerca con un top-K elevato (rispetto al numero totale di embedding vettoriali), le varianti IVF rappresentano una scelta migliore rispetto ai tipi di indice basati su grafi.
Per una ricerca con un top-K di medie dimensioni e un rapporto di filtraggio elevato, le varianti IVF rappresentano la scelta migliore.
Matrice decisionale: scelta del tipo di indice più appropriato
La tabella seguente è una matrice decisionale a cui fare riferimento nella scelta di un tipo di indice appropriato.
Scenario |
Indice consigliato |
Note |
|---|---|---|
I dati grezzi rientrano nella memoria |
HNSW, IVF + Refinement |
Utilizzare HNSW per un basso |
Dati grezzi su disco, SSD |
DiskANN |
Ottimale per query sensibili alla latenza. |
Dati grezzi su disco, RAM limitata |
IVFPQ/SQ + mmap |
Bilancia l'accesso alla memoria e al disco. |
Elevato rapporto di filtraggio (>95%) |
Brute-Force (FLAT) |
Evita il sovraccarico dell'indice per insiemi di candidati molto piccoli. |
|
IVF |
Il pruning dei cluster riduce il carico di calcolo. |
Tasso di richiamo estremamente elevato (>99%) |
Forza bruta (FLAT) + GPU |
-- |
Stima dell'utilizzo della memoria
Questa sezione si concentra sul calcolo del consumo di memoria di un tipo specifico di indice e include molti dettagli tecnici. È possibile saltare tranquillamente questa sezione se non è di proprio interesse.
Il consumo di memoria di un indice è influenzato dalla sua struttura dei dati, dal tasso di compressione ottenuto tramite quantizzazione e dal refiner in uso. In generale, gli indici basati su grafi hanno solitamente un ingombro di memoria maggiore a causa della struttura del grafo (ad esempio, HNSW), il che di solito comporta un notevole overhead per spazio vettoriale. Al contrario, l’IVF e le sue varianti sono più efficienti in termini di memoria poiché comportano un minore overhead per spazio vettoriale. Tuttavia, tecniche avanzate come DiskANN consentono a parti dell’indice, come il grafo o il refiner, di risiedere su disco, riducendo il carico di memoria pur mantenendo le prestazioni.
Nello specifico, l’utilizzo di memoria di un indice può essere calcolato come segue:
Utilizzo di memoria degli indici IVF
Gli indici IVF bilanciano l’efficienza della memoria con le prestazioni di ricerca suddividendo i dati in cluster. Di seguito è riportata una ripartizione della memoria utilizzata da 1 milione di vettori a 128 dimensioni indicizzati utilizzando varianti di IVF.
Calcolo della memoria utilizzata dai centroidi.
I tipi di indice della serie IVF consentono a Milvus di raggruppare i vettori in bucket utilizzando una partizionatura basata sui centroidi. Ogni centroide è incluso nell’indice sotto forma di embedding vettoriale grezzo. Quando si dividono i vettori in 2.000 cluster, l’utilizzo di memoria può essere calcolato come segue:
2,000 clusters × 128 dimensions × 4 bytes = 1.0 MBCalcolare la memoria utilizzata dalle assegnazioni ai cluster.
Ogni embedding vettoriale viene assegnato a un cluster e memorizzato come ID intero. Per 2.000 cluster, è sufficiente un intero a 2 byte. L’utilizzo di memoria può essere calcolato come segue:
1,000,000 vectors × 2 bytes = 2.0 MBCalcolare la compressione causata dalla quantizzazione.
Le varianti IVF utilizzano in genere PQ e SQ8, e l’utilizzo di memoria può essere stimato come segue:
Utilizzo di PQ con 8 sottocuantizzatori
1,000,000 vectors × 8 bytes = 8.0 MBUtilizzo di SQ8
1,000,000 vectors × 128 dimensions × 1 byte = 128 MB
La tabella seguente elenca l’utilizzo stimato di memoria con diverse configurazioni:
Configurazione
Stima della memoria
Memoria totale
IVF-PQ (senza raffinamento)
1,0 MB + 2,0 MB + 8,0 MB
11,0 MB
IVF-PQ + 10% di raffinamento grezzo
1,0 MB + 2,0 MB + 8,0 MB + 51,2 MB
62,2 MB
IVF-SQ8 (senza affinamento)
1,0 MB + 2,0 MB + 128 MB
131,0 MB
IVF-FLAT (vettori grezzi completi)
1,0 MB + 2,0 MB + 512 MB
515,0 MB
Calcolare il sovraccarico di raffinamento.
Le varianti IVF sono spesso abbinate a un raffinatore per riclassificare i candidati. Per una ricerca che restituisce i primi 10 risultati con un tasso di espansione pari a 5, il sovraccarico di raffinamento può essere stimato come segue:
10 (topK) x 5 (expansion rate) = 50 candidates
50 candidates x 128 dimensions x 4 bytes = 25.6 KB
Utilizzo della memoria degli indici basati su grafi
I tipi di indice basati su grafo come HNSW richiedono una notevole quantità di memoria per memorizzare sia la struttura del grafo che gli embedding vettoriali grezzi. Di seguito è riportata una ripartizione dettagliata della memoria consumata da 1 milione di vettori a 128 dimensioni indicizzati utilizzando il tipo di indice HNSW.
Calcolo della memoria utilizzata dalla struttura del grafo.
Ogni vettore in HNSW mantiene connessioni con i propri vicini. Con un grado del grafo (spigoli per nodo) pari a 32, la memoria consumata può essere calcolata come segue:
1,000,000 vectors × 32 links × 4 bytes (for 32-bit integer storage) = 128 MBCalcolare la memoria utilizzata dagli embedding vettoriali grezzi.
La memoria consumata dalla memorizzazione di vettori FP32 non compressi può essere calcolata come segue:
1,000,000 vectors × 128 dimensions × 4 bytes = 512 MBQuando si utilizza HNSW per indicizzare 1 milione di embedding vettoriali a 128 dimensioni, la memoria totale utilizzata sarebbe pari a 128 MB (grafo) + 512 MB (vettori) = 640 MB.
Calcolare la compressione ottenuta grazie alla quantizzazione.
La quantizzazione riduce le dimensioni dei vettori. Ad esempio, l’utilizzo di PQ con 8 subquantizzatori (8 byte per vettore) comporta una compressione drastica. La memoria consumata dagli embedding vettoriali compressi può essere calcolata come segue:
1,000,000 vectors × 8 bytes = 8 MBSi ottiene così un rapporto di compressione di 64 volte rispetto alle rappresentazioni vettoriali non compresse, e la memoria totale utilizzata dal tipo di indice HNSWPQ sarebbe pari a 128 MB (grafo) + 8 MB (vettori compressi) = 136 MB.
Calcolare il sovraccarico di affinamento.
Le operazioni di affinamento, come il riordino dei risultati con vettori non compressi, comportano il caricamento temporaneo in memoria di dati ad alta precisione. Per una ricerca che restituisce i primi 10 risultati con un tasso di espansione pari a 5, il sovraccarico di affinamento può essere stimato come segue:
10 (topK) x 5 (expansion rate) = 50 candidates
50 candidates x 128 dimensions x 4 bytes = 25.6 KB
Altre considerazioni
Mentre gli indici IVF e quelli basati su grafi ottimizzano l’utilizzo della memoria tramite la quantizzazione, i file mappati in memoria (mmap) e DiskANN affrontano scenari in cui i set di dati superano la memoria ad accesso casuale (RAM) disponibile.
DiskANN
DiskANN è un indice basato sul grafo Vamana che collega i punti dati per una navigazione efficiente durante la ricerca, applicando al contempo il PQ per ridurre le dimensioni dei vettori e consentire un rapido calcolo approssimativo della distanza tra i vettori.
Il grafo Vamana è memorizzato su disco, il che consente a DiskANN di gestire grandi set di dati che altrimenti sarebbero troppo grandi per essere contenuti in memoria. Ciò è particolarmente utile per set di dati da miliardi di punti.
File mappati in memoria (mmap)
La mappatura in memoria (mmap) consente l’accesso diretto alla memoria per file di grandi dimensioni su disco, permettendo a Milvus di memorizzare indici e dati sia in memoria che su disco rigido. Questo approccio aiuta a ottimizzare le operazioni di I/O riducendo il sovraccarico delle chiamate I/O in base alla frequenza di accesso, ampliando così la capacità di archiviazione delle collezioni senza influire in modo significativo sulle prestazioni di ricerca.
Nello specifico, è possibile configurare Milvus per mappare in memoria i dati grezzi in determinati campi invece di caricarli interamente in memoria. In questo modo, è possibile ottenere l’accesso diretto in memoria ai campi senza preoccuparsi di problemi di memoria ed estendere la capacità della collezione.
