

Gambaran Umum Opsi Penerapan Milvus
Milvus adalah basis data vektor yang berkinerja tinggi dan dapat diskalakan. Basis data ini mendukung berbagai skenario penggunaan dengan skala yang beragam, mulai dari demo yang dijalankan secara lokal di Jupyter Notebooks hingga kluster Kubernetes berskala besar yang menangani puluhan miliar vektor. Saat ini, terdapat tiga opsi penerapan Milvus: Milvus Lite, Milvus Standalone, dan Milvus Distributed.
Milvus Lite
Milvus Lite adalah pustaka Python yang dapat diimpor ke dalam aplikasi Anda. Sebagai versi ringan dari Milvus, Milvus Lite sangat ideal untuk pembuatan prototipe cepat di Jupyter Notebooks atau dijalankan pada perangkat pintar dengan sumber daya terbatas. Milvus Lite mendukung API yang sama dengan deployment Milvus lainnya. Kode sisi klien yang berinteraksi dengan Milvus Lite juga dapat bekerja dengan instance Milvus dalam mode deployment lainnya.
Untuk mengintegrasikan Milvus Lite ke dalam aplikasi Anda, jalankan perintah ` pip install pymilvus ` untuk menginstalnya, lalu gunakan pernyataan ` MilvusClient("./demo.db") ` untuk membuat instans basis data vektor dengan berkas lokal yang menyimpan semua data Anda. Untuk detail lebih lanjut, lihat bagian " Run Milvus Lite".
Milvus Standalone
Milvus Standalone adalah penyebaran server pada satu mesin. Semua komponen Milvus Standalone dikemas dalam satu gambar Docker, sehingga memudahkan proses penyebaran. Jika Anda memiliki beban kerja produksi tetapi memilih untuk tidak menggunakan Kubernetes, menjalankan Milvus Standalone pada satu mesin dengan memori yang memadai merupakan pilihan yang tepat. Secara default, Milvus Standalone menjalankan Woodpecker (terintegrasi) sebagai antrian pesannya, sehingga tidak ada layanan pesan terpisah yang perlu dioperasikan.
Milvus Distributed
Milvus Distributed dapat diimplementasikan pada kluster Kubernetes. Implementasi ini memiliki arsitektur cloud-native, di mana beban pengambilan data dan kueri pencarian ditangani secara terpisah oleh node-node yang terisolasi, sehingga memungkinkan redundansi untuk komponen-komponen kritis. Milvus Distributed menawarkan skalabilitas dan ketersediaan tertinggi, serta fleksibilitas dalam menyesuaikan sumber daya yang dialokasikan pada setiap komponen. Milvus Distributed adalah pilihan utama bagi pengguna perusahaan yang menjalankan sistem pencarian vektor berskala besar dalam produksi. Secara default, Milvus Distributed menjalankan Woodpecker sebagai antrian pesannya, yang diimplementasikan sebagai layanan khusus bersama Milvus.
Pilih Penerapan yang Tepat untuk Kasus Penggunaan Anda
Pemilihan mode penerapan biasanya bergantung pada tahap pengembangan aplikasi Anda:
Untuk Pembuatan Prototipe Cepat
Jika Anda ingin dengan cepat membangun sesuatu sebagai prototipe atau untuk tujuan pembelajaran, seperti demo Retrieval Augmented Generation (RAG), chatbot AI, atau pencarian multimodal, Milvus Lite sendiri atau kombinasi Milvus Lite dan Milvus Standalone sangat cocok. Anda dapat menggunakan Milvus Lite di notebook untuk prototipe cepat dan mengeksplorasi berbagai pendekatan, seperti strategi chunking yang berbeda dalam RAG. Anda mungkin ingin mengimplementasikan aplikasi yang dibangun dengan Milvus Lite dalam lingkungan produksi skala kecil untuk melayani pengguna nyata, atau memvalidasi ide tersebut pada dataset yang lebih besar, misalnya lebih dari beberapa juta vektor. Milvus Standalone adalah pilihan yang tepat. Logika aplikasi untuk Milvus Lite tetap dapat dibagikan karena semua penerapan Milvus memiliki API sisi klien yang sama. Data yang disimpan di Milvus Lite juga dapat dipindahkan ke Milvus Standalone menggunakan alat baris perintah.
Penerapan Produksi Skala Kecil
Untuk produksi tahap awal, ketika proyek masih mencari kesesuaian produk-pasar dan kelincahan lebih penting daripada skalabilitas, Milvus Standalone adalah pilihan terbaik. Milvus Standalone masih dapat diskalakan hingga 100 juta vektor dengan sumber daya mesin yang memadai, sekaligus membutuhkan DevOps yang jauh lebih sedikit daripada memelihara kluster K8s.
Penerapan Produksi Skala Besar
Seiring pertumbuhan bisnis Anda yang pesat dan skala data melampaui kapasitas satu server, inilah saatnya mempertimbangkan Milvus Distributed. Anda dapat tetap menggunakan Milvus Standalone untuk lingkungan pengembangan atau staging karena kemudahannya, sekaligus mengoperasikan kluster K8s yang menjalankan Milvus Distributed. Hal ini dapat mendukung Anda hingga puluhan miliar vektor, serta memberikan fleksibilitas dalam menyesuaikan ukuran node untuk beban kerja khusus Anda, seperti kasus pembacaan tinggi, penulisan jarang, atau penulisan tinggi, pembacaan rendah.
Pencarian Lokal di Perangkat Edge
Untuk melakukan pencarian pada data pribadi atau sensitif di perangkat tepi, Anda dapat mengimplementasikan Milvus Lite langsung di perangkat tersebut tanpa bergantung pada layanan berbasis cloud untuk pencarian teks atau gambar. Hal ini cocok untuk kasus seperti pencarian dokumen eksklusif, atau deteksi objek langsung di perangkat.
Pilihan mode penerapan Milvus bergantung pada tahap dan skala proyek Anda. Milvus menyediakan solusi yang fleksibel dan kuat untuk berbagai kebutuhan, mulai dari pembuatan prototipe cepat hingga penerapan skala besar di perusahaan.
- Milvus Lite direkomendasikan untuk dataset yang lebih kecil, hingga beberapa juta vektor.
- Milvus Standalone cocok untuk dataset berukuran sedang, yang dapat ditingkatkan hingga 100 juta vektor.
- Milvus Distributed dirancang untuk penerapan berskala besar, yang mampu menangani kumpulan data mulai dari 100 juta hingga puluhan miliar vektor.
Terlepas dari mode penerapan apa pun, setiap instance Milvus bergantung pada antrian pesan, penyimpanan objek, dan penyimpanan metadata — secara default Woodpecker, MinIO, dan etcd. Untuk mempelajari tentang ketergantungan ini, menyesuaikannya, atau menghubungkan layanan eksternal, lihat Infrastruktur Data.
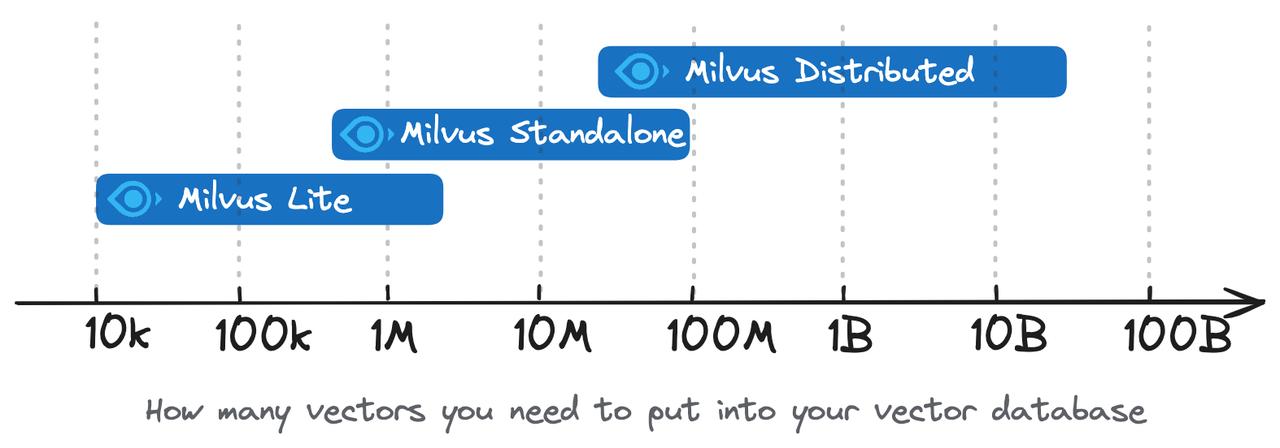 Pilih opsi penerapan yang sesuai dengan kasus penggunaan Anda
Perbandingan fitur
| Fitur | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / Perpustakaan Klien | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| Tipe data | Vektor Padat Vektor Jarang Vektor Biner Boolean Bilangan Bulat Bilangan Pecahan VarChar Array JSON | Vektor Padat Vektor Jarang Vektor Biner Boolean Bilangan Bulat Bilangan Pecahan VarChar Array JSON | Vektor Padat Vektor Jarang Vektor Biner Boolean Bilangan Bulat Bilangan Pecahan VarChar Array JSON |
| Kemampuan pencarian | Pencarian Vektor (Pencarian ANN) Penyaringan Metadata Pencarian Rentang Kueri Skalar Dapatkan Entitas berdasarkan Kunci Utama Pencarian Hibrida | Pencarian Vektor (Pencarian ANN) Penyaringan Metadata Pencarian Rentang Kueri Skalar Mengambil Entitas berdasarkan Kunci Utama Pencarian Hibrida | Pencarian Vektor (Pencarian ANN) Penyaringan Metadata Pencarian Rentang Kueri Skalar Mengambil Entitas berdasarkan Kunci Utama Pencarian Hibrida |
| Operasi CRUD | ✔️ | ✔️ | ✔️ |
| Manajemen data lanjutan | N/A | Kontrol Akses Partisi Kunci Partisi | Kontrol Akses Partisi Kunci Partisi Pengelompokan Sumber Daya Fisik |
| Tingkat Konsistensi | Kuat | Kuat Keterlambatan Terbatas Sesi Akhirnya | Kuat Keterlambatan Terbatas Sesi Akhir |
| Antrian pesan | N/A | Woodpecker (terintegrasi) | Woodpecker (layanan) |
