

Penjelasan tentang Indeks
Indeks adalah struktur tambahan yang dibangun di atas data. Struktur internalnya bergantung pada algoritma pencarian tetangga terdekat yang digunakan. Indeks mempercepat proses pencarian, tetapi menimbulkan biaya tambahan berupa waktu prapemrosesan, ruang penyimpanan, dan penggunaan RAM selama proses pencarian. Selain itu, penggunaan indeks umumnya menurunkan tingkat recall (meskipun efeknya dapat diabaikan, hal ini tetap penting). Oleh karena itu, artikel ini menjelaskan cara meminimalkan biaya penggunaan indeks sekaligus memaksimalkan manfaatnya.
Gambaran Umum
Di Milvus, indeks bersifat spesifik untuk setiap bidang, dan jenis indeks yang dapat diterapkan bervariasi sesuai dengan tipe data bidang yang dituju. Sebagai basis data vektor profesional, Milvus berfokus pada peningkatan kinerja pencarian vektor dan penyaringan skalar, itulah sebabnya Milvus menawarkan berbagai jenis indeks.
Tabel berikut mencantumkan hubungan pemetaan antara tipe data bidang dan jenis indeks yang berlaku.
Tipe Data Bidang |
Jenis Indeks yang Dapat Digunakan |
|---|---|
FLOAT_VECTOR |
|
|
|
VEKTOR_BINER |
|
VEKTOR_FLOAT_JARANG |
SPARSE_INVERTED_INDEX |
VARCHAR |
|
BOOL |
|
|
|
|
TERBALIK |
ARRAY (elemen tipe BOOL, INT8/16/32/64, dan VARCHAR) |
BITMAP (Disarankan) |
ARRAY (elemen tipe BOOL, INT8/16/32/64, FLOAT, DOUBLE, dan VARCHAR) |
TERBALIK |
JSON |
TERBALIK |
Artikel ini berfokus pada cara memilih indeks vektor yang tepat. Untuk bidang skalar, Anda selalu dapat menggunakan tipe indeks yang direkomendasikan.
Memilih jenis indeks yang tepat untuk pencarian vektor dapat berdampak signifikan terhadap kinerja dan penggunaan sumber daya. Saat memilih jenis indeks untuk bidang vektor, penting untuk mempertimbangkan berbagai faktor, termasuk struktur data yang mendasarinya, penggunaan memori, dan persyaratan kinerja.
Anatomi Indeks Vektor
Sebagaimana ditunjukkan pada diagram di bawah ini, jenis indeks di Milvus terdiri dari tiga komponen inti, yaitu struktur data, kuantisasi, dan penyaring. Kuantisasi dan penyaring bersifat opsional, tetapi banyak digunakan karena keseimbangan keuntungan yang signifikan yang lebih baik daripada biayanya.
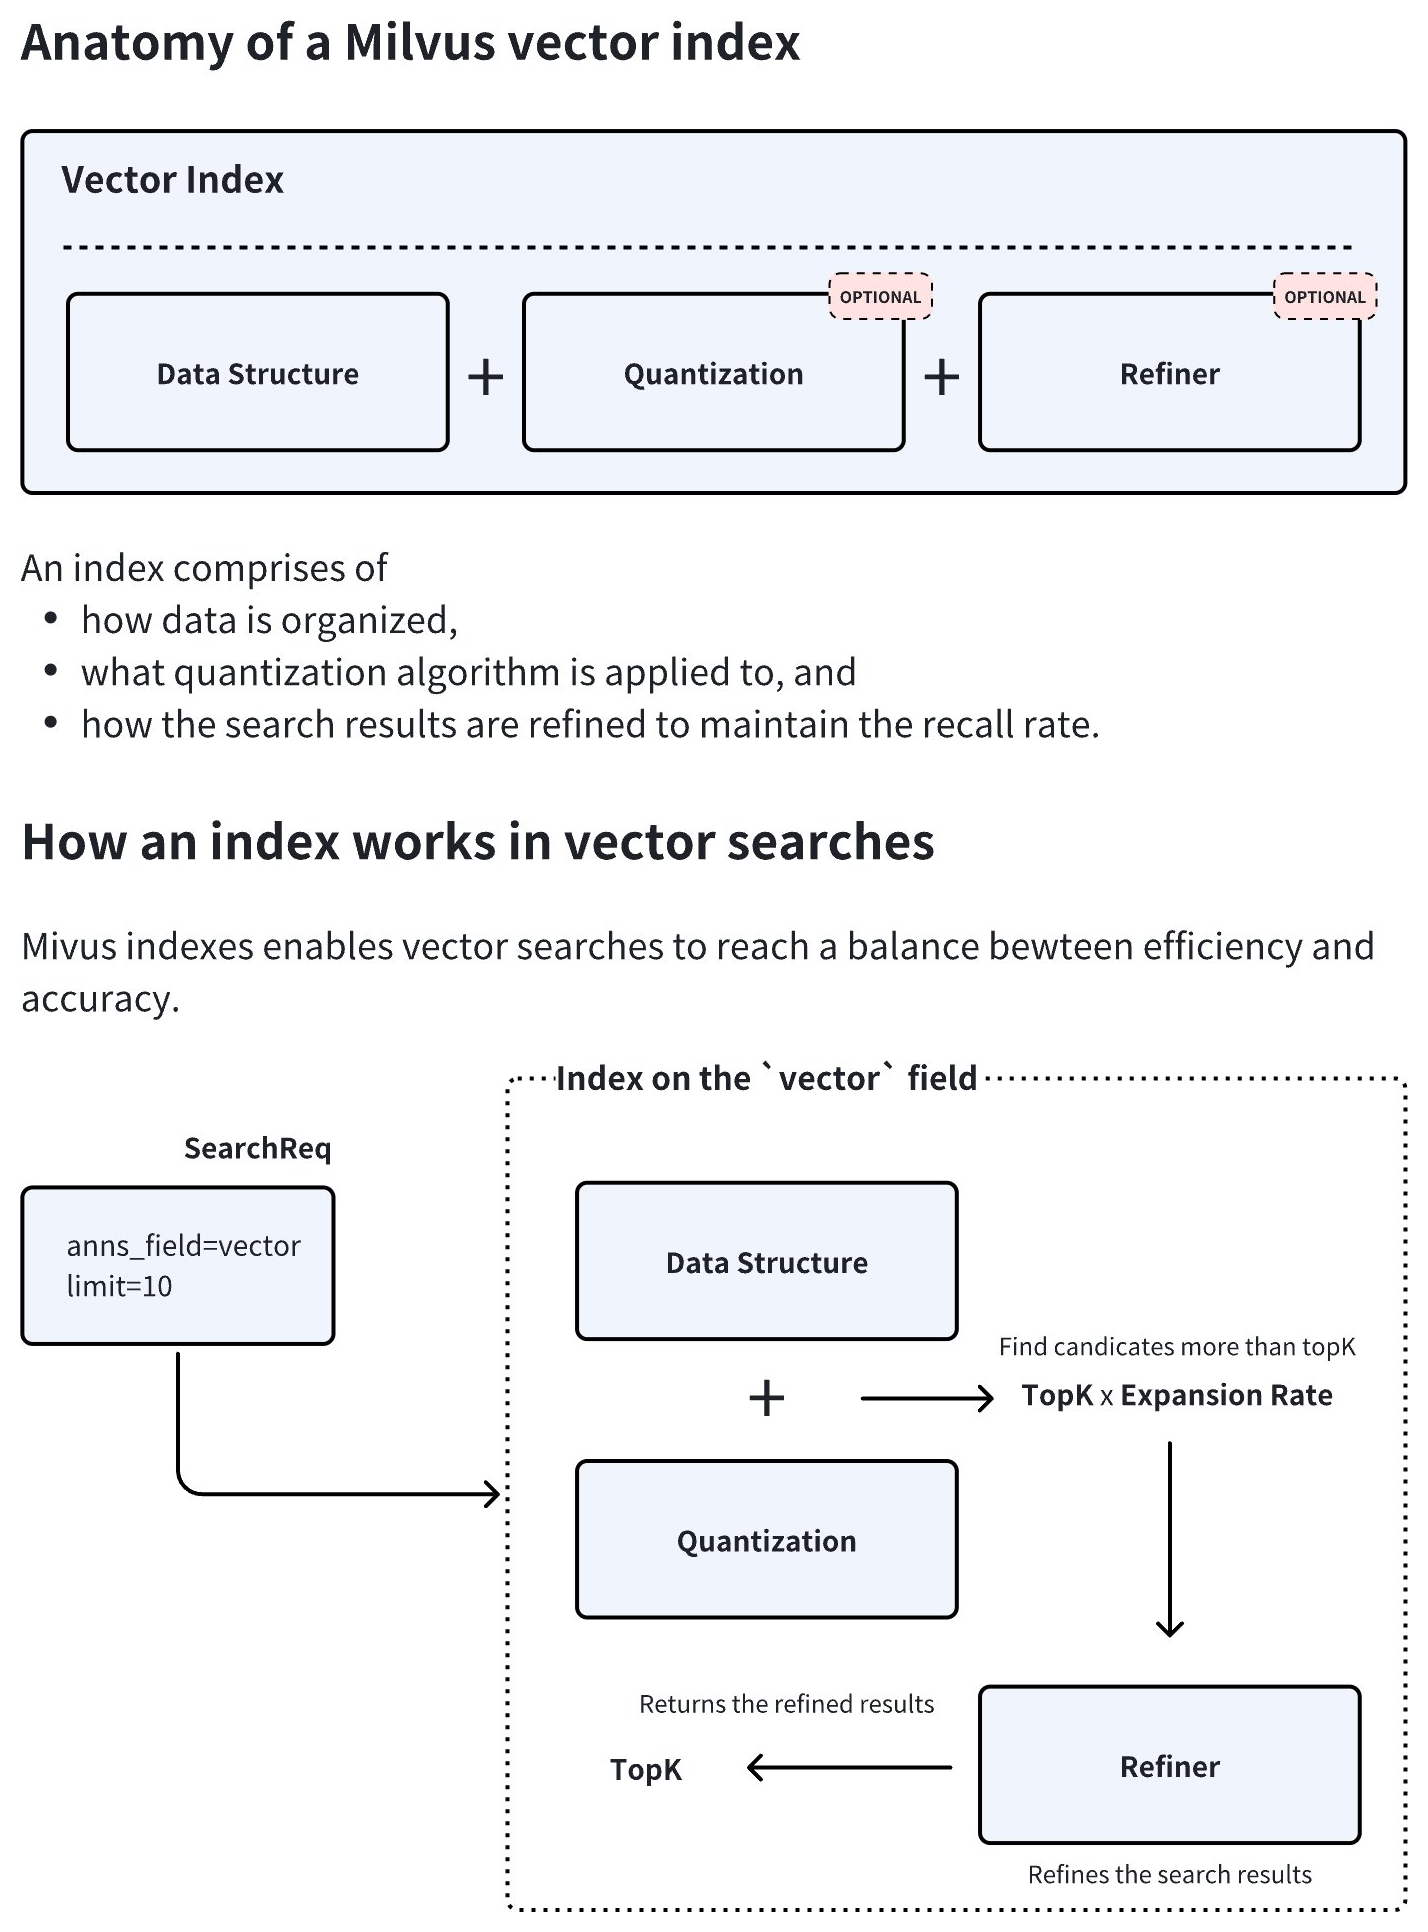 Anatomi Indeks Vektor
Selama pembuatan indeks, Milvus menggabungkan struktur data dan metode kuantisasi yang dipilih untuk menentukan tingkat ekspansi yang optimal. Pada saat kueri, sistem mengambil vektor kandid topK × expansion rate, menerapkan refiner untuk menghitung ulang jarak dengan presisi lebih tinggi, dan akhirnya mengembalikan hasil topK yang paling akurat. Pendekatan hibrida ini menyeimbangkan kecepatan dan akurasi dengan membatasi penyempurnaan yang memakan banyak sumber daya ke subset kandidat yang telah difilter.
Struktur data
Struktur data merupakan lapisan dasar dari indeks. Jenis-jenis yang umum meliputi:
Inverted File (IVF)
Jenis indeks seri IVF memungkinkan Milvus mengelompokkan vektor ke dalam bucket melalui partisi berbasis pusat kluster. Secara umum, aman untuk mengasumsikan bahwa semua vektor dalam sebuah bucket kemungkinan besar berada dekat dengan vektor kueri jika pusat kluster bucket tersebut dekat dengan vektor kueri. Berdasarkan premis ini, Milvus hanya memindai embedding vektor di bucket-bucket yang pusatnya dekat dengan vektor kueri, alih-alih memeriksa seluruh dataset. Strategi ini mengurangi biaya komputasi sambil mempertahankan akurasi yang dapat diterima.
Jenis struktur data indeks ini ideal untuk dataset berskala besar yang membutuhkan throughput yang cepat.
Struktur berbasis graf
Struktur data berbasis graf untuk pencarian vektor, seperti Hierarchical Navigable Small World (HNSW), membangun graf berlapis di mana setiap vektor terhubung ke tetangga terdekatnya. Kueri menelusuri hierarki ini, dimulai dari lapisan atas yang kasar dan beralih ke lapisan bawah, sehingga memungkinkan kompleksitas pencarian waktu logaritmik yang efisien.
Jenis struktur data indeks ini unggul dalam ruang berdimensi tinggi dan skenario yang menuntut kueri dengan latensi rendah.
Kuantisasi
Kuantisasi mengurangi penggunaan memori dan biaya komputasi melalui representasi yang lebih kasar:
Kuantisasi Skalar (mis. SQ8) memungkinkan Milvus mengompres setiap dimensi vektor menjadi satu byte (8-bit), sehingga mengurangi penggunaan memori sebesar 75% dibandingkan dengan bilangan floating-point 32-bit sambil tetap mempertahankan akurasi yang memadai.
Kuantisasi Produk (PQ) memungkinkan Milvus membagi vektor menjadi subvektor dan mengkodekannya menggunakan pengelompokan berbasis buku kode. Hal ini menghasilkan rasio kompresi yang lebih tinggi (misalnya, 4-32x) dengan sedikit penurunan recall, sehingga cocok untuk lingkungan dengan keterbatasan memori.
Refiner
Kuantisasi pada dasarnya bersifat lossy. Untuk mempertahankan tingkat recall, kuantisasi secara konsisten menghasilkan lebih banyak kandidat top-K daripada yang diperlukan, sehingga memungkinkan refiner menggunakan presisi yang lebih tinggi untuk memilih hasil top-K dari kandidat-kandidat tersebut, yang pada akhirnya meningkatkan tingkat recall.
Misalnya, refiner FP32 beroperasi pada kandidat hasil pencarian yang dikembalikan oleh kuantisasi dengan menghitung ulang jarak menggunakan presisi FP32, bukan nilai-nilai yang telah dikuantisasi.
Hal ini sangat penting untuk aplikasi yang memerlukan keseimbangan antara efisiensi pencarian dan presisi, seperti pencarian semantik atau sistem rekomendasi, di mana variasi jarak yang kecil berdampak signifikan terhadap kualitas hasil.
Ringkasan
Arsitektur berjenjang ini – penyaringan kasar melalui struktur data, komputasi efisien melalui kuantisasi, dan penyempurnaan presisi melalui penyempurnaan – memungkinkan Milvus mengoptimalkan keseimbangan antara akurasi dan kinerja secara adaptif.
Kompromi kinerja
Saat mengevaluasi kinerja, sangat penting untuk menyeimbangkan waktu pembangunan, kueri per detik (QPS), dan tingkat recall. Aturan umumnya adalah sebagai berikut:
Jenis indeks berbasis graf biasanya mengungguli varian IVF dalam hal QPS.
Varian IVF sangat cocok untuk skenario dengan topK yang besar (misalnya, lebih dari 2.000).
PQ biasanya menawarkan tingkat recall yang lebih baik pada tingkat kompresi yang serupa jika dibandingkan dengan SQ, meskipun SQ memberikan kinerja yang lebih cepat.
Menggunakan hard drive untuk sebagian indeks (seperti pada DiskANN) membantu mengelola kumpulan data besar, tetapi juga berpotensi menimbulkan kemacetan IOPS.
Kapasitas
Kapasitas biasanya berkaitan dengan hubungan antara ukuran data dan RAM yang tersedia. Saat menangani kapasitas, pertimbangkan hal-hal berikut:
Jika seperempat data mentah Anda muat dalam memori, pertimbangkan DiskANN karena latensinya yang stabil.
Jika seluruh data mentah Anda muat di memori, pertimbangkan jenis indeks berbasis memori dan mmap.
Anda dapat menggunakan jenis indeks yang menerapkan kuantisasi dan mmap untuk menukar akurasi demi kapasitas maksimum.
Mmap tidak selalu menjadi solusi. Ketika sebagian besar data Anda berada di disk, DiskANN memberikan latensi yang lebih baik.
Recall
Recall biasanya melibatkan rasio penyaringan, yang mengacu pada data yang disaring sebelum pencarian. Saat membahas recall, pertimbangkan hal-hal berikut:
Jika rasio penyaringan kurang dari 85%, jenis indeks berbasis graf lebih unggul daripada varian IVF.
Jika rasio penyaringan berada di antara 85% dan 95%, gunakan varian IVF.
Jika rasio penyaringan lebih dari 98%, gunakan Brute-Force (FLAT) untuk hasil pencarian yang paling akurat.
Hal-hal di atas tidak selalu benar. Anda disarankan untuk menyesuaikan recall dengan jenis indeks yang berbeda untuk menentukan jenis indeks mana yang paling efektif.
Kinerja
Kinerja pencarian biasanya melibatkan top-K, yang mengacu pada jumlah catatan yang dihasilkan oleh pencarian. Saat membahas kinerja, pertimbangkan hal-hal berikut:
Untuk pencarian dengan top-K kecil (misalnya, 2.000) yang membutuhkan tingkat recall tinggi, jenis indeks berbasis graf lebih unggul daripada varian IVF.
Untuk pencarian dengan top-K yang besar (dibandingkan dengan jumlah total embedding vektor), varian IVF merupakan pilihan yang lebih baik daripada jenis indeks berbasis graf.
Untuk pencarian dengan top-K berukuran sedang dan rasio filter yang tinggi, varian IVF merupakan pilihan yang lebih baik.
Matriks Keputusan: Memilih jenis indeks yang paling sesuai
Tabel berikut adalah matriks keputusan yang dapat Anda jadikan acuan saat memilih jenis indeks yang sesuai.
Skenario |
Indeks yang Direkomendasikan |
Catatan |
|---|---|---|
Data mentah muat dalam memori |
HNSW, IVF + Penyempurnaan |
Gunakan HNSW untuk low- |
Data mentah di disk, SSD |
DiskANN |
Optimal untuk kueri yang sensitif terhadap latensi. |
Data mentah di disk, RAM terbatas |
IVFPQ/SQ + mmap |
Menyeimbangkan penggunaan memori dan akses disk. |
Rasio penyaringan tinggi (>95%) |
Brute-Force (FLAT) |
Menghindari beban indeks untuk kumpulan kandidat yang sangat kecil. |
|
IVF |
Pemangkasan kluster mengurangi beban komputasi. |
Tingkat recall yang sangat tinggi (>99%) |
Brute-Force (FLAT) + GPU |
-- |
Perkiraan penggunaan memori
Bagian ini berfokus pada perhitungan konsumsi memori dari jenis indeks tertentu dan mencakup banyak detail teknis. Anda dapat melewati bagian ini dengan aman jika tidak sesuai dengan minat Anda.
Konsumsi memori suatu indeks dipengaruhi oleh struktur datanya, tingkat kompresi melalui kuantisasi, dan refiner yang digunakan. Secara umum, indeks berbasis graf biasanya memiliki jejak memori yang lebih besar karena struktur grafnya (misalnya, HNSW), yang biasanya berarti adanya overhead ruang per-vektor yang cukup signifikan. Sebaliknya, IVF dan variannya lebih efisien dalam hal memori karena overhead per ruang vektor yang diterapkan lebih sedikit. Namun, teknik-teknik canggih seperti DiskANN memungkinkan bagian-bagian dari indeks, seperti graf atau refiner, untuk disimpan di disk, sehingga mengurangi beban memori sekaligus mempertahankan kinerja.
Secara spesifik, penggunaan memori suatu indeks dapat dihitung sebagai berikut:
Penggunaan memori indeks IVF
Indeks IVF menyeimbangkan efisiensi memori dengan kinerja pencarian dengan mempartisi data ke dalam kluster. Di bawah ini adalah rincian memori yang digunakan oleh 1 juta vektor berdimensi 128 yang diindeks menggunakan varian IVF.
Hitung memori yang digunakan oleh pusat kluster.
Jenis indeks seri IVF memungkinkan Milvus mengelompokkan vektor ke dalam bucket menggunakan partisi berbasis centroid. Setiap centroid dimasukkan ke dalam indeks dalam bentuk embedding vektor mentah. Saat Anda membagi vektor menjadi 2.000 kluster, penggunaan memori dapat dihitung sebagai berikut:
2,000 clusters × 128 dimensions × 4 bytes = 1.0 MBHitung memori yang digunakan oleh penugasan kluster.
Setiap embedding vektor ditugaskan ke suatu kluster dan disimpan sebagai ID bilangan bulat. Untuk 2.000 kluster, bilangan bulat 2-byte sudah cukup. Penggunaan memori dapat dihitung sebagai berikut:
1,000,000 vectors × 2 bytes = 2.0 MBHitung kompresi yang disebabkan oleh kuantisasi.
Varian IVF biasanya menggunakan PQ dan SQ8, dan penggunaan memori dapat diperkirakan sebagai berikut:
Menggunakan PQ dengan 8 subkuantisator
1,000,000 vectors × 8 bytes = 8.0 MBMenggunakan SQ8
1,000,000 vectors × 128 dimensions × 1 byte = 128 MB
Tabel berikut mencantumkan perkiraan penggunaan memori dengan konfigurasi yang berbeda:
Konfigurasi
Perkiraan Memori
Total Memori
IVF-PQ (tanpa penyempurnaan)
1,0 MB + 2,0 MB + 8,0 MB
11,0 MB
IVF-PQ + penyempurnaan 10% data mentah
1,0 MB + 2,0 MB + 8,0 MB + 51,2 MB
62,2 MB
IVF-SQ8 (tanpa penyempurnaan)
1,0 MB + 2,0 MB + 128 MB
131,0 MB
IVF-FLAT (vektor mentah lengkap)
1,0 MB + 2,0 MB + 512 MB
515,0 MB
Hitung beban pemurnian.
Varian IVF sering dipasangkan dengan refiner untuk menyusun ulang peringkat kandidat. Untuk pencarian yang mengambil 10 hasil teratas dengan tingkat ekspansi 5, overhead penyempurnaan dapat diperkirakan sebagai berikut:
10 (topK) x 5 (expansion rate) = 50 candidates
50 candidates x 128 dimensions x 4 bytes = 25.6 KB
Penggunaan memori indeks berbasis graf
Jenis indeks berbasis graf seperti HNSW memerlukan memori yang signifikan untuk menyimpan struktur graf dan embedding vektor mentah. Di bawah ini adalah rincian terperinci mengenai memori yang digunakan oleh 1 juta vektor berdimensi 128 yang diindeks menggunakan jenis indeks HNSW.
Hitung memori yang digunakan oleh struktur graf.
Setiap vektor dalam HNSW mempertahankan koneksi ke tetangganya. Dengan derajat graf (tepi per simpul) sebesar 32, memori yang digunakan dapat dihitung sebagai berikut:
1,000,000 vectors × 32 links × 4 bytes (for 32-bit integer storage) = 128 MBHitung memori yang digunakan oleh embedding vektor mentah.
Memori yang digunakan untuk menyimpan vektor FP32 yang tidak terkompresi dapat dihitung sebagai berikut:
1,000,000 vectors × 128 dimensions × 4 bytes = 512 MBSaat Anda menggunakan HNSW untuk mengindeks 1 juta embedding vektor 128 dimensi, total memori yang digunakan adalah 128 MB (grafik) + 512 MB (vektor) = 640 MB.
Hitung kompresi yang disebabkan oleh kuantisasi.
Kuantisasi mengurangi ukuran vektor. Misalnya, menggunakan PQ dengan 8 subkuantisator (8 byte per vektor) menghasilkan kompresi yang drastis. Memori yang digunakan oleh vektor embedding terkompresi dapat dihitung sebagai berikut:
1,000,000 vectors × 8 bytes = 8 MBHal ini menghasilkan tingkat kompresi 64 kali lipat jika dibandingkan dengan vektor embedding mentah, dan total memori yang digunakan oleh tipe indeks HNSWPQ adalah 128 MB (grafik) + 8 MB (vektor terkompresi) = 136 MB.
Hitung beban tambahan penyempurnaan.
Penyempurnaan, seperti pemeringkatan ulang dengan vektor mentah, memuat data presisi tinggi ke dalam memori untuk sementara waktu. Untuk pencarian yang mengambil 10 hasil teratas dengan tingkat ekspansi 5, overhead penyempurnaan dapat diperkirakan sebagai berikut:
10 (topK) x 5 (expansion rate) = 50 candidates
50 candidates x 128 dimensions x 4 bytes = 25.6 KB
Pertimbangan lain
Meskipun indeks IVF dan berbasis grafik mengoptimalkan penggunaan memori melalui kuantisasi, file yang dipetakan ke memori (mmap) dan DiskANN menangani skenario di mana kumpulan data melebihi memori akses acak (RAM) yang tersedia.
DiskANN
DiskANN adalah indeks berbasis grafik Vamana yang menghubungkan titik-titik data untuk navigasi yang efisien selama pencarian sambil menerapkan PQ untuk mengurangi ukuran vektor dan memungkinkan perhitungan jarak perkiraan yang cepat antar vektor.
Grafik Vamana disimpan di disk, yang memungkinkan DiskANN menangani kumpulan data besar yang jika tidak akan terlalu besar untuk dimuat dalam memori. Hal ini sangat berguna untuk kumpulan data dengan miliaran titik.
File yang dipetakan ke memori (mmap)
Pemetaan memori (mmap) memungkinkan akses memori langsung ke berkas besar di disk, sehingga Milvus dapat menyimpan indeks dan data baik di memori maupun di hard drive. Pendekatan ini membantu mengoptimalkan operasi I/O dengan mengurangi beban panggilan I/O berdasarkan frekuensi akses, sehingga memperluas kapasitas penyimpanan untuk koleksi tanpa secara signifikan memengaruhi kinerja pencarian.
Secara khusus, Anda dapat mengonfigurasi Milvus untuk memetakan data mentah di bidang-bidang tertentu ke memori, alih-alih memuatnya sepenuhnya ke dalam memori. Dengan cara ini, Anda dapat memperoleh akses memori langsung ke bidang-bidang tersebut tanpa perlu khawatir tentang masalah memori dan memperluas kapasitas koleksi.
