

Hugging Face RankerCompatible with Milvus v2.6.20+
La recherche vectorielle classe les résultats en fonction de la distance vectorielle, mais l'ordre initial peut ne pas refléter la pertinence des réponses textuelles de chaque candidat par rapport à la requête. Hugging Face Ranker envoie la requête et les textes des candidats aux fournisseurs d'inférence Hugging Face hébergés et utilise les scores d'sentence-similarity pour réorganiser l'ordre des candidats renvoyés par Milvus.
Cette intégration utilise le routeur hébergé de Hugging Face. Pour effectuer un reclassement à l’aide d’un service Text Embeddings Inference (TEI) déployé séparément, consultez TEI Ranker.
Limites
- La fonction doit référencer exactement un champ «
VARCHAR» non nul dansinput_field_names. - Le nombre de chaînes de caractères dans `
queries` doit être égal au nombre de requêtes de recherche (nq).
Fonctionnement
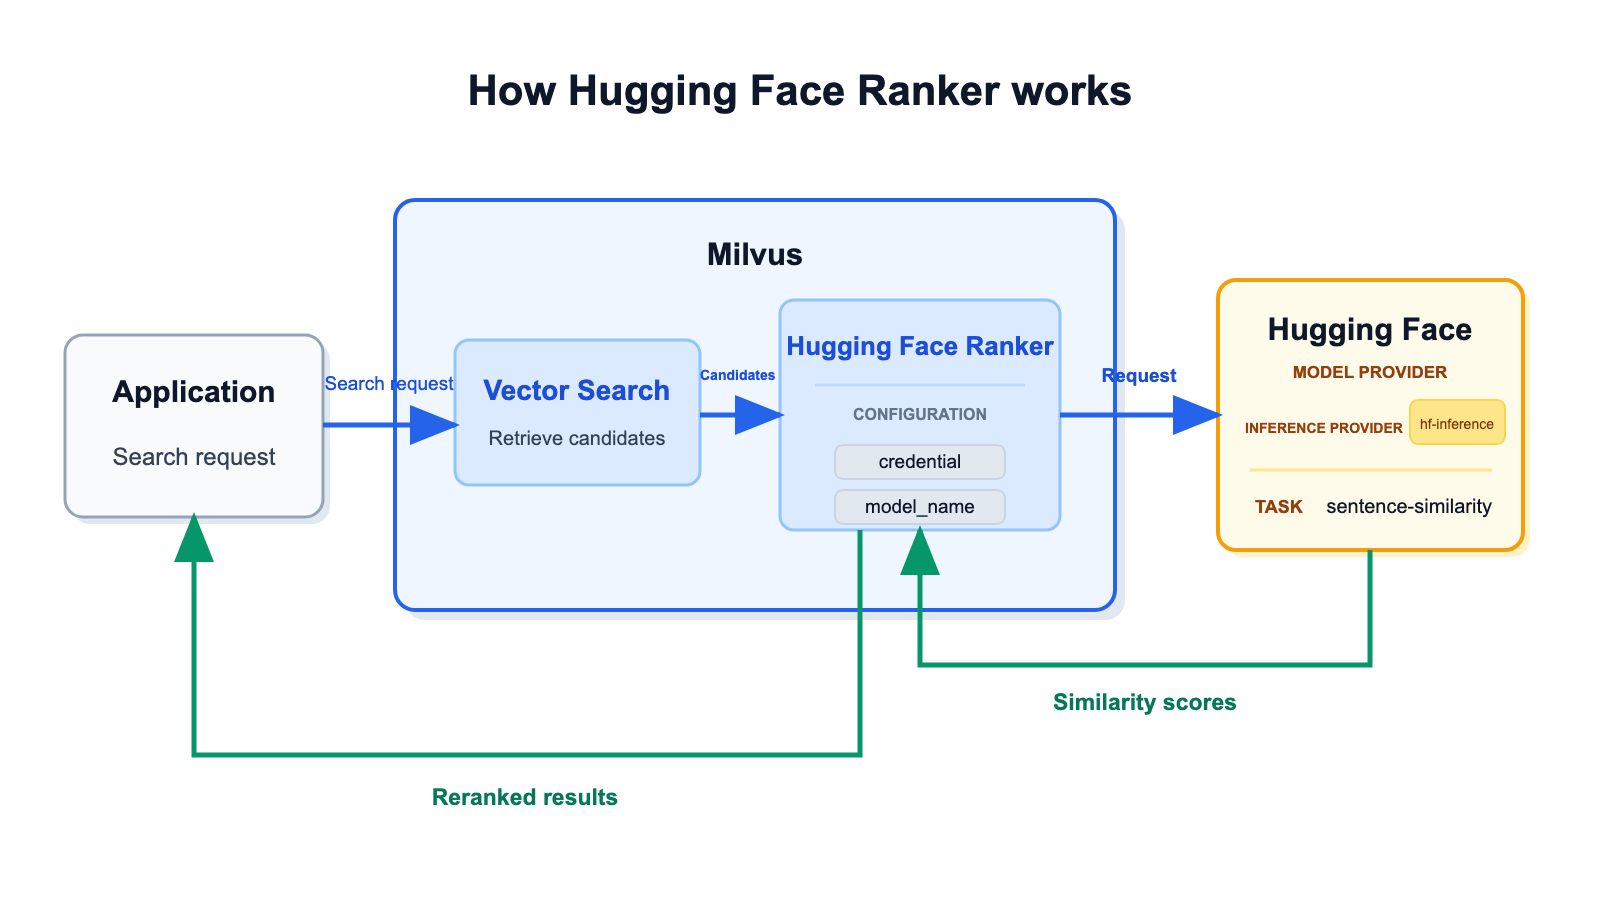 Workflow de Hugging Face Ranker
Hugging Face Ranker s'exécute après la recherche vectorielle initiale :
- Récupération des entités candidates. Milvus effectue une recherche dans le champ vectoriel configuré et collecte les entités candidates.
- Préparation du texte pour le reclassement. La fonction lit le texte de la requête à partir de
params.querieset le texte des entités candidates à partir du champVARCHARspécifié dansinput_field_names. - Demande des scores de similarité. Milvus envoie la requête via
source_sentenceet les textes candidats viasentences, en passant parhf-inference, vers le pipeline Hugging Facesentence-similarity. - Réclassement des candidats. Hugging Face renvoie un score par candidat. Milvus classe les candidats du score le plus élevé au plus bas et renvoie les résultats reclassés.
Comment les scores de similarité sont-ils calculés ?
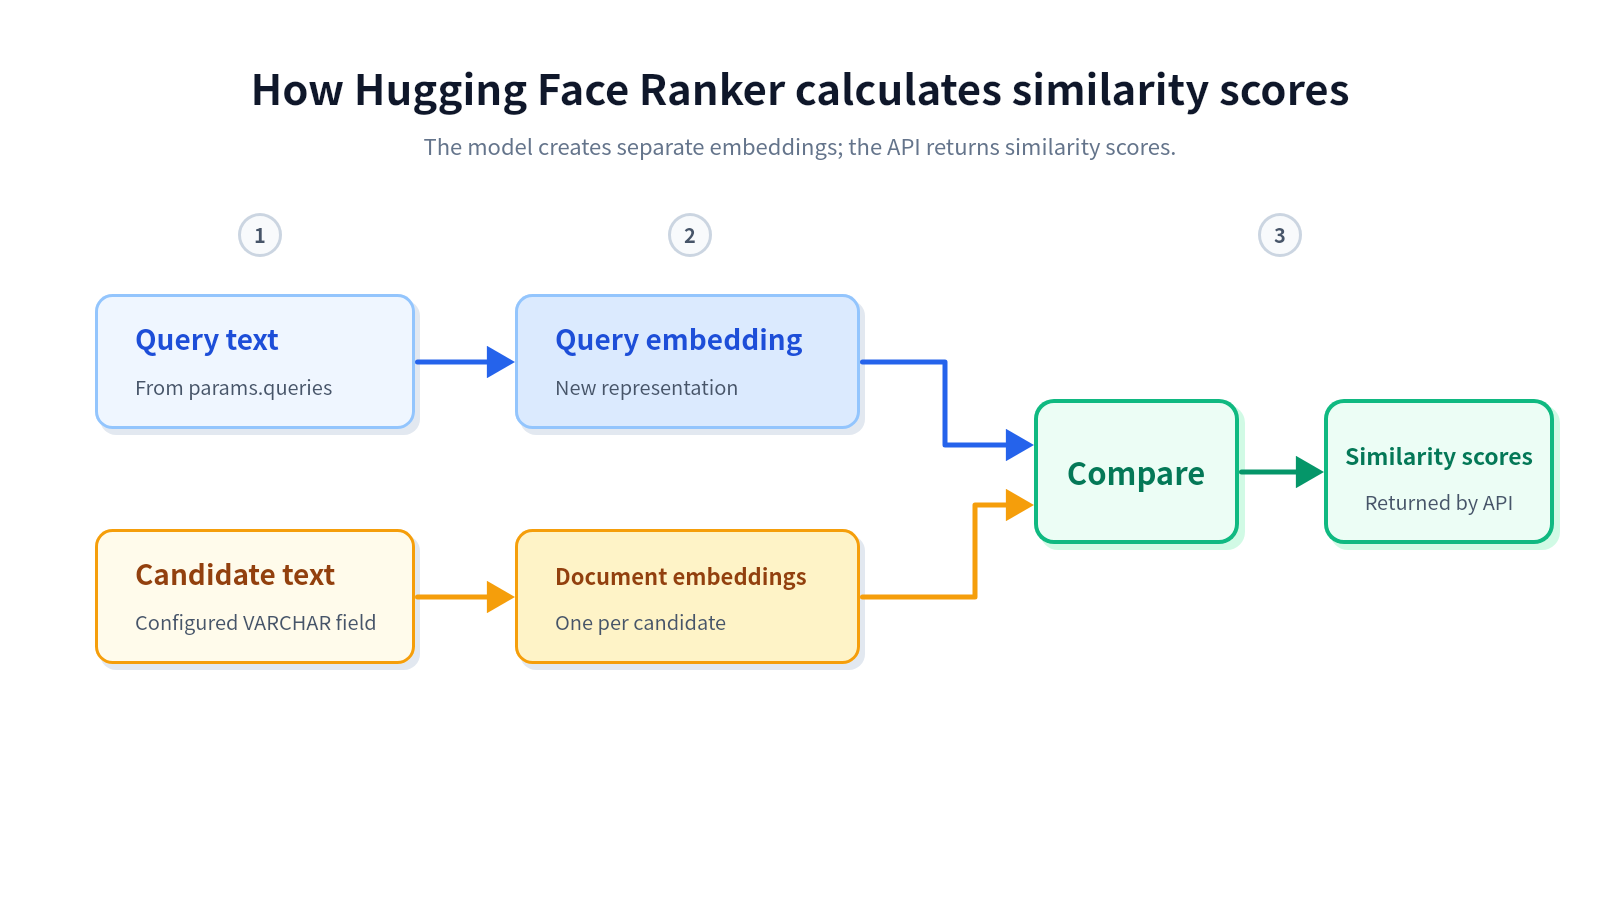 Comment Hugging Face Ranker calcule les scores de similarité
Le modèle Hugging Face calcule les scores en trois étapes :
- Préparation des entrées textuelles. Le Ranker lit le texte de la requête à partir de
params.querieset le texte des candidats à partir du champVARCHARconfiguré. - Création de représentations distinctes pour le modèle. Milvus envoie la requête sous la forme
source_sentenceet les textes candidats sous la formesentences. Le modèle encode en interne la requête et chaque candidat séparément. - Comparaison et retour des scores. Le modèle compare la représentation de la requête à celle de chaque candidat et renvoie un score de similarité par candidat.
Les embeddings ou représentations utilisés par le modèle Hugging Face constituent une étape intermédiaire du traitement du modèle. Hugging Face renvoie des scores, et non des vecteurs. La récupération initiale des vecteurs et le reclassement par le modèle utilisent donc des représentations distinctes et peuvent faire appel à des modèles différents.
Avant de commencer
Avant d’utiliser Hugging Face Ranker, assurez-vous de disposer de :
- Milvus 2.6.20 ou une version ultérieure de la branche 2.6.
- PyMilvus 2.6.16 ou une version ultérieure.
- Un jeton d’accès utilisateur Hugging Face permettant d’appeler les fournisseurs d’inférence.
- Un modèle actuellement hébergé par
hf-inferencepour lasentence-similaritytâche. - Une collection stockant les textes candidats dans un champ
VARCHARnon nul.
Milvus ne contrôle pas si un modèle Hugging Face reste disponible via hf-inference, ni si le modèle répond à vos exigences en matière de stabilité, de latence et de qualité de sortie. Vérifiez le modèle sur Hugging Face et évaluez-le pour votre charge de travail avant de l’utiliser en production.
Les exemples utilisent sentence-transformers/all-MiniLM-L6-v2 uniquement à des fins de démonstration de la configuration. Le modèle ne constitue ni une recommandation ni une certification de la part de Milvus.
Configurer les identifiants
Vous pouvez configurer le jeton d’accès utilisateur Hugging Face sur milvus.yaml ou via une variable d’environnement.
L'ordre de priorité des identifiants est le suivant :
Function credential label -> provider credential label in milvus.yaml -> environment variable
Option 1 : Fichier de configuration
Définissez le jeton dans la section de niveau supérieur « credential », puis pointez le fournisseur de classement Hugging Face vers le libellé des identifiants :
# milvus.yaml
credential:
  huggingface_apikey:
    apikey: <YOUR_HUGGING_FACE_TOKEN>

function:
  rerank:
    model:
      providers:
        huggingface:
          credential: huggingface_apikey
          # url: https://router.huggingface.co
Un paramètre « credential » au niveau de la fonction peut remplacer le libellé au niveau du fournisseur. Sa valeur doit être un libellé d’identifiant défini dans milvus.yaml, et non le jeton lui-même.
Option 2 : variable d’environnement
Si ni la configuration de la fonction ni celle du fournisseur ne spécifient de libellé d’ MILVUS_HUGGINGFACE_API_KEY, définissez l’ dans l’environnement du service Milvus :
# docker-compose.yaml
standalone:
  environment:
    MILVUS_HUGGINGFACE_API_KEY: <YOUR_HUGGING_FACE_TOKEN>
Utilisation de Hugging Face Ranker
Hugging Face Ranker est défini et appliqué au moment de la recherche. Vous pouvez modifier ou omettre le ranker pour chaque recherche sans modifier le schéma de la collection.
Étape 1 : Préparer une collection
L'exemple suivant crée une collection comportant un champ de texte pour le reclassement et un champ vectoriel pour la recherche initiale :
from pymilvus import DataType, Function, FunctionType, MilvusClient

client = MilvusClient(uri="http://localhost:19530")

collection_name = "hugging_face_rerank_demo"
schema = client.create_schema()
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=1000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=4)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE",
)

client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
)

client.insert(
    collection_name=collection_name,
    data=[
        {
            "id": 1,
            "document": "Recent renewable energy developments include improved solar efficiency.",
            "dense": [0.10, 0.20, 0.30, 0.40],
        },
        {
            "id": 2,
            "document": "Climate policy and carbon markets have evolved rapidly in recent years.",
            "dense": [0.11, 0.19, 0.28, 0.39],
        },
        {
            "id": 3,
            "document": "New battery technology helps stabilize wind and solar power generation.",
            "dense": [0.90, 0.10, 0.05, 0.02],
        },
        {
            "id": 4,
            "document": "Vector databases support similarity search for machine learning applications.",
            "dense": [0.01, 0.02, 0.03, 0.04],
        },
    ],
)
Étape 2 : Définir la fonction de reclassement
Définissez une fonction « RERANK » qui lit le texte des candidats à partir de document et utilise le texte de la requête dans queries:
hugging_face_ranker = Function(
    name="hugging_face_semantic_ranker",
    input_field_names=["document"],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "model",
        "provider": "huggingface",
        "model_name": "sentence-transformers/all-MiniLM-L6-v2",
        "hf_provider": "hf-inference",
        "queries": ["renewable energy developments"],
        "credential": "huggingface_apikey",
        "max_client_batch_size": 32,
    },
)
Si vous utilisez uniquement les identifiants au niveau du fournisseur ou une variable d’environnement, omettez credential des paramètres de la fonction.
Le tableau suivant décrit les paramètres de Hugging Face Ranker :
| Paramètre | Obligatoire ? | Description |
|---|---|---|
reranker | Oui | Implémentation du reclassement. Définissez cette valeur sur « model ». |
provider | Oui | Le fournisseur de modèle. Définissez cette valeur sur huggingface. |
model_name | Oui | L'ID du modèle Hugging Face pour un modèle fourni via hf-inference pour la tâche « sentence-similarity ». |
queries | Oui | Chaînes de requête utilisées pour le reclassement. Indiquez exactement une chaîne par requête de recherche, même lorsque la récupération initiale utilise des vecteurs de requête. |
hf_provider | Non | La route du fournisseur d’inférence Hugging Face. La valeur par défaut et la seule prise en charge dans Milvus 2.6.20 est hf-inference. |
credential | Non | L'étiquette d'un identifiant défini dans la section de niveau supérieur credential de milvus.yaml. Cette valeur n'est pas le jeton lui-même. |
max_client_batch_size | Non | Le nombre maximal de textes candidats envoyés dans une seule requête Hugging Face. La valeur par défaut est 32, et cette valeur doit être supérieure à 0. |
Étape 3 : Effectuer une recherche avec le classificateur
Transmettez la fonction via le paramètre ranker de search():
query_vector = [0.12, 0.21, 0.29, 0.41]

results = client.search(
    collection_name=collection_name,
    data=[query_vector],
    anns_field="dense",
    limit=3,
    output_fields=["document"],
    ranker=hugging_face_ranker,
    consistency_level="Strong",
)

print(results)
Milvus récupère d’abord les candidats à partir de dense, puis utilise le texte de la requête dans queries et le texte des candidats dans document pour calculer les scores de similarité des phrases. Les candidats renvoyés sont classés selon les scores Hugging Face.
Dépannage
Le modèle n’est pas disponible pour la similarité des phrases
Ouvrez la page du modèle sur Hugging Face et consultez la section « Inference Providers ». Vérifiez que hf-inference héberge bien le modèle pour sentence-similarity. Si ce n’est pas le cas, sélectionnez un autre modèle prenant en charge cette tâche.
Le nombre de chaînes de requête ne correspond pas à la requête de recherche
Le nombre de chaînes dans « queries » doit être égal au nombre de requêtes de recherche (nq). Pour une recherche avec un seul vecteur de requête, fournissez exactement une chaîne de requête.
Le texte candidat est manquant ou peut être nul
Assurez-vous que input_field_names contient exactement un champ VARCHAR non nul et que chaque entité candidate contient du texte dans ce champ.
Milvus signale l’absence d’identifiants Hugging Face
Vérifiez que le libellé « Function credential » existe dans ` milvus.yaml`, que le libellé au niveau du fournisseur est valide ou que ` MILVUS_HUGGINGFACE_API_KEY ` est présent dans l’environnement de service Milvus.
Étapes suivantes
- Pour connaître le comportement et les limites du Model Ranker partagé, consultez la présentation du Model Ranker.
- Pour générer des représentations vectorielles via les fournisseurs d’inférence Hugging Face hébergés, consultez la section Hugging Face.
- Pour appliquer le classificateur à la recherche hybride, consultez la section « Recherche hybride multi-vecteurs ».
