

Hugging FaceCompatible with Milvus v2.6.20+
L'utilisation d'un modèle d'embedding Hugging Face nécessite généralement que votre application gère les identifiants, appelle le modèle séparément et génère des embeddings de manière cohérente pour les données insérées et les requêtes de recherche. Grâce à la fonction d'embedding de texte, Milvus appelle les fournisseurs d'inférence Hugging Face hébergés pour convertir le texte brut en vecteurs lors de l'insertion et de la recherche.
Cette intégration utilise le routeur hébergé de Hugging Face. Pour connecter Milvus à un service d’inférence d’encodage de texte (TEI) déployé séparément, consultez la documentation Hugging Face TEI.
Limites
- Le champ de sortie de la fonction doit utiliser le type de données «
FLOAT_VECTOR». L’encodage Hugging Face dans Milvus ne prend pas en charge les champs de sortie de type «INT8_VECTOR», «BINARY_VECTOR», «FLOAT16_VECTOR» ou «BFLOAT16_VECTOR». - La dimension du champ de sortie « Function » doit correspondre à la dimension de sortie du modèle sélectionné.
Fonctionnement
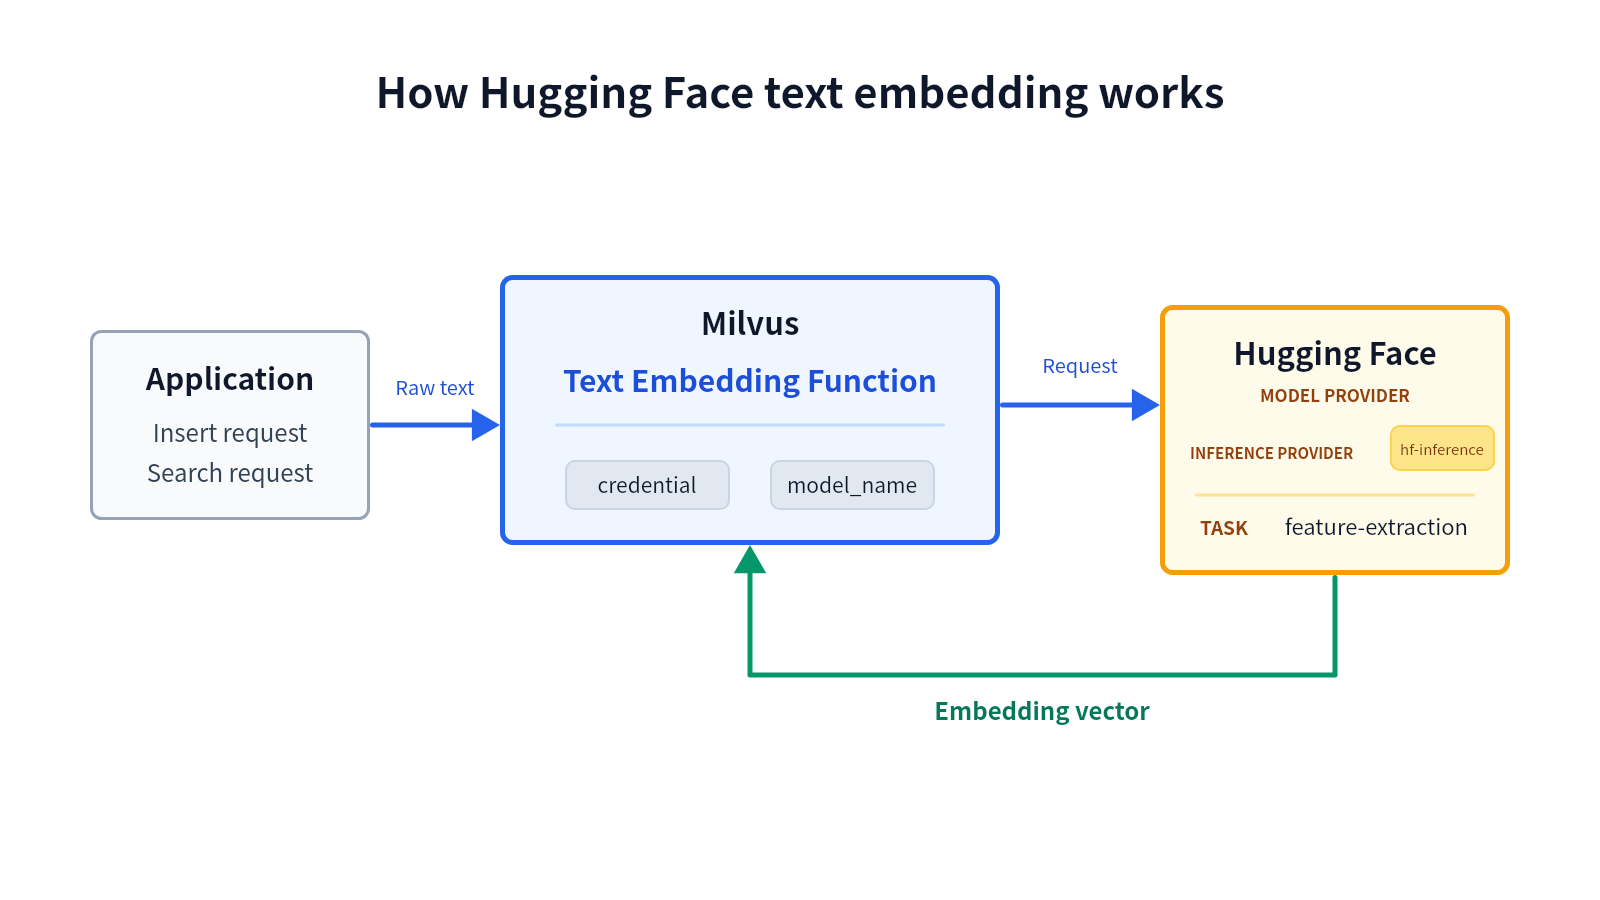 Workflow d’embedding de texte Hugging Face
Le workflow comporte trois étapes :
- Envoi du texte brut. Votre application fournit le texte brut dans une requête d’insertion ou de recherche.
- Générer un vecteur d’encodage. La fonction « Text Embedding » transmet le texte via
hf-inferenceau pipeline d’feature-extractions de Hugging Face. La fonction utilisemodel_namepour sélectionner le modèle et peut transmettre des options d’inférence prises en charge, telles que la normalisation et la troncature. - Utiliser l’embedding. Hugging Face renvoie un embedding à virgule flottante par texte d’entrée. Lors d’une insertion, Milvus stocke le vecteur dans le champ de sortie de la fonction. Lors d’une recherche, Milvus utilise le vecteur comme vecteur de requête.
La même configuration de fonction gère à la fois l’insertion et la recherche, ce qui garantit la cohérence du modèle et des paramètres d’inférence entre ces deux opérations.
Avant de commencer
Avant d’utiliser l’encodage de texte hébergé par Hugging Face, assurez-vous de disposer :
- Milvus 2.6.20 ou une version ultérieure de la branche 2.6.
- PyMilvus 2.6.16 ou une version ultérieure.
- Un jeton d’accès utilisateur Hugging Face permettant d’appeler les fournisseurs d’inférence.
- Un modèle actuellement hébergé par
hf-inferencepour lafeature-extractiontâche.
Milvus ne contrôle pas si un modèle Hugging Face reste disponible via hf-inference, ni si ce modèle répond à vos exigences en matière de stabilité, de latence et de qualité de sortie. Vérifiez le modèle sur Hugging Face et évaluez-le pour votre charge de travail avant de l’utiliser en production.
Les exemples utilisent sentence-transformers/all-MiniLM-L6-v2, qui produit des représentations de 384 dimensions. Ce modèle sert uniquement à illustrer la configuration et ne constitue ni une recommandation ni une certification de la part de Milvus.
Configurer les identifiants
Milvus nécessite un jeton d’accès utilisateur Hugging Face pour appeler le routeur hébergé. Vous pouvez configurer ce jeton sur milvus.yaml ou via une variable d’environnement.
L'ordre de priorité des identifiants est le suivant :
Function credential label -> provider credential label in milvus.yaml -> environment variable
Option 1 : Fichier de configuration
Définissez le jeton dans la section de niveau supérieur credential de milvus.yaml, puis pointez le fournisseur d’embeddings Hugging Face vers ce libellé d’identifiant :
# milvus.yaml
credential:
  huggingface_apikey:
    apikey: <YOUR_HUGGING_FACE_TOKEN>

function:
  textEmbedding:
    providers:
      huggingface:
        credential: huggingface_apikey
        # url: https://router.huggingface.co
Vous pouvez également définir credential dans les paramètres de la fonction. La valeur doit correspondre au libellé défini dans la section de niveau supérieur credential, et non au jeton lui-même. Un libellé d’identifiant au niveau de la fonction a priorité sur celui au niveau du fournisseur.
Option 2 : variable d’environnement
Si ni la configuration de la fonction ni celle du fournisseur ne spécifient de libellé d’identifiant, Milvus lit le jeton à partir de ` MILVUS_HUGGINGFACE_API_KEY`.
Pour Docker Compose, définissez la variable dans le service autonome Milvus :
# docker-compose.yaml
standalone:
  environment:
    MILVUS_HUGGINGFACE_API_KEY: <YOUR_HUGGING_FACE_TOKEN>
Pour plus de détails sur l’application des paramètres Docker Compose, consultez la section « Configurer Milvus avec Docker Compose ».
Utiliser l’embedding de texte Hugging Face
Étape 1 : Créer une collection avec une fonction d’encodage de texte
Créez un schéma comportant un champ principal, un champ d’entrée « VARCHAR » et un champ de sortie « FLOAT_VECTOR ». La dimension de sortie doit correspondre au modèle sélectionné.
from pymilvus import DataType, Function, FunctionType, MilvusClient

client = MilvusClient(uri="http://localhost:19530")

collection_name = "hugging_face_embedding_demo"
schema = client.create_schema()

schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)
schema.add_field(
    field_name="document",
    datatype=DataType.VARCHAR,
    max_length=9000,
)
schema.add_field(
    field_name="dense",
    datatype=DataType.FLOAT_VECTOR,
    dim=384,
)
Définissez une fonction « TEXTEMBEDDING » qui écrit les représentations de « document » vers « dense » :
text_embedding_function = Function(
    name="hugging_face_embedding",
    input_field_names=["document"],
    output_field_names=["dense"],
    function_type=FunctionType.TEXTEMBEDDING,
    params={
        "provider": "huggingface",
        "model_name": "sentence-transformers/all-MiniLM-L6-v2",
        "hf_provider": "hf-inference",
        "credential": "huggingface_apikey",
        "normalize": "true",
        "truncate": "true",
        "max_client_batch_size": 128,
    },
)

schema.add_function(text_embedding_function)
Si vous utilisez uniquement les informations d’identification au niveau du fournisseur ou la variable d’environnement, omettez « credential » des paramètres de la fonction.
Configurez un index pour le champ de sortie, puis créez la collection :
index_params = client.prepare_index_params()
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE",
)

client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
)
Le tableau suivant décrit les paramètres de la fonction spécifiques à Hugging Face :
| Paramètre | Obligatoire ? | Description |
|---|---|---|
provider | Oui | Le fournisseur du modèle d'embedding. Définissez cette valeur sur huggingface. |
model_name | Oui | L'ID du modèle Hugging Face pour un modèle hébergé sur hf-inference pour la tâche « feature-extraction ». |
hf_provider | Non | La route du fournisseur d’inférence Hugging Face. La valeur par défaut et la seule prise en charge dans Milvus 2.6.20 est hf-inference. |
credential | Non | L'étiquette d'un identifiant défini dans la section de niveau supérieur credential de milvus.yaml. Cette valeur n'est pas le jeton lui-même. |
normalize | Non | Indique si Hugging Face doit renvoyer des représentations normalisées. Les valeurs prises en charge sont true et false. Si cette option est omise, Milvus ne la définit pas dans la requête. |
prompt_name | Non | Nom d’une invite définie dans la configuration « Sentence Transformers » du modèle sélectionné. |
truncate | Non | Indique si Hugging Face doit tronquer une entrée qui dépasse la longueur prise en charge par le modèle. Les valeurs prises en charge sont « true » et « false ». |
truncation_direction | Non | Direction à partir de laquelle Hugging Face tronque une entrée. Les valeurs prises en charge sont « left » et « right ». |
max_client_batch_size | Non | Nombre maximal de textes d’entrée envoyés dans une seule requête Hugging Face. La valeur par défaut est 128, et la valeur doit être supérieure à 0. |
Étape 2 : Insérer du texte brut
Insérez du texte sans fournir de vecteurs. Milvus appelle Hugging Face et écrit les embeddings générés dans dense.
client.insert(
    collection_name=collection_name,
    data=[
        {
            "id": 1,
            "document": "Milvus simplifies semantic search through embeddings.",
        },
        {
            "id": 2,
            "document": "Vector embeddings convert text into searchable numeric data.",
        },
        {
            "id": 3,
            "document": "Semantic search helps users find relevant information quickly.",
        },
    ],
)
Étape 3 : Recherche avec du texte brut
Effectuez une recherche à l’aide d’une requête textuelle. Milvus applique la même configuration de fonction pour créer le vecteur de requête avant d’exécuter la recherche vectorielle.
results = client.search(
    collection_name=collection_name,
    data=["How does Milvus handle semantic search?"],
    anns_field="dense",
    limit=3,
    output_fields=["document"],
    consistency_level="Strong",
)

print(results)
Le résultat contient les documents les plus pertinents par rapport au texte de la requête, classés par similarité cosinus.
Dépannage
Le modèle n’est pas disponible pour l’extraction de caractéristiques
Ouvrez la page du modèle sur Hugging Face et consultez la section « Inference Providers ». Vérifiez que « hf-inference » fournit le modèle pour « feature-extraction ». Si ce n'est pas le cas, sélectionnez un autre modèle et mettez à jour la dimension du champ vectoriel si nécessaire.
La dimension du vecteur renvoyé ne correspond pas au champ
Vérifiez la dimension de sortie du modèle et comparez-la à celle indiquée sur dim dans le champ « Function output ». Milvus rejette toute réponse dont la dimension du vecteur diffère de celle du champ « FLOAT_VECTOR ».
Milvus signale l’absence d’identifiants Hugging Face
Vérifiez que le libellé des identifiants de la fonction existe bien dans la section de niveau supérieur « credential », que le libellé au niveau du fournisseur est valide, ou que « MILVUS_HUGGINGFACE_API_KEY » est présent dans l’environnement de service Milvus.
Étapes suivantes
- Pour les concepts généraux relatifs aux fonctions et le comportement d’insertion/recherche, consultez la présentation des fonctions d’intégration.
- Pour reclasser les candidats à la recherche vectorielle à l’aide des scores de similarité de phrases fournis par Hugging Face, consultez la section « Hugging Face Ranker ».
