

Présentation des options de déploiement de Milvus
Milvus est une base de données vectorielle hautement performante et évolutive. Elle prend en charge des cas d'utilisation de tailles très variées, allant des démos exécutées localement dans Jupyter Notebooks aux clusters Kubernetes à très grande échelle traitant des dizaines de milliards de vecteurs. Actuellement, il existe trois options de déploiement de Milvus : Milvus Lite, Milvus Standalone et Milvus Distributed.
Milvus Lite
Milvus Lite est une bibliothèque Python pouvant être importée dans vos applications. En tant que version allégée de Milvus, elle est idéale pour le prototypage rapide dans Jupyter Notebooks ou pour une exécution sur des appareils intelligents disposant de ressources limitées. Milvus Lite prend en charge les mêmes API que les autres déploiements Milvus. Le code côté client interagissant avec Milvus Lite peut également fonctionner avec des instances Milvus dans d’autres modes de déploiement.
Pour intégrer Milvus Lite à vos applications, exécutez la commande « pip install pymilvus » afin de l’installer, puis utilisez l’instruction « MilvusClient("./demo.db") » pour instancier une base de données vectorielle à partir d’un fichier local qui conserve toutes vos données. Pour plus de détails, consultez la section « Exécuter Milvus Lite ».
Milvus Standalone
Milvus Standalone est un déploiement serveur sur une seule machine. Tous les composants de Milvus Standalone sont regroupés dans une seule image Docker, ce qui facilite le déploiement. Si vous avez une charge de travail en production mais que vous préférez ne pas utiliser Kubernetes, l’exécution de Milvus Standalone sur une seule machine disposant d’une mémoire suffisante est une bonne option. Par défaut, Milvus Standalone utilise Woodpecker (intégré) comme file d’attente de messages ; il n’y a donc pas de service de messagerie distinct à gérer.
Milvus Distributed
Milvus Distributed peut être déployé sur des clusters Kubernetes. Ce déploiement repose sur une architecture cloud native, dans laquelle la charge d’ingestion et les requêtes de recherche sont gérées séparément par des nœuds isolés, ce qui permet d’assurer la redondance des composants critiques. Il offre une évolutivité et une disponibilité optimales, ainsi qu’une grande flexibilité pour personnaliser les ressources allouées à chaque composant. Milvus Distributed est le choix idéal pour les entreprises exploitant des systèmes de recherche vectorielle à grande échelle en production. Par défaut, Milvus Distributed utilise Woodpecker comme file d’attente de messages, déployé en tant que service dédié aux côtés de Milvus.
Choisissez le mode de déploiement adapté à votre cas d’utilisation
Le choix d’un mode de déploiement dépend généralement du stade de développement de votre application :
Pour un prototypage rapide
Si vous souhaitez créer rapidement un prototype ou à des fins d’apprentissage, par exemple des démos de « Retrieval Augmented Generation » (RAG), des chatbots IA ou la recherche multimodale, Milvus Lite seul ou une combinaison de Milvus Lite et de Milvus Standalone convient parfaitement. Vous pouvez utiliser Milvus Lite dans des notebooks pour un prototypage rapide et explorer diverses approches, telles que différentes stratégies de découpage en segments (chunking) dans le RAG. Vous souhaiterez peut-être déployer l’application créée avec Milvus Lite dans un environnement de production à petite échelle pour servir de vrais utilisateurs, ou valider le concept sur des ensembles de données plus volumineux, par exemple dépassant quelques millions de vecteurs. Milvus Standalone est alors la solution appropriée. La logique d’application de Milvus Lite peut toujours être partagée, car tous les déploiements Milvus disposent de la même API côté client. Les données stockées dans Milvus Lite peuvent également être transférées vers Milvus Standalone à l’aide d’un outil en ligne de commande.
Déploiement en production à petite échelle
Pour les premières phases de production, lorsque le projet cherche encore à trouver son adéquation produit-marché et que l’agilité prime sur l’évolutivité, Milvus Standalone est le meilleur choix. Il peut tout de même prendre en charge jusqu’à 100 millions de vecteurs si les ressources matérielles sont suffisantes, tout en nécessitant beaucoup moins d’interventions DevOps que la maintenance d’un cluster K8s.
Déploiement en production à grande échelle
À mesure que votre entreprise connaît une croissance rapide et que le volume de données dépasse la capacité d’un seul serveur, il est temps d’envisager Milvus Distributed. Vous pouvez continuer à utiliser Milvus Standalone pour les environnements de développement ou de préproduction en raison de sa simplicité d’utilisation, tout en exploitant le cluster K8s sur lequel s’exécute Milvus Distributed. Cette configuration vous permettra de gérer des dizaines de milliards de vecteurs, tout en vous offrant la flexibilité nécessaire pour adapter la taille des nœuds à votre charge de travail spécifique, qu’il s’agisse de cas à forte lecture et écriture peu fréquente ou à forte écriture et faible lecture.
Recherche locale sur les terminaux périphériques
Pour effectuer des recherches sur des données privées ou sensibles au niveau des terminaux, vous pouvez déployer Milvus Lite directement sur le terminal sans avoir recours à un service cloud pour la recherche de texte ou d’images. Cette solution est adaptée à des cas tels que la recherche dans des documents propriétaires ou la détection d’objets directement sur le terminal.
Le choix du mode de déploiement de Milvus dépend du stade et de l’ampleur de votre projet. Milvus offre une solution flexible et puissante adaptée à divers besoins, du prototypage rapide au déploiement d’entreprise à grande échelle.
- Milvus Lite est recommandé pour les petits ensembles de données, jusqu’à quelques millions de vecteurs.
- Milvus Standalone convient aux ensembles de données de taille moyenne, pouvant aller jusqu’à 100 millions de vecteurs.
- Milvus Distributed est conçu pour les déploiements à grande échelle, capable de gérer des ensembles de données allant de 100 millions à plusieurs dizaines de milliards de vecteurs.
Quel que soit le mode de déploiement, chaque instance Milvus s'appuie sur une file d'attente de messages, un stockage d'objets et un magasin de métadonnées — par défaut, Woodpecker, MinIO et etcd. Pour en savoir plus sur ces dépendances, les configurer ou connecter des services externes, consultez la section Infrastructure de données.
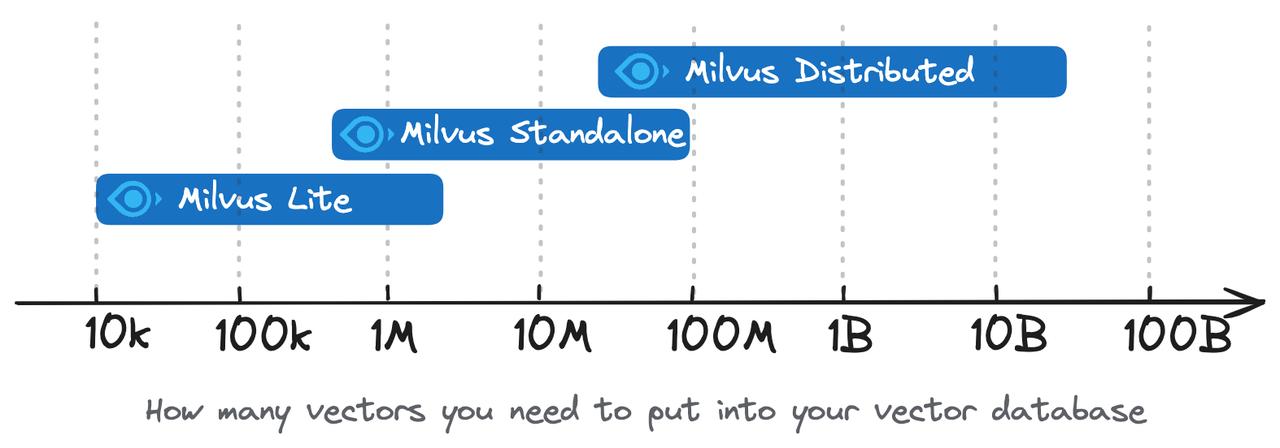 Sélectionnez l’option de déploiement adaptée à votre cas d’utilisation
Comparaison des fonctionnalités
| Fonctionnalité | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / Bibliothèque client | Python gRPC | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| Types de données | Vecteur dense Vecteur creux Vecteur binaire Booléen Entier Nombre à virgule flottante VarChar Tableau JSON | Vecteur dense Vecteur creux Vecteur binaire Booléen Entier Nombre à virgule flottante VarChar Tableau JSON | Vecteur dense Vecteur creux Vecteur binaire Booléen Entier Nombre à virgule flottante VarChar Tableau JSON |
| Fonctionnalités de recherche | Recherche vectorielle (recherche ANN) Filtrage par métadonnées Recherche par plage Requête scalaire Récupération d’entités par clé primaire Recherche hybride | Recherche vectorielle (recherche ANN) Filtrage par métadonnées Recherche par plage Requête scalaire Récupération d’entités par clé primaire Recherche hybride | Recherche vectorielle (recherche ANN) Filtrage par métadonnées Recherche par plage Requête scalaire Récupération d’entités par clé primaire Recherche hybride |
| Opérations CRUD | ✔️ | ✔️ | ✔️ |
| Gestion avancée des données | N/A | de contrôle d'accès Partition Clé de partition | de contrôle d'accès Partition Clé de partition Regroupement des ressources physiques |
| Niveaux de cohérence | Fort | Fort Staleness limité Session Éventuel | Fort Staleness limité Session Éventuel |
| File d’attente de messages | N/A | Woodpecker (intégré) | Woodpecker (service) |
