


Volltextsuche mit Milvus
DieVolltextsuche ist eine traditionelle Methode zum Auffinden von Dokumenten durch die Suche nach bestimmten Schlüsselwörtern oder Phrasen im Text. Sie ordnet die Ergebnisse auf der Grundlage von Relevanzwerten ein, die aus Faktoren wie der Häufigkeit von Begriffen berechnet werden. Während die semantische Suche besser in der Lage ist, die Bedeutung und den Kontext zu verstehen, zeichnet sich die Volltextsuche durch einen präzisen Abgleich von Schlüsselwörtern aus, was sie zu einer nützlichen Ergänzung der semantischen Suche macht. Ein gängiger Ansatz zum Aufbau einer Retrieval-Augmented Generation (RAG)-Pipeline umfasst das Abrufen von Dokumenten sowohl über die semantische Suche als auch über die Volltextsuche, gefolgt von einem Reranking-Prozess zur Verfeinerung der Ergebnisse.
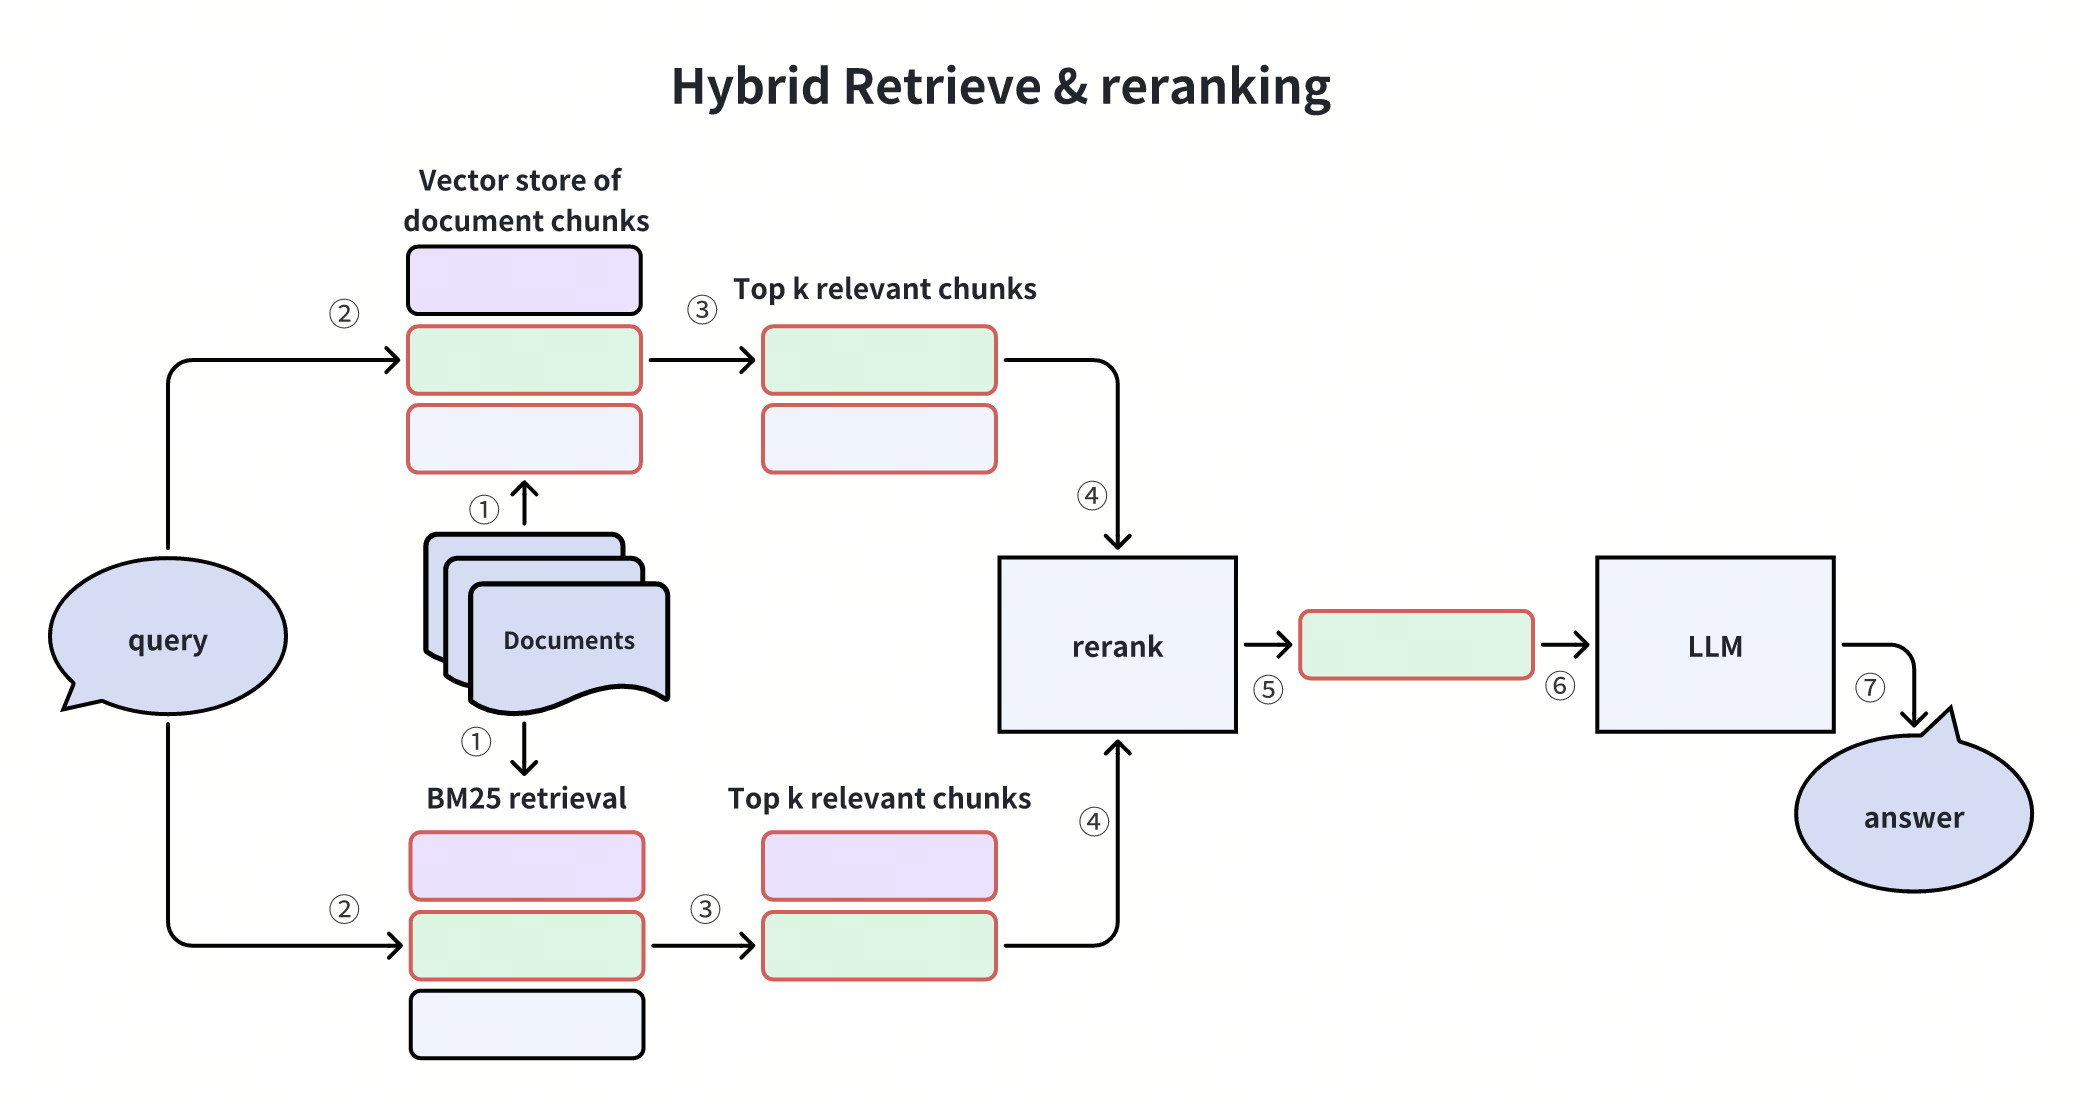
Dieser Ansatz konvertiert Text in spärliche Vektoren für die BM25-Bewertung. Zur Aufnahme von Dokumenten können die Benutzer einfach Rohtext eingeben, ohne den Sparse-Vektor manuell zu berechnen. Milvus generiert und speichert die Sparse-Vektoren automatisch. Um Dokumente zu durchsuchen, müssen die Benutzer nur die Suchanfrage angeben. Milvus berechnet intern die BM25-Bewertungen und gibt die Ergebnisse in einer Rangfolge zurück.
Milvus unterstützt auch hybrides Retrieval, indem es die Volltextsuche mit der semantischen Suche auf der Basis dichter Vektoren kombiniert. Sie verbessert in der Regel die Suchqualität und liefert den Nutzern bessere Ergebnisse, indem sie ein Gleichgewicht zwischen der Suche nach Schlüsselwörtern und dem semantischen Verständnis schafft.
- Die Volltextsuche ist derzeit in Milvus Standalone, Milvus Distributed und Zilliz Cloud verfügbar, obwohl sie in Milvus Lite noch nicht unterstützt wird (diese Funktion ist für eine zukünftige Implementierung geplant). Wenden Sie sich an support@zilliz.com für weitere Informationen.
Vorbereitung
PyMilvus installieren
$ pip install pymilvus -U
Wenn Sie Google Colab verwenden, müssen Sie möglicherweise die Runtime neu starten, um die soeben installierten Abhängigkeiten zu aktivieren (klicken Sie auf das Menü "Runtime" oben auf dem Bildschirm und wählen Sie "Restart session" aus dem Dropdown-Menü).
OpenAI API-Schlüssel festlegen
Wir werden die Modelle von OpenAI für die Erstellung von Vektoreinbettungen und die Generierung von Antworten verwenden. Sie sollten den Api-Schlüssel OPENAI_API_KEY als Umgebungsvariable vorbereiten.
import os

os.environ["OPENAI_API_KEY"] = "sk-***********"
Einrichtung und Konfiguration
Importieren Sie die erforderlichen Bibliotheken
from typing import List
from openai import OpenAI

from pymilvus import (
    MilvusClient,
    DataType,
    Function,
    FunctionType,
    AnnSearchRequest,
    RRFRanker,
)
Wir werden den MilvusClient verwenden, um eine Verbindung zum Milvus-Server herzustellen.
# Connect to Milvus
uri = "http://localhost:19530"
collection_name = "full_text_demo"
client = MilvusClient(uri=uri)
Für die connection_args:
- Sie können einen performanteren Milvus-Server auf Docker oder Kubernetes einrichten. In diesem Setup verwenden Sie bitte die Serveradresse, z.B.
http://localhost:19530, alsuri. - Wenn Sie Zilliz Cloud, den vollständig verwalteten Cloud-Service für Milvus, nutzen möchten, passen Sie
uriundtokenan, die dem öffentlichen Endpunkt und dem Api-Schlüssel in Zilliz Cloud entsprechen.
Einrichten der Sammlung für die Volltextsuche
Das Einrichten einer Sammlung für die Volltextsuche erfordert mehrere Konfigurationsschritte. Lassen Sie uns diese nacheinander durchgehen.
Konfiguration der Textanalyse
Für die Volltextsuche legen wir fest, wie der Text verarbeitet werden soll. Analyzer sind für die Volltextsuche unerlässlich, da sie Sätze in Token zerlegen und lexikalische Analysen wie Stemming und das Entfernen von Stoppwörtern durchführen. Hier definieren wir einfach einen Analyzer.
# Define tokenizer parameters for text analysis
analyzer_params = {"tokenizer": "standard", "filter": ["lowercase"]}
Weitere Details zum Konzept des Analyzers finden Sie in der Analyzer-Dokumentation.
Sammelschema und BM25-Funktion
Nun definieren wir das Schema mit Feldern für Primärschlüssel, Textinhalt, sparse Vektoren (für die Volltextsuche), dense Vektoren (für die semantische Suche) und Metadaten. Wir konfigurieren auch die BM25-Funktion für die Volltextsuche.
Die BM25-Funktion wandelt den Textinhalt automatisch in Sparse-Vektoren um, so dass Milvus die Komplexität der Volltextsuche bewältigen kann, ohne dass eine manuelle Erzeugung von Sparse-Embedding erforderlich ist.
# Create schema
schema = MilvusClient.create_schema()
schema.add_field(
    field_name="id",
    datatype=DataType.VARCHAR,
    is_primary=True,
    auto_id=True,
    max_length=100,
)
schema.add_field(
    field_name="content",
    datatype=DataType.VARCHAR,
    max_length=65535,
    analyzer_params=analyzer_params,
    enable_match=True,  # Enable text matching
    enable_analyzer=True,  # Enable text analysis
)
schema.add_field(field_name="sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR)
schema.add_field(
    field_name="dense_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=1536,  # Dimension for text-embedding-3-small
)
schema.add_field(field_name="metadata", datatype=DataType.JSON)

# Define BM25 function to generate sparse vectors from text
bm25_function = Function(
    name="bm25",
    function_type=FunctionType.BM25,
    input_field_names=["content"],
    output_field_names="sparse_vector",
)

# Add the function to schema
schema.add_function(bm25_function)
{'auto_id': False, 'description': '', 'fields': [{'name': 'id', 'description': '', 'type': <DataType.VARCHAR: 21>, 'params': {'max_length': 100}, 'is_primary': True, 'auto_id': True}, {'name': 'content', 'description': '', 'type': <DataType.VARCHAR: 21>, 'params': {'max_length': 65535, 'enable_match': True, 'enable_analyzer': True, 'analyzer_params': {'tokenizer': 'standard', 'filter': ['lowercase']}}}, {'name': 'sparse_vector', 'description': '', 'type': <DataType.SPARSE_FLOAT_VECTOR: 104>, 'is_function_output': True}, {'name': 'dense_vector', 'description': '', 'type': <DataType.FLOAT_VECTOR: 101>, 'params': {'dim': 1536}}, {'name': 'metadata', 'description': '', 'type': <DataType.JSON: 23>}], 'enable_dynamic_field': False, 'functions': [{'name': 'bm25', 'description': '', 'type': <FunctionType.BM25: 1>, 'input_field_names': ['content'], 'output_field_names': ['sparse_vector'], 'params': {}}]}
Indizierung und Erstellung von Sammlungen
Um die Suchleistung zu optimieren, erstellen wir Indizes sowohl für sparse als auch für dense Vektorfelder und erstellen dann die Sammlung in Milvus.
# Define indexes
index_params = MilvusClient.prepare_index_params()
index_params.add_index(
    field_name="sparse_vector",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
)
index_params.add_index(field_name="dense_vector", index_type="FLAT", metric_type="IP")

# Drop collection if exist
if client.has_collection(collection_name):
    client.drop_collection(collection_name)
# Create the collection
client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
)
print(f"Collection '{collection_name}' created successfully")
Collection 'full_text_demo' created successfully
Daten einfügen
Nach dem Einrichten der Sammlung fügen wir Daten ein, indem wir Entitäten sowohl mit Textinhalten als auch mit ihren Vektordarstellungen vorbereiten. Wir definieren eine Einbettungsfunktion und fügen dann Daten in die Sammlung ein.
# Set up OpenAI for embeddings
openai_client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
model_name = "text-embedding-3-small"


# Define embedding generation function for reuse
def get_embeddings(texts: List[str]) -> List[List[float]]:
    if not texts:
        return []

    response = openai_client.embeddings.create(input=texts, model=model_name)
    return [embedding.embedding for embedding in response.data]
Fügen Sie Beispieldokumente in die Sammlung ein.
# Example documents to insert
documents = [
    {
        "content": "Milvus is a vector database built for embedding similarity search and AI applications.",
        "metadata": {"source": "documentation", "topic": "introduction"},
    },
    {
        "content": "Full-text search in Milvus allows you to search using keywords and phrases.",
        "metadata": {"source": "tutorial", "topic": "full-text search"},
    },
    {
        "content": "Hybrid search combines the power of sparse BM25 retrieval with dense vector search.",
        "metadata": {"source": "blog", "topic": "hybrid search"},
    },
]

# Prepare entities for insertion
entities = []
texts = [doc["content"] for doc in documents]
embeddings = get_embeddings(texts)

for i, doc in enumerate(documents):
    entities.append(
        {
            "content": doc["content"],
            "dense_vector": embeddings[i],
            "metadata": doc.get("metadata", {}),
        }
    )

# Insert data
client.insert(collection_name, entities)
print(f"Inserted {len(entities)} documents")
Inserted 3 documents
Retrieval durchführen
Sie können die Methoden search() oder hybrid_search() flexibel verwenden, um eine Volltextsuche (sparse), eine semantische Suche (dense) und eine hybride Suche zu implementieren, um robustere und genauere Suchergebnisse zu erzielen.
Volltext-Suche
Bei der spärlichen Suche wird der BM25-Algorithmus genutzt, um Dokumente zu finden, die bestimmte Schlüsselwörter oder Ausdrücke enthalten. Diese herkömmliche Suchmethode zeichnet sich durch eine präzise Begriffsabstimmung aus und ist besonders effektiv, wenn die Benutzer genau wissen, wonach sie suchen.
# Example query for keyword search
query = "full-text search keywords"

# BM25 sparse vectors
results = client.search(
    collection_name=collection_name,
    data=[query],
    anns_field="sparse_vector",
    limit=5,
    output_fields=["content", "metadata"],
)
sparse_results = results[0]

# Print results
print("\nSparse Search (Full-text search):")
for i, result in enumerate(sparse_results):
    print(
        f"{i+1}. Score: {result['distance']:.4f}, Content: {result['entity']['content']}"
    )
Sparse Search (Full-text search):
1. Score: 3.1261, Content: Full-text search in Milvus allows you to search using keywords and phrases.
2. Score: 0.1836, Content: Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
3. Score: 0.1335, Content: Milvus is a vector database built for embedding similarity search and AI applications.
Semantische Suche
Bei der dichten Suche werden Vektoreinbettungen verwendet, um Dokumente mit ähnlicher Bedeutung zu finden, auch wenn sie nicht genau dieselben Schlüsselwörter enthalten. Dieser Ansatz hilft, den Kontext und die Semantik zu verstehen, und ist daher ideal für Abfragen in natürlicher Sprache.
# Example query for semantic search
query = "How does Milvus help with similarity search?"

# Generate embedding for query
query_embedding = get_embeddings([query])[0]

# Semantic search using dense vectors
results = client.search(
    collection_name=collection_name,
    data=[query_embedding],
    anns_field="dense_vector",
    limit=5,
    output_fields=["content", "metadata"],
)
dense_results = results[0]

# Print results
print("\nDense Search (Semantic):")
for i, result in enumerate(dense_results):
    print(
        f"{i+1}. Score: {result['distance']:.4f}, Content: {result['entity']['content']}"
    )
Dense Search (Semantic):
1. Score: 0.6959, Content: Milvus is a vector database built for embedding similarity search and AI applications.
2. Score: 0.6501, Content: Full-text search in Milvus allows you to search using keywords and phrases.
3. Score: 0.4371, Content: Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
Hybride Suche
Die hybride Suche kombiniert sowohl die Volltextsuche als auch das semantisch dichte Retrieval. Dieser ausgewogene Ansatz verbessert die Suchgenauigkeit und Robustheit, indem er die Stärken beider Methoden nutzt.
Die hybride Suche ist besonders wertvoll bei Retrieval-Augmented Generation (RAG)-Anwendungen, bei denen sowohl das semantische Verständnis als auch der präzise Abgleich von Schlüsselwörtern zu besseren Abrufergebnissen beitragen.
# Example query for hybrid search
query = "what is hybrid search"

# Get query embedding
query_embedding = get_embeddings([query])[0]

# Set up BM25 search request
sparse_search_params = {"metric_type": "BM25"}
sparse_request = AnnSearchRequest(
    [query], "sparse_vector", sparse_search_params, limit=5
)

# Set up dense vector search request
dense_search_params = {"metric_type": "IP"}
dense_request = AnnSearchRequest(
    [query_embedding], "dense_vector", dense_search_params, limit=5
)

# Perform hybrid search with reciprocal rank fusion
results = client.hybrid_search(
    collection_name,
    [sparse_request, dense_request],
    ranker=RRFRanker(),  # Reciprocal Rank Fusion for combining results
    limit=5,
    output_fields=["content", "metadata"],
)
hybrid_results = results[0]

# Print results
print("\nHybrid Search (Combined):")
for i, result in enumerate(hybrid_results):
    print(
        f"{i+1}. Score: {result['distance']:.4f}, Content: {result['entity']['content']}"
    )
Hybrid Search (Combined):
1. Score: 0.0328, Content: Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
2. Score: 0.0320, Content: Milvus is a vector database built for embedding similarity search and AI applications.
3. Score: 0.0320, Content: Full-text search in Milvus allows you to search using keywords and phrases.
Generierung von Antworten
Nach dem Abrufen relevanter Dokumente mit der hybriden Suche können wir ein LLM verwenden, um eine umfassende Antwort auf der Grundlage der abgerufenen Informationen zu generieren. Dies ist der letzte Schritt in einer RAG (Retrieval Augmented Generation) Pipeline.
# Format retrieved documents into context
context = "\n\n".join([doc["entity"]["content"] for doc in hybrid_results])

# Create prompt
prompt = f"""Answer the following question based on the provided context.
If the context doesn't contain relevant information, just say "I don't have enough information to answer this question."

Context:
{context}

Question: {query}

Answer:"""

# Call OpenAI API
response = openai_client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {
            "role": "system",
            "content": "You are a helpful assistant that answers questions based on the provided context.",
        },
        {"role": "user", "content": prompt},
    ],
)

print(response.choices[0].message.content)
Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
Das war's! Jetzt haben Sie gerade eine RAG mit hybrider Suche aufgebaut, die die Leistung der BM25-basierten Volltextsuche und der dichten vektorbasierten semantischen Suche kombiniert.
