

Übersicht über die Milvus-Bereitstellungsoptionen
Milvus unterstützt lokale Prototypen und groß angelegte Vektorsuchdienste. Wählen Sie je nach Ihren Daten, der Lese- und Schreibauslastung, den Verfügbarkeitsanforderungen und der Betriebsumgebung zwischen Milvus Lite, Milvus Standalone und Milvus Distributed.
Milvus Lite
Milvus Lite ist eine Python-Bibliothek, die in Ihre Anwendungen importiert werden kann. Als leichtgewichtige Version von Milvus eignet sie sich ideal für die schnelle Prototypenerstellung in Jupyter-Notebooks oder für den Einsatz auf Smart-Geräten mit begrenzten Ressourcen. Milvus Lite unterstützt dieselben APIs wie andere Milvus-Bereitstellungsarten. Der clientseitige Code, der mit Milvus Lite interagiert, kann auch mit Milvus-Instanzen in anderen Bereitstellungsmodi verwendet werden.
Verwenden Sie für die lokalen Beispiele Python 3.10 oder höher und installieren Sie die optionale Lite-Abhängigkeit explizit. Unter Windows überspringt pip den Zusatz „ milvus-lite “, daher ist die Angabe des vollständigen Paketnamens erforderlich:
python3 -m pip install "pymilvus[milvus-lite]==3.0.2" "milvus-lite==3.2.2"
Verwenden Sie „ MilvusClient("./demo.db") “, um den lokalen Speicher zu öffnen. Milvus Lite 3.x erstellt ein Verzeichnis unter diesem Pfad; eine vorhandene Milvus Lite 2.x-Datenbankdatei muss exportiert und migriert werden. Informationen zu den Plattformanforderungen finden Sie unter „Milvus Lite ausführen“ und ein vollständiges Beispiel zum Einfügen und Suchen unter „Schnellstart “.
Milvus Standalone
Milvus Standalone ist eine Serverbereitstellung auf einem einzelnen Rechner. Alle Komponenten von Milvus Standalone sind in einem einzigen Docker-Image zusammengefasst, was die Bereitstellung vereinfacht. Wenn Sie eine Produktionslast haben, aber lieber auf Kubernetes verzichten möchten, ist der Betrieb von Milvus Standalone auf einem einzelnen Rechner mit ausreichendem Arbeitsspeicher eine gute Option. Standardmäßig nutzt Milvus Standalone „Woodpecker“ (eingebettet) als Nachrichtenwarteschlange, sodass kein separater Messaging-Dienst betrieben werden muss.
Milvus Distributed
Milvus Distributed kann auf Kubernetes-Clustern bereitgestellt werden. Diese Bereitstellung zeichnet sich durch eine cloudnative Architektur aus, bei der die Eingabelast und Suchanfragen separat von isolierten Knoten verarbeitet werden, was Redundanz für kritische Komponenten ermöglicht. Sie bietet höchste Skalierbarkeit und Verfügbarkeit sowie Flexibilität bei der Anpassung der zugewiesenen Ressourcen für jede Komponente. Milvus Distributed ist die erste Wahl für Unternehmensanwender, die groß angelegte Vektorsuchsysteme im Produktivbetrieb einsetzen. Standardmäßig nutzt Milvus Distributed Woodpecker als Nachrichtenwarteschlange, das als dedizierter Dienst neben Milvus bereitgestellt wird.
Wählen Sie die richtige Bereitstellung für Ihren Anwendungsfall
Die Wahl des Bereitstellungsmodus hängt in der Regel vom Entwicklungsstand Ihrer Anwendung ab:
Für schnelles Prototyping
Verwenden Sie Milvus Lite in einem Notebook, um Embeddings, RAG-Chunking-Strategien und das Abrufverhalten zu testen. Wechseln Sie zu Milvus Standalone, wenn Sie einen gemeinsam genutzten Server benötigen oder wenn der gemessene Speicher- und Abfrageaufwand die Kapazitäten der lokalen Umgebung übersteigt. Die Client-API ist ähnlich, prüfen Sie jedoch die Funktionsunterschiede und migrieren Sie die gespeicherten Daten separat.
Produktivbereitstellung in kleinem Maßstab
Verwenden Sie Milvus Standalone, wenn ein einzelner Server Ihre Anforderungen an Arbeitslast und Verfügbarkeit erfüllen kann und Sie den Betrieb ohne Kubernetes bevorzugen. Schätzen Sie den Speicherbedarf anhand von Vektordimensionen, Skalarfeldern, Indexeinstellungen und Replikaten und führen Sie anschließend einen Benchmark der erwarteten Abfrage-Parallelität und Schreibrate durch. Die Anzahl der Vektoren allein sagt nichts über die Kapazität aus.
Groß angelegter Produktionsbetrieb
Wenn Ihr Unternehmen schnell wächst und der Datenumfang die Kapazität eines einzelnen Servers übersteigt, ist es an der Zeit, Milvus Distributed in Betracht zu ziehen. Sie können Milvus Standalone aufgrund seiner Benutzerfreundlichkeit weiterhin für Entwicklungs- oder Staging-Umgebungen nutzen und gleichzeitig den K8s-Cluster betreiben, auf dem Milvus Distributed läuft. Dies ermöglicht die Skalierung auf mehrere zehn Milliarden Vektoren und bietet zudem Flexibilität bei der Anpassung der Knotengröße an Ihre spezifische Arbeitslast, beispielsweise bei Szenarien mit hohem Leseaufkommen und seltenen Schreibvorgängen oder umgekehrt mit hohem Schreibaufkommen und geringem Leseaufkommen.
Lokale Suche auf Edge-Geräten
Für die Suche in privaten oder sensiblen Daten auf Edge-Geräten können Sie Milvus Lite direkt auf dem Gerät bereitstellen, ohne für die Text- oder Bildsuche auf einen cloudbasierten Dienst angewiesen zu sein. Dies eignet sich beispielsweise für die Suche in firmeneigenen Dokumenten oder die Objekterkennung direkt auf dem Gerät.
Die Wahl des Milvus-Bereitstellungsmodus hängt von der Phase und dem Umfang Ihres Projekts ab. Milvus bietet eine flexible und leistungsstarke Lösung für verschiedene Anforderungen, vom schnellen Prototyping bis hin zum groß angelegten Einsatz in Unternehmen.
- Milvus Lite eignet sich für lokale Auswertungen und Workloads, die mit den Ressourcen einer einzelnen Anwendung bewältigt werden können.
- Milvus Standalone bietet einen gemeinsam genutzten Dienst, wenn ein Server Ihre Anforderungen an Kapazität und Verfügbarkeit erfüllt.
- Milvus Distributed bietet Skalierbarkeit auf Komponentenebene und Redundanz, wenn Sie über einen Server hinauswachsen oder Lese- und Schreibressourcen voneinander trennen müssen.
Milvus Standalone und Distributed nutzen eine Nachrichtenwarteschlange, einen Objektspeicher und einen Metadatenspeicher. Milvus Lite läuft lokal ohne diese separaten Dienste. Informationen zu den Standardabhängigkeiten der Serverbereitstellungen und zu Optionen für externe Dienste finden Sie unter „Dateninfrastruktur“.
Wenn Sie einen Managed Service bevorzugen, anstatt die Serverinfrastruktur selbst zu betreiben, sollten Sie Zilliz Cloud in Betracht ziehen. Für eine eigenständige Bereitstellung fahren Sie mit Docker oder Kubernetes fort.
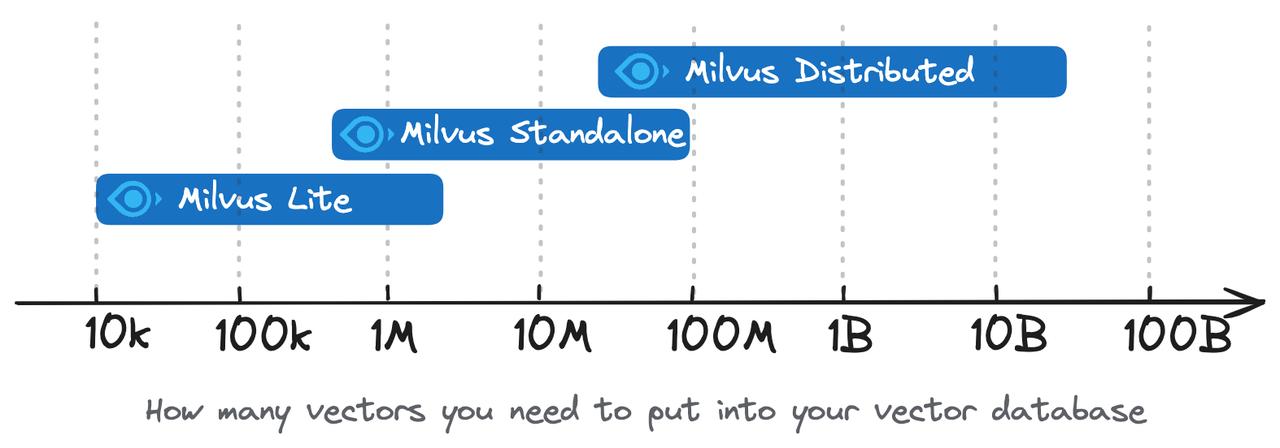 Wählen Sie die Bereitstellungsoption für Ihren Anwendungsfall
Vergleich der Funktionen
Die Spalte „Lite“ beschreibt Milvus Lite 3.2.2. Prüfen Sie die Einschränkungen von Milvus Lite, bevor Sie sich in einer lokalen Anwendung auf eine Serverfunktion verlassen.
| Funktion | Milvus Lite | Milvus Standalone | Milvus Distributed |
|---|---|---|---|
| SDK / Client-Bibliothek | Python (lokaler PyMilvus-Adapter) | Python Go Java Node.js C# RESTful | Python Java Go Node.js C# RESTful |
| Datentypen | Dichter Vektor Sparse-Vektor Boolescher Wert Ganzzahl Gleitkomma VarChar Array JSON | Dichter Vektor Sparse-Vektor Binärvektor Boolescher Wert Ganzzahl Gleitkomma VarChar Array JSON | Dichter Vektor Sparse-Vektor Binärvektor Boolesche Werte Ganzzahlen Gleitkommazahlen VarChar Array JSON |
| Suchfunktionen | Vektorsuche (ANN-Suche) Metadatenfilterung Bereichssuche Skalare Abfrage Entitäten nach Primärschlüssel abrufen Hybride Suche | Vektorsuche (ANN-Suche) Metadatenfilterung Bereichssuche Skalare Abfrage Entitäten nach Primärschlüssel abrufen Hybride Suche | Vektorsuche (ANN-Suche) Metadatenfilterung Bereichssuche Skalare Abfrage Entitäten nach Primärschlüssel abrufen Hybride Suche |
| CRUD-Operationen | ✔️ | ✔️ | ✔️ |
| Erweiterte Datenverwaltung | Datenbanken Partitionen Aliase Keine Zugriffskontrolle | Zugriffskontrolle Partition Partitionsschlüssel | Zugriffskontrolle Partition Partitionsschlüssel Physische Ressourcengruppierung |
| Konsistenzstufen | Nicht zutreffend: Ein einzelner lokaler Prozess bedient alle Anfragen; „ consistency_level “ wird akzeptiert, hat jedoch keine Auswirkung | Starke Begrenzte Veralterung Sitzung Eventuell | Starkes „ “, „Bounded Staleness“, „ “, „Session“, „ “, „Eventual“ |
| Nachrichtenwarteschlange | k. A. | Woodpecker (eingebettet) | Woodpecker (Dienst) |
