


البحث في النص الكامل مع ميلفوس
البحث في النص الكامل هو طريقة تقليدية لاسترجاع المستندات عن طريق مطابقة كلمات أو عبارات محددة في النص. ويقوم بترتيب النتائج بناءً على درجات الملاءمة المحسوبة من عوامل مثل تكرار المصطلحات. في حين أن البحث الدلالي أفضل في فهم المعنى والسياق، فإن البحث في النص الكامل يتفوق في مطابقة الكلمات المفتاحية بدقة، مما يجعله مكملاً مفيدًا للبحث الدلالي. يتضمن النهج الشائع لإنشاء خط أنابيب الاسترجاع المعزز (RAG) استرجاع المستندات من خلال كل من البحث الدلالي والبحث في النص الكامل، تليها عملية إعادة ترتيب لتنقيح النتائج.
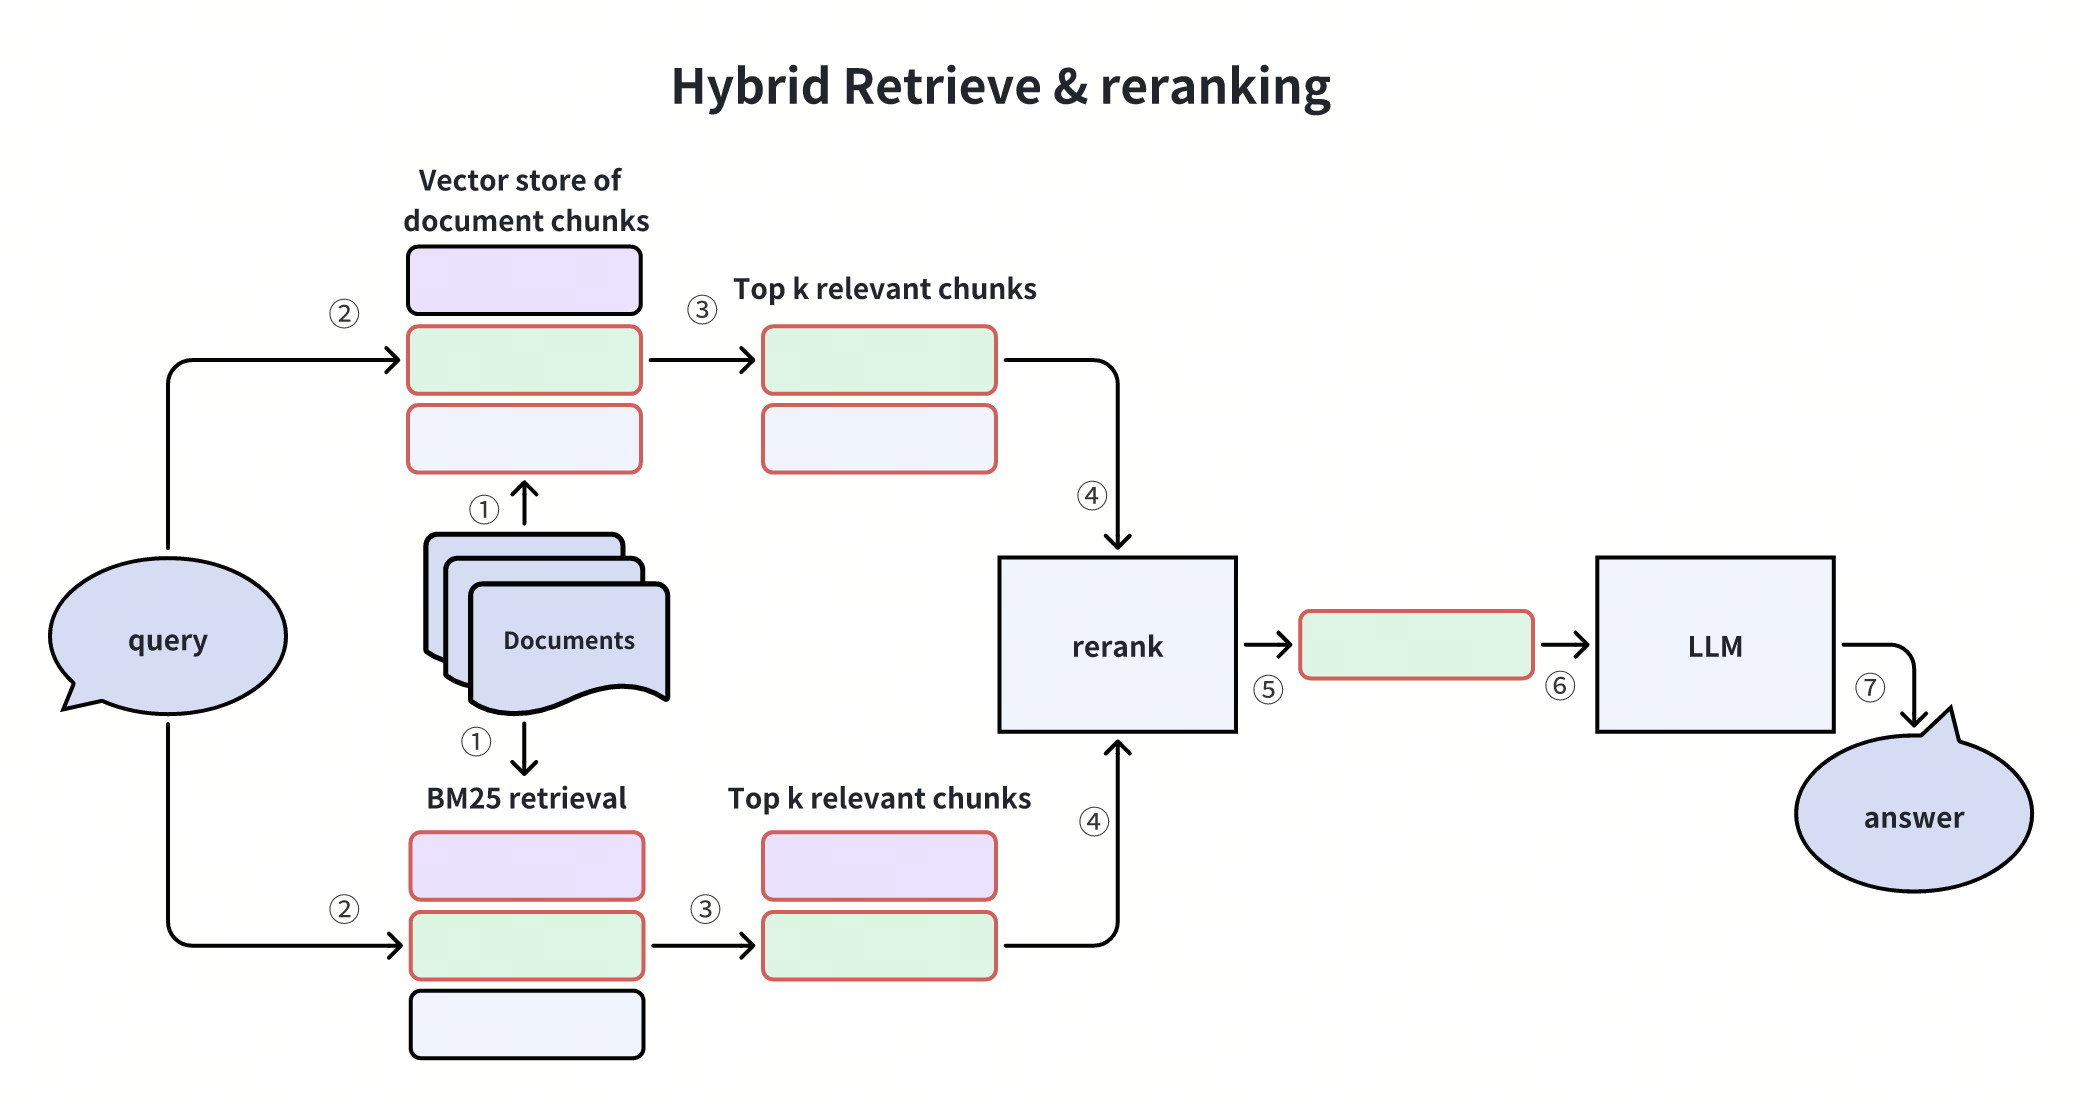
يقوم هذا النهج بتحويل النص إلى متجهات متناثرة لتسجيل BM25. لاستيعاب المستندات، يمكن للمستخدمين ببساطة إدخال نص خام دون حساب المتجهات المتفرقة يدويًا. سيقوم برنامج Milvus تلقائيًا بإنشاء المتجهات المتفرقة وتخزينها. للبحث في المستندات، يحتاج المستخدمون فقط إلى تحديد استعلام البحث النصي. سيقوم ميلفوس بحساب درجات BM25 داخليًا وإرجاع النتائج المرتبة.
يدعم Milvus أيضًا الاسترجاع الهجين من خلال الجمع بين البحث في النص الكامل والبحث الدلالي القائم على المتجهات الكثيفة. وعادةً ما يحسن جودة البحث ويقدم نتائج أفضل للمستخدمين من خلال الموازنة بين مطابقة الكلمات الرئيسية والفهم الدلالي.
- يتوفر البحث عن النص الكامل حاليًا في Milvus Standalone وMilvus Distributed وZilliz Cloud، على الرغم من عدم دعم هذه الميزة بعد في Milvus Lite (والتي من المقرر تطبيق هذه الميزة في المستقبل). تواصل مع support@zilliz.com لمزيد من المعلومات.
التحضير
تثبيت PyMilvus
$ pip install pymilvus -U
إذا كنت تستخدم Google Colab، لتمكين التبعيات المثبتة للتو، قد تحتاج إلى إعادة تشغيل وقت التشغيل (انقر على قائمة "وقت التشغيل" في أعلى الشاشة، وحدد "إعادة تشغيل الجلسة" من القائمة المنسدلة).
تعيين مفتاح OpenAI API
سنستخدم النماذج من OpenAI لإنشاء التضمينات المتجهة وتوليد الاستجابة. يجب عليك إعداد مفتاح API OPENAI_API_KEY كمتغير بيئة.
import os

os.environ["OPENAI_API_KEY"] = "sk-***********"
الإعداد والتهيئة
استيراد المكتبات اللازمة
from typing import List
from openai import OpenAI

from pymilvus import (
    MilvusClient,
    DataType,
    Function,
    FunctionType,
    AnnSearchRequest,
    RRFRanker,
)
سنستخدم MilvusClient لإنشاء اتصال بخادم Milvus.
# Connect to Milvus
uri = "http://localhost:19530"
collection_name = "full_text_demo"
client = MilvusClient(uri=uri)
من أجل الاتصال_args:
- يمكنك إعداد خادم Milvus أكثر أداءً على docker أو kubernetes. في هذا الإعداد، يرجى استخدام عنوان الخادم، على سبيل المثال
http://localhost:19530، كعنوانuri. - إذا كنت ترغب في استخدام Zilliz Cloud، الخدمة السحابية المدارة بالكامل لـ Milvus، اضبط
uriوtoken، والتي تتوافق مع نقطة النهاية العامة ومفتاح Api في Zilliz Cloud.
إعداد مجموعة للبحث عن النص الكامل
يتطلب إعداد مجموعة للبحث في النص الكامل عدة خطوات تكوين. لنستعرضها واحدة تلو الأخرى.
تكوين تحليل النص
للبحث عن النص الكامل، نحدد كيفية معالجة النص. المحللات ضرورية في البحث عن النص الكامل من خلال تقسيم الجمل إلى رموز وإجراء تحليل معجمي مثل الجذع وإزالة كلمات التوقف. نقوم هنا ببساطة بتعريف المحلل.
# Define tokenizer parameters for text analysis
analyzer_params = {"tokenizer": "standard", "filter": ["lowercase"]}
لمزيد من تفاصيل المفهوم حول المحلل، يرجى الرجوع إلى وثائق المحلل.
مخطط المجموعة ووظيفة BM25
نحدد الآن المخطط مع حقول للمفتاح الأساسي، ومحتوى النص، والمتجهات المتفرقة (للبحث في النص الكامل)، والمتجهات الكثيفة (للبحث الدلالي)، والبيانات الوصفية. نقوم أيضًا بتكوين دالة BM25 للبحث في النص الكامل.
تقوم دالة BM25 تلقائيًا بتحويل محتوى النص تلقائيًا إلى متجهات متناثرة، مما يسمح لـ Milvus بالتعامل مع تعقيد البحث في النص الكامل دون الحاجة إلى إنشاء تضمين يدوي متناثر.
# Create schema
schema = MilvusClient.create_schema()
schema.add_field(
    field_name="id",
    datatype=DataType.VARCHAR,
    is_primary=True,
    auto_id=True,
    max_length=100,
)
schema.add_field(
    field_name="content",
    datatype=DataType.VARCHAR,
    max_length=65535,
    analyzer_params=analyzer_params,
    enable_match=True,  # Enable text matching
    enable_analyzer=True,  # Enable text analysis
)
schema.add_field(field_name="sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR)
schema.add_field(
    field_name="dense_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=1536,  # Dimension for text-embedding-3-small
)
schema.add_field(field_name="metadata", datatype=DataType.JSON)

# Define BM25 function to generate sparse vectors from text
bm25_function = Function(
    name="bm25",
    function_type=FunctionType.BM25,
    input_field_names=["content"],
    output_field_names="sparse_vector",
)

# Add the function to schema
schema.add_function(bm25_function)
{'auto_id': False, 'description': '', 'fields': [{'name': 'id', 'description': '', 'type': <DataType.VARCHAR: 21>, 'params': {'max_length': 100}, 'is_primary': True, 'auto_id': True}, {'name': 'content', 'description': '', 'type': <DataType.VARCHAR: 21>, 'params': {'max_length': 65535, 'enable_match': True, 'enable_analyzer': True, 'analyzer_params': {'tokenizer': 'standard', 'filter': ['lowercase']}}}, {'name': 'sparse_vector', 'description': '', 'type': <DataType.SPARSE_FLOAT_VECTOR: 104>, 'is_function_output': True}, {'name': 'dense_vector', 'description': '', 'type': <DataType.FLOAT_VECTOR: 101>, 'params': {'dim': 1536}}, {'name': 'metadata', 'description': '', 'type': <DataType.JSON: 23>}], 'enable_dynamic_field': False, 'functions': [{'name': 'bm25', 'description': '', 'type': <FunctionType.BM25: 1>, 'input_field_names': ['content'], 'output_field_names': ['sparse_vector'], 'params': {}}]}
الفهرسة وإنشاء المجموعات
لتحسين أداء البحث، نقوم بإنشاء فهارس لحقول المتجهات المتفرقة والكثيفة على حد سواء، ثم ننشئ المجموعة في Milvus.
# Define indexes
index_params = MilvusClient.prepare_index_params()
index_params.add_index(
    field_name="sparse_vector",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
)
index_params.add_index(field_name="dense_vector", index_type="FLAT", metric_type="IP")

# Drop collection if exist
if client.has_collection(collection_name):
    client.drop_collection(collection_name)
# Create the collection
client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
)
print(f"Collection '{collection_name}' created successfully")
Collection 'full_text_demo' created successfully
إدراج البيانات
بعد إعداد المجموعة، نقوم بإدراج البيانات من خلال إعداد كيانات ذات محتوى نصي وتمثيلات متجهاتها. دعونا نحدد دالة تضمين ثم ندرج البيانات في المجموعة.
# Set up OpenAI for embeddings
openai_client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
model_name = "text-embedding-3-small"


# Define embedding generation function for reuse
def get_embeddings(texts: List[str]) -> List[List[float]]:
    if not texts:
        return []

    response = openai_client.embeddings.create(input=texts, model=model_name)
    return [embedding.embedding for embedding in response.data]
إدراج أمثلة على المستندات في المجموعة.
# Example documents to insert
documents = [
    {
        "content": "Milvus is a vector database built for embedding similarity search and AI applications.",
        "metadata": {"source": "documentation", "topic": "introduction"},
    },
    {
        "content": "Full-text search in Milvus allows you to search using keywords and phrases.",
        "metadata": {"source": "tutorial", "topic": "full-text search"},
    },
    {
        "content": "Hybrid search combines the power of sparse BM25 retrieval with dense vector search.",
        "metadata": {"source": "blog", "topic": "hybrid search"},
    },
]

# Prepare entities for insertion
entities = []
texts = [doc["content"] for doc in documents]
embeddings = get_embeddings(texts)

for i, doc in enumerate(documents):
    entities.append(
        {
            "content": doc["content"],
            "dense_vector": embeddings[i],
            "metadata": doc.get("metadata", {}),
        }
    )

# Insert data
client.insert(collection_name, entities)
print(f"Inserted {len(entities)} documents")
Inserted 3 documents
إجراء الاسترجاع
يمكنك استخدام طريقتَي search() أو hybrid_search() بمرونة لتنفيذ البحث عن النص الكامل (المتناثر) والبحث الدلالي (الكثيف) والبحث المختلط للوصول إلى نتائج بحث أكثر قوة ودقة.
البحث في النص الكامل
يستفيد البحث المتفرّق من خوارزمية BM25 للعثور على المستندات التي تحتوي على كلمات أو عبارات محددة. تتفوق طريقة البحث التقليدية هذه في مطابقة المصطلحات بدقة وتكون فعالة بشكل خاص عندما يعرف المستخدمون ما يبحثون عنه بالضبط.
# Example query for keyword search
query = "full-text search keywords"

# BM25 sparse vectors
results = client.search(
    collection_name=collection_name,
    data=[query],
    anns_field="sparse_vector",
    limit=5,
    output_fields=["content", "metadata"],
)
sparse_results = results[0]

# Print results
print("\nSparse Search (Full-text search):")
for i, result in enumerate(sparse_results):
    print(
        f"{i+1}. Score: {result['distance']:.4f}, Content: {result['entity']['content']}"
    )
Sparse Search (Full-text search):
1. Score: 3.1261, Content: Full-text search in Milvus allows you to search using keywords and phrases.
2. Score: 0.1836, Content: Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
3. Score: 0.1335, Content: Milvus is a vector database built for embedding similarity search and AI applications.
البحث الدلالي
يستخدم البحث الكثيف التضمينات المتجهة للعثور على المستندات ذات المعنى المتشابه، حتى لو لم تتشارك نفس الكلمات المفتاحية بالضبط. يساعد هذا النهج في فهم السياق والدلالات، مما يجعله مثاليًا لمزيد من الاستعلامات اللغوية الطبيعية.
# Example query for semantic search
query = "How does Milvus help with similarity search?"

# Generate embedding for query
query_embedding = get_embeddings([query])[0]

# Semantic search using dense vectors
results = client.search(
    collection_name=collection_name,
    data=[query_embedding],
    anns_field="dense_vector",
    limit=5,
    output_fields=["content", "metadata"],
)
dense_results = results[0]

# Print results
print("\nDense Search (Semantic):")
for i, result in enumerate(dense_results):
    print(
        f"{i+1}. Score: {result['distance']:.4f}, Content: {result['entity']['content']}"
    )
Dense Search (Semantic):
1. Score: 0.6959, Content: Milvus is a vector database built for embedding similarity search and AI applications.
2. Score: 0.6501, Content: Full-text search in Milvus allows you to search using keywords and phrases.
3. Score: 0.4371, Content: Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
البحث الهجين
يجمع البحث الهجين بين البحث في النص الكامل والاسترجاع الدلالي الكثيف. يعمل هذا النهج المتوازن على تحسين دقة البحث وقوته من خلال الاستفادة من نقاط القوة في كلتا الطريقتين.
يعد البحث الهجين ذا قيمة خاصة في تطبيقات توليد الاسترجاع المعزز (RAG)، حيث يساهم كل من الفهم الدلالي والمطابقة الدقيقة للكلمات الرئيسية في تحسين نتائج الاسترجاع.
# Example query for hybrid search
query = "what is hybrid search"

# Get query embedding
query_embedding = get_embeddings([query])[0]

# Set up BM25 search request
sparse_search_params = {"metric_type": "BM25"}
sparse_request = AnnSearchRequest(
    [query], "sparse_vector", sparse_search_params, limit=5
)

# Set up dense vector search request
dense_search_params = {"metric_type": "IP"}
dense_request = AnnSearchRequest(
    [query_embedding], "dense_vector", dense_search_params, limit=5
)

# Perform hybrid search with reciprocal rank fusion
results = client.hybrid_search(
    collection_name,
    [sparse_request, dense_request],
    ranker=RRFRanker(),  # Reciprocal Rank Fusion for combining results
    limit=5,
    output_fields=["content", "metadata"],
)
hybrid_results = results[0]

# Print results
print("\nHybrid Search (Combined):")
for i, result in enumerate(hybrid_results):
    print(
        f"{i+1}. Score: {result['distance']:.4f}, Content: {result['entity']['content']}"
    )
Hybrid Search (Combined):
1. Score: 0.0328, Content: Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
2. Score: 0.0320, Content: Milvus is a vector database built for embedding similarity search and AI applications.
3. Score: 0.0320, Content: Full-text search in Milvus allows you to search using keywords and phrases.
توليد الإجابات
بعد استرجاع المستندات ذات الصلة باستخدام البحث المختلط، يمكننا استخدام LLM لتوليد إجابة شاملة بناءً على المعلومات المسترجعة. هذه هي الخطوة الأخيرة في خط أنابيب RAG (التوليد المعزز للاسترجاع).
# Format retrieved documents into context
context = "\n\n".join([doc["entity"]["content"] for doc in hybrid_results])

# Create prompt
prompt = f"""Answer the following question based on the provided context.
If the context doesn't contain relevant information, just say "I don't have enough information to answer this question."

Context:
{context}

Question: {query}

Answer:"""

# Call OpenAI API
response = openai_client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {
            "role": "system",
            "content": "You are a helpful assistant that answers questions based on the provided context.",
        },
        {"role": "user", "content": prompt},
    ],
)

print(response.choices[0].message.content)
Hybrid search combines the power of sparse BM25 retrieval with dense vector search.
هذا كل شيء! لقد قمت الآن للتو ببناء RAG مع الاسترجاع الهجين الذي يجمع بين قوة البحث بالنص الكامل المستند إلى BM25 والبحث الدلالي القائم على المتجهات الكثيفة.
