

Hugging Face RankerCompatible with Milvus v2.6.20+
يقوم البحث المتجهي بترتيب النتائج حسب المسافة المتجهة، ولكن الترتيب الأولي قد لا يعكس مدى ملاءمة نص كل مرشح للاستعلام. يقوم Hugging Face Ranker بإرسال الاستعلام والنص المرشح إلى مزودي الاستدلال Hugging Face المستضافين ويستخدم درجات " sentence-similarity " لإعادة ترتيب المرشحين الذين أعادهم Milvus.
يستخدم هذا التكامل جهاز التوجيه (router) المستضاف من Hugging Face. لإعادة الترتيب باستخدام خدمة استدلال تضمين النصوص (TEI) التي تم نشرها بشكل منفصل، راجع TEI Ranker.
القيود
- يجب أن تشير الدالة إلى حقل واحد فقط غير قابل للفراغ من حقول «
VARCHAR» في «input_field_names». - يجب أن يكون عدد السلاسل في
queriesمساوياً لعدد استعلامات البحث (nq).
كيفية العمل
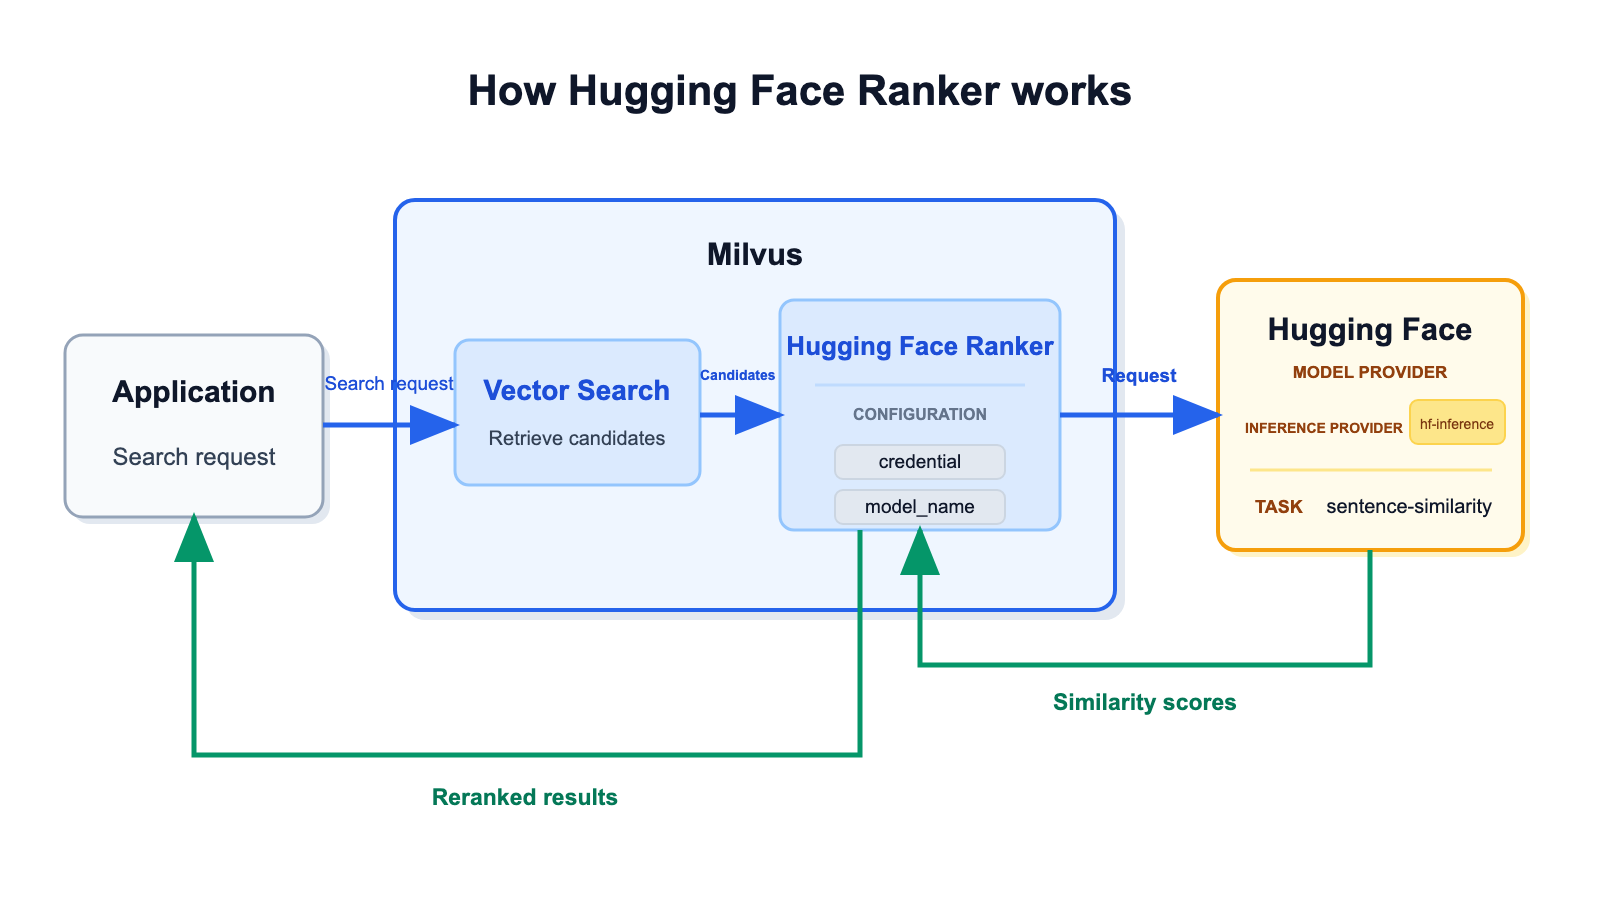 سير عمل Hugging Face Ranker
يتم تشغيل Hugging Face Ranker بعد البحث المتجهي الأولي:
- استرجاع الكيانات المرشحة. يقوم Milvus بالبحث في حقل المتجهات المُهيأ ويجمع الكيانات المرشحة.
- تحضير النص لإعادة الترتيب. تقرأ الدالة نص الاستعلام من
params.queriesوالنص المرشح من الحقلVARCHARالمحدد فيinput_field_names. - طلب درجات التشابه. يرسل Milvus الاستعلام كـ
source_sentenceوالنصوص المرشحة كـsentencesعبرhf-inferenceإلى مسار Hugging Facesentence-similarity. - إعادة ترتيب النصوص المرشحة. يعرض Hugging Face درجة واحدة لكل نص مرشح. يقوم Milvus بترتيب النصوص المرشحة من أعلى درجة إلى أدنى درجة ويعرض النتائج بعد إعادة الترتيب.
كيفية حساب درجات التشابه
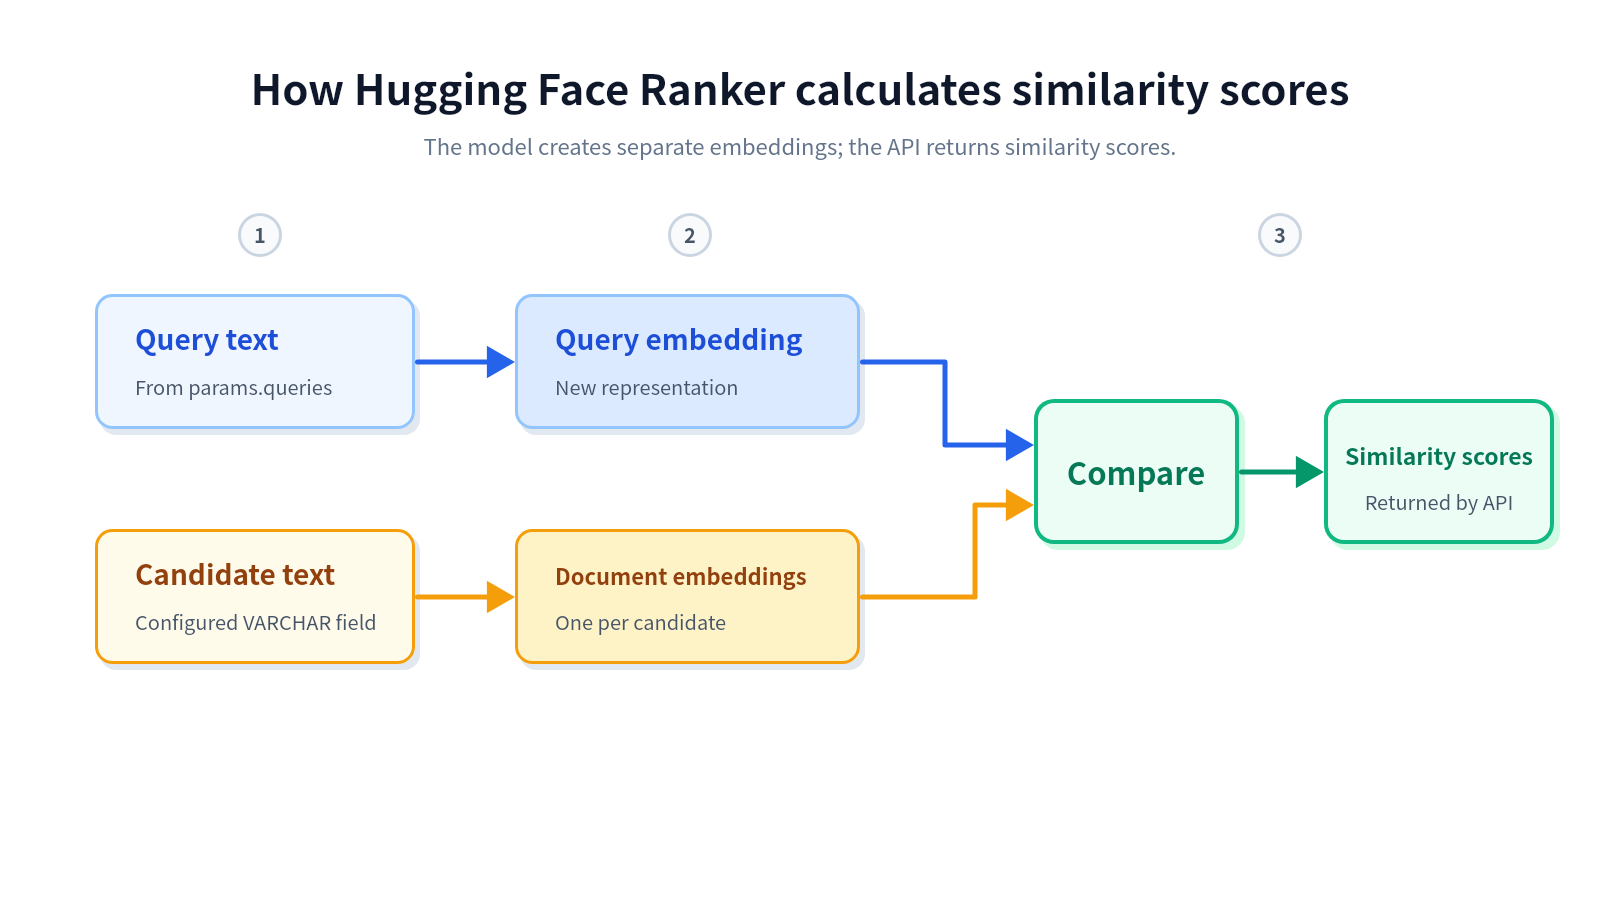 كيف يحسب Hugging Face Ranker درجات التشابه
يحسب نموذج Hugging Face الدرجات على ثلاث مراحل:
- تحضير مدخلات النص. يقرأ Ranker نص الاستعلام من
params.queriesونص المرشح من الحقلVARCHARالذي تم تكوينه. - إنشاء تمثيلات منفصلة للنموذج. يرسل Milvus الاستعلام على أنه
source_sentenceوالنصوص المرشحة على أنهاsentences. يقوم النموذج داخليًا بترميز الاستعلام وكل مرشح على حدة. - قارن النتائج وأعد الدرجات. يقارن النموذج تمثيل الاستعلام مع كل تمثيل مرشح ويعيد درجة تشابه واحدة لكل مرشح.
تعد التضمينات أو التمثيلات التي يستخدمها نموذج Hugging Face معالجة نموذجية وسيطة. يعرض Hugging Face الدرجات، وليس المتجهات. وبالتالي، يستخدم استرجاع المتجهات الأولي وإعادة ترتيب النموذج تمثيلات منفصلة وقد يستخدمان نماذج مختلفة.
قبل البدء
قبل استخدام Hugging Face Ranker، تأكد من توفر ما يلي:
- Milvus 2.6.20 أو إصدار أحدث من سلسلة الإصدارات 2.6.
- PyMilvus 2.6.16 أو أحدث.
- رمز وصول مستخدم Hugging Face يمكنه استدعاء مزودي الاستدلال.
- نموذج يتم تقديمه حاليًا بواسطة
hf-inferenceلـsentence-similarityالمهمة. - مجموعة تخزن النص المرشح في حقل
VARCHARغير قابل للقيمة الفارغة.
لا يتحكم Milvus في ما إذا كان نموذج Hugging Face سيظل متاحًا عبر hf-inference ، أو ما إذا كان النموذج يلبي متطلباتك من حيث الاستقرار وزمن الاستجابة وجودة المخرجات. تحقق من النموذج على Hugging Face وقم بتقييمه بالنسبة لحمل العمل الخاص بك قبل استخدامه في بيئة الإنتاج.
تستخدم الأمثلة sentence-transformers/all-MiniLM-L6-v2 فقط لتوضيح التكوين. ولا يُعد النموذج توصية أو اعتمادًا من Milvus.
تكوين بيانات الاعتماد
يمكنك تكوين رمز وصول مستخدم Hugging Face في milvus.yaml أو من خلال متغير بيئة.
ترتيب أولوية بيانات الاعتماد هو:
Function credential label -> provider credential label in milvus.yaml -> environment variable
الخيار 1: ملف التكوين
حدد الرمز في قسم credential ذي المستوى الأعلى، ثم وجه مزود تصنيف Hugging Face إلى تسمية بيانات الاعتماد:
# milvus.yaml
credential:
  huggingface_apikey:
    apikey: <YOUR_HUGGING_FACE_TOKEN>

function:
  rerank:
    model:
      providers:
        huggingface:
          credential: huggingface_apikey
          # url: https://router.huggingface.co
يمكن لمعلمة credential على مستوى الوظيفة أن تتجاوز التسمية على مستوى المزود. يجب أن تكون قيمتها تسمية بيانات اعتماد محددة في milvus.yaml ، وليس الرمز نفسه.
الخيار 2: متغير البيئة
إذا لم تحدد أي من وظيفة أو تكوين المزود تسمية بيانات الاعتماد، فقم بتعيين MILVUS_HUGGINGFACE_API_KEY في بيئة خدمة Milvus:
# docker-compose.yaml
standalone:
  environment:
    MILVUS_HUGGINGFACE_API_KEY: <YOUR_HUGGING_FACE_TOKEN>
استخدام Hugging Face Ranker
يتم تعريف Hugging Face Ranker وتطبيقه في وقت البحث. يمكنك تغيير أو حذف أداة الترتيب لكل عملية بحث دون تغيير مخطط المجموعة.
الخطوة 1: إعداد مجموعة
يُنشئ المثال التالي مجموعة تحتوي على حقل نصي لإعادة الترتيب وحقل متجه للاسترجاع الأولي:
from pymilvus import DataType, Function, FunctionType, MilvusClient

client = MilvusClient(uri="http://localhost:19530")

collection_name = "hugging_face_rerank_demo"
schema = client.create_schema()
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=1000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=4)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE",
)

client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
)

client.insert(
    collection_name=collection_name,
    data=[
        {
            "id": 1,
            "document": "Recent renewable energy developments include improved solar efficiency.",
            "dense": [0.10, 0.20, 0.30, 0.40],
        },
        {
            "id": 2,
            "document": "Climate policy and carbon markets have evolved rapidly in recent years.",
            "dense": [0.11, 0.19, 0.28, 0.39],
        },
        {
            "id": 3,
            "document": "New battery technology helps stabilize wind and solar power generation.",
            "dense": [0.90, 0.10, 0.05, 0.02],
        },
        {
            "id": 4,
            "document": "Vector databases support similarity search for machine learning applications.",
            "dense": [0.01, 0.02, 0.03, 0.04],
        },
    ],
)
الخطوة 2: تعريف دالة إعادة الترتيب
قم بتعريف دالة إعادة الترتيب ( RERANK ) التي تقرأ النص المرشح من document وتستخدم نص الاستعلام الموجود في queries:
hugging_face_ranker = Function(
    name="hugging_face_semantic_ranker",
    input_field_names=["document"],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "model",
        "provider": "huggingface",
        "model_name": "sentence-transformers/all-MiniLM-L6-v2",
        "hf_provider": "hf-inference",
        "queries": ["renewable energy developments"],
        "credential": "huggingface_apikey",
        "max_client_batch_size": 32,
    },
)
إذا كنت تستخدم فقط بيانات الاعتماد على مستوى المزود أو متغير البيئة، فاحذف credential من معلمات الدالة.
يصف الجدول التالي معلمات Hugging Face Ranker:
| المعلمة | مطلوب؟ | الوصف |
|---|---|---|
reranker | نعم | تنفيذ إعادة الترتيب. اضبط هذه القيمة على model. |
provider | نعم | مزود النموذج. اضبط هذه القيمة على huggingface. |
model_name | نعم | معرف نموذج Hugging Face الخاص بنموذج يتم تقديمه عبر hf-inference لمهمة sentence-similarity. |
queries | نعم | سلاسل الاستعلام المستخدمة لإعادة الترتيب. أدخل سلسلة واحدة فقط لكل استعلام بحث، حتى عندما يستخدم الاسترجاع الأولي متجهات الاستعلام. |
hf_provider | لا | مسار مزود الاستدلال (Inference Provider) الخاص بـ Hugging Face. القيمة الافتراضية والوحيدة المدعومة في Milvus 2.6.20 هي hf-inference. |
credential | لا | تسمية بيانات الاعتماد المحددة في قسم المستوى الأعلى credential في milvus.yaml. هذه القيمة ليست الرمز نفسه. |
max_client_batch_size | لا | الحد الأقصى لعدد النصوص المرشحة المرسلة في طلب Hugging Face واحد. القيمة الافتراضية هي 32 ، ويجب أن تكون القيمة أكبر من 0. |
الخطوة 3: البحث باستخدام أداة الترتيب
قم بتمرير الدالة عبر المعلمة ranker في search():
query_vector = [0.12, 0.21, 0.29, 0.41]

results = client.search(
    collection_name=collection_name,
    data=[query_vector],
    anns_field="dense",
    limit=3,
    output_fields=["document"],
    ranker=hugging_face_ranker,
    consistency_level="Strong",
)

print(results)
يقوم Milvus أولاً باسترداد المرشحين من dense ، ثم يستخدم نص الاستعلام الموجود في queries ونص المرشح الموجود في document لحساب درجات تشابه الجمل. يتم ترتيب المرشحين المعروضين وفقًا لدرجات Hugging Face.
استكشاف الأخطاء وإصلاحها
النموذج غير متاح لتشابه الجمل
افتح صفحة النموذج على Hugging Face وتحقق من قسم " Inference Providers " (مزودي الاستدلال). تأكد من أن hf-inference يقدم النموذج لـ sentence-similarity. إذا لم يكن الأمر كذلك، فاختر نموذجًا آخر يدعم هذه المهمة.
عدد سلاسل الاستعلام لا يتطابق مع طلب البحث
يجب أن يساوي عدد سلاسل الاستعلام في queries عدد استعلامات البحث (nq). للبحث باستخدام متجه استعلام واحد، أدخل سلسلة استعلام واحدة فقط.
النص المرشح مفقود أو قابل للفراغ
تأكد من أن input_field_names يحتوي على حقل واحد فقط غير قابل للفراغ VARCHAR وأن كل كيان مرشح يحتوي على نص في هذا الحقل.
يبلغ Milvus عن فقدان بيانات اعتماد Hugging Face
تأكد من وجود تسمية بيانات اعتماد الوظيفة في milvus.yaml ، وأن التسمية على مستوى المزود صالحة، أو أن MILVUS_HUGGINGFACE_API_KEY موجود في بيئة خدمة Milvus.
الخطوات التالية
- للاطلاع على سلوك مصنف النماذج المشترك وحدوده، راجع نظرة عامة على مصنف النماذج.
- لإنشاء التضمينات من خلال مزودي الاستدلال المستضافين من Hugging Face، راجع Hugging Face.
- لتطبيق أداة التصنيف على البحث الهجين، راجع " البحث الهجين متعدد المتجهات".
