Annuncio di Milvus 3.0: ricerca vettoriale lake-native e un motore di recupero più potente
Oggi rilasciamo Milvus 3.0, un’importante pietra miliare architetturale per il progetto. Cambia sia dove Milvus può creare e servire gli indici, sia quanta parte del lavoro di retrieval può essere eseguita direttamente all’interno del motore.
- Milvus 3.0 introduce un percorso lake-native per indicizzare dati vettoriali che risiedono in object storage e formati di tabella aperti, tra cui Parquet, Lance, Iceberg e Vortex. I team possono rendere ricercabili i dati residenti nel lake senza mantenere un’altra copia in un database vettoriale.
- Questa release estende inoltre Milvus oltre il recupero iniziale dei candidati. Ordinamento lato server, aggregazione, ricerca a faccette, StructArray per strutture doc/chunk annidate e vettori ColBERT, e un indice sparso riprogettato spostano più attività di ranking, raggruppamento ed elaborazione dei risultati fuori dal codice applicativo e dentro il motore di retrieval.
Insieme, questi progressi rendono Milvus la base open-source per il retrieval AI in produzione e per architetture Vector Lakebase che combinano storage lake-native con retrieval vettoriale ad alte prestazioni.
Una rapida panoramica delle funzionalità di Milvus 3.0
| Area | Funzionalità | Perché è importante |
|---|---|---|
| Retrieval lake-native | External Collections su Parquet, Lance, Iceberg e Vortex | Cerca dati residenti nel lake senza mantenere una seconda copia di serving |
| Storage basato su S3 | Loon (Storage v3) | Riduce l’amplificazione delle letture puntuali per accessi in stile serving e supporta l’evoluzione dello schema |
| Workflow offline/batch e ripristino | Snapshot, Spark DataSource V2 ed evoluzione dello schema online | Porta viste stabili delle collection nei pipeline di valutazione, deduplicazione, clustering e feature |
| Motore di retrieval | ORDER BY, aggregazione, faccette, StructArray e retrieval sparso migliorato | Sposta più elaborazione dei risultati e scoring multi-vettore in Milvus |
| Modello dati e operazioni | Vettori nullable, TEXT LOB, TTL, MinHash, Woodpecker e ForceMerge | Supporta modelli dati più ricchi e pattern operativi di produzione |
L’infrastruttura lake-native: indicizzare e servire i dati dove già risiedono
Il più grande cambiamento architetturale in Milvus 3.0 riguarda dove il sistema può creare e servire gli indici. I dati vettoriali possono rimanere in formati aperti su object storage mentre Milvus fornisce indicizzazione, retrieval e API di livello produzione.
1. External Collections: indicizzazione direttamente su dati residenti nel lake
Molti team archiviano già gli embedding in un data lake — tabelle Lance, tabelle Iceberg, file Parquet o altri dataset in formato aperto su S3, GCS o Azure Blob Storage. Prima di Milvus 3.0, di solito esistevano due opzioni per cercare in quei dati.
- Copiare gli embedding in un database vettoriale. Questo offre ricerca a bassa latenza, ma crea una seconda copia e una pipeline ETL che deve rimanere sincronizzata.
- Interrogare direttamente il lake. Questo evita la duplicazione, ma senza indici ANN, la ricerca vettoriale diventa una scansione brute-force che non può soddisfare la latenza di produzione.
External Collections introduce una terza via. Definisci una collection Milvus su dati che rimangono in object storage, mappi i campi esterni in uno schema Milvus e usi le stesse API di ricerca e query di una collection nativa. I file sorgente non vengono spostati; Milvus crea e serve indici vettoriali, invertiti BM25, JSON e scalari sui dati esterni.
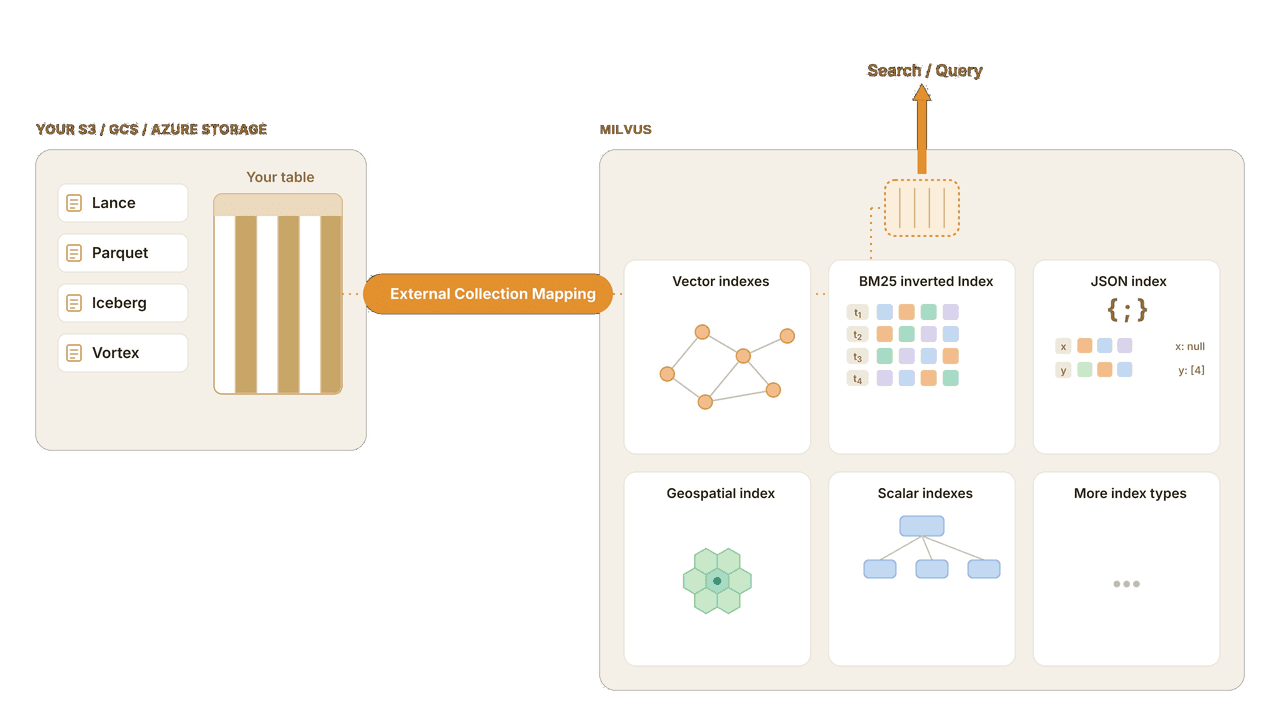
Le External Collections sono read-only e zero-copy, il che le rende utili quando governance, confini di proprietà o costi operativi richiedono che il dataset sorgente rimanga nel lake.
Quando il dataset esterno cambia, Milvus legge il suo manifest di storage e indicizza i frammenti appena aggiunti invece di ricostruire l’intera collection.
import json
import os
import time
from pymilvus import DataType, MilvusClient
client = MilvusClient(uri=“”)
# Register an Iceberg table as a zero-copy collection.
schema = client.create_schema(
external_source=“s3://lake/docs/metadata/v1.metadata.json”,
external_spec=json.dumps(
{
“format”: “iceberg-table”,
“snapshot_id”: 123456789,
“extfs”: {
“cloud_provider”: “aws”,
“region”: “us-east-1”,
“access_key_id”: os.environ[“AWS_ACCESS_KEY_ID”],
“access_key_value”: os.environ[“AWS_SECRET_ACCESS_KEY”],
},
}
),
)
schema.add_field(field_name=“id”, datatype=DataType.INT64, external_field=“doc_id”)
schema.add_field(field_name=“emb”, datatype=DataType.FLOAT_VECTOR, dim=1024, external_field=“embedding”)
schema.add_field(field_name=“title”, datatype=DataType.VARCHAR, max_length=1024, external_field=“title”)
client.create_collection(collection_name=“docs”, schema=schema)
# Import the external table snapshot.
job_id = client.refresh_external_collection(collection_name=“docs”)
while True:
progress = client.get_refresh_external_collection_progress(job_id=job_id)
if progress.state == “RefreshCompleted”:
break
if progress.state == “RefreshFailed”:
raise RuntimeError(progress.reason)
time.sleep(1)
index_params = client.prepare_index_params()
index_params.add_index(field_name=“emb”, index_type=“HNSW”, metric_type=“COSINE”)
client.create_index(collection_name=“docs”, index_params=index_params)
client.load_collection(collection_name=“docs”)
Negli ambienti governati, il retrieval può essere eseguito dove i dati sono autorizzati a risiedere. Per grandi sistemi AI, un dataset residente nel lake può supportare più deployment di retrieval senza un job di migrazione tra di essi.
Le collection esterne sono una funzionalità additiva. Le collection native Milvus rimangono il percorso principale per il serving write-heavy e a bassa latenza, mentre le External Collections sono progettate per dataset il cui sistema di record rimane al di fuori di Milvus.
Per maggiori dettagli, consulta Creare una External Collection.
2. Loon (Storage v3): letture puntuali efficienti per il retrieval lake-native
Le External Collections sollevano una domanda ovvia: l’object storage è progettato per scalabilità e durabilità, ma può supportare le letture puntuali ristrette che seguono una ricerca ANN?
La sfida è l’amplificazione delle letture. La ricerca vettoriale viene comunemente eseguita in due fasi: un indice ANN restituisce ID candidati e il sistema recupera i campi selezionati per quei candidati. I formati ottimizzati per scansioni analitiche possono trasformare un lookup logico ristretto in una lettura fisica molto più grande.
Milvus 3.0 affronta questo problema con Loon, noto anche come Storage v3, un motore di storage colonnare basato su manifest per object storage compatibile con S3. Loon organizza i campi in ColumnGroups con ID riga allineati, consentendo ai campi scalari di privilegiare filtri e scansioni mentre vettori e campi con molte letture puntuali utilizzano layout progettati per lookup più ristretti.
Loon mantiene gli indici vettoriali e invertiti separati dal formato file invece di incorporarli al suo interno. Ogni versione del dataset è descritta da un manifest immutabile che registra i suoi ColumnGroups, consentendo allo stesso motore di indicizzazione di funzionare su Lance, Parquet, Iceberg e Vortex.
Il design basato su manifest rende inoltre l’evoluzione dello schema meno dirompente. Aggiungere o rimuovere un campo può aggiornare i metadati senza riscrivere le colonne esistenti. Il popolamento di un nuovo campo scrive un nuovo ColumnGroup lasciando invariati i ColumnGroups esistenti.
Vortex è il formato predefinito per questo percorso. È un formato colonnare aperto e compatibile con Arrow, con layout flessibili e codifiche annidate che si adattano meglio ai dati AI con molte query puntuali. In un benchmark interno con 3 milioni di righe, vettori a 128 dimensioni, S3 e 256 lettori concorrenti, l’I/O misurato per lettura puntuale è sceso da circa 9,4 MB per il baseline Parquet a 0,07 MB per Vortex con Loon, circa 135 volte in meno.
Milvus 3.0 non fa sì che l’object storage si comporti come memoria locale. Riduce l’amplificazione delle letture che altrimenti rende l’object storage impraticabile per lookup puntuali in stile serving. Il predicate pushdown nel formato e una variante locale di Vortex sono i prossimi elementi della roadmap.
Per maggiori dettagli, consulta il nostro blog: Perché abbiamo creato Loon e il progetto Vortex.
3. Snapshot: vista point-in-time senza copia dei dati
I job offline hanno bisogno di una vista coerente dei dati anche mentre le collection di produzione continuano a ricevere scritture. Uno snapshot Milvus è una vista point-in-time, read-only, che registra riferimenti a file di dati, indici e metadati esistenti invece di copiare l’intero dataset.
Questo rende gli snapshot abbastanza economici da creare prima di operazioni rischiose come la sostituzione di un modello, un job di re-embedding o una migrazione dello schema. Il ripristino di uno snapshot può riutilizzare file di dati e indici esistenti tramite copia lato server nell’object storage, invece di reimportare ogni riga e ricostruire ogni indice. Questa funzionalità è particolarmente utile per workload in rapido movimento come gli agenti AI, dove i dati cambiano costantemente e si desiderano punti di ripristino frequenti ed economici invece di backup pesanti occasionali.
La stessa vista congelata può supportare valutazione, deduplicazione, validazione di backfill e test isolati mentre la collection live continua ad accettare scritture. Lo snapshot stabilizza l’input logico, sebbene i workload possano comunque condividere infrastrutture come object storage e larghezza di banda di rete.
Gli snapshot non sostituiscono i backup. Uno snapshot fa riferimento a file di proprietà della collection live ed è più adatto a ripristino logico, clonazione e viste stabili di breve durata. Un backup crea una copia indipendente per conservazione a lungo termine e disaster recovery.
Per maggiori informazioni, consulta Snapshot, Gestire gli snapshot e Casi d’uso degli snapshot.
4. Connettore Spark: collegare Milvus ai workflow batch
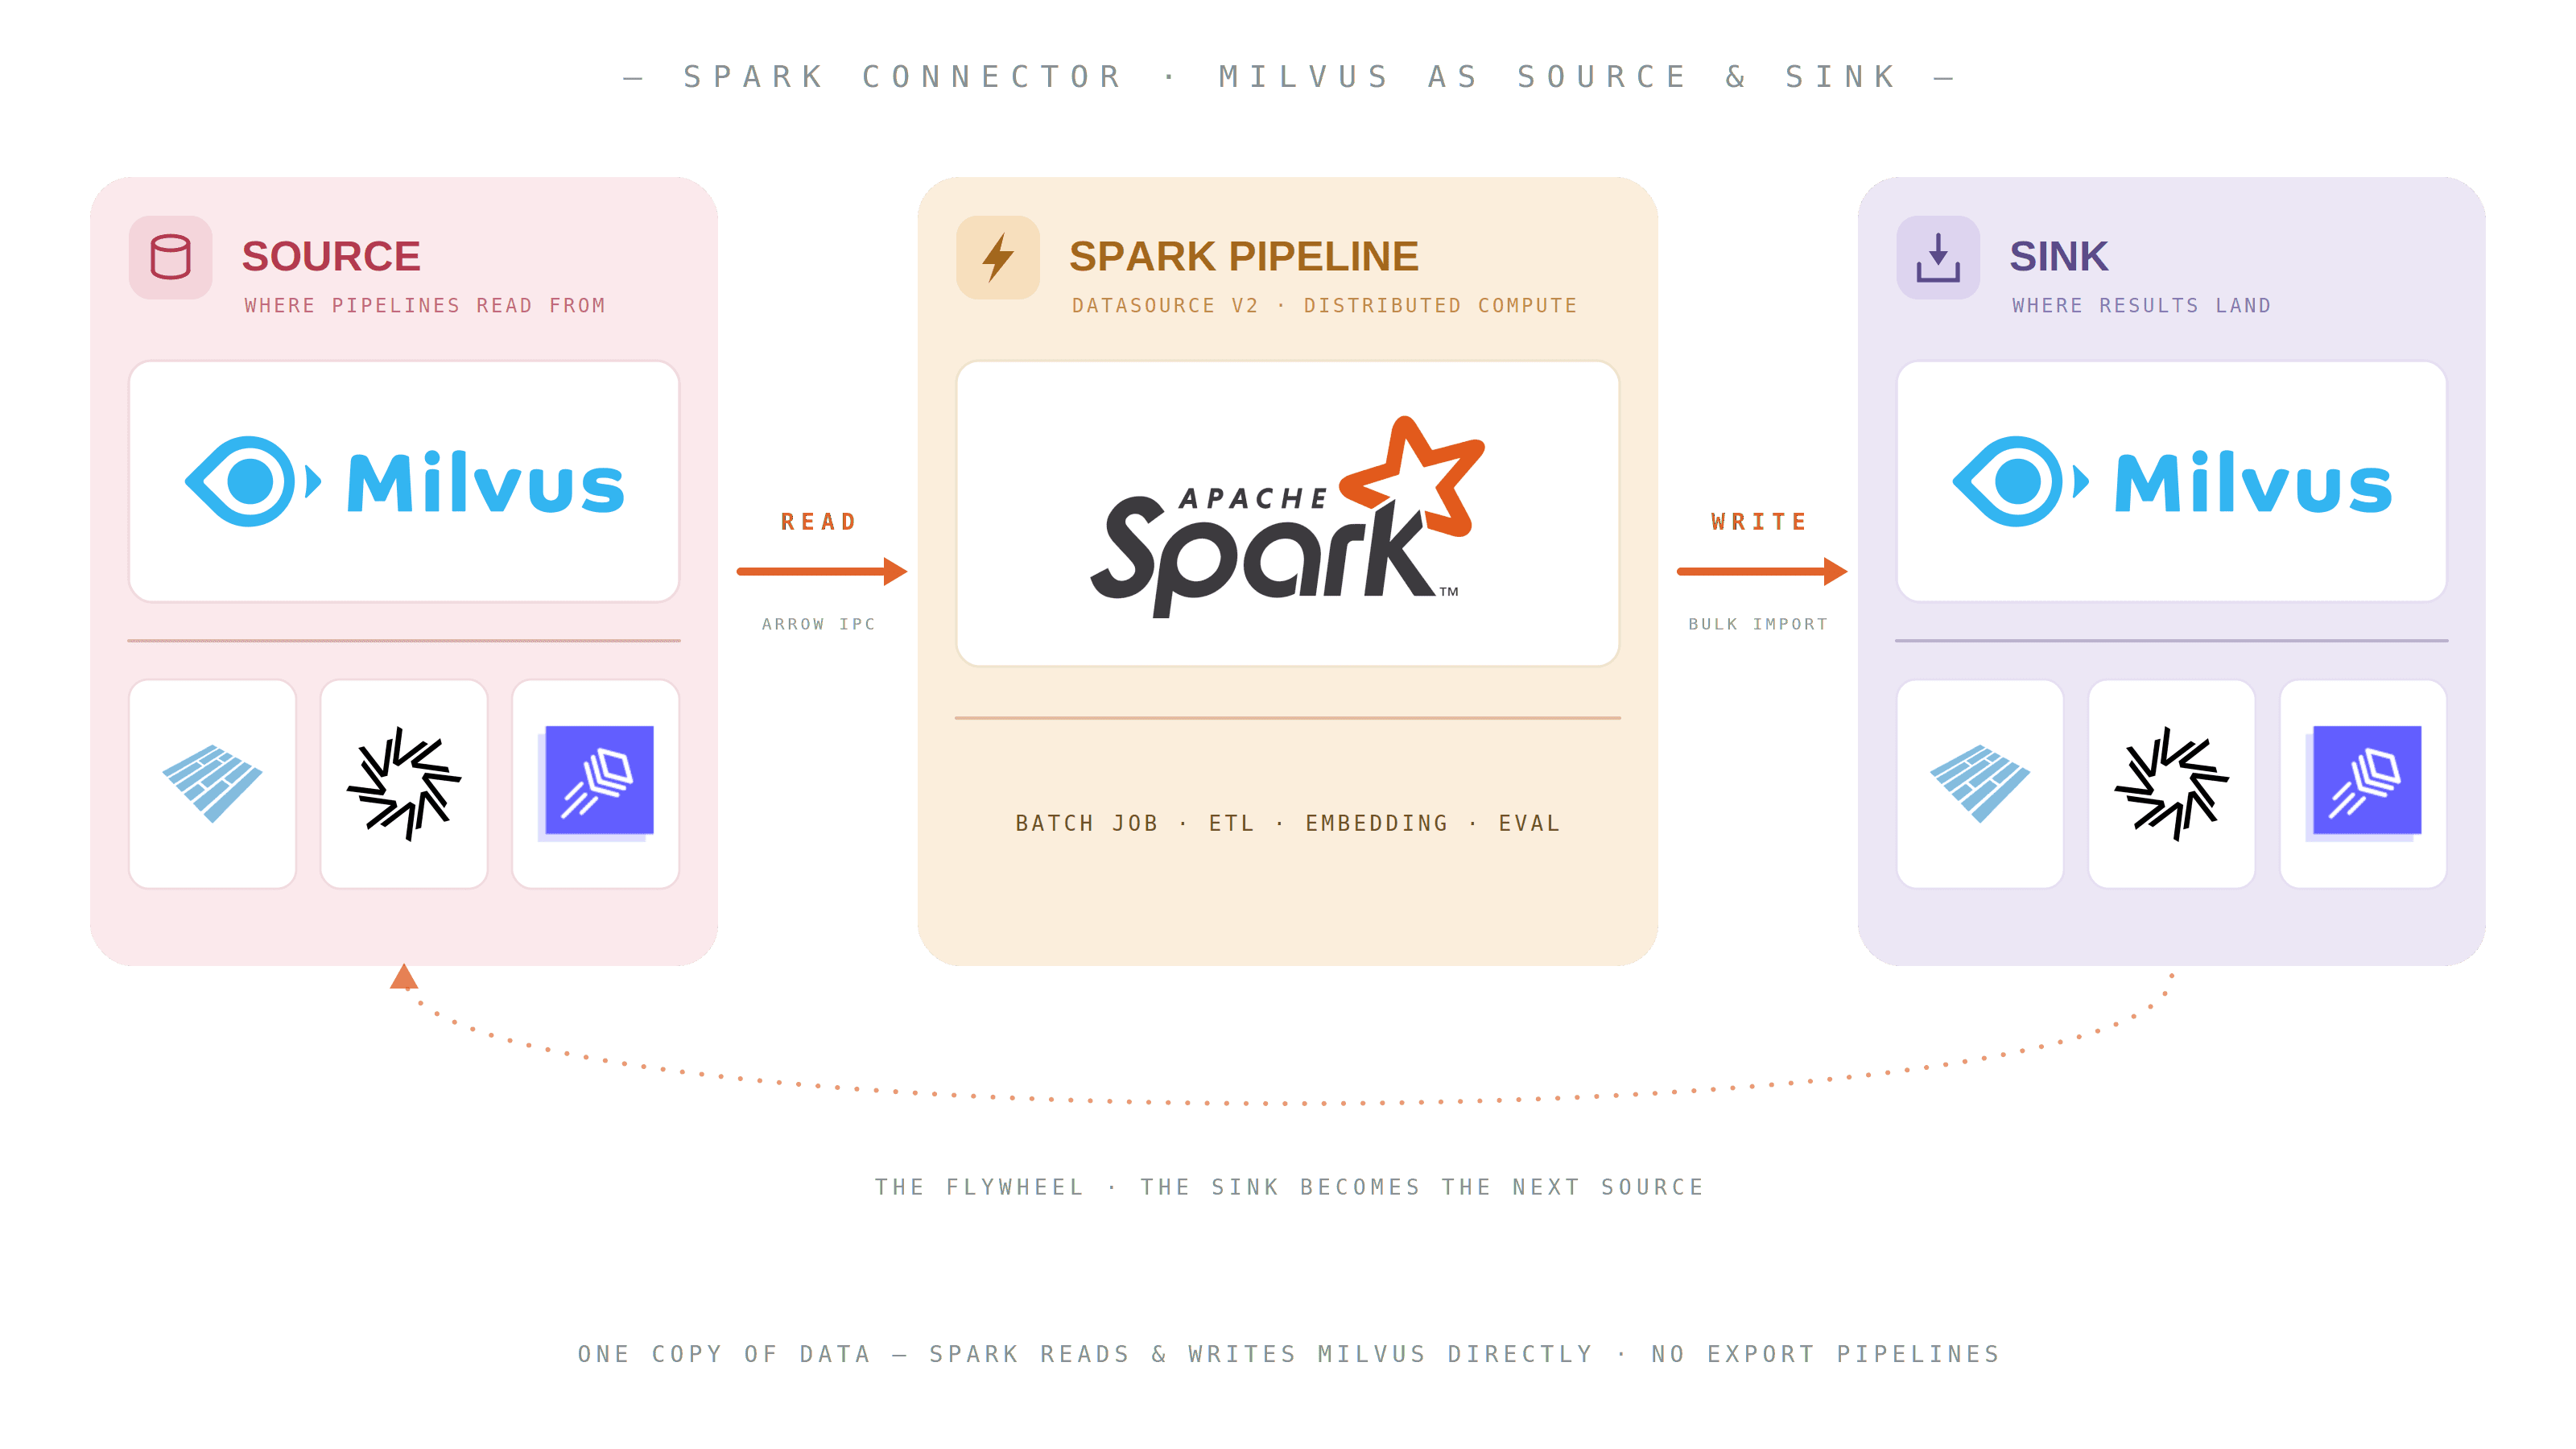
Uno snapshot stabile è utile solo se i motori batch possono leggerlo. Milvus 3.0 espone Milvus come Spark DataSource V2, consentendo a job Spark, Databricks ed EMR di leggere da e scrivere su Milvus come parte di pipeline batch standard.
Questa funzionalità è importante perché i workflow di dati AI sono iterativi: la deduplicazione alimenta il re-embedding, il clustering alimenta la valutazione e la valutazione produce set curati per training o serving. Uno snapshot stabile fornisce a questi job un input coerente, mentre la collection live continua a servire. Con il connettore Spark, il sink di un job diventa la sorgente del successivo, senza esportare ogni volta un’intera collection fuori da Milvus.
Milvus 3.0 introduce inoltre operatori batch vector-native per attività come deduplicazione, rilevamento di anomalie e clustering, mantenendo il lavoro compute-heavy fuori dal percorso di query online pur operando direttamente sui dati vettoriali.
5. Modifiche dello schema online e backfill
Uno schema raramente rimane statico in produzione — i team aggiungono nel tempo nuovi modelli di embedding, vettori sparsi, etichette, campi di metadati e policy di retention. Milvus 3.0 consente di aggiungere, popolare e rimuovere colonne mentre il serving continua, invece delle ricostruzioni dirompenti che ciò richiedeva in passato.
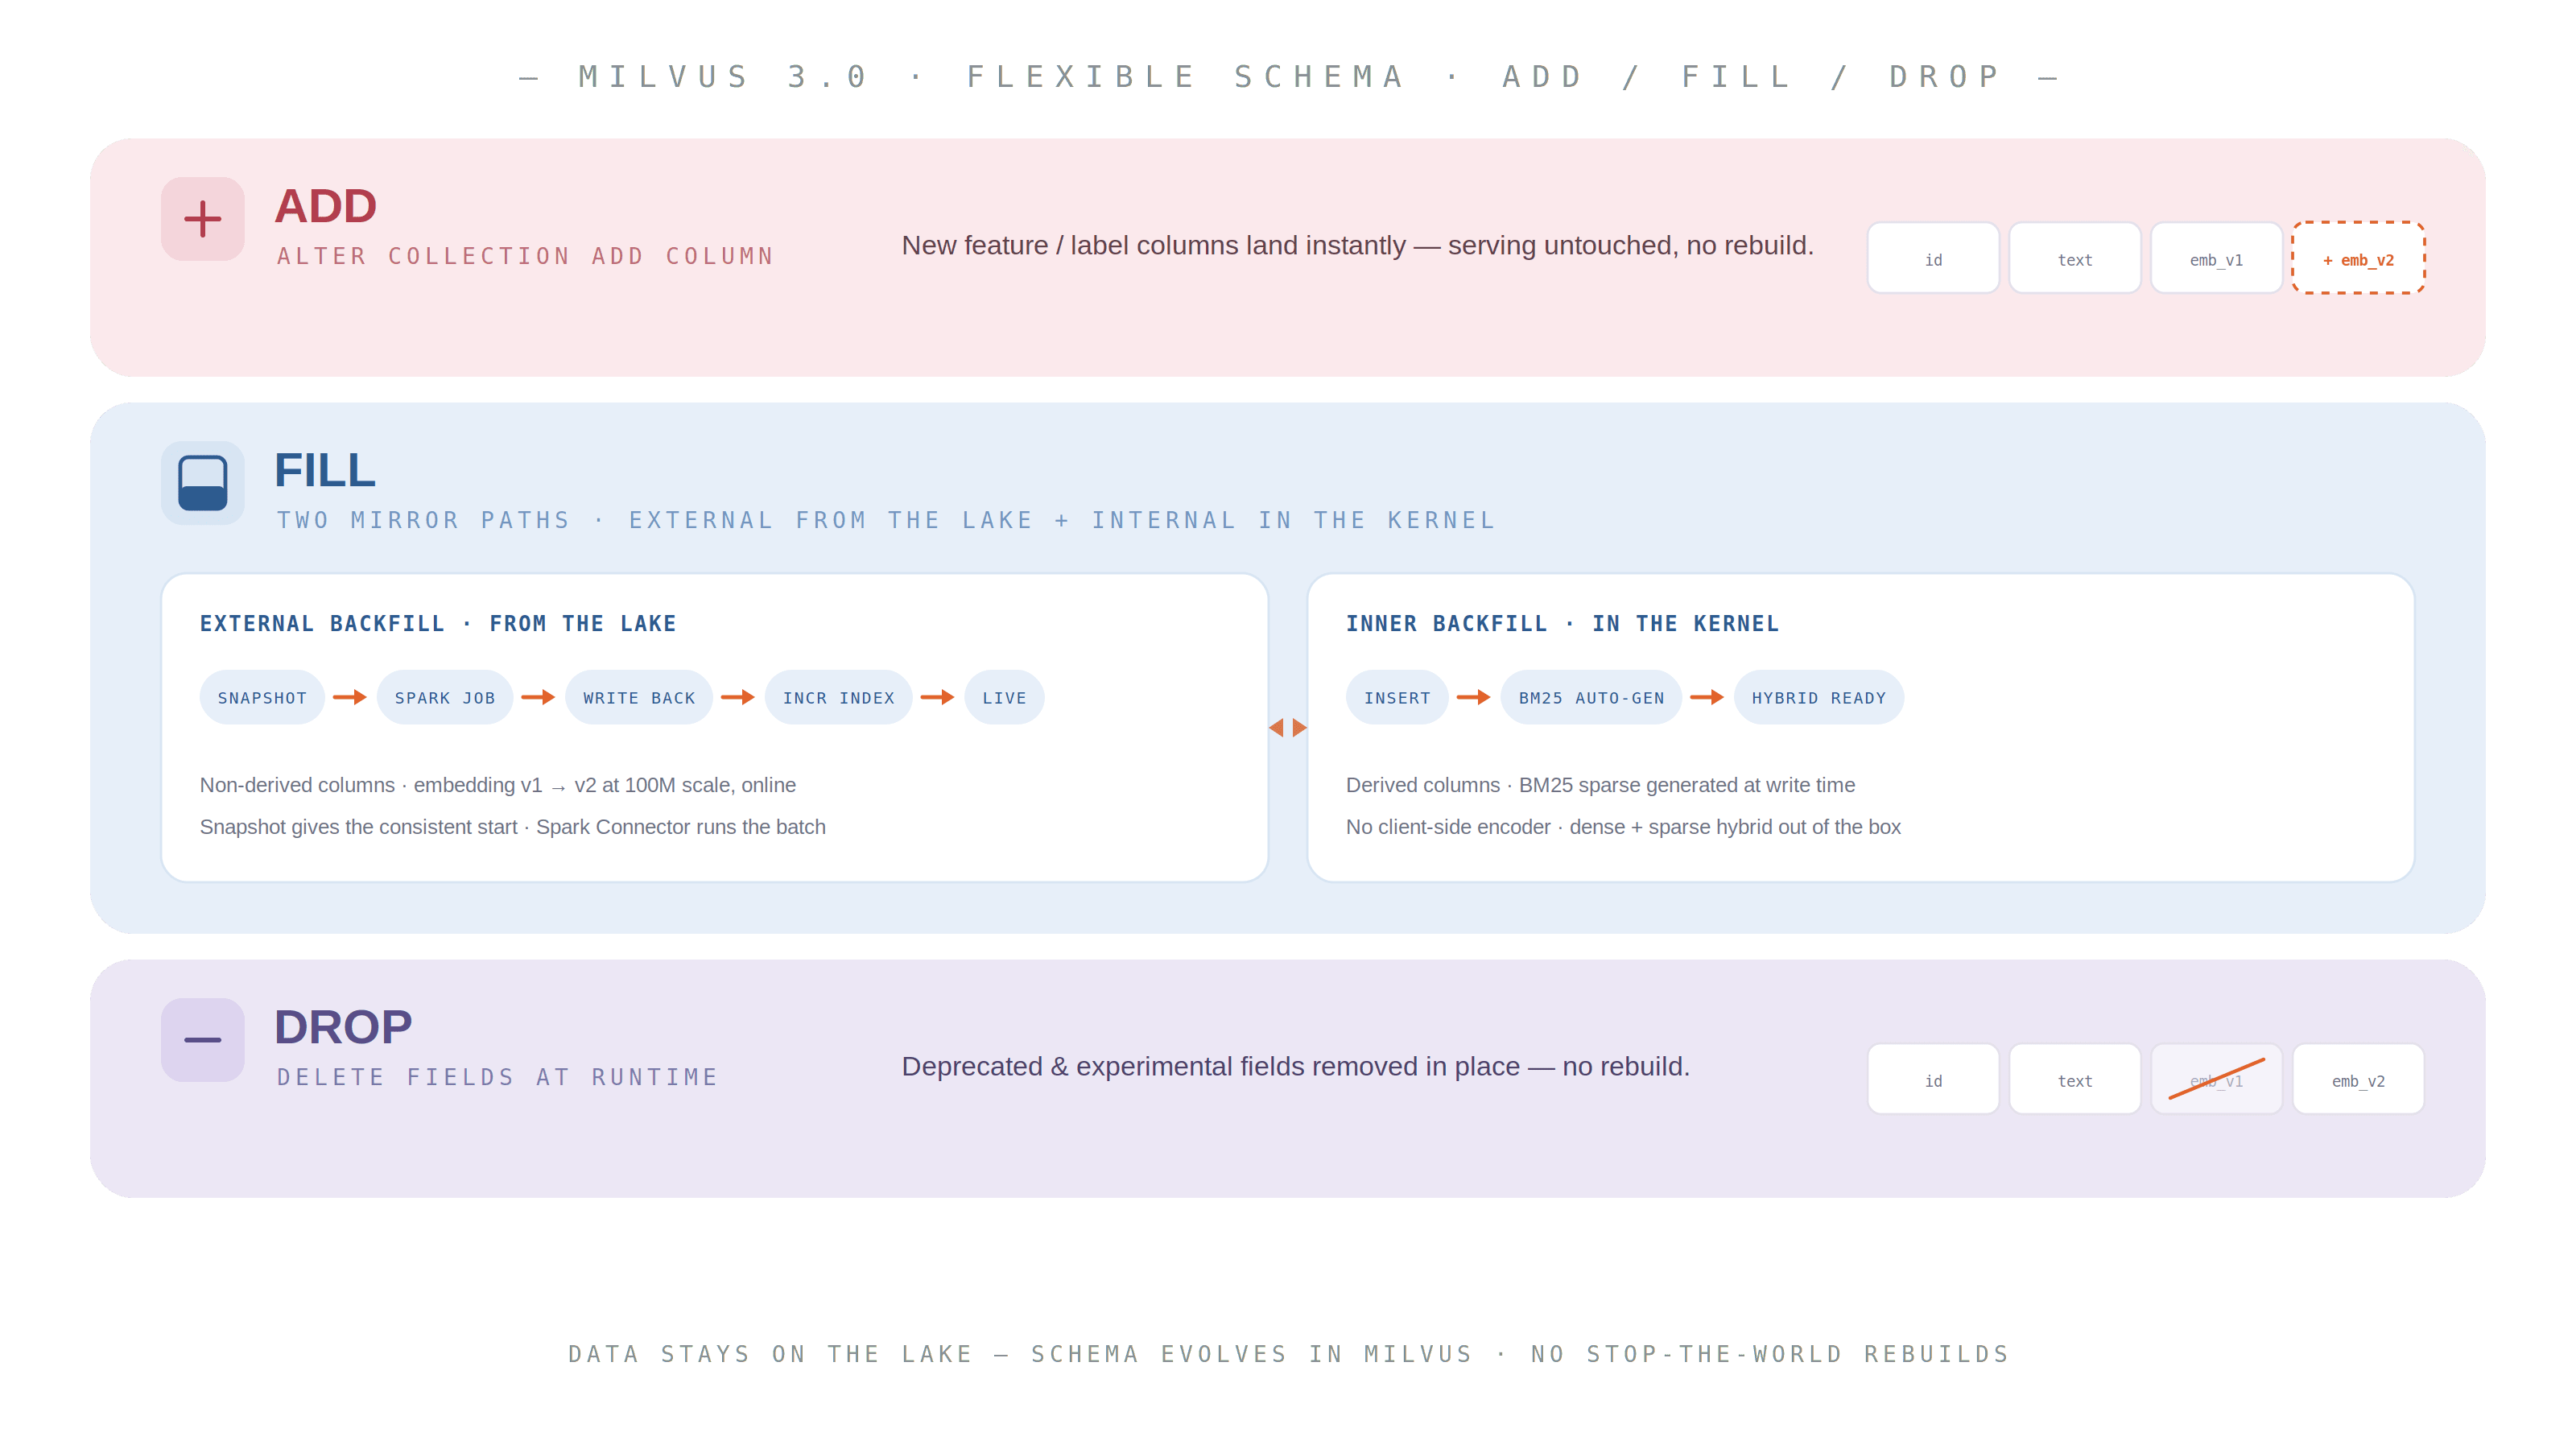
Aggiungere o rimuovere una colonna non richiede la riscrittura dei dati esistenti. client.add_collection_field(...) inserisce una nuova colonna nullable senza portare offline la collection, e client.drop_collection_field(...) rimuove a runtime un campo deprecato o sperimentale. Nessuna delle due operazioni riscrive i dati esistenti — ciascuna è una modifica al manifest della collection invece che ai file di dati, motivo per cui non è necessaria alcuna ricostruzione.
Milvus 3.0 supporta due percorsi di backfill:
- Inner backfill (in 3.0) è destinato a valori derivati da campi esistenti. Milvus può generare un vettore sparso BM25 da una colonna di testo all’interno del kernel, eliminando la necessità di un encoder lato client quando si costruisce retrieval ibrido dense-plus-sparse.
- External backfill(nella roadmap) sarà destinato a valori calcolati fuori da Milvus: acquisire uno snapshot, eseguire Spark sulla vista coerente, calcolare una nuova colonna, scrivere i valori indietro e lasciare che Milvus aggiorni l’indice in modo incrementale. Questo è il percorso previsto per grandi job di re-embedding — ad esempio, aggiungere una nuova colonna di embedding su centinaia di milioni di righe mentre le scritture continuano.
Insieme, modifiche dello schema online e backfill rendono più semplice evolvere le pipeline di retrieval senza ricostruire un’intera collection ogni volta che cambia il modello dati.
Un motore più potente per il retrieval end-to-end
Milvus supporta da tempo più della ricerca ANN densa, incluso il retrieval sparso basato su BM25 e la ricerca ibrida. Milvus 3.0 estende il motore lungo un asse diverso: porta più elementi della pipeline di retrieval multi-stadio dentro Milvus stesso, riducendo over-fetching, logica applicativa duplicata e dipendenza da servizi separati di post-processing.
1. ORDER BY lato server: ordinamento dentro il motore, per segmento
In precedenza, l’ordinamento richiedeva alle applicazioni di recuperare candidati in eccesso, spostarli sul client e ordinarli lì. Questo consumava larghezza di banda e rendeva il risultato finale dipendente dal punto in cui avveniva il troncamento lato client.
Milvus 3.0 aggiunge ORDER BY lato server, che consente ai workload di query di ordinare le righe filtrate per campi scalari come rating, prezzo, freschezza, inventario o timestamp.
- Sul percorso di query, ogni segmento ordina il proprio set di risultati filtrati, i query node uniscono questi stream e il proxy restituisce la porzione richiesta.
- Sul percorso di ricerca, ORDER BY ordina il set di candidati ANN all’interno di Milvus, riducendo over-fetching lato client e post-processing duplicato. Non modifica il limite di recall stabilito dai candidati ANN.
client.query(
    collection_name="products",
    filter="category == 'shoes'",
    output_fields=["price", "rating"],
    limit=10,
    order_by=["rating:desc", "price:asc"],
)
Questo è particolarmente utile per ricerche che combinano rilevanza con vincoli aziendali o rivolti all’utente come rating, prezzo, freschezza, inventario o timestamp.
Per maggiori informazioni, consulta Ordinare i risultati di ricerca per campi scalari e Ordinare i risultati di query.
2. Aggregazione e ricerca a faccette
Milvus 3.0 aggiunge l’aggregazione lato query con operazioni come conteggio, somma, media, minimo e massimo, raggruppate per uno o più campi scalari. Questo elimina un pattern comune in cui i team estraggono righe filtrate nel codice client solo per contare, raggruppare o calcolare semplici statistiche.
client.query(
    collection_name="orders",
    filter="in_stock == true",
    group_by_fields=["category"],
    output_fields=["category", "count(*)", "avg(price)", "max(rating)"],
)
Milvus 3.0 aggiunge inoltre aggregazione di ricerca per la ricerca a faccette. Dopo una ricerca ANN, Milvus raggruppa gli hit recuperati per un campo e restituisce conteggi dei bucket, statistiche aggregate e top-N hit campione per bucket — il pattern alla base del raggruppamento per brand, fascia di prezzo, colore, tenant o tipo di documento. Un’avvertenza: l’aggregazione di ricerca opera sul set di risultati recuperati dall’ANN, non sull’intera collection, quindi i conteggi delle faccette sono approssimativi. Quando servono conteggi esatti, usa l’aggregazione lato query.
Per maggiori informazioni, consulta Aggregare i risultati di query.
3. StructArray per vettori annidati e modello late-interaction
Molte entità sono naturalmente rappresentate da più vettori. Un documento lungo è una serie di chunk; un video è una sequenza di frame che preferiresti mantenere insieme in una riga invece di disperdere su molte; un prodotto ha diverse immagini o angolazioni. I modelli late-interaction spingono questo concetto ancora oltre — ColBERT emette un vettore per token, ColPali uno per patch visiva. In ogni caso, l’unità che vuoi effettivamente archiviare e cercare è l’intera entità, non ciascun frammento da solo.
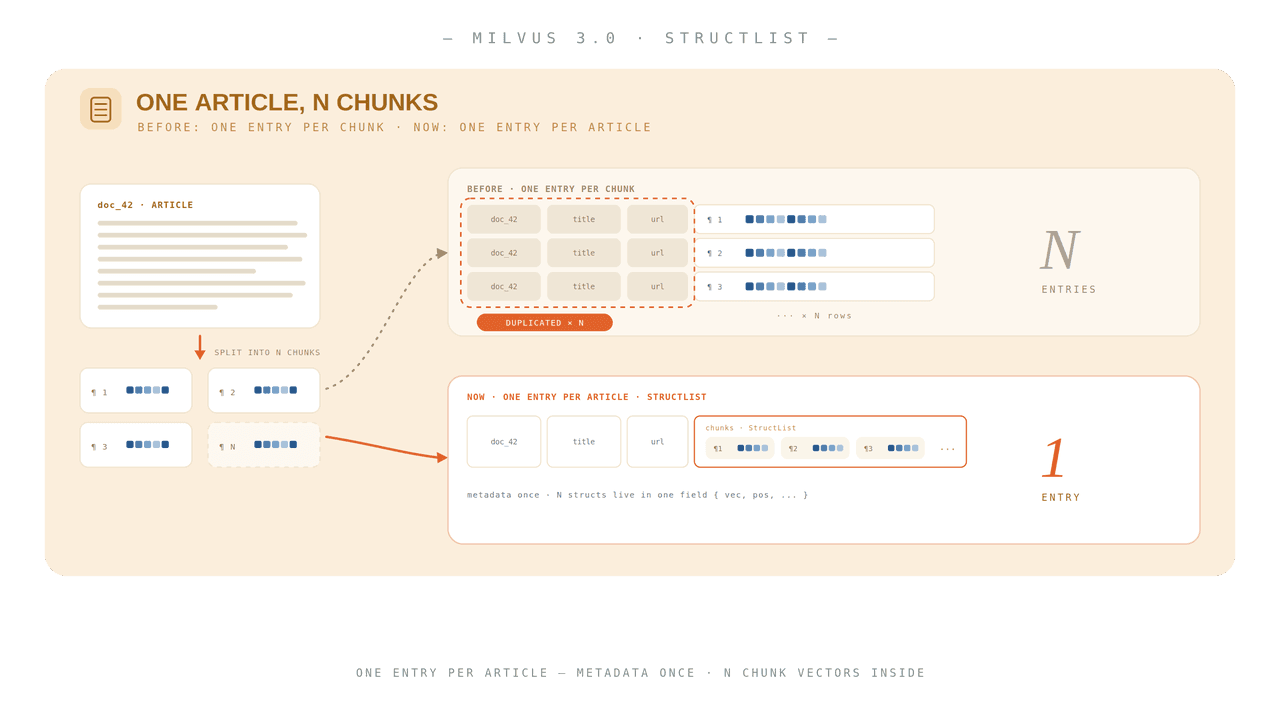
StructArray consente a una riga Milvus di contenere un array di lunghezza variabile di elementi strutturati, inclusi più vettori, preservando al contempo un singolo ID entità e un unico set di metadati. Questo evita di suddividere un documento in più righe e duplicare etichette, permessi o altri campi tra i frammenti.
Milvus supporta due granularità di ricerca.
- Ricerca a livello di elemento confronta un vettore di query con ciascun elemento nella lista e restituisce l’elemento specifico corrispondente con il suo offset. È utile quando vuoi sapere quale chunk, token, patch o immagine ha prodotto la corrispondenza. Una riga può apparire più di una volta se corrispondono più elementi.
- Ricerca a livello di entità confronta l’intera lista di vettori di una query con la lista di vettori della riga usando
MAX_SIM, con la metricaMAX_SIM_COSINE. Ogni token della query prende la sua migliore corrispondenza nel documento e quei punteggi migliori vengono sommati. Questo offre a Milvus supporto nativo per pattern di retrieval late-interaction come ColBERT e ColPali, mantenendo una riga per documento.
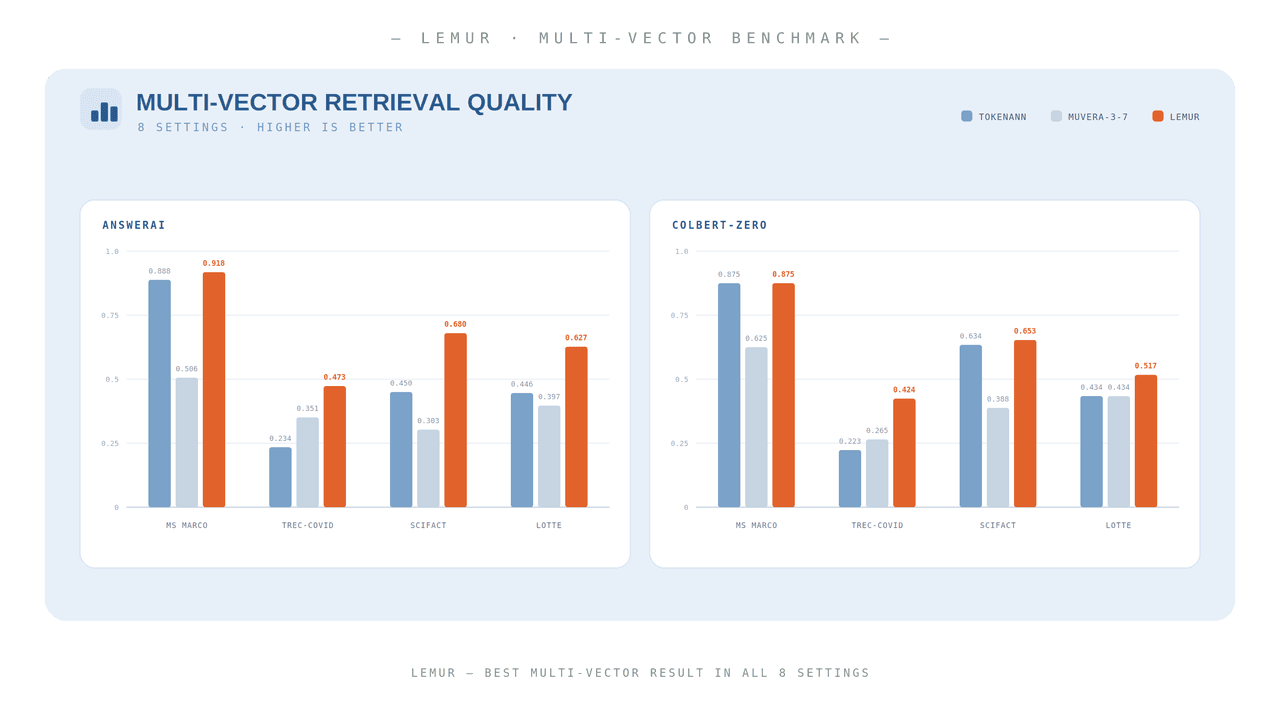
Indicizzare ogni vettore token può essere costoso; perciò Milvus 3.0 aggiunge più percorsi di accelerazione, tra cui TokenANN, Muvera e Lemur, che bilanciano dimensione dell’indice, costo di training e recall.
| Strategia | Rappresentazione di primo stadio | Profilo di costo | Ideale per |
|---|---|---|---|
| TokenANN | Ogni vettore token è indicizzato. | Massimo, esatto | Modelli ad alta discriminazione e documenti brevi |
| Muvera | Un vettore per documento usando FDE a proiezione casuale. | Medio, senza training | Documenti lunghi |
| Lemur | Un vettore per documento usando compressione MLP appresa | Minimo, richiede training | Modelli a bassa discriminazione e vettori visivi o di patch |
Nei nostri benchmark, Lemur eguaglia o supera la recall di TokenANN sulla maggior parte dei dataset, comprimendo al contempo ogni documento in un singolo vettore; l’eccezione sono i corpora con elevata varianza di lunghezza, dove TokenANN o un’altra strategia è più sicura.
Per corpora più grandi della memoria, Milvus supporta anche un indice DISKANN che mantiene le liste di embedding su disco per ridurre la pressione sulla RAM.
La ricerca a livello di elemento è già arrivata in Milvus 2.6. Il filtraggio per Muvera, Lemur e StructList è nuovo in 3.0.
4. Compressione dell’indice BM25 e SINDI
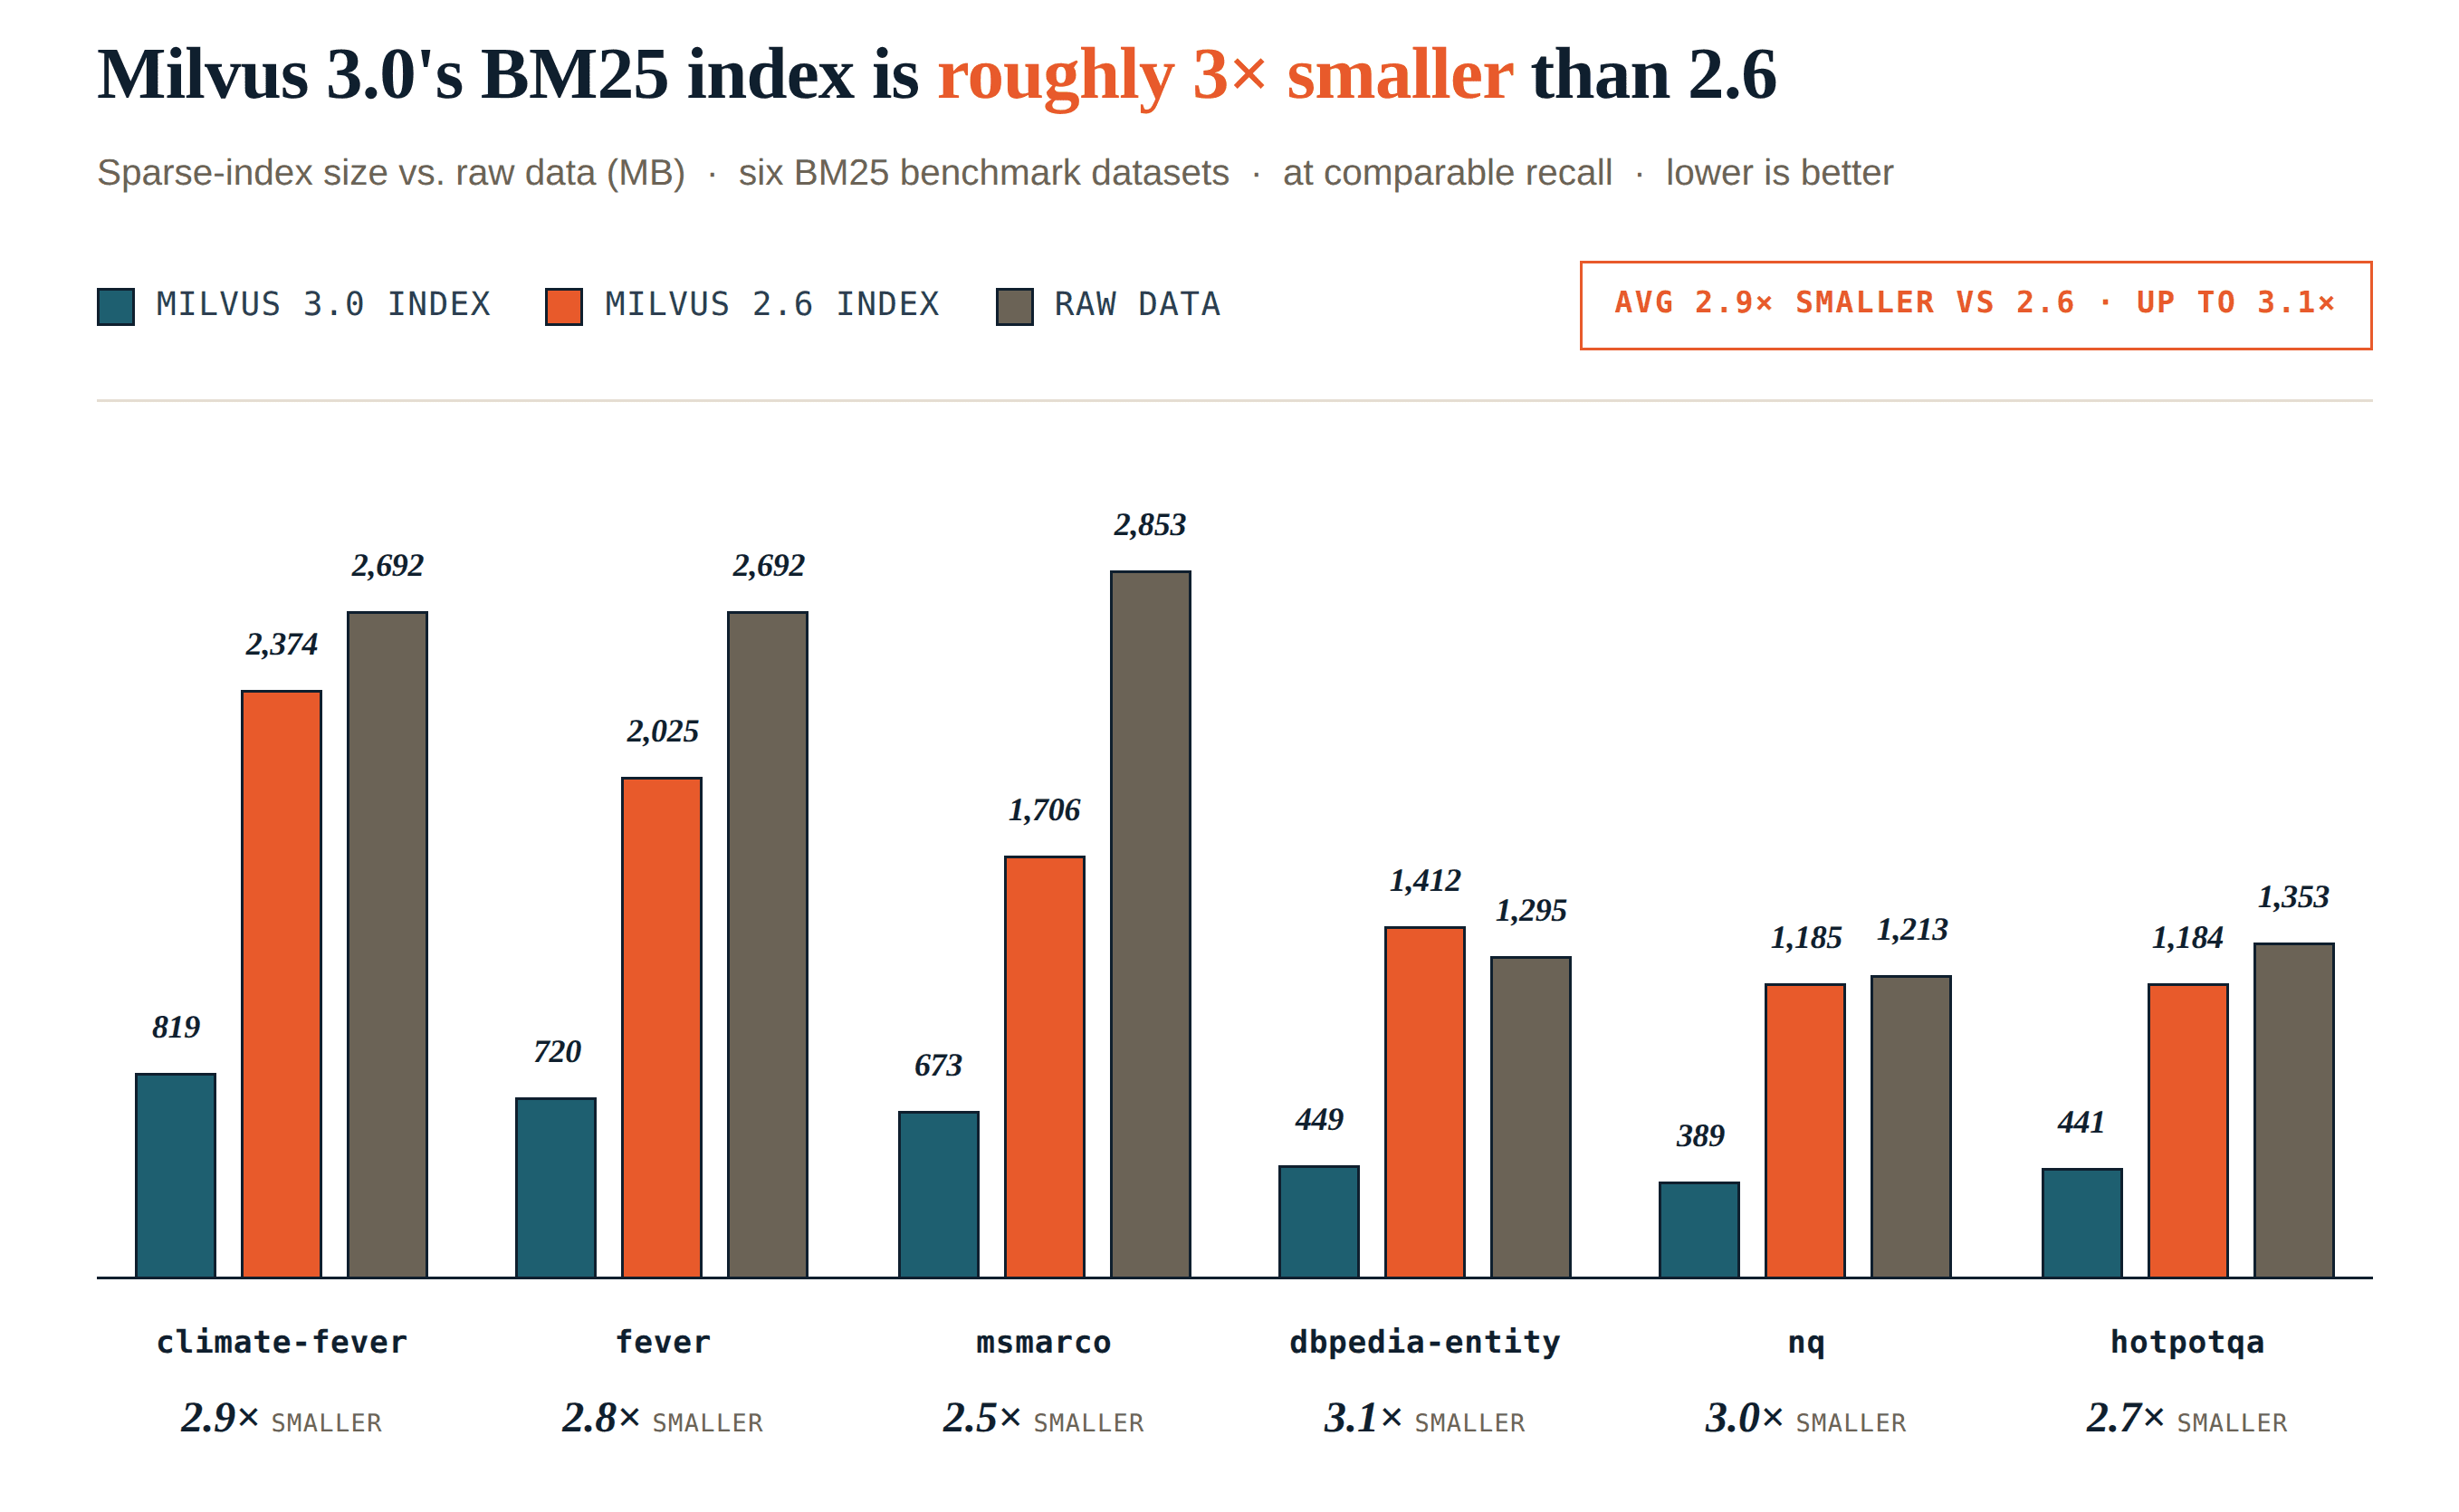
Milvus ha supportato la ricerca vettoriale sparsa nelle release precedenti. Milvus 3.0 riduce l’impronta dell’indice sparso tramite posting compressi a blocchi (algoritmi correlati a VByte più decodifica SIMD) e quantizzazione (fp16 per prodotti interni, u16 per BM25).
Su una serie di benchmark interni BM25, la nuova implementazione era circa 3 volte più piccola dell’indice sparso di Milvus 2.6 a recall comparabile. Un indice più piccolo riduce la pressione su memoria e larghezza di banda e può migliorare la velocità nei workload limitati dallo spostamento dei dati.
Milvus 3.0 introduce inoltre SINDI, un nuovo algoritmo di retrieval sparso ottimizzato per embedding sparsi appresi come SPLADE. Poiché questi embedding producono posting list più dense rispetto a BM25, gli algoritmi di ricerca con forte pruning possono spendere molto tempo CPU a decidere cosa saltare. SINDI invece organizza i posting in finestre compatte e usa accumulo dei punteggi SIMD-friendly per elaborarli in modo efficiente, preservando al contempo l’accuratezza del retrieval tramite pruning lossless.
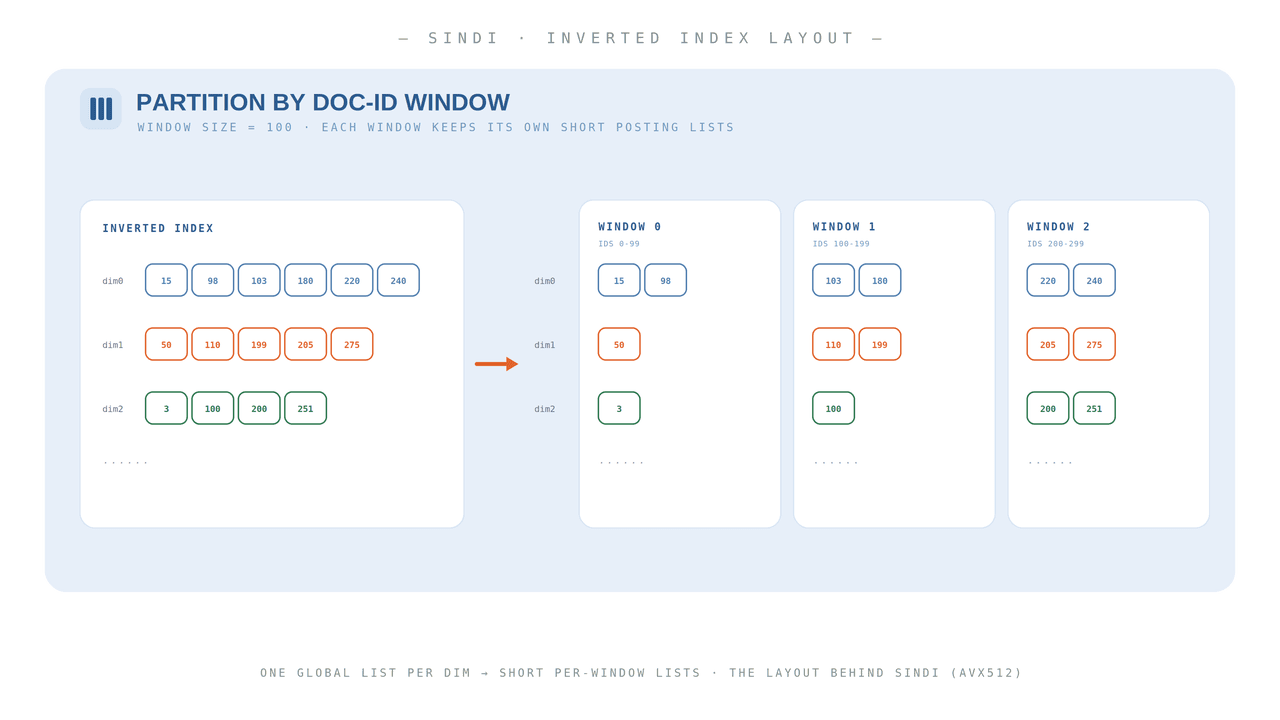
Abbiamo inoltre esteso SINDI oltre il suo design originale per includere il supporto BM25 nativo, consentendo a Milvus di usare lo stesso percorso di retrieval sparso ottimizzato sia per embedding sparsi appresi sia per la ricerca full-text tradizionale.
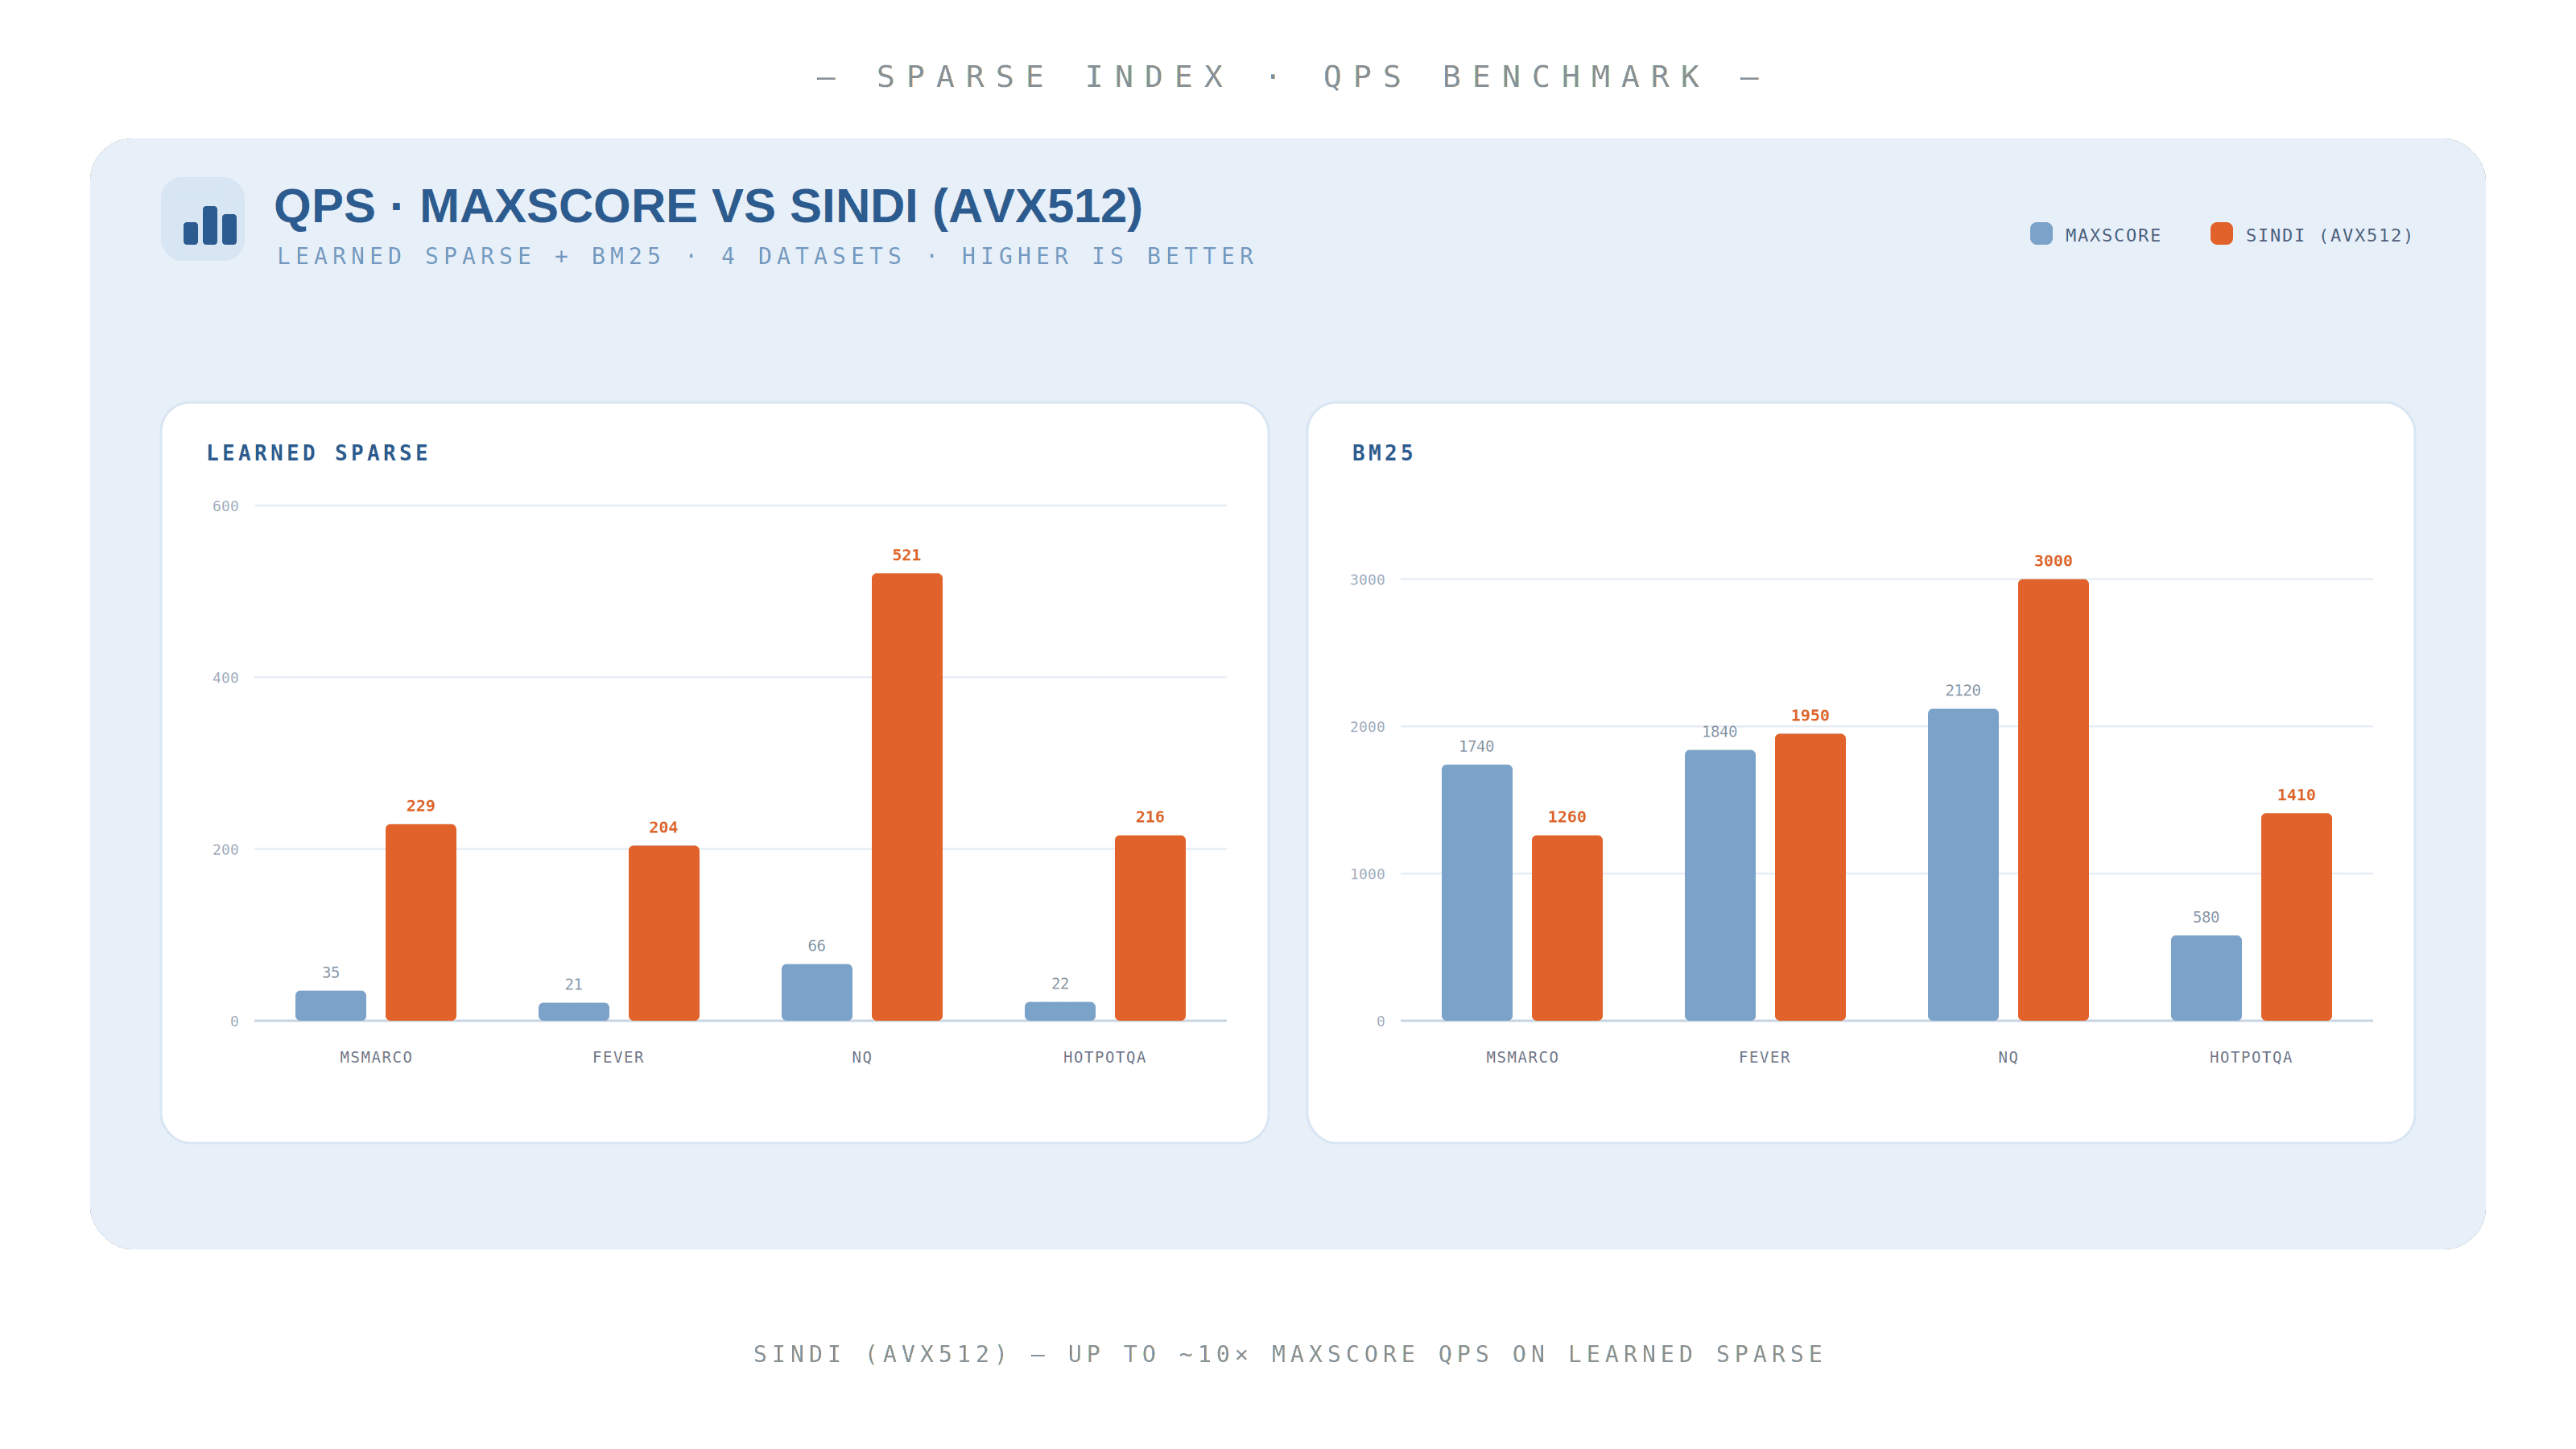
Nei nostri benchmark su 4 dataset di vettori sparsi SPLADE, SINDI raggiunge fino a circa 10x i QPS di MaxScore su vettori learned-sparse, con un caso peggiore di circa 5x.
SINDI è il valore predefinito per la ricerca sparsa con prodotto interno in Milvus 3.0.
Altri miglioramenti
- TEXT LOB: Archivia testo sorgente lungo accanto ai vettori. Il testo sotto i 64 KB rimane inline; i valori più grandi usano un riferimento Vortex LOB.
- Supporto ampliato agli indici densi: Aggiunge più scelte di indice all’interno della famiglia Faiss, tra cui SVS, Panorama, PQ, IVFPQ e ScaNN, per diversi requisiti di scala, memoria e recall.
- MinHash e ricerca di quasi-duplicati: Genera firme MinHash lato server e recupera candidati quasi duplicati usando MINHASH_LSH.
- Vettori nullable e nuovi tipi: Consente ai campi vettoriali di essere NULL e aggiunge TIMESTAMPTZ per filtri time-aware e policy di retention.
- Dizionari full-text personalizzati: Registra dizionari, sinonimi e risorse di stop-word sul cluster per tokenizzazione multilingue e specifica di dominio.
- Woodpecker standalone: Esegue il write-ahead log di Milvus come servizio scalabile e osservabile in modo indipendente.
- Entity TTL****: Fa scadere singoli record tramite un campo TIMESTAMPTZ, con filtraggio MVCC seguito da garbage collection durante la compaction.
- ForceMerge: Compatta piccoli segmenti fino a una dimensione target e ricostruisce gli indici per ridurre l’amplificazione delle letture prima di un servizio sostenuto read-heavy.
- E altro ancora
Inizia con Milvus 3.0
Milvus 3.0 è disponibile da oggi con licenza Apache 2.0 e rimane un progetto LF AI & Data. Per iniziare:
- Leggi le note di rilascio e il quickstart, e ottieni il sorgente su github.com/milvus-io/milvus.
- Unisciti alla community Milvus su Discord o prenota una sessione Milvus Office Hours per discutere il tuo caso d’uso con i maintainer.
Milvus 3.0 e Zilliz Vector Lakebase
Milvus 3.0 getta le basi open-source per il retrieval AI in produzione e per l’architettura emergente Vector Lakebase, che combina storage lake-native con retrieval vettoriale ad alte prestazioni su un’unica source of truth, ciascuno al costo giusto.
Zilliz Cloud è un Vector Lakebase completamente gestito creato dal team dietro Milvus. Condivide la stessa architettura distribuita e lake-native di Milvus ed è pienamente compatibile con l’API Milvus. Alimentato dal suo motore di indicizzazione proprietario Cardinal, Zilliz Cloud offre fino a 10× migliori prestazioni/prezzo rispetto agli approcci di indicizzazione open-source standard, eliminando al contempo la complessità operativa della gestione dell’infrastruttura. Le capacità enterprise includono compute scale-to-zero, disaster recovery cross-region, deployment BYOC, sicurezza e conformità di livello enterprise (SOC 2, HIPAA, ISO 27001 e GDPR) e fino al 99,99% di SLA.
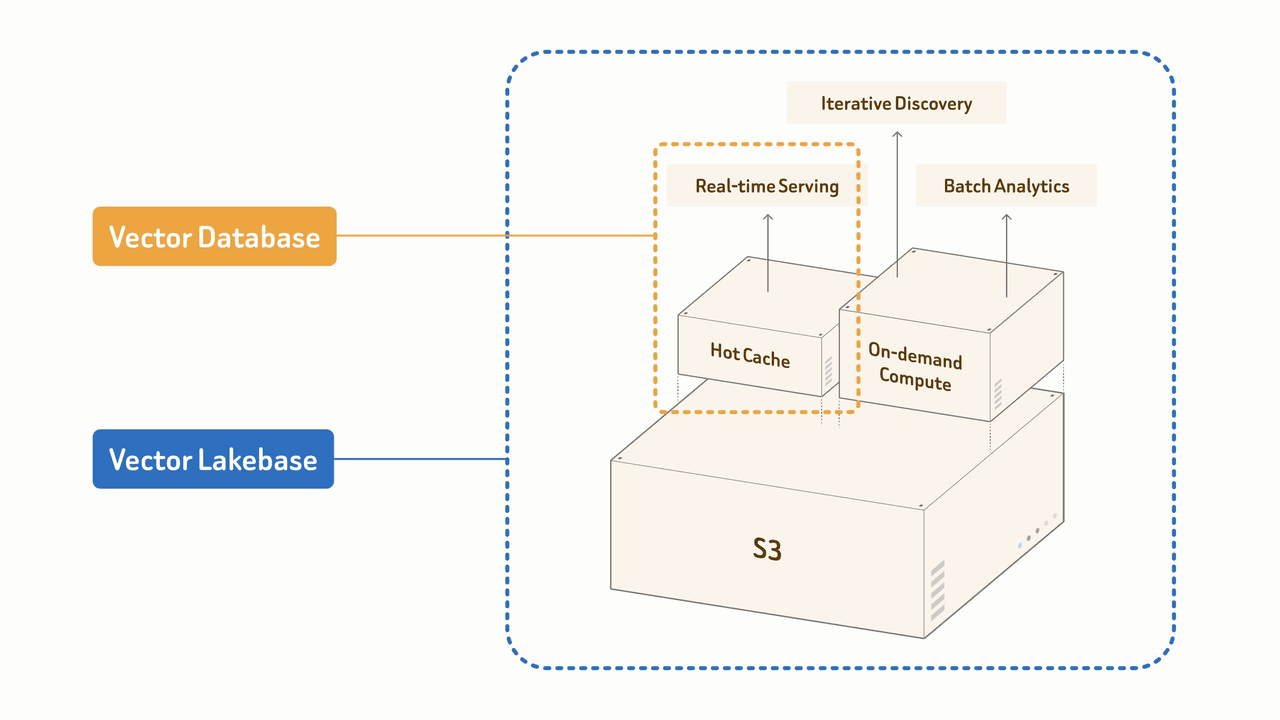
Gli sviluppatori possono distribuire Milvus come database vettoriale open-source o usare Zilliz Cloud per una piattaforma gestita su più workload lungo l’intero ciclo di vita dei dati AI.
Cosa viene dopo
La roadmap di Milvus si basa sull’architettura 3.0 con predicate pushdown per External Collections, external backfill, operatori Spark aggiuntivi e supporto per altri formati di tabella, tra cui Delta Lake e Apache Paimon.
La direzione più ampia è chiara: i sistemi di dati AI hanno bisogno di un ciclo più stretto tra retrieval online e miglioramento dei dati offline. I dati vettoriali non dovrebbero dover essere copiati in sistemi separati ogni volta che i team vogliono cercarli, analizzarli, migliorarli o servirli.
Prova Milvus gestito gratuitamente
Zilliz Cloud è senza problemi, basato su Milvus e 10 volte più veloce.
Inizia




Like the article? Spread the word