

模型排名器概述Compatible with Milvus 2.6.x
传统的向量搜索完全基于数学相似性对结果进行排序——即向量在高维空间中的匹配程度。虽然这种方法效率很高,但往往会忽略真正的语义相关性。以搜索“数据库优化的最佳实践”为例:您可能会收到向量相似度很高、频繁提及这些术语的文档,但这些文档实际上并未提供可操作的优化策略。
Model Ranker 通过集成能够理解查询与文档之间语义关系的先进语言模型,彻底革新了 Milvus 的搜索方式。它不再仅依赖向量相似度,而是通过评估内容含义和上下文,提供更智能、更相关的搜索结果。
限制
模型排序器无法与分组搜索配合使用。
用于模型重新排序的字段必须为文本类型(
VARCHAR)。每个模型排名器每次只能使用一个
VARCHAR字段进行评估。
工作原理
模型排序器通过一个明确定义的工作流,将语言模型的理解能力集成到 Milvus 搜索过程中:
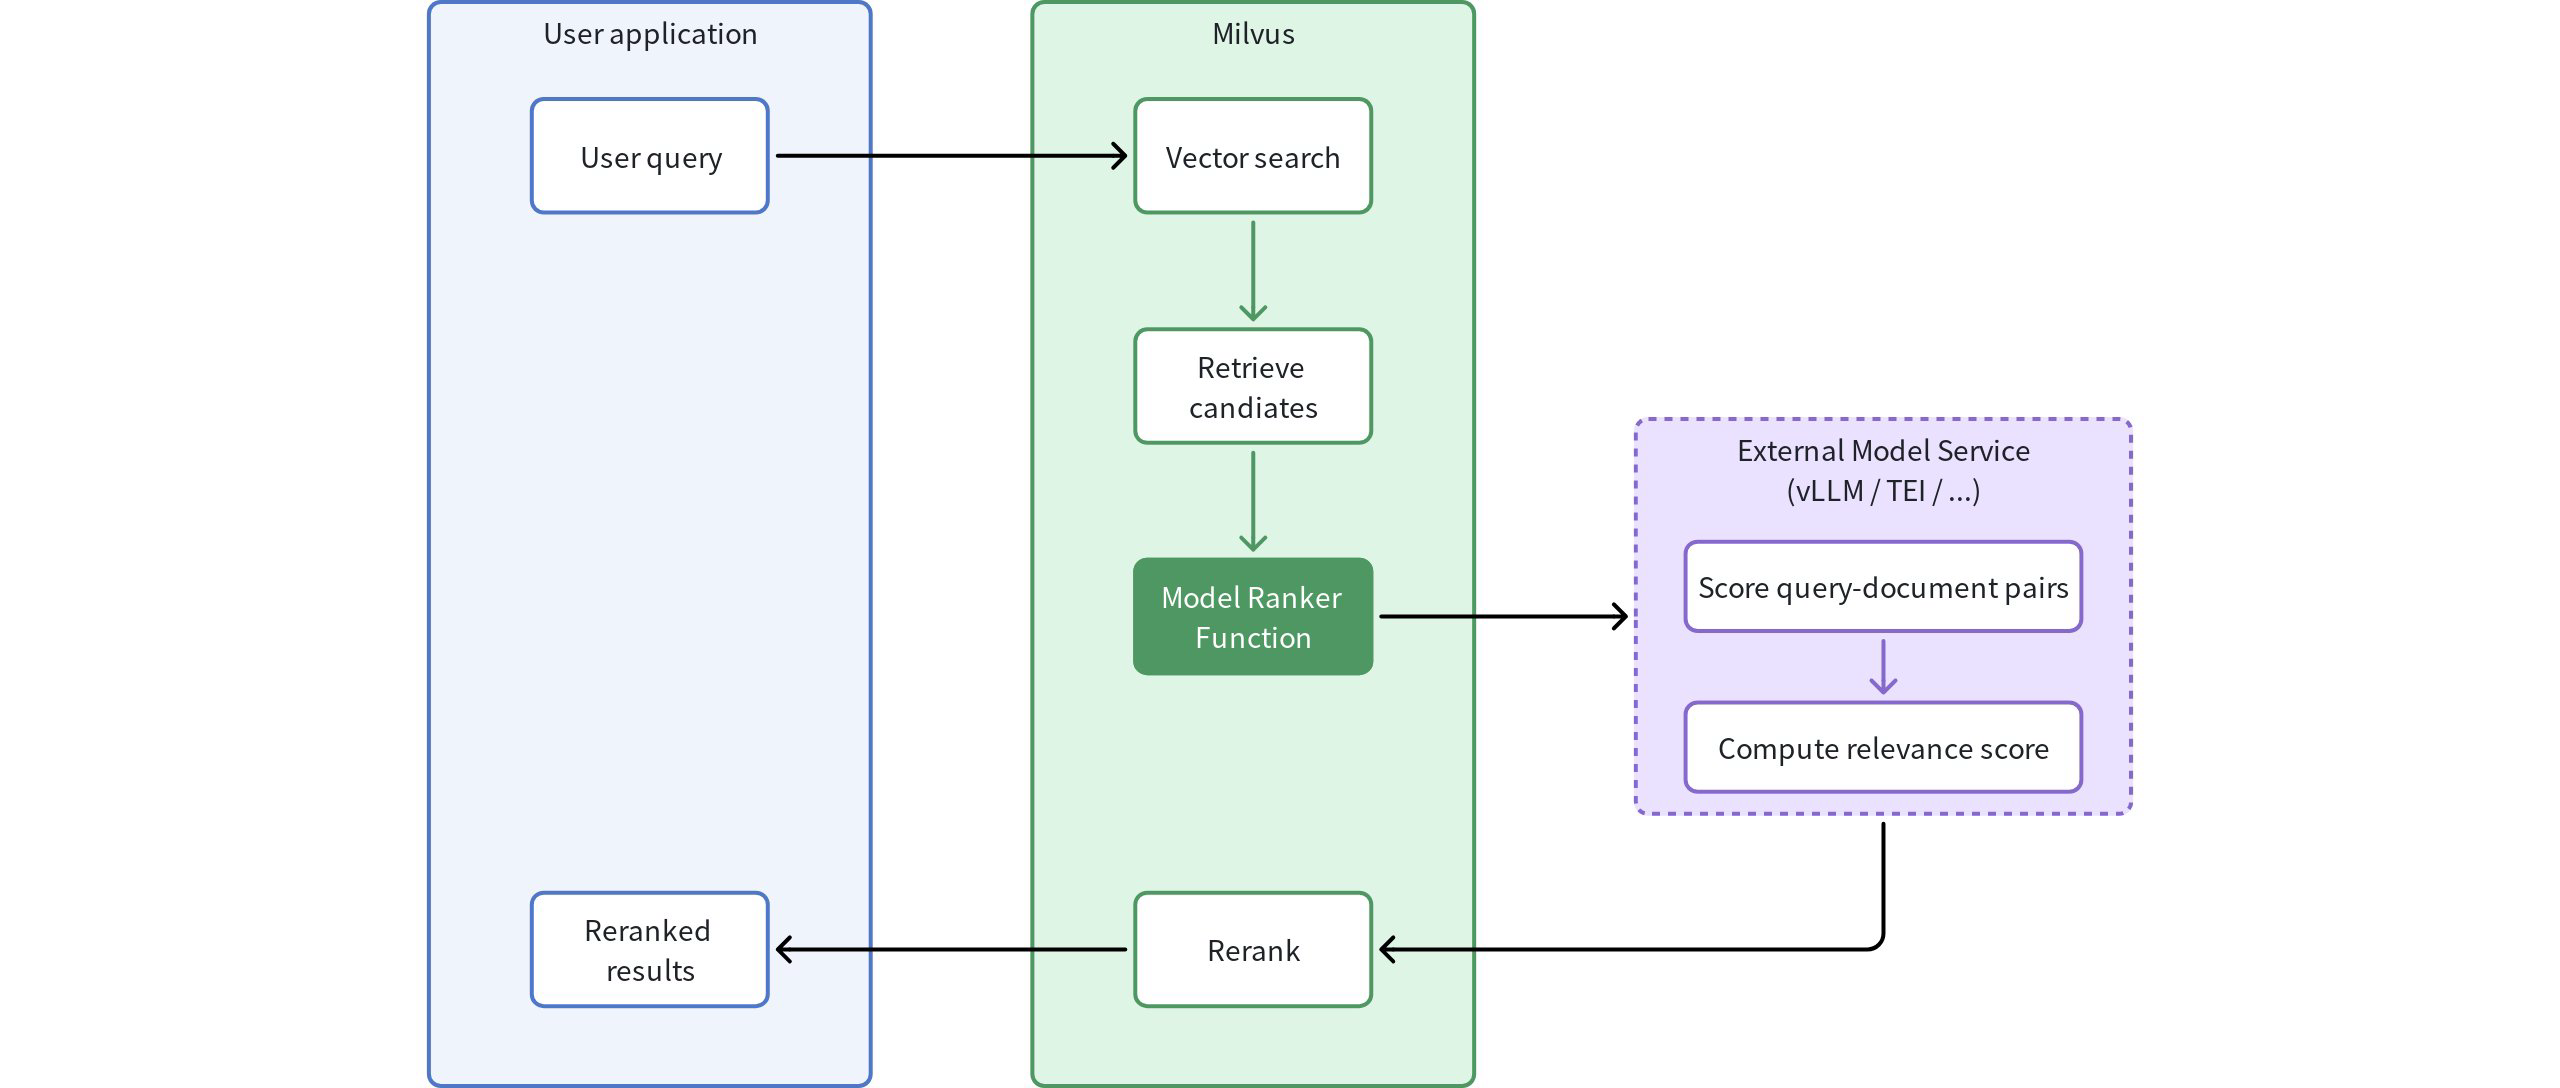 模型排名器概述
初始查询:您的应用程序向 Milvus 发送查询
向量搜索:Milvus 执行标准向量搜索以识别候选文档
候选文档检索:系统根据向量相似度确定初始候选文档集
模型评估:模型排序器函数处理查询-文档对:
将原始查询和候选文档发送至外部模型服务
语言模型评估查询与每篇文档之间的语义相关性
每份文档根据语义理解获得相关性评分
智能重新排序:根据模型生成的相关性评分对文档进行重新排序
增强的搜索结果:您的应用程序将获得按语义相关性排序的结果,而非仅基于向量相似性排序的结果
根据您的需求选择模型提供商
Milvus 支持以下用于重新排序的模型服务提供商,各具特色:
提供商 |
最适合 |
特点 |
示例用例 |
|---|---|---|---|
vLLM |
需要深度语义理解和定制化的复杂应用 |
|
部署了能够理解法律术语和判例法关系的领域专用模型的法律研究平台 |
TEI |
快速实施,资源利用率高 |
|
需要高效重新排序功能且符合标准要求的內容管理系统 |
Cohere |
优先考虑可靠性和易于集成的企业级应用 |
|
需要高可用性搜索、稳定API性能及多语言产品目录的电子商务平台 |
Voyage AI |
具有特定性能和上下文要求的RAG应用 |
|
包含不同文档长度、需要精细调整性能控制和专业语义理解的研究数据库 |
SiliconFlow |
优先考虑成本效益的長文档处理应用 |
|
技术文档检索系统,用于处理需要智能分段和重叠控制的长篇手册及论文 |
Hugging Face |
使用托管版 Hugging Face 句子相似度模型的应用程序 |
|
希望使用 Hugging Face 模型对候选文本进行重新排序,而无需运行独立推理服务的语义搜索应用程序 |
有关各模型服务实现的详细信息,请参阅相关文档:
实现
在实现模型排序器之前,请确保您拥有:
一个包含
VARCHAR字段的Milvus Collection,该字段中包含待重新排序的文本一个正在运行的外部模型服务,且您的 Milvus 实例可访问该服务
Milvus 与您选择的模型服务之间具备适当的网络连接
模型排序器可与标准向量搜索和混合搜索操作无缝集成。实现过程包括创建一个 Function 对象来定义您的重新排序配置,并将该对象传递给搜索操作。
创建模型排序器
要实现模型重新排序,首先需定义一个带有适当配置的 Function 对象。在此示例中,我们使用 TEI 作为服务提供商:
from pymilvus import MilvusClient, Function, FunctionType

# Connect to your Milvus server
client = MilvusClient(
    uri="http://localhost:19530"  # Replace with your Milvus server URI
)

# Create a model ranker function
model_ranker = Function(
    name="semantic_ranker",  # Function identifier
    input_field_names=["document"],  # VARCHAR field to use for reranking
    function_type=FunctionType.RERANK,  # Must be set to RERANK
    params={
        "reranker": "model",  # Specify model reranker. Must be "model"
        "provider": "tei",  # Choose provider: "tei", "vllm", etc.
        "queries": ["machine learning for time series"],  # Query text
        "endpoint": "http://model-service:8080",  # Model service endpoint
        # "maxBatch": 32  # Optional: batch size for processing
    }
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.ranker.ModelRanker;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

ModelRanker ranker = ModelRanker.builder()
        .name("semantic_ranker")
        .inputFieldNames(Collections.singletonList("document"))
        .provider("tei")
        .queries(Collections.singletonList("machine learning for time series"))
        .endpoint("http://model-service:8080")
        .build();
// nodejs
// go
# restful
参数 |
必填? |
描述 |
值 / 示例 |
|---|---|---|---|
|
是 |
用于执行搜索时函数的标识符。 |
|
|
是 |
用于重新排序的文本字段名称。 必须是 |
|
|
是 |
指定正在创建的函数类型。 对于所有模型排名器,必须设置为“ |
|
|
是 |
一个包含基于模型的重新排序函数配置的字典。可用参数(键)因服务提供商而异。 |
|
|
是 |
必须设置为 |
|
|
是 |
用于重新排序的模型服务提供商。 |
|
|
是 |
重新排序模型用于计算相关性得分的查询字符串列表。 查询字符串的数量必须与搜索操作中的查询数量完全一致(即使使用查询向量代替文本),否则将报告错误。 |
|
|
是 |
模型服务的 URL。 |
|
|
否 |
单批次中处理的文档最大数量。数值越大,吞吐量越高,但需要更多的内存。 |
|
应用于标准向量搜索
定义模型排序器后,您可以在搜索操作中通过将其传递给 ranker 参数来应用该排序器:
# Use the model ranker in standard vector search
results = client.search(
    collection_name,
    data=[your_query_vector], # Number of query vectors must match that specified in model_ranker.params["queries"]
    anns_field="vector_field",
    limit=10,
    output_fields=["document"],  # Include the text field in outputs
    ranker=model_ranker,  # Apply the model ranker here
    consistency_level="Bounded"
)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

SearchReq searchReq = SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .data(Collections.singletonList(new EmbeddedText("machine learning for time series")))
        .annsField("vector_field")
        .limit(10)
        .outputFields(Collections.singletonList(document))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .consistencyLevel(ConsistencyLevel.BOUNDED)
        .build();
SearchResp searchResp = client.search(searchReq);
// nodejs
// go
# restful
