

提升排名器Compatible with Milvus v2.6.2+
Boost Ranker 并不完全依赖基于向量距离计算的语义相似性,而是让您以有意义的方式影响搜索结果。它是使用元数据过滤快速调整搜索结果的理想选择。
当搜索请求中包含提升排名器功能时,Milvus 会使用该功能中的可选过滤条件,在搜索结果候选项中查找匹配项,并通过应用指定权重来提升这些匹配项的得分,从而帮助提升或降低匹配实体在最终结果中的排名。
何时使用提升排名器
与其他依赖交叉编码器模型或融合算法的排名器不同,Boost Ranker 直接将可选的元数据驱动规则注入排名过程,因此更适用于以下情况。
使用案例 |
实例 |
为什么 Boost Ranker 运行良好 |
|---|---|---|
业务驱动的内容优先级排序 |
|
无需重建索引或修改向量 Embeddings 模型(操作符可能会耗费大量时间),您就可以通过实时应用可选元数据过滤器,在搜索结果中即时提升或降低特定项目的排名。这种机制可实现灵活、动态的搜索排名,轻松适应不断变化的业务需求。 |
战略性内容降级 |
|
您还可以将多个提升排名器结合起来,实施更动态、更强大的基于权重的排名策略。
提升排名器的机制
下图说明了提升排名器的主要工作流程。
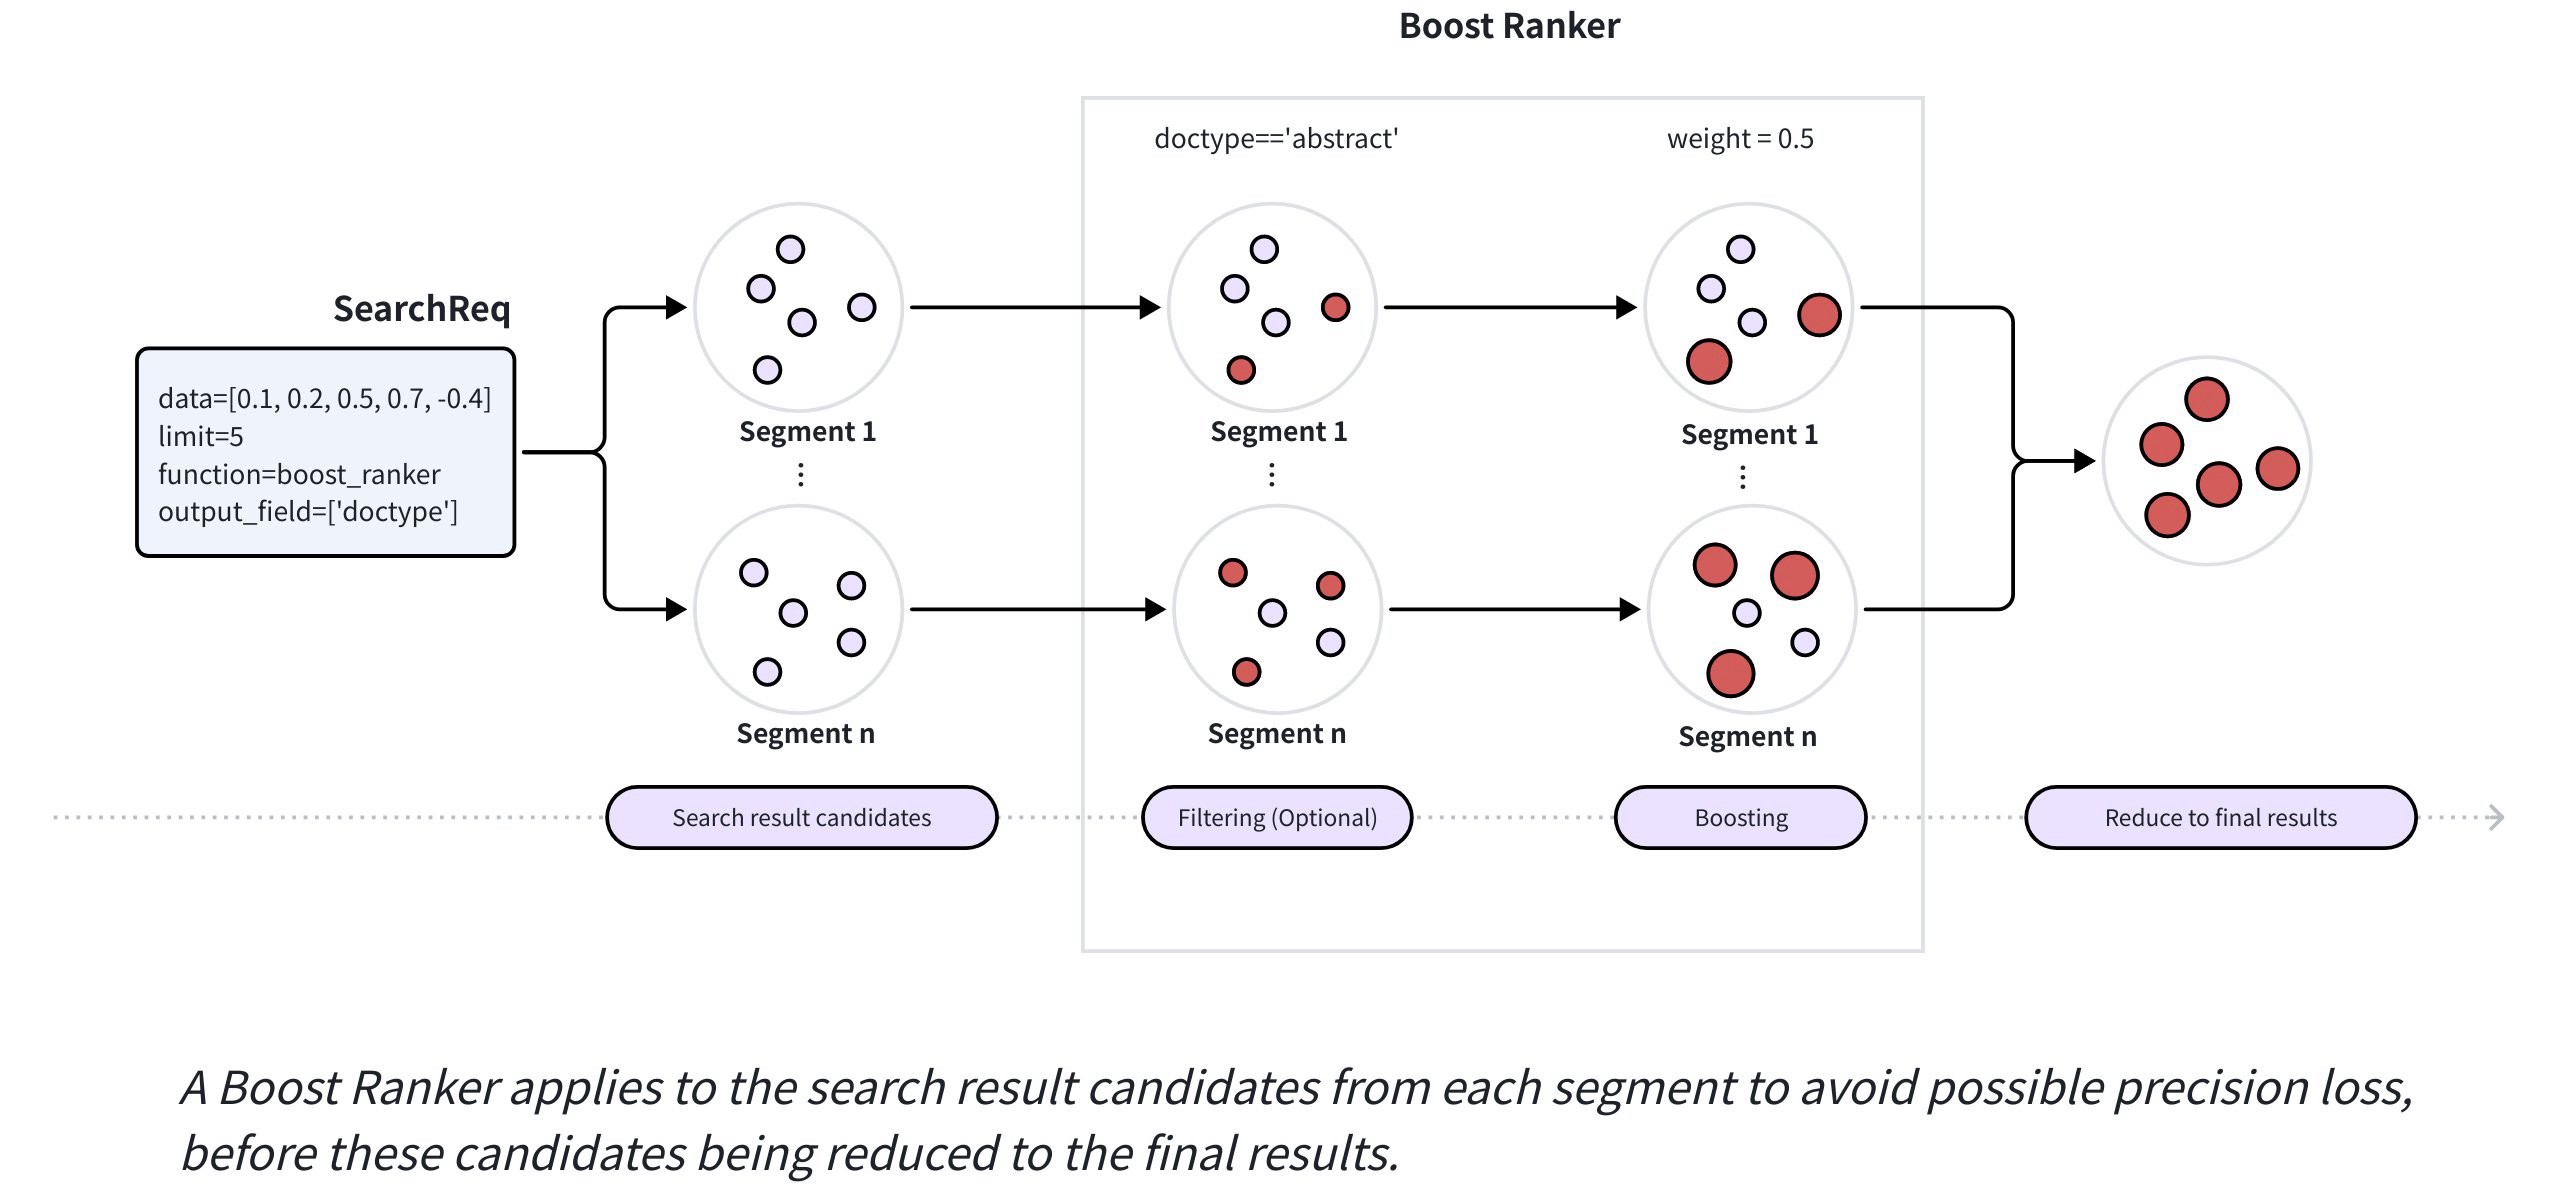 提升排名器机制
插入数据时,Milvus 会将数据分布到各个分段。在搜索过程中,每个分段都会返回一组候选数据,Milvus 会对这些来自所有分段的候选数据进行排名,从而产生最终结果。当搜索请求包括提升排名器时,Milvus 会将其应用到每个分段的候选结果中,以防止潜在的精度损失并提高召回率。
在最终确定结果之前,Milvus 会使用提升排名器对这些候选结果进行如下处理:
应用 Boost Ranker 中指定的可选过滤表达式,以识别与表达式匹配的实体。
应用提升排名器中指定的权重来提升已识别实体的分数。
在多向量混合搜索中,不能将 Boost Ranker 用作排序器。不过,您可以在任何子请求中使用它作为排序器 (AnnSearchRequest)。
Boost Ranker 示例
下面的示例说明了 Boost Ranker 在单向量搜索中的使用,该搜索要求返回前五个最相关的实体,并为具有抽象文档类型的实体的得分添加权重。
分段收集搜索结果候选。
下表假定 Milvus 将实体 Distributed 为两个分段(0001和0002),每个分段返回五个候选实体。
ID
文档类型
得分
等级
段
117
抽象
0.344
1
0001
89
摘要
0.456
2
0001
257
身体
0.578
3
0001
358
标题
0.788
4
0001
168
身体
0.899
5
0001
46
身体
0.189
1
0002
48
主体
0265
2
0002
561
摘要
0.366
3
0002
344
摘要
0.444
4
0002
276
摘要
0.845
5
0002
应用 Boost Ranker (
doctype='abstract') 中指定的过滤表达式。如下表中
DocType字段所示,Milvus 将标记所有doctype设置为abstract的实体,以便进一步处理。ID
文件类型
得分
排名
段
117
抽象
0.344
1
0001
89
摘要
0.456
2
0001
257
身体
0.578
3
0001
358
标题
0.788
4
0001
168
身体
0.899
5
0001
46
身体
0.189
1
0002
48
主体
0265
2
0002
561
摘要
0.366
3
0002
344
摘要
0.444
4
0002
276
摘要
0.845
5
0002
应用提升排名器 (
weight=0.5) 中指定的权重。上一步中确定的所有实体都将乘以提升排名器中指定的权重,从而改变其排名。
ID
文件类型
得分
加权得分
(= 分数 x 权重)
等级
分段
117
抽象
0.344
0.172
1
0001
89
抽象
0.456
0.228
2
0001
257
身体
0.578
0.578
3
0001
358
标题
0.788
0.788
4
0001
168
身体
0.899
0.899
5
0001
561
抽象
0.366
0.183
1
0002
46
身体
0.189
0.189
2
0002
344
抽象
0.444
0.222
3
0002
48
身体
0.265
0.265
4
0002
276
抽象
0.845
0.423
5
0002
权重必须是您选择的浮点数。在上例中,分数越小表示相关性越大,因此权重应小于1,否则权重应大于1。
根据加权分数汇总所有分段的候选信息,最终确定结果。
ID
文档类型
得分
加权得分
排名
段
117
抽象
0.344
0.172
1
0001
561
抽象
0.366
0.183
2
0002
46
身体
0.189
0.189
3
0002
344
抽象
0.444
0.222
4
0002
89
抽象
0.456
0.228
5
0001
Boost Ranker 的使用
在本节中,您将看到如何使用 Boost Ranker 影响单向量搜索结果的示例。
创建 Boost Ranker
在将 Boost Ranker 传递给搜索请求的 Ranker 之前,应先将 Boost Ranker 正确定义为一个 Ranker 函数,如下所示:
from pymilvus import Function, FunctionType

ranker = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "filter": "doctype == 'abstract'",
        "random_score": {
            "seed": 126,
            "field": "id"
        },
        "weight": 0.5
    }
)
import io.milvus.v2.service.vector.request.ranker.BoostRanker;

BoostRanker ranker = BoostRanker.builder()
        .name("boost")
        .filter("doctype == \"abstract\"")
        .weight(5.0f)
        .randomScoreField("id")
        .randomScoreSeed(126)
        .build();
// go
import {FunctionType} from '@zilliz/milvus2-sdk-node';

const ranker = {
  name: "boost",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "boost",
    filter: "doctype == 'abstract'",
    random_score: {
      seed: 126,
      field: "id",
    },
    weight: 0.5,
  },
};
# restful
参数 |
是否需要? |
描述 |
值/示例 |
|---|---|---|---|
|
是 |
此功能的唯一标识符 |
|
|
是 |
要应用该函数的向量字段列表(对于 Boost Ranker,必须为空) |
|
|
是 |
要调用的函数类型;使用 |
|
|
是 |
指定 Reranker 的类型。 使用 Boost Ranker 时必须设置为 |
|
|
是 |
指定原始搜索结果中任何匹配实体的得分所乘以的权重。 该值应为浮点数。
|
|
|
无 |
指定用于在搜索结果实体中匹配实体的过滤表达式。它可以是《过滤说明》中提到的任何有效的基本过滤表达式。 注意:只能使用基本操作符,如 |
|
|
无 |
指定随机函数,随机生成一个介于
|
|
使用单个提升排名器搜索
一旦 Boost Ranker 函数准备就绪,您就可以在搜索请求中引用它。下面的示例假定您已经创建了一个 Collection,该 Collection 有以下字段:ID、向量和doctype。
from pymilvus import MilvusClient

# Connect to the Milvus server
client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Assume you have a collection set up

# Conduct a similarity search using the created ranker
client.search(
    collection_name="my_collection",
    data=[[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
    anns_field="vector",
    params={},
    output_field=["doctype"],
    ranker=ranker
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.FloatVec;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

SearchResp searchReq = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new FloatVec(new float[]{-0.619954f, 0.447943f, -0.174938f, -0.424803f, -0.864845f})))
        .annsField("vector")
        .outputFields(Collections.singletonList("doctype"))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .build());
SearchResp searchResp = client.search(searchReq);
// go
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

// Connect to the Milvus server
const client = new MilvusClient({
  address: 'localhost:19530',
  token: 'root:Milvus'
});

// Assume you have a collection set up

// Conduct a similarity search
const searchResults = await client.search({
  collection_name: 'my_collection',
  data: [-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911],
  anns_field: 'vector',
  output_fields: ['doctype'],
  rerank: ranker,
});

console.log('Search results:', searchResults);
# restful
使用多个 Boost Ranker 进行搜索
您可以在一次搜索中结合多个 Boost Ranker 来影响搜索结果。为此,请创建多个 Boost Ranker,在FunctionScore实例中引用它们,并在搜索请求中使用FunctionScore实例作为排名器。
下面的示例展示了如何通过应用介于0.8和1.2 之间的权重来修改所有已识别实体的得分。
from pymilvus import MilvusClient, Function, FunctionType, FunctionScore

# Create a Boost Ranker with a fixed weight
fix_weight_ranker = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "weight": 0.8
    }
)

# Create a Boost Ranker with a randomly generated weight between 0 and 0.4
random_weight_ranker = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "random_score": {
            "seed": 126,
        },
        "weight": 0.4
    }
)

# Create a Function Score
ranker = FunctionScore(
    functions=[
        fix_weight_ranker,
        random_weight_ranker
    ],
    params={
        "boost_mode": "Multiply",
        "function_mode": "Sum"
    }
)

# Conduct a similarity search using the created Function Score
client.search(
    collection_name="my_collection",
    data=[[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
    anns_field="vector",
    params={},
    output_field=["doctype"],
    ranker=ranker
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.Function fixWeightRanker = CreateCollectionReq.Function.builder()
                 .functionType(FunctionType.RERANK)
                 .name("boost")
                 .param("reranker", "boost")
                 .param("weight", "0.8")
                 .build();

CreateCollectionReq.Function randomWeightRanker = CreateCollectionReq.Function.builder()
                 .functionType(FunctionType.RERANK)
                 .name("boost")
                 .param("reranker", "boost")
                 .param("weight", "0.4")
                 .param("random_score", "{\"seed\": 126}")
                 .build();

Map<String, String> params = new HashMap<>();
params.put("boost_mode","Multiply");
params.put("function_mode","Sum");
FunctionScore ranker = FunctionScore.builder()
                 .addFunction(fixWeightRanker)
                 .addFunction(randomWeightRanker)
                 .params(params)
                 .build()

SearchResp searchReq = client.search(SearchReq.builder()
                 .collectionName("my_collection")
                 .data(Collections.singletonList(new FloatVec(new float[]{-0.619954f, 0.447943f, -0.174938f, -0.424803f, -0.864845f})))
                 .annsField("vector")
                 .outputFields(Collections.singletonList("doctype"))
                 .addFunction(ranker)
                 .build());
SearchResp searchResp = client.search(searchReq);
// go
import {FunctionType} from '@zilliz/milvus2-sdk-node';

const fix_weight_ranker = {
  name: "boost",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "boost",
    weight: 0.8,
  },
};

const random_weight_ranker = {
  name: "boost",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "boost",
    random_score: {
      seed: 126,
    },
    weight: 0.4,
  },
};

const ranker = {
  functions: [fix_weight_ranker, random_weight_ranker],
  params: {
    boost_mode: "Multiply",
    function_mode: "Sum",
  },
};

await client.search({
  collection_name: "my_collection",
  data: [[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
  anns_field: "vector",
  params: {},
  output_field: ["doctype"],
  ranker: ranker
});
# restful
具体来说,有两个 Boost Ranker:一个给所有找到的实体应用固定权重,而另一个则给它们分配随机权重。然后,我们在一个FunctionScore 中引用这两个排名器,它还定义了权重如何影响找到的实体的得分。
下表列出了创建FunctionScore实例所需的参数。
参数 |
是否需要? |
说明 |
值/示例 |
|---|---|---|---|
|
是 |
在列表中指定目标排序器的名称。 |
|
|
否 |
指定权重如何影响任何匹配实体的得分。 可能的值有
|
|
|
无 |
指定如何处理来自不同提升排名器的加权值。 可能的值有
|
|
