

模型排名器概述Compatible with Milvus 2.6.x
傳統的向量搜尋純粹依據數學上的相似度來排序結果——即向量在高維空間中的匹配程度。雖然這種方法效率很高,但往往會忽略真正的語義相關性。以搜尋「資料庫優化的最佳實踐」為例:您可能會收到向量相似度很高、且頻繁提及這些術語的文件,但這些文件實際上並未提供可付諸實行的優化策略。
Model Ranker 透過整合能理解查詢與文件之間語義關係的先進語言模型,徹底革新了 Milvus 的搜尋方式。它不再僅依賴向量相似度,而是評估內容的意義與上下文,從而提供更智能、更相關的搜尋結果。
限制
模型排序器無法與分組搜尋功能併用。
用於模型重新排序的欄位必須為文字類型(
VARCHAR)。每個模型重新排序器每次僅能使用一個
VARCHAR欄位進行評估。
運作原理
模型排序器透過一套明確定義的工作流程,將語言模型的理解能力整合至 Milvus 搜尋流程中:
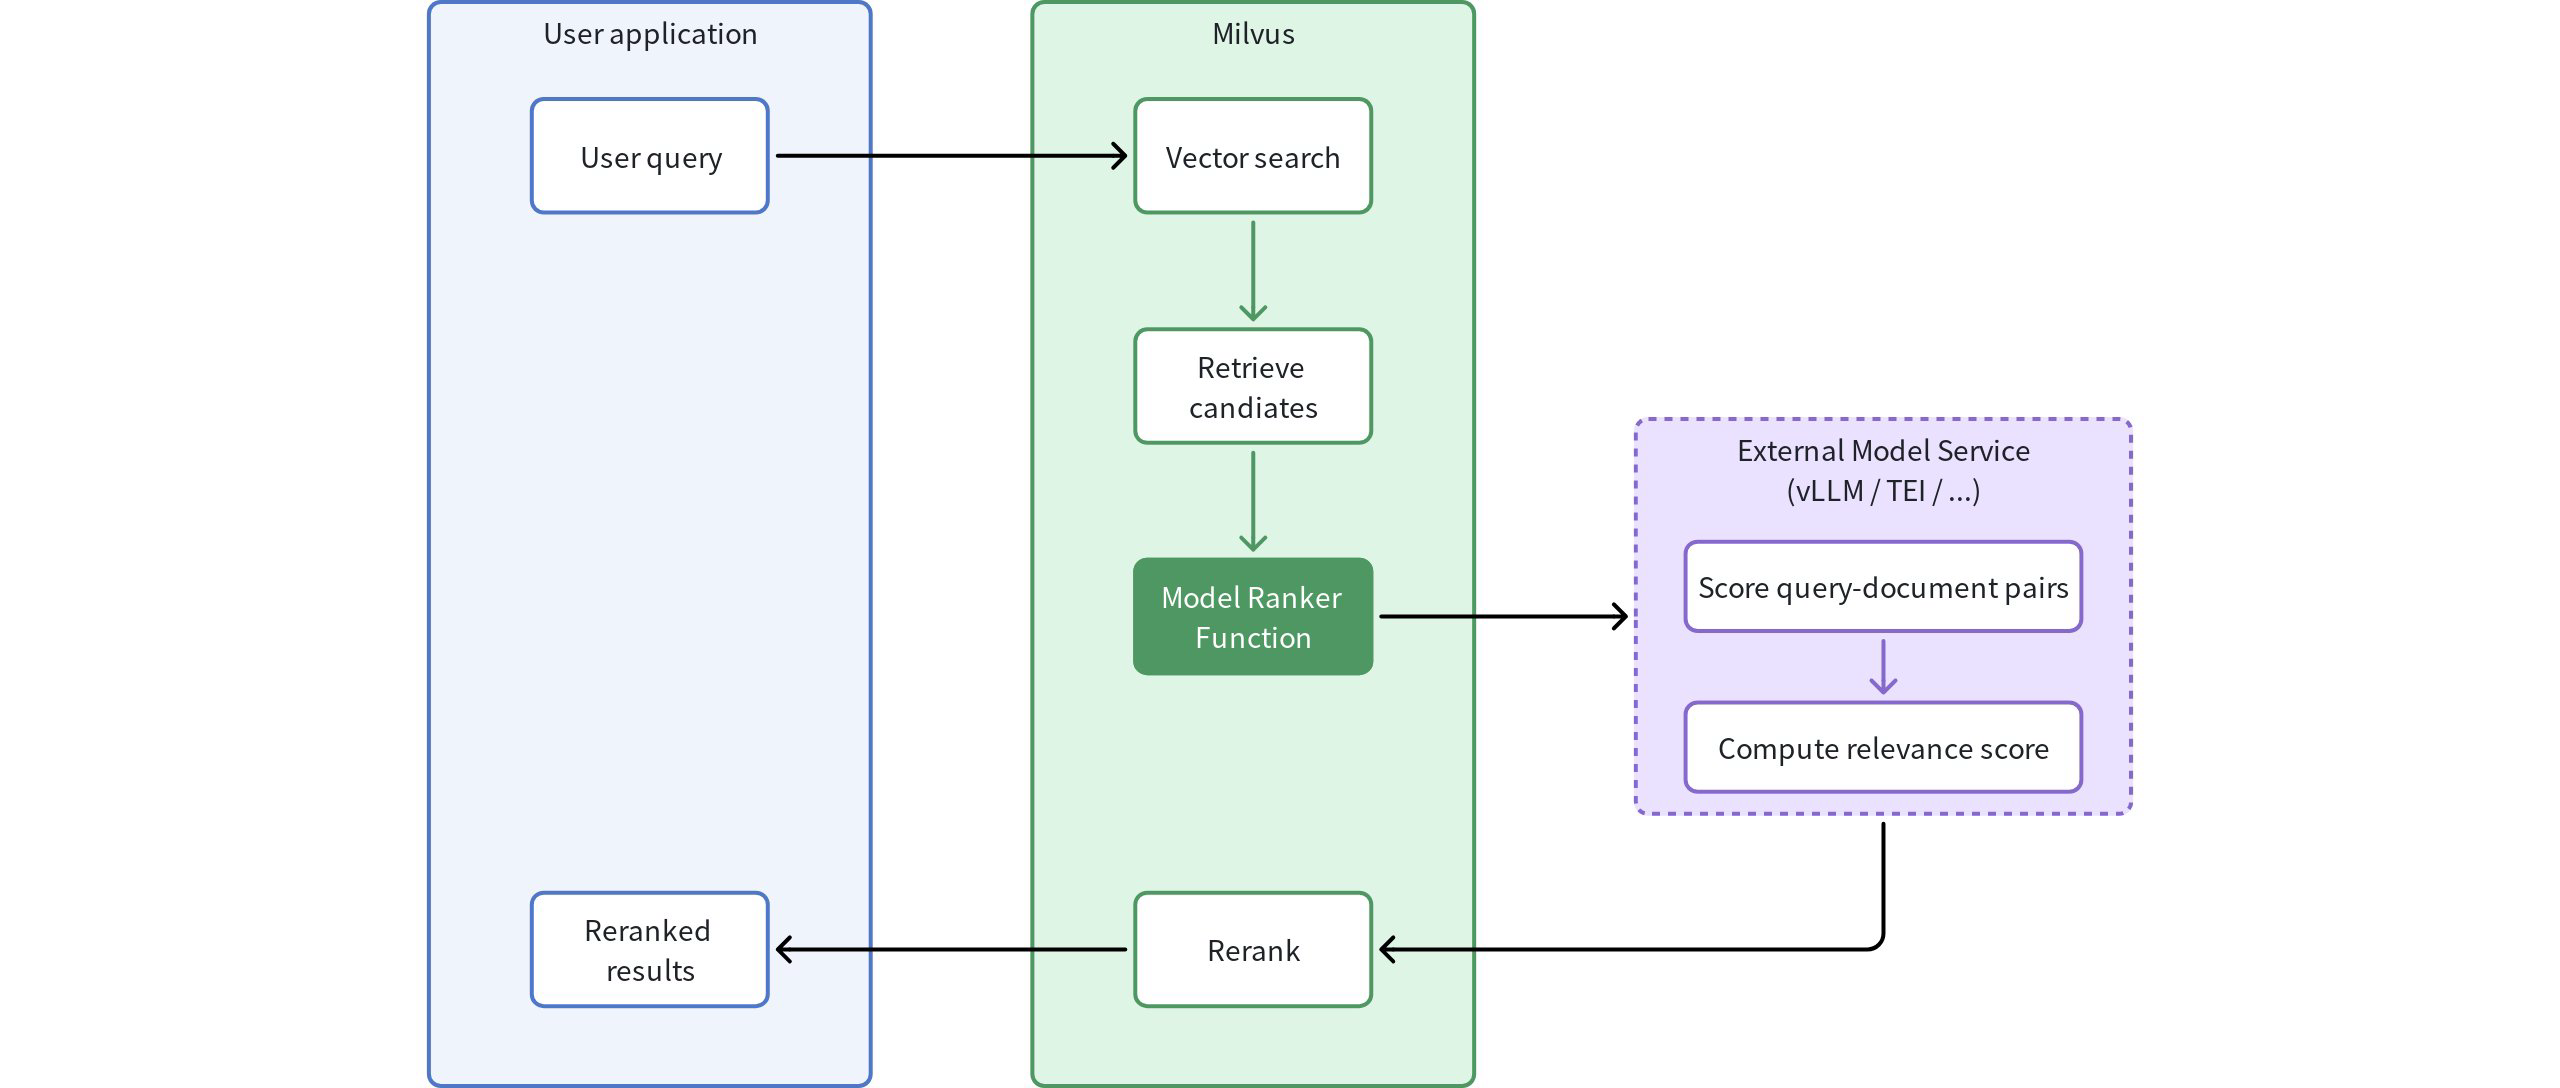 模型排名器概覽
初始查詢:您的應用程式將查詢傳送至 Milvus
向量搜尋:Milvus 執行標準向量搜尋以識別候選文件
候選文件檢索:系統根據向量相似度識別出初始候選文件集
模型評估:模型排序器函式處理查詢-文件配對:
將原始查詢與候選文件傳送至外部模型服務
語言模型評估查詢與每份文件之間的語義相關性
每份文件會根據語義理解獲得相關性分數
智慧重新排序:根據模型產生的相關性分數,重新排列文件順序
強化搜尋結果:您的應用程式將收到依語義相關性排序的結果,而非僅依向量相似度排序
根據您的需求選擇模型供應商
Milvus 支援以下用於重新排序的模型服務供應商,各家皆具備獨特特性:
供應商 |
最適合 |
特點 |
應用範例 |
|---|---|---|---|
vLLM |
需要深度語義理解與客製化的複雜應用 |
|
部署了能理解法律術語與判例法之間關係的領域專用模型之法律研究平台 |
TEI |
快速實施且資源利用率高 |
|
需要高效重新排序功能且符合標準要求的內容管理系統 |
Cohere |
優先考量可靠性與整合便利性的企業級應用程式 |
|
需要高可用性搜尋功能、穩定 API 效能及多語言產品目錄的電子商務平台 |
Voyage AI |
具有特定效能與語境需求的 RAG 應用程式 |
|
包含不同文件長度的研究資料庫,需要精細調校的效能控制與專業的語義理解 |
SiliconFlow |
以成本效益為優先考量,處理長篇文件之應用 |
|
技術文件搜尋系統,專門處理需要智慧分割與重疊控制的長篇手冊及論文 |
Hugging Face |
採用 Hugging Face 託管式句子相似度模型的應用程式 |
|
希望利用 Hugging Face 模型對候選文字進行重新排序,卻無需自行運作獨立推論服務的語義搜尋應用程式 |
有關各模型服務實作的詳細資訊,請參閱專用文件:
實作
在實作 Model Ranker 之前,請確保您已具備:
一個 Milvus 集合,其中包含名為 `
VARCHAR` 的欄位,該欄位存有待重新排序的文字一個可由您的 Milvus 實例存取且正在運行的外部模型服務
Milvus 與您選用的模型服務之間具備適當的網路連線
模型排序器可與標準向量搜尋及混合搜尋操作無縫整合。實作過程涉及建立一個 Function 物件來定義您的重新排序設定,並將其傳遞給搜尋操作。
建立模型排序器
要實作模型重新排序,首先需定義一個具有適當配置的 Function 物件。在此範例中,我們使用 TEI 作為服務提供者:
from pymilvus import MilvusClient, Function, FunctionType

# Connect to your Milvus server
client = MilvusClient(
    uri="http://localhost:19530"  # Replace with your Milvus server URI
)

# Create a model ranker function
model_ranker = Function(
    name="semantic_ranker",  # Function identifier
    input_field_names=["document"],  # VARCHAR field to use for reranking
    function_type=FunctionType.RERANK,  # Must be set to RERANK
    params={
        "reranker": "model",  # Specify model reranker. Must be "model"
        "provider": "tei",  # Choose provider: "tei", "vllm", etc.
        "queries": ["machine learning for time series"],  # Query text
        "endpoint": "http://model-service:8080",  # Model service endpoint
        # "maxBatch": 32  # Optional: batch size for processing
    }
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.ranker.ModelRanker;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

ModelRanker ranker = ModelRanker.builder()
        .name("semantic_ranker")
        .inputFieldNames(Collections.singletonList("document"))
        .provider("tei")
        .queries(Collections.singletonList("machine learning for time series"))
        .endpoint("http://model-service:8080")
        .build();
// nodejs
// go
# restful
參數 |
是否必填? |
說明 |
值 / 範例 |
|---|---|---|---|
|
是 |
執行搜尋時用於識別您的函式的標識符。 |
|
|
是 |
用於重新排序的文字欄位名稱。 必須為 |
|
|
是 |
指定正在建立的函數類型。 對於所有模型排名器,此參數必須設定為「 |
|
|
是 |
一個包含基於模型的重新排序函數配置的字典。可用的參數(鍵)會因服務提供者而異。 |
|
|
是 |
必須設定為 ` |
|
|
是 |
用於重新排序的模型服務提供者。 |
|
|
是 |
重新排序模型用於計算相關性分數的查詢字串清單。 查詢字串的數量必須與搜尋操作中的查詢數量完全相符(即使使用查詢向量而非文字),否則將回報錯誤。 |
|
|
是 |
模型服務的 URL。 |
|
|
否 |
單批次中最多可處理的文件數量。較大的數值會提高吞吐量,但需要更多記憶體。 |
|
套用至標準向量搜尋
定義模型排序器後,您可透過將其傳遞至 `ranker` 參數,在搜尋操作中套用該模型:
# Use the model ranker in standard vector search
results = client.search(
    collection_name,
    data=[your_query_vector], # Number of query vectors must match that specified in model_ranker.params["queries"]
    anns_field="vector_field",
    limit=10,
    output_fields=["document"],  # Include the text field in outputs
    ranker=model_ranker,  # Apply the model ranker here
    consistency_level="Bounded"
)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

SearchReq searchReq = SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .data(Collections.singletonList(new EmbeddedText("machine learning for time series")))
        .annsField("vector_field")
        .limit(10)
        .outputFields(Collections.singletonList(document))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .consistencyLevel(ConsistencyLevel.BOUNDED)
        .build();
SearchResp searchResp = client.search(searchReq);
// nodejs
// go
# restful
