

MinHash 函式Compatible with Milvus 3.0.x
MinHash 函式可將原始文字轉換為二進位向量,用以近似計算文件之間的雅卡德相似度。該函式透過文字分片與多種雜湊函式,產生固定長度的簽名向量,從而實現快速近重複檢測及大規模文件去重。
作為內建函式,MinHash 在 Milvus 內部執行,無需外部模型推論或預處理。您只需輸入原始文字,Milvus 便會自動產生 MinHash 簽名向量。
限制
輸出欄位必須為
BINARY_VECTOR,且其維度須滿足dim % 32 == 0,因為每個 MinHash 簽名向量皆為 32 位元哈希值。二進位向量欄位的
dim必須等於32 * num_hashes。若不符,將導致錯誤。當使用
MINHASH_LSH索引與MinHash函數的輸出時,mh_element_bit_width必須設定為32。
MinHash 的運作原理
MinHash是一種局部敏感哈希技術,用於估算集合之間的雅卡德相似度。在 Milvus 中,MinHash 函數遵循以下處理流程:您提供原始文字作為輸入,Milvus 則產生二進位向量作為輸出——所有中間步驟均由系統內部處理。
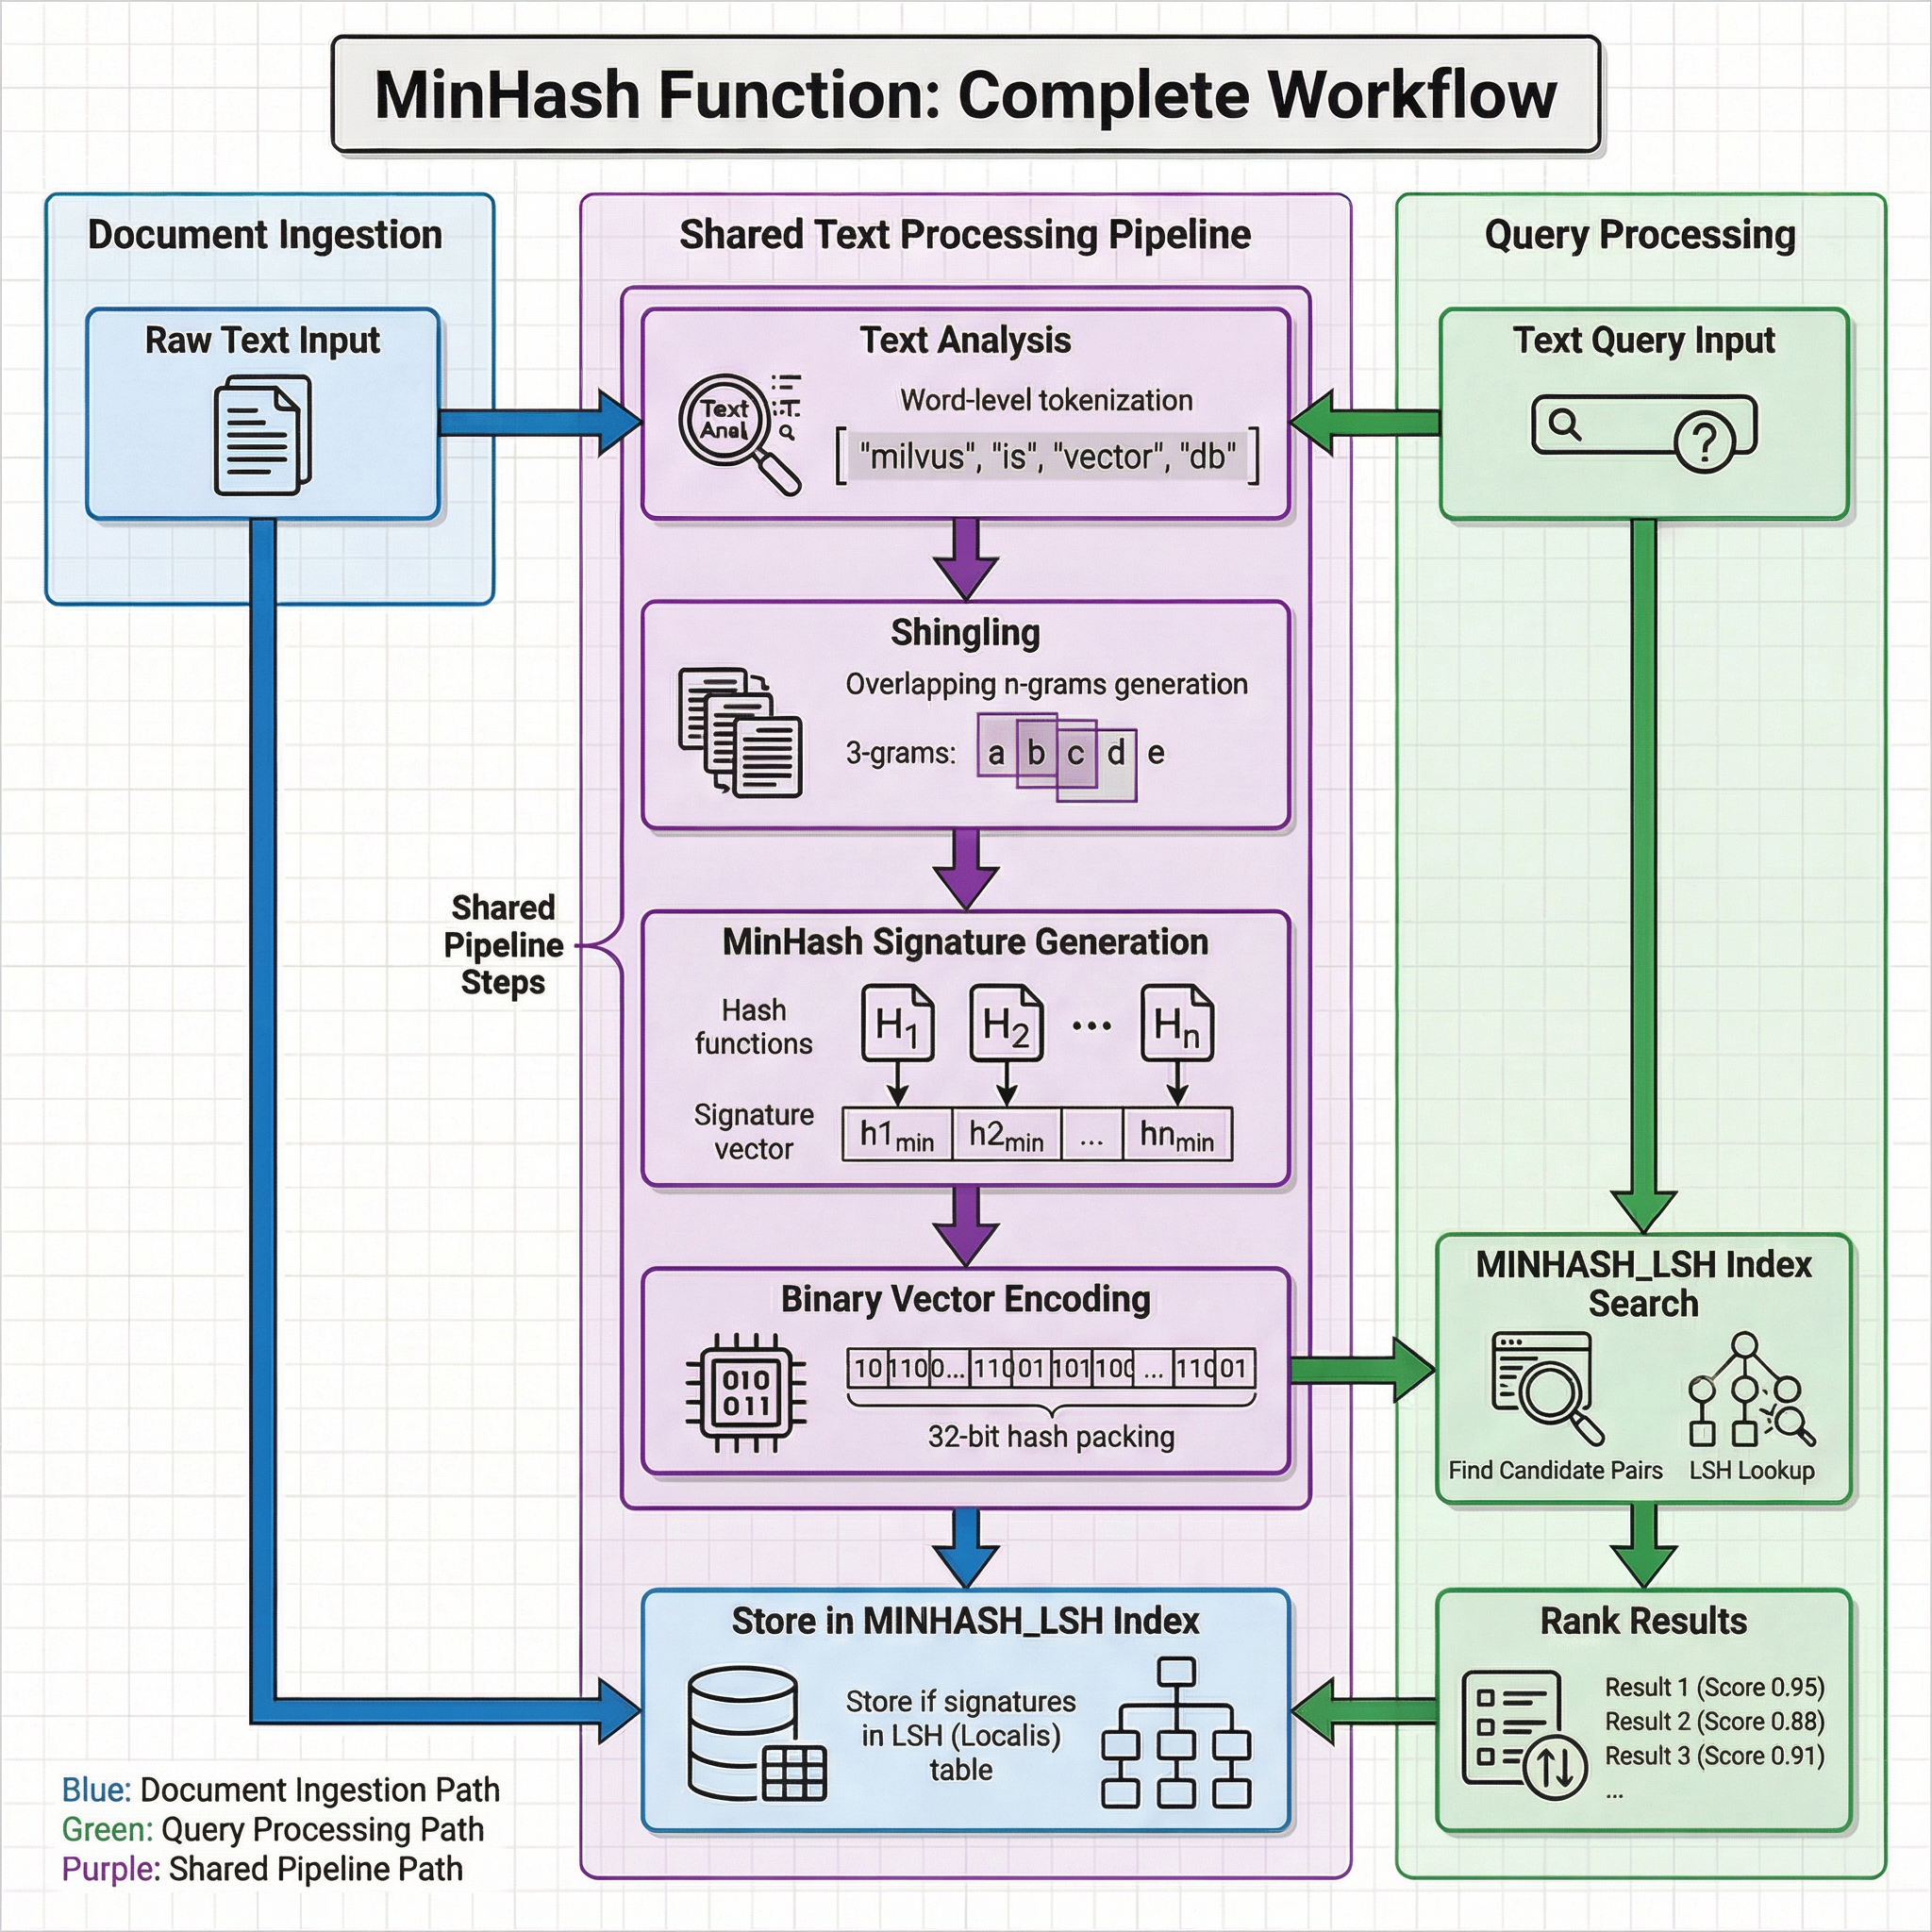
整體工作流程包含一個由文件導入與查詢處理共同使用的共用文字處理管線,隨後是針對儲存與檢索各階段的特定操作。
 Iaqkbfeh8oqggsx6nsocfosondo
共用文字處理流程
無論是文件導入還是查詢處理,都會將原始文字通過相同的四階段轉換:
文字分析:文字會由分析器進行處理(當
token_level為"word"時),或直接使用(當token_level為"char"時)。詞級分詞會套用在輸入欄位上配置的分析器,將文字分割為術語——例如,"milvus is vector db"會變成["milvus", "is", "vector", "db"]。分片(Shingling):將詞元分割為大小為
shingle_size的重疊 n-gram(分片)。例如,在詞級使用 3-gram 時,詞元["information", "retrieval", "is", "a", "field"]會變成類似["information retrieval is", "retrieval is a", "is a field"]的分片。MinHash 簽名生成:對片段集套用多個雜湊函數(H1、H2、…、Hn,其中 n =
num_hashes)。 針對每個哈希函數,會從所有片段中選取最小的哈希值。這些最小值的集合即構成 MinHash 簽名——一種固定長度的表示形式,用以近似原始文件的雅卡德相似度。二進位向量編碼:每個簽名值皆為 32 位元雜湊值,而完整的簽名則被封裝進一個維度為
32 * num_hashes的BINARY_VECTOR中。
文件導入
在插入過程中,由共享管線產生的二進位向量會儲存於MINHASH_LSH 索引中。該索引維護一個LSH(局部敏感雜湊)表,將相似的簽名分組至相同的桶位中,從而能在查詢時快速檢索候選項目。
查詢處理
在搜尋過程中,查詢文字會經過相同的共用管線以產生二進位向量。此向量用於在MINHASH_LSH 索引中執行 LSH 查詢,從而快速識別出可能相似的候選對。若未啟用 Jaccard 精細化,Milvus 會返回未依預估 Jaccard 相似度進行排序的 LSH 候選結果。 當啟用雅卡德(Jaccard)精細化時,Milvus 會利用儲存的原始 MinHash 簽名,根據估算的雅卡德相似度對候選結果進行排序,並返回前 K 項結果。
由於這兩條路徑採用相同的轉換邏輯,內容高度重疊的兩份文件會產生相似的 MinHash 簽名。這使得該功能即使在文件詞彙順序、格式或細微措辭有所不同時,仍能有效找出近似重複文件。
開始之前
在使用 MinHash 函式之前,請規劃您的資料集架構,使其包含以下項目:
用於儲存原始內容的文字欄位
您的資料集必須包含一個 `
VARCHAR` 欄位,用以儲存原始文字。此欄位將作為 MinHash 函式的輸入。文字欄位的分析器(當使用字詞層級分詞時)
若
token_level設定為"word"(預設值),則該文字欄位必須啟用分析器。分析器定義了在進行分片處理前,文字應如何進行分詞。預設情況下,Milvus 會使用standard分析器。若要設定其他分析器,請參閱《根據您的使用情境選擇合適的分析器》。用於 MinHash 輸出的二進位向量欄位
您的集合必須包含一個
BINARY_VECTOR欄位,用以儲存由 MinHash 函式所產生的二進位向量。該維度的數值必須等於32 * num_hashes。
步驟 1:建立具有 MinHash 函式的集合
若要使用 MinHash 函式,請在建立集合時進行定義。該函式將成為集合模式的一部分,並會在資料插入和搜尋過程中自動套用。
定義模式欄位
您的集合模式必須包含至少三個欄位:
主欄位:用於唯一識別集合中的每個實體。
文字欄位(
VARCHAR):儲存原始文字文件。請設定enable_analyzer=True,以便 Milvus 能處理文字以產生 MinHash 簽名。預設情況下,Milvus 會使用standard分析器進行文字分析。若要設定其他分析器,請參閱《根據您的使用情境選擇合適的分析器》。二進位向量欄位(
BINARY_VECTOR):儲存由 MinHash 函式自動生成的二進位向量。其維數必須等於32 * num_hashes。
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="http://localhost:19530", token="root:Milvus")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
// java
// nodejs
// go
# restful
定義 MinHash 函式
MinHash 函式會將分析過的文字轉換為二進位向量,用以近似文件之間的 Jaccard 相似度。
定義該函式並將其新增至您的資料結構:
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
// java
// nodejs
// go
# restful
設定選項
MinHash 函式的 `params ` 字典接受以下參數。所有參數名稱均不區分大小寫。
參數 |
類型 |
預設值 |
說明 |
|---|---|---|---|
|
int |
源自 |
用於簽名生成的哈希函數數量。輸出二進位向量的維度等於 |
|
int |
|
用於分段(shingling)的 N-gram 大小。詞級:通常為 1-3。字元級:通常為 2-6。 |
|
str |
|
要使用的雜湊函數。選項:
|
|
str |
|
分詞層級。選項:
|
|
int |
|
用於初始化 MinHash 函式的隨機種子。 |
配置索引
MinHash 二進位向量建議的索引類型為 `MINHASH_LSH`,度量類型則為 `MHJACCARD`。
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
// java
// nodejs
// go
# restful
若搜尋將使用 Jaccard 精細化,請將with_raw_data 設定為True 。這需要原始的 MinHash 簽名,才能針對 LSH 查詢所返回的候選項計算預估的 Jaccard 相似度。
建立集合
使用上述定義的模式和索引參數建立集合:
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
// java
// nodejs
// go
# restful
步驟 2:插入文件
設定完資料集後,請插入文字資料。您只需提供原始文字 — MinHash 函式會自動為每個文件產生二進位向量。
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
// java
// nodejs
// go
# restful
步驟 3:使用 MinHash 進行搜尋
資料插入完成後,透過提供原始文字查詢來搜尋近似重複的文件。Milvus 會自動將每個查詢轉換為 MinHash 二進位向量。啟用 Jaccard 精細化功能,即可根據估算的 Jaccard 相似度對 LSH 候選結果進行排序。
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
// java
// nodejs
// go
# restful
將 `mh_search_with_jaccard ` 設定為 `True ` 以啟用 Jaccard 精細化。`refine_k ` 控制用於精細化的候選集容量。Milvus 預設使用 `max(refine_k, limit) ` 作為容量,但若 LSH 查詢返回的匹配結果較少,則可能僅對較少候選項目進行精細化。增加 `refine_k ` 可提升結果品質,但會增加運算成本。
下一步
全文搜尋:使用 BM25 進行詞彙相關性排序,而非近似重複檢測。
分析器概述:為文字分詞配置自訂分析器。
MINHASH_LSH 索引:瞭解如何調整 LSH 參數以優化召回率與效能。
