

Совпадение по фразеCompatible with Milvus 2.5.17+
Поиск по фразе позволяет находить документы, содержащие термины вашего запроса в виде точной фразы. По умолчанию слова должны встречаться в том же порядке и непосредственно рядом друг с другом. Например, запрос «робототехника машинное обучение» найдет текст типа «…типичные модели машинного обучения в робототехнике…», где слова «робототехника», «машинное» и «обучение» идут подряд, без других слов между ними.
Однако в реальных сценариях строгое фразное сопоставление может оказаться слишком жестким. Возможно, вам потребуется найти текст типа «…модели машинного обучения, широко применяемые в робототехнике…». В данном случае присутствуют те же ключевые слова, но они не расположены рядом и не в исходном порядке. Для решения этой проблемы фразное сопоставление поддерживает параметр « slop », который обеспечивает гибкость. Значение параметра « slop » определяет, сколько позиционных сдвигов допускается между терминами в фразе. Например, при значении параметра « slop » равном 1 запрос «machine learning» может сопоставляться с текстом типа «…machine deep learning…», где одно слово («deep») разделяет исходные термины.
Обзор
Функция сопоставления фраз, реализованная на основе библиотеки поисковой системы Tantivy, работает путем анализа информации о положении слов в документах. На приведенной ниже схеме показан этот процесс:
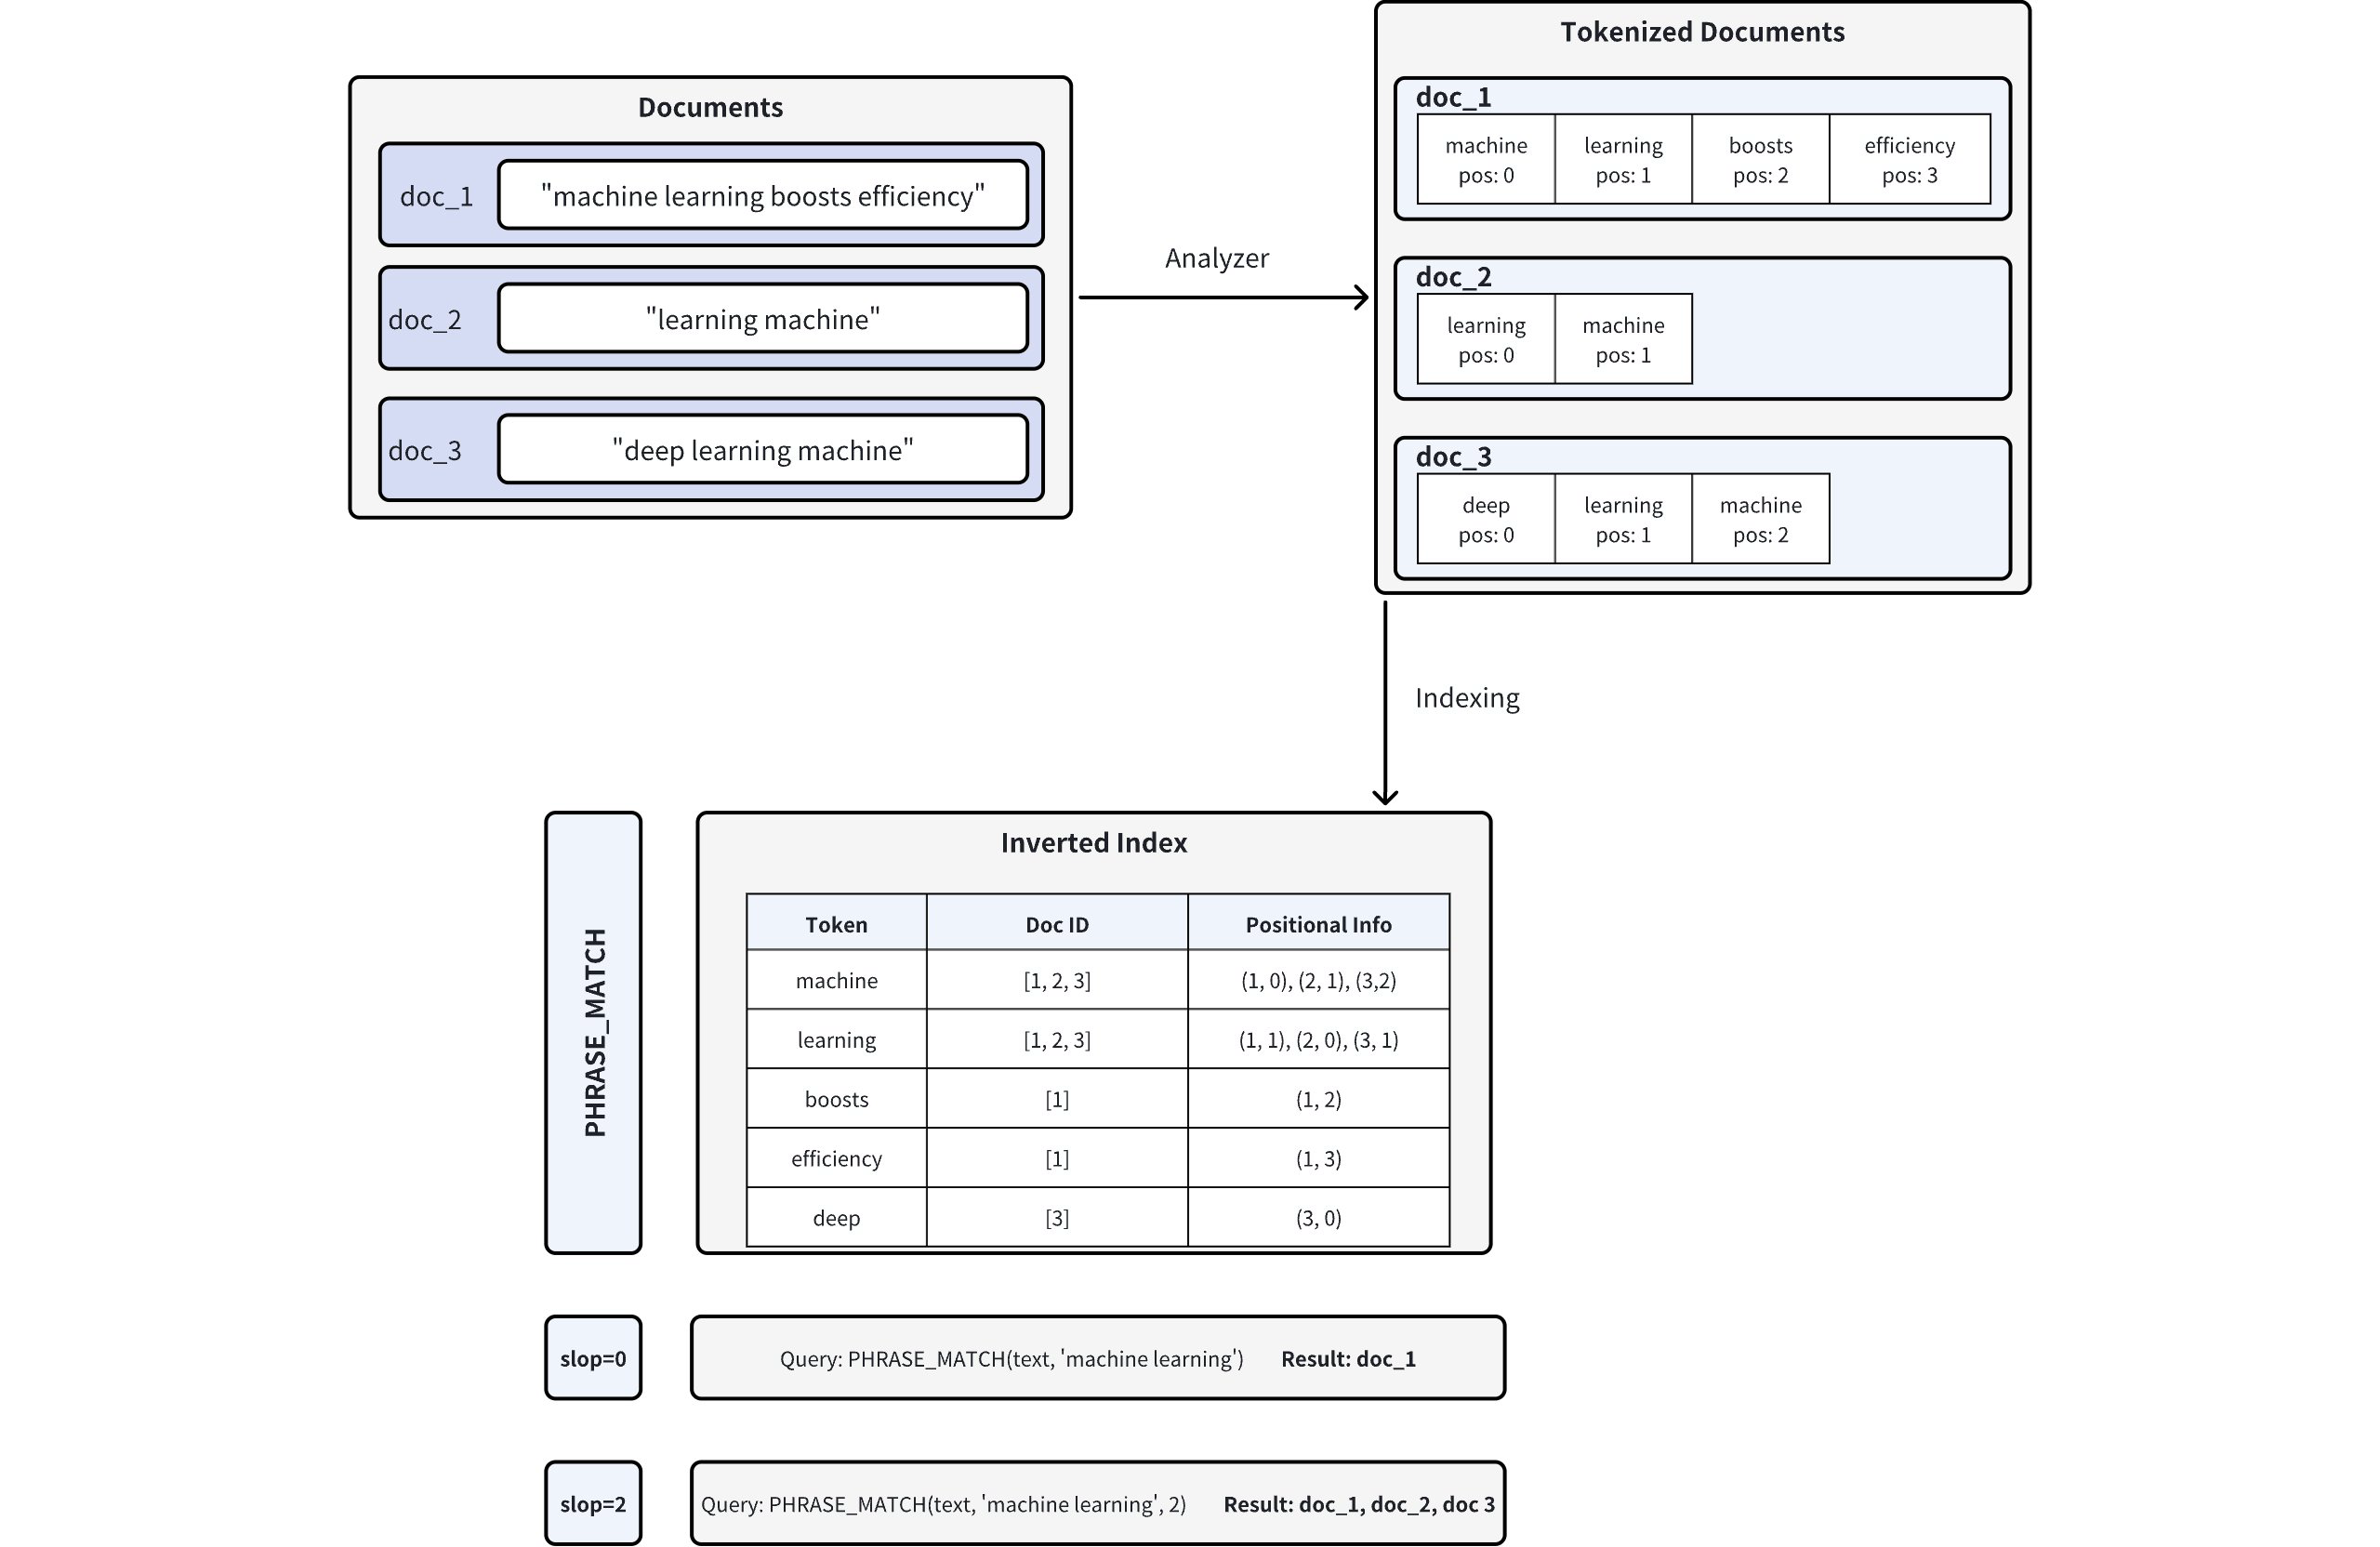 Рабочий процесс поиска по фразам
Токенизация документа: при загрузке документов в Milvus текст разбивается на токены (отдельные слова или термины) с помощью анализатора, при этом для каждого токена фиксируется информация о его позиции. Например, doc_1 токенизируется в [«machine» (pos=0), «learning» (pos=1), «boosts» (pos=2), «efficiency» (pos=3)]. Дополнительную информацию об анализаторах см. в разделе «Обзор анализаторов».
Создание инвертированного индекса: Milvus создаёт инвертированный индекс, сопоставляя каждый токен с документом (документами), в котором он встречается, и с позициями этого токена в этих документах.
Сопоставление фраз: при выполнении фразового запроса Milvus ищет каждый токен в инвертированном индексе и проверяет их позиции, чтобы определить, появляются ли они в правильном порядке и с нужной близостью. Параметр «
slop» контролирует максимальное количество позиций, допустимое между совпадающими токенами:slop = 0 означает, что токены должны встречаться в точном порядке и непосредственно рядом друг с другом (т. е. без лишних слов между ними).
- В примере точно соответствует только doc_1 («machine» в позиции 0, «learning» в позиции 1).
slop = 2 допускает до двух позиций гибкости или перестановки между совпадающими токенами.
Это допускает обратный порядок («learning machine») или небольшой промежуток между токенами.
Следовательно, совпадают doc_1, doc_2 («learning» в позиции 0, «machine» в позиции 1) и doc_3 («learning» в позиции 1, «machine» в позиции 2).
Включение фразового сопоставления
Совпадение по фразам работает с типом поля « VARCHAR » — типом данных «string» в Milvus. Чтобы включить поиск по фразам, настройте схему коллекции, установив для параметров « enable_analyzer » и « enable_match » значение « True », аналогично поиску по тексту.
Установите значения enable_analyzer и enable_match
Чтобы включить поиск по фразам для конкретного поля VARCHAR, при определении схемы поля установите для обоих параметров enable_analyzer и enable_match значение True. Эта настройка указывает Milvus на необходимость токенизации текста и создания инвертированного индекса с позиционной информацией, необходимой для эффективного поиска по фразам.
Ниже приведён пример определения схемы для включения поиска по фразам:
from pymilvus import MilvusClient, DataType

# Create a schema for a new collection
schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
# Add a VARCHAR field configured for phrase matching
schema.add_field(
    field_name='text',                 # Name of the field
    datatype=DataType.VARCHAR,         # Field data type set as VARCHAR (string)
    max_length=1000,                   # Maximum length of the string in bytes
    enable_analyzer=True,              # Enables text analysis (tokenization)
    enable_match=True                  # Enables inverted indexing for phrase matching
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
Необязательно: настройка анализатора
Точность поиска по фразам в значительной степени зависит от анализатора, используемого для токенизации текстовых данных. Различные анализаторы подходят для разных языков и форматов текста, что влияет на токенизацию и точность позиционного поиска. Выбор подходящего анализатора для вашего конкретного случая использования позволит оптимизировать результаты поиска по фразам.
По умолчанию Milvus использует стандартный анализатор, который разбивает текст на токены на основе пробелов и знаков препинания, удаляет токены длиной более 40 символов и преобразует текст в нижний регистр. Для использования по умолчанию дополнительные параметры не требуются. Подробности см. в разделе «Стандартный анализатор ».
Если вашему приложению требуется конкретный анализатор, настройте его с помощью параметра ` analyzer_params `. Например, вот как настроить анализатор ` english ` для сопоставления фраз в тексте на английском языке:
# Define analyzer parameters for English-language tokenization
analyzer_params = {
    "type": "english"
}

# Add the VARCHAR field with the English analyzer enabled
schema.add_field(
    field_name='text',                 # Name of the field
    datatype=DataType.VARCHAR,         # Field data type set as VARCHAR
    max_length=1000,                   # Maximum length of the string in bytes
    enable_analyzer=True,              # Enables text analysis
    analyzer_params=analyzer_params,   # Specifies the analyzer configuration
    enable_match=True                  # Enables inverted indexing for phrase matching
)
Milvus поддерживает несколько анализаторов, адаптированных для разных языков и сценариев использования. Подробную информацию см. в разделе «Обзор анализаторов».
Использование поиска по фразам
После включения сопоставления для поля « VARCHAR » в схеме коллекции можно выполнять сопоставление фраз с помощью выражения « PHRASE_MATCH ».
Выражение « PHRASE_MATCH » нечувствительно к регистру. Можно использовать как « PHRASE_MATCH », так и « phrase_match ».
Синтаксис выражения PHRASE_MATCH
Используйте выражение « PHRASE_MATCH » для указания поля, фразы и опциональной гибкости (slop) при поиске. Синтаксис следующий:
PHRASE_MATCH(field_name, phrase, slop)
field_name: Имя поля «VARCHAR», по которому выполняется поиск по фразе.phrase: Точная фраза, которую нужно найти.slop(необязательно): Целое число, определяющее максимальное количество позиций, допускаемых в совпадающих токенах.0(по умолчанию): Соответствует только точным фразам. Пример: Фильтр для «machine learning» будет соответствовать именно «machine learning», но не «machine boosts learning» или «learning machine».1: Допускает незначительные вариации, такие как один дополнительный термин или небольшое смещение позиции. Пример: фильтр для «machine learning» найдет совпадение с «machine boosts learning» (один токен между «machine» и «learning»), но не с «learning machine» (термины в обратном порядке).2: Допускает большую гибкость, включая обратный порядок терминов или до двух токенов между ними. Пример: фильтр «machine learning» будет находить совпадения с «learning machine» (термины в обратном порядке) или «machine quickly boosts learning» (два токена между «machine» и «learning»).
Пример набора данных
Предположим, у вас есть коллекция с именем tech_articles, содержащая следующие пять сущностей:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
2 |
«Освоение машинного подхода имеет жизненно важное значение для прогресса современного искусственного интеллекта» |
3 |
«Архитектуры систем глубокого обучения оптимизируют вычислительную нагрузку» |
4 |
«Машина быстро повышает эффективность модели для непрерывного обучения» |
5 |
«Обучение сложным алгоритмам расширяет возможности ИИ» |
Запрос с поиском по фразе
При использовании метода query() параметр PHRASE_MATCH действует как скалярный фильтр. Возвращаются только те документы, которые содержат указанную фразу (с учетом допустимого отклонения).
Пример: slop = 0 (точное совпадение)
В этом примере возвращаются документы, содержащие точную фразу «machine learning» без каких-либо дополнительных токенов между словами.
# Match documents containing exactly "machine learning"
filter = "PHRASE_MATCH(text, 'machine learning')"

result = client.query(
    collection_name="tech_articles",
    filter=filter,
    output_fields=["id", "text"]
)
Ожидаемые результаты сопоставления:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
Только документ 1 содержит точную фразу «machine learning» в указанном порядке без дополнительных токенов.
Поиск с помощью фразового сопоставления
В операциях поиска PHRASE_MATCH используется для фильтрации документов перед применением ранжирования по векторному сходству. Этот двухэтапный подход сначала сужает набор кандидатов с помощью текстового сопоставления, а затем заново ранжирует этих кандидатов на основе векторных вложений.
Пример: slop = 1
Здесь мы допускаем отклонение, равное 1. Фильтр применяется к документам, содержащим фразу «learning machine», с небольшой гибкостью.
# Example: Filter documents containing "learning machine" with slop=1
filter_slop1 = "PHRASE_MATCH(text, 'learning machine', 1)"

result_slop1 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",
    data=[query_vector],
    filter=filter_slop1,
    search_params={"params": {"nprobe": 10}},
    limit=10,
    output_fields=["id", "text"]
)
Результаты сопоставления:
|
|
|---|---|
2 |
«Изучение машинного подхода имеет жизненно важное значение для прогресса современного ИИ» |
3 |
«Архитектуры машин глубокого обучения оптимизируют вычислительную нагрузку» |
5 |
«Освоение передовых алгоритмов машинного обучения расширяет возможности ИИ» |
Пример: slop = 2
В этом примере допускается отклонение 2, что означает, что между словами «machine» и «learning» допускается до двух дополнительных токенов (или терминов в обратном порядке) .
# Example: Filter documents containing "machine learning" with slop=2
filter_slop2 = "PHRASE_MATCH(text, 'machine learning', 2)"

result_slop2 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",             # Vector field name
    data=[query_vector],                 # Query vector
    filter=filter_slop2,                 # Filter expression
    search_params={"params": {"nprobe": 10}},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)
Результаты сопоставления:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
3 |
«Архитектуры машин глубокого обучения оптимизируют вычислительную нагрузку» |
Пример: slop = 3
В этом примере значение slop, равное 3, обеспечивает еще большую гибкость. Фильтр ищет фразу «machine learning», при этом между словами допускается до трех позиций токенов.
# Example: Filter documents containing "machine learning" with slop=3
filter_slop3 = "PHRASE_MATCH(text, 'machine learning', 3)"

result_slop2 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",             # Vector field name
    data=[query_vector],                 # Query vector
    filter=filter_slop3,                 # Filter expression
    search_params={"params": {"nprobe": 10}},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)
Результаты сопоставления:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
2 |
«Освоение машинного подхода имеет жизненно важное значение для прогресса современного ИИ» |
3 |
«Архитектуры систем глубокого обучения оптимизируют вычислительную нагрузку» |
5 |
«Изучение передовых алгоритмов машинного обучения расширяет возможности ИИ» |
Рекомендации
Включение сопоставления фраз для поля приводит к созданию инвертированного индекса, что требует ресурсов хранения. При принятии решения о включении этой функции учитывайте влияние на хранение, поскольку оно зависит от размера текста, количества уникальных токенов и используемого анализатора.
После определения анализатора в схеме его настройки становятся постоянными для данной коллекции. Если вы решите, что другой анализатор лучше соответствует вашим потребностям, можно удалить существующую коллекцию и создать новую с нужной конфигурацией анализатора.
Производительность поиска по фразам зависит от того, как разбивается текст на токены. Прежде чем применять анализатор ко всей коллекции, воспользуйтесь методом `
run_analyzer`, чтобы проверить результаты токенизации. Дополнительные сведения см. в разделе «Обзор анализаторов».Правила экранирования в выражениях
filter:Символы, заключённые в двойные или одинарные кавычки внутри выражений, интерпретируются как строковые константы. Если строковая константа содержит символы экранирования, эти символы должны быть представлены с помощью экранирующих последовательностей. Например, используйте `
\\` для представления `\`, `\\t` для представления табуляции `\t` и `\\n` для представления символа новой строки.Если строковая константа заключена в одинарные кавычки, одинарная кавычка внутри константы должна представляться как
\\', тогда как двойная кавычка может представляться либо как", либо как\\". Пример:'It\\'s milvus'.Если строковая константа заключена в двойные кавычки, двойная кавычка внутри константы должна быть представлена как
\\", а одинарная кавычка может быть представлена либо как', либо как\\'. Пример:"He said \\"Hi\\"".
