

Função MinHashCompatible with Milvus 3.0.x
A função MinHash converte texto bruto em vetores binários que aproximam a similaridade de Jaccard entre documentos. Aplica o método de «shingling» de texto e várias funções hash para produzir vetores de assinatura de comprimento fixo, permitindo a deteção rápida de quase-duplicados e a deduplicação de documentos em grande escala.
Sendo uma função integrada, a MinHash é executada no Milvus e não requer inferência de modelos externos nem pré-processamento. Basta inserir o texto bruto e o Milvus gera automaticamente os vetores de assinatura MinHash.
Limites
O campo de saída deve ser um «
BINARY_VECTOR» com uma dimensão que satisfaça a condição «dim % 32 == 0», uma vez que cada assinatura MinHash é um valor hash de 32 bits.O `
dim` do campo de vetor binário deve ser igual a `32 * num_hashes`. Uma discrepância provoca um erro.Ao utilizar o índice «
MINHASH_LSH» com a saída da função MinHash, «mh_element_bit_width» deve ser definido como «32».
Como funciona o MinHash
O MinHash é uma técnica de hash sensível à localidade que estima a similaridade de Jaccard entre conjuntos. No Milvus, a função MinHash segue este fluxo de trabalho: fornece-se texto bruto como entrada e o Milvus produz um vetor binário como saída — tratando de todas as etapas intermédias internamente.
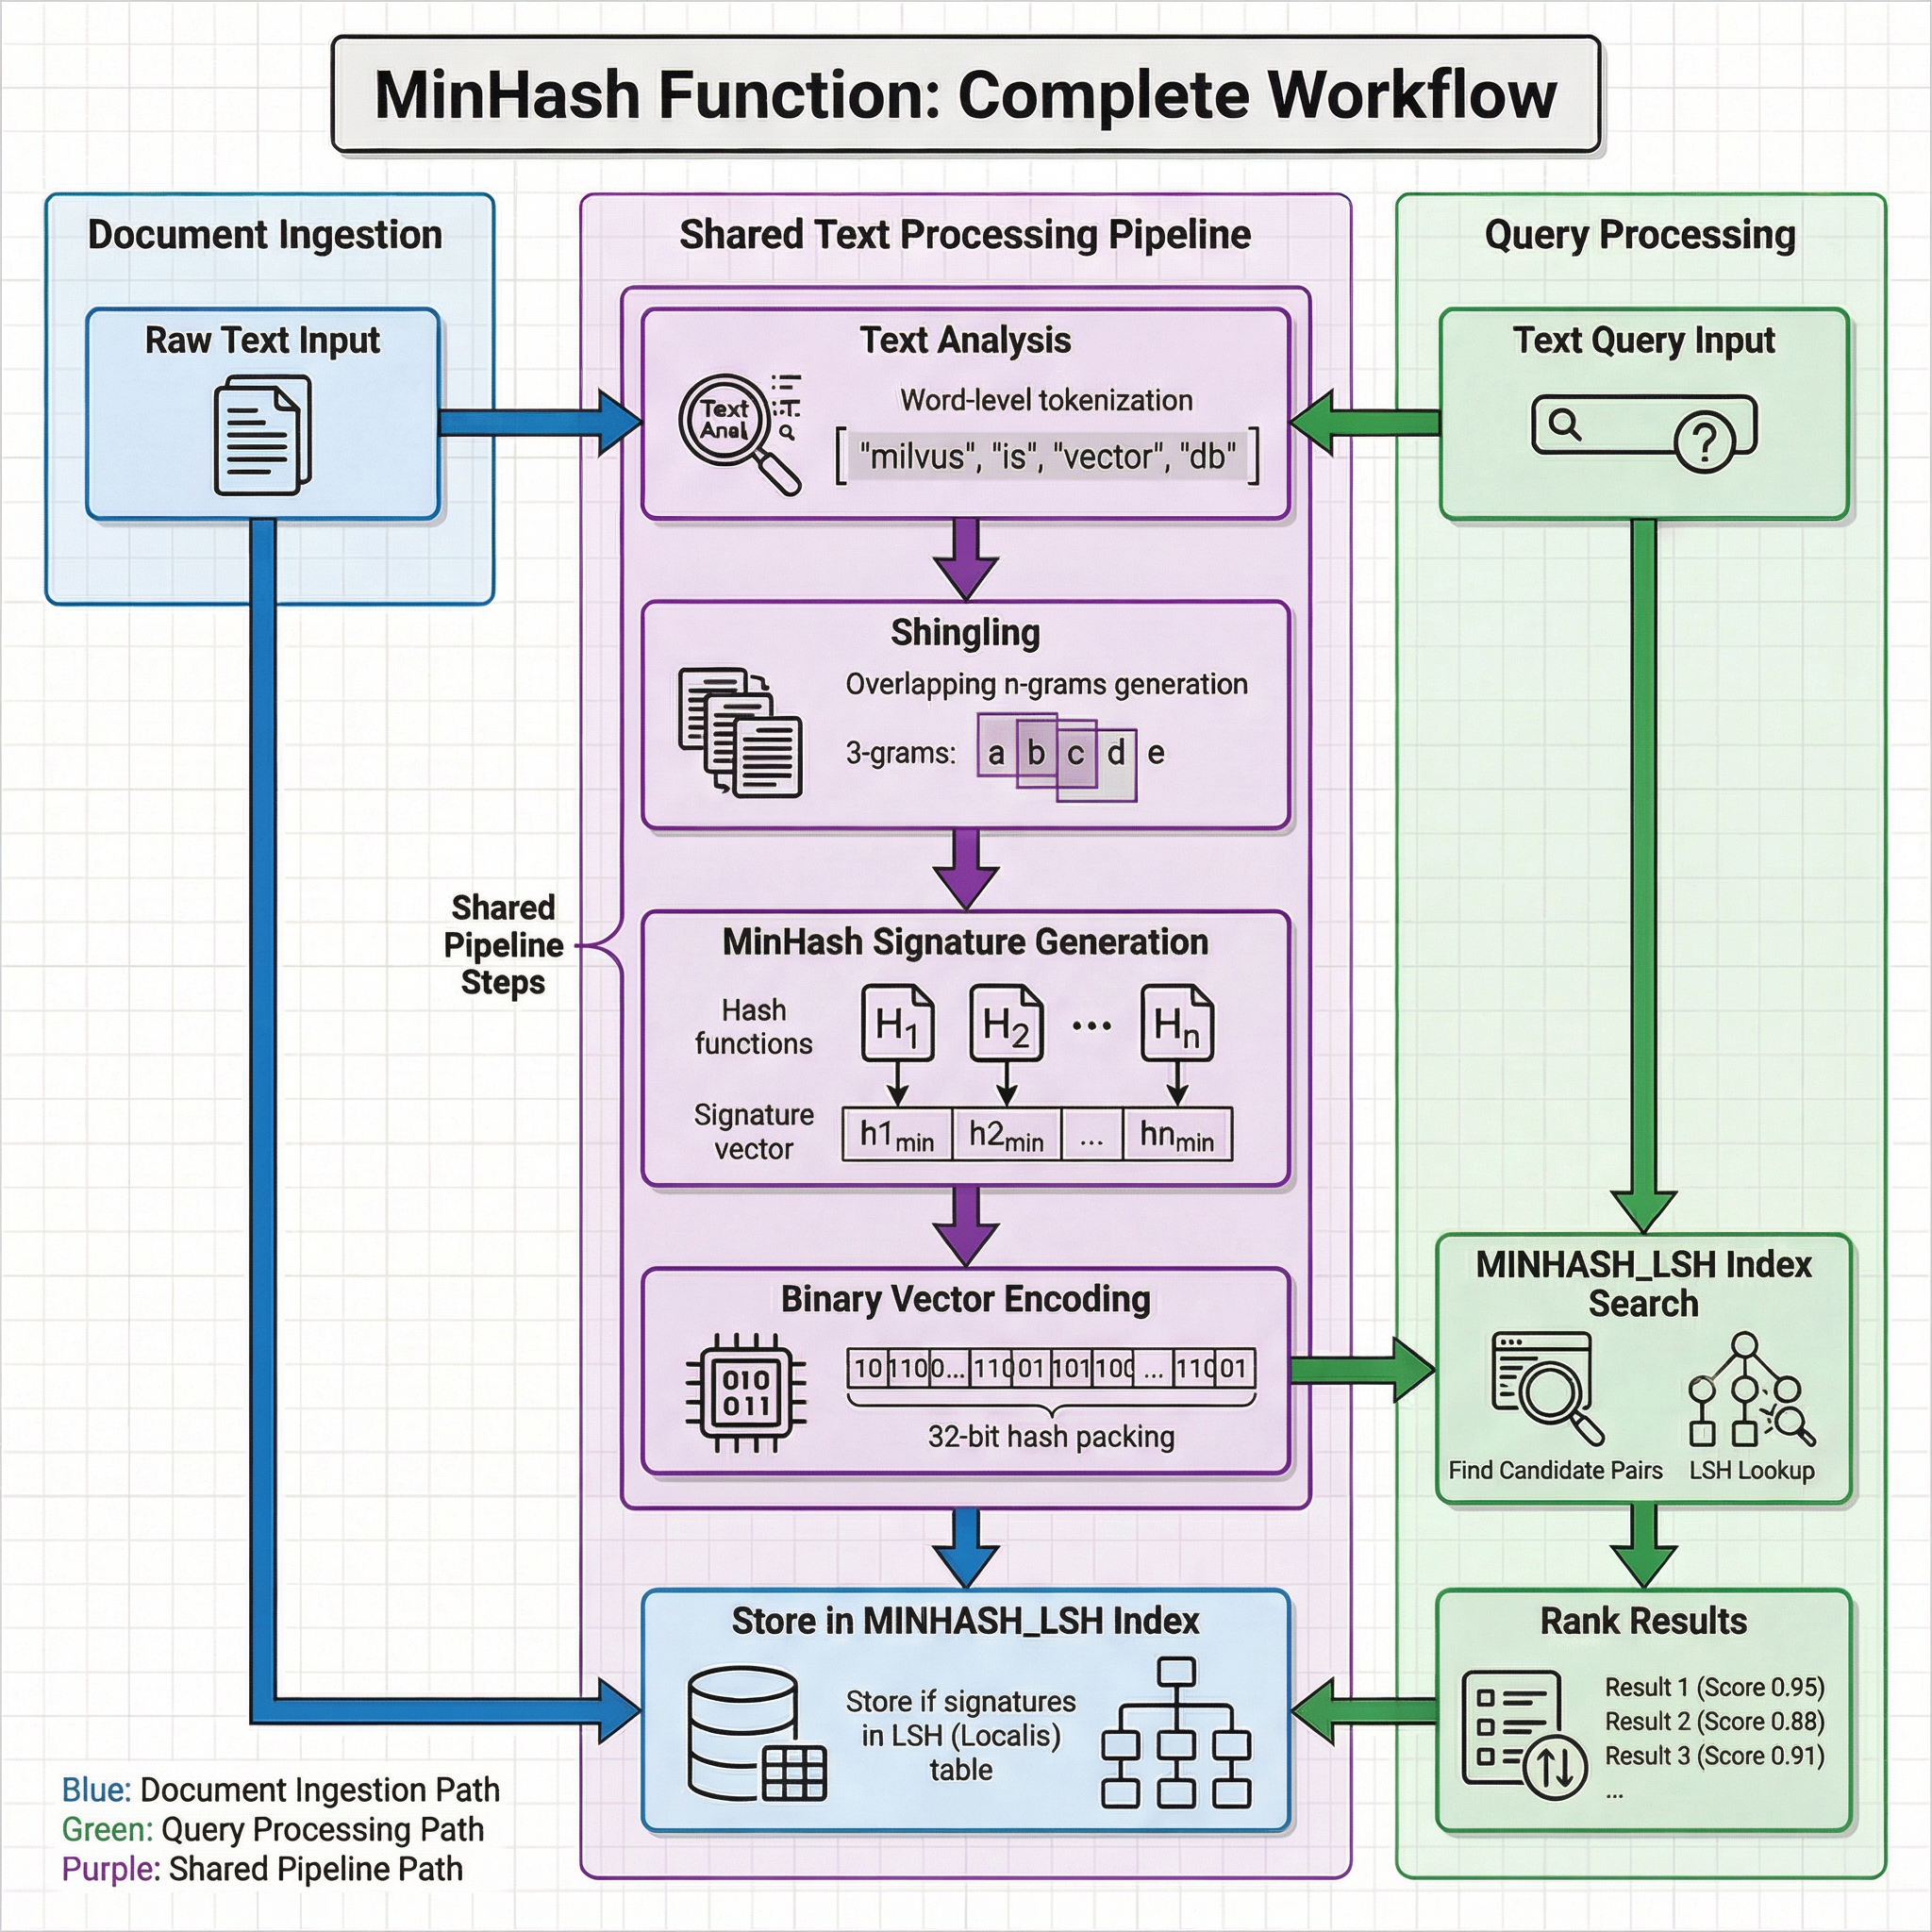
O fluxo de trabalho global consiste num fluxo de processamento de texto partilhado, utilizado tanto pela ingestão de documentos como pelo processamento de consultas, seguido de operações específicas de cada fase para armazenamento e recuperação.
 Iaqkbfeh8oqggsx6nsocfosondo
Fluxo de trabalho partilhado de processamento de texto
Tanto a ingestão de documentos como o processamento de consultas submetem o texto bruto à mesma transformação em quatro etapas:
Análise de texto: O texto é processado por um analisador (quando
token_levelé"word") ou utilizado diretamente (quandotoken_levelé"char"). A tokenização ao nível da palavra aplica o analisador configurado no campo de entrada para segmentar o texto em termos — por exemplo,"milvus is vector db"torna-se["milvus", "is", "vector", "db"].Shingling: Os tokens são divididos em n-gramas sobrepostos (shingles) de tamanho
shingle_size. Por exemplo, com 3-gramas ao nível da palavra, os tokens["information", "retrieval", "is", "a", "field"]tornam-se shingles como["information retrieval is", "retrieval is a", "is a field"].Geração da assinatura MinHash: São aplicadas várias funções hash (H1, H2, …, Hn, onde n =
num_hashes) ao conjunto de shingles. Para cada função hash, é selecionado o valor hash mínimo entre todos os shingles. O conjunto destes valores mínimos forma a assinatura MinHash — uma representação de comprimento fixo que se aproxima da similaridade de Jaccard do documento original.Codificação de vetor binário: Cada valor de assinatura é um hash de 32 bits, e a assinatura completa é compactada num
BINARY_VECTORde dimensão32 * num_hashes.
Ingestão de documentos
Durante a inserção, o vetor binário produzido pelo pipeline partilhado é armazenado no índice « MINHASH_LSH ». O índice mantém uma tabela LSH (Locality-Sensitive Hashing) que agrupa assinaturas semelhantes nos mesmos buckets, permitindo uma recuperação rápida de candidatos no momento da consulta.
Processamento de consultas
Durante a pesquisa, o texto da consulta passa pelo mesmo pipeline partilhado para produzir um vetor binário. Este vetor é utilizado para realizar uma pesquisa LSH no índice MINHASH_LSH, o que identifica rapidamente pares de candidatos que são provavelmente semelhantes. Sem o refinamento de Jaccard, o Milvus devolve candidatos LSH que não estão classificados pela semelhança estimada de Jaccard. Quando o refinamento de Jaccard está ativado, o Milvus utiliza as assinaturas MinHash brutas armazenadas para classificar os candidatos de acordo com a semelhança estimada de Jaccard e devolver os K melhores resultados.
Como ambos os percursos partilham a mesma lógica de transformação, dois documentos com conteúdo altamente sobreposto produzem assinaturas MinHash semelhantes. Isto torna a função eficaz para encontrar quase-duplicados, mesmo quando os documentos diferem na ordem das palavras, na formatação ou em pequenas variações de expressão.
Antes de começar
Antes de utilizar a função MinHash, planeie o esquema da sua coleção de forma a incluir o seguinte:
Um campo de texto para conteúdo bruto
A sua coleção deve incluir um campo «
VARCHAR» para armazenar texto bruto. Este campo serve como entrada para a função MinHash.Um analisador para o campo de texto (ao utilizar a tokenização ao nível da palavra)
Se «
token_level» estiver definido como «"word"» (predefinição), o campo de texto deve ter um analisador ativado. O analisador define como o texto é tokenizado antes do shingling. Por predefinição, o Milvus utiliza o analisador «standard». Para configurar um analisador diferente, consulte «Escolher o analisador adequado para o seu caso de utilização».Um campo de vetor binário para a saída do MinHash
A sua coleção deve incluir um campo «
BINARY_VECTOR» para armazenar os vetores binários gerados pela função MinHash. A dimensão deve ser igual a «32 * num_hashes».
Passo 1: Criar uma coleção com uma função MinHash
Para utilizar a função MinHash, defina-a ao criar a coleção. A função passa a fazer parte do esquema da coleção e é aplicada automaticamente durante a inserção e a pesquisa de dados.
Definir campos do esquema
O esquema da sua coleção deve incluir, pelo menos, três campos:
Campo primário: identifica de forma única cada entidade na coleção.
Campo de texto (
VARCHAR): Armazena documentos de texto bruto. Defina «enable_analyzer=True» para que o Milvus possa processar o texto para a geração da assinatura MinHash. Por predefinição, o Milvus utiliza o analisador «standard» para a análise de texto. Para configurar um analisador diferente, consulte «Escolher o analisador adequado para o seu caso de utilização».Campo de vetores binários (
BINARY_VECTOR): Armazena vetores binários gerados automaticamente pela função MinHash. A dimensão deve ser igual a32 * num_hashes.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="http://localhost:19530", token="root:Milvus")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
// java
// nodejs
// go
# restful
Definir a função MinHash
A função MinHash converte o texto analisado em vetores binários que aproximam a similaridade de Jaccard entre documentos.
Defina a função e adicione-a ao seu esquema:
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
// java
// nodejs
// go
# restful
Opções de configuração
O dicionário ` params ` da função MinHash aceita os seguintes parâmetros. Todos os nomes dos parâmetros não distinguem maiúsculas de minúsculas.
Parâmetro |
Tipo |
Padrão |
Descrição |
|---|---|---|---|
|
int |
Derivado de |
Número de funções hash para a geração de assinaturas. A dimensão do vetor binário de saída é igual a |
|
int |
|
Tamanho do N-gram para shingling. Ao nível da palavra: o valor típico é 1-3. Ao nível do carácter: o valor típico é 2-6. |
|
str |
|
Função hash a utilizar. Opções:
|
|
str |
|
Nível de tokenização. Opções:
|
|
int |
|
Semente aleatória para a inicialização da função MinHash. |
Configurar o índice
O tipo de índice recomendado para vetores binários MinHash é « MINHASH_LSH », com o tipo de métrica « MHJACCARD ».
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
// java
// nodejs
// go
# restful
Defina « with_raw_data » como « True » se as pesquisas forem utilizar o refinamento de Jaccard. As assinaturas MinHash brutas são necessárias para calcular a similaridade de Jaccard estimada para os candidatos devolvidos pela pesquisa LSH.
Criar a coleção
Crie a coleção utilizando os parâmetros de esquema e índice definidos acima:
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
// java
// nodejs
// go
# restful
Passo 2: Inserir documentos
Após configurar a sua coleção, insira dados de texto. Basta fornecer o texto bruto — a função MinHash gera automaticamente o vetor binário para cada documento.
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
// java
// nodejs
// go
# restful
Passo 3: Pesquisar com o MinHash
Depois de inserir os dados, procure documentos quase duplicados, fornecendo consultas de texto bruto. O Milvus converte automaticamente cada consulta num vetor binário MinHash. Ative o refinamento de Jaccard para classificar os candidatos LSH de acordo com a semelhança de Jaccard estimada.
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
// java
// nodejs
// go
# restful
Defina ` mh_search_with_jaccard ` como ` True ` para ativar o refinamento de Jaccard. ` refine_k ` controla a capacidade do conjunto de candidatos utilizada para o refinamento. O Milvus utiliza ` max(refine_k, limit) ` como capacidade, mas poderá refinar menos candidatos se a pesquisa LSH devolver menos correspondências. Aumentar ` refine_k ` pode melhorar a qualidade dos resultados, à custa de um esforço computacional adicional.
Próximos passos
Pesquisa de texto completo: utilize o BM25 para a classificação por relevância lexical, em vez da deteção de quase-duplicados.
Visão geral do analisador: Configure analisadores personalizados para a tokenização de texto.
Índice MINHASH_LSH: Saiba mais sobre o ajuste dos parâmetros LSH para recall e desempenho.
