

MinHash 함수Compatible with Milvus 3.0.x
MinHash 함수는 원본 텍스트를 문서 간의 자카드 유사도를 근사하는 이진 벡터로 변환합니다. 이 함수는 텍스트 쉐이링 및 여러 해시 함수를 적용하여 고정 길이의 시그니처 벡터를 생성함으로써, 대규모 환경에서 빠른 유사 문서 탐지 및 문서 중복 제거를 가능하게 합니다.
내장 함수인 MinHash는 Milvus 내에서 실행되며, 외부 모델 추론이나 전처리가 필요하지 않습니다. 원본 텍스트를 입력하면 Milvus가 MinHash 시그니처 벡터를 자동으로 생성합니다.
제한 사항
각 MinHash 시그니처는 32비트 해시 값이므로, 출력 필드는
dim % 32 == 0조건을 충족하는 차원을 가진BINARY_VECTOR이어야 합니다.이진 벡터 필드의
dim는32 * num_hashes와 동일해야 합니다. 일치하지 않을 경우 오류가 발생합니다.MINHASH_LSH인덱스를 MinHash 함수 출력과 함께 사용할 경우,mh_element_bit_width는32로 설정되어야 합니다.
MinHash의 작동 원리
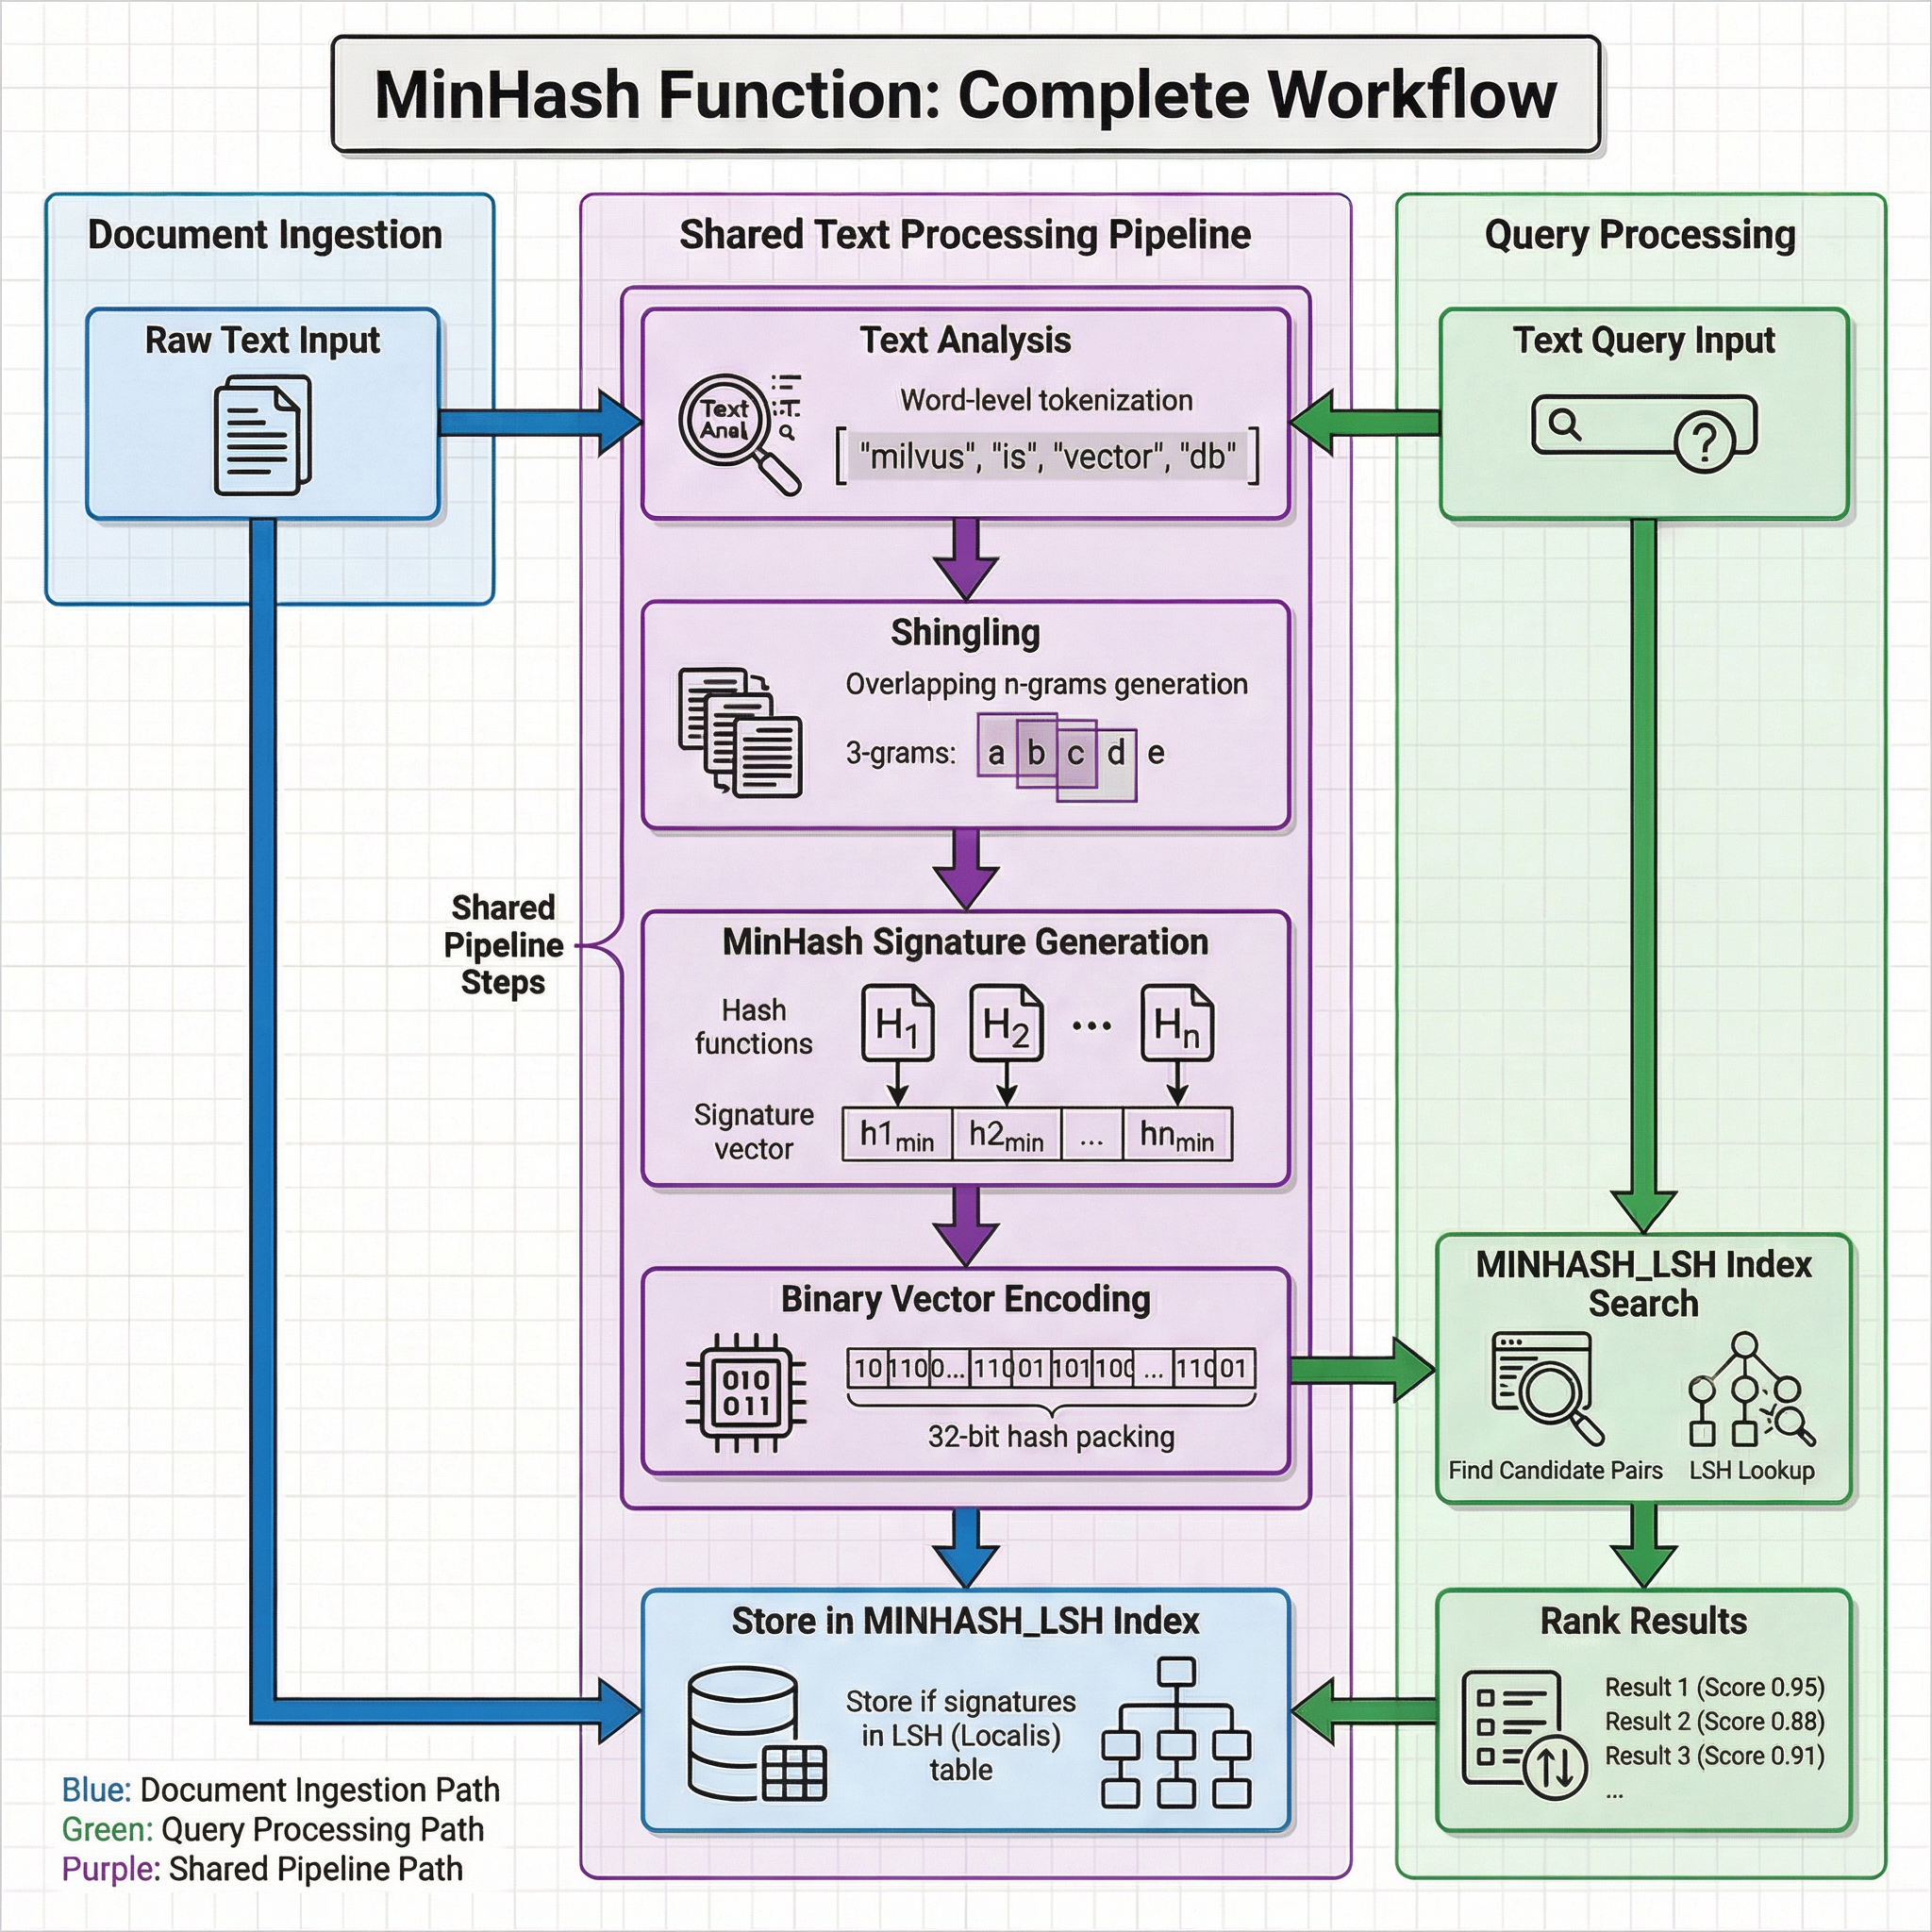
MinHash는 집합 간의 Jaccard 유사도를 추정하는 국소성 민감 해싱 기법입니다. Milvus에서 MinHash 함수는 다음과 같은 파이프라인을 따릅니다. 사용자는 원본 텍스트를 입력으로 제공하면, Milvus는 이진 벡터를 출력으로 생성하며, 모든 중간 단계는 내부적으로 처리됩니다.
전체 워크플로는 문서 수집 및 쿼리 처리 모두에서 사용되는 공통 텍스트 처리 파이프라인으로 구성되며, 그 뒤를 이어 저장 및 검색을 위한 단계별 작업이 수행됩니다.
 Iaqkbfeh8oqggsx6nsocfosondo
공유 텍스트 처리 파이프라인
문서 수집과 쿼리 처리 모두 원본 텍스트를 동일한 4단계 변환 과정을 거칩니다:
텍스트 분석: 텍스트는 분석기 (
token_level가"word"인 경우)를 통해 처리되거나 직접 사용됩니다(token_level가"char"인 경우). 단어 수준 토큰화는 입력 필드에 구성된 분석기를 적용하여 텍스트를 용어로 분할합니다. 예를 들어,"milvus is vector db"는["milvus", "is", "vector", "db"]가 됩니다.싱글링(Shingling): 토큰은 크기
shingle_size인 중첩된 n-그램(싱글)으로 분할됩니다. 예를 들어, 단어 수준에서 3-그램을 사용하는 경우, 토큰["information", "retrieval", "is", "a", "field"]은["information retrieval is", "retrieval is a", "is a field"]과 같은 싱글이 됩니다.MinHash 서명 생성: 여러 해시 함수(H1, H2, …, Hn, 여기서 n =
num_hashes)가 싱글 집합에 적용됩니다. 각 해시 함수에 대해, 모든 싱글에서 가장 작은 해시 값이 선택됩니다. 이러한 최소값들의 집합이 MinHash 서명을 형성하며, 이는 원본 문서의 자카드 유사도를 근사하는 고정 길이 표현입니다.이진 벡터 인코딩: 각 서명 값은 32비트 해시이며, 전체 서명은 차원
32 * num_hashes의BINARY_VECTOR로 압축됩니다.
문서 수집
삽입 시, 공유 파이프라인에서 생성된 이진 벡터는 MINHASH_LSH 인덱스에 저장됩니다. 이 인덱스는 유사한 서명을 동일한 버킷으로 묶는 LSH(Locality-Sensitive Hashing) 테이블을 유지하여, 쿼리 시 후보를 빠르게 검색할 수 있도록 합니다.
쿼리 처리
검색 시, 쿼리 텍스트는 동일한 공유 파이프라인을 거쳐 이진 벡터를 생성합니다. 이 벡터는 MINHASH_LSH 인덱스에서 LSH 조회를 수행하는 데 사용되며, 이를 통해 유사할 가능성이 높은 후보 쌍을 신속하게 식별합니다. Jaccard 정제 기능이 활성화되지 않은 경우, Milvus는 추정된 Jaccard 유사도에 따라 순위가 매겨지지 않은 LSH 후보들을 반환합니다. Jaccard 정교화 기능이 활성화되면, Milvus는 저장된 원시 MinHash 시그니처를 사용하여 추정된 Jaccard 유사도에 따라 후보를 순위 매기고 상위 K개 결과를 반환합니다.
두 경로 모두 동일한 변환 논리를 공유하기 때문에, 내용이 크게 중복되는 두 문서는 유사한 MinHash 시그니처를 생성합니다. 이로 인해 문서의 단어 순서, 서식 또는 사소한 표현이 다르더라도 준중복 문서를 효과적으로 찾을 수 있습니다.
시작하기 전에
MinHash 함수를 사용하기 전에, 다음 사항을 포함하도록 컬렉션 스키마를 계획하십시오:
원본 콘텐츠를 저장할 텍스트 필드
컬렉션에는 원본 텍스트를 저장할 `
VARCHAR` 필드가 반드시 포함되어야 합니다. 이 필드는 MinHash 함수의 입력으로 사용됩니다.텍스트 필드용 분석기 (단어 수준 토큰화 사용 시)
token_level가"word"(기본값)으로 설정된 경우, 텍스트 필드에는 분석기가 활성화되어 있어야 합니다. 분석기는 쉐이링(shingling) 전에 텍스트가 어떻게 토큰화될지를 정의합니다. 기본적으로 Milvus는standard분석기를 사용합니다. 다른 분석기를 구성하려면 ‘사용 사례에 적합한 분석기 선택’을 참조하십시오.MinHash 출력을 위한 이진 벡터 필드
컬렉션에는 MinHash 함수에 의해 생성된 이진 벡터를 저장하기 위한 `
BINARY_VECTOR` 필드가 포함되어야 합니다. 차원은 `32 * num_hashes`와 동일해야 합니다.
1단계: MinHash 함수가 포함된 컬렉션 생성
MinHash 함수를 사용하려면 컬렉션을 생성할 때 해당 함수를 정의해야 합니다. 이 함수는 컬렉션 스키마의 일부가 되며, 데이터 삽입 및 검색 시 자동으로 적용됩니다.
스키마 필드 정의
컬렉션 스키마에는 다음 세 가지 필드가 반드시 포함되어야 합니다.
기본 필드(Primary field): 컬렉션 내 각 엔티티를 고유하게 식별합니다.
텍스트 필드 (
VARCHAR): 원시 텍스트 문서를 저장합니다. Milvus가 MinHash 서명 생성을 위해 텍스트를 처리할 수 있도록 `enable_analyzer=True`를 설정하십시오. 기본적으로 Milvus는 텍스트 분석에 `standard` 분석기를 사용합니다. 다른 분석기를 구성하려면 ‘사용 사례에 적합한 분석기 선택’을 참조하십시오.바이너리 벡터 필드 (
BINARY_VECTOR): MinHash 함수에 의해 자동 생성된 바이너리 벡터를 저장합니다. 차원은32 * num_hashes와 동일해야 합니다.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="http://localhost:19530", token="root:Milvus")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
// java
// nodejs
// go
# restful
MinHash 함수 정의
MinHash 함수는 분석된 텍스트를 문서 간의 자카드 유사도를 근사화하는 이진 벡터로 변환합니다.
함수를 정의하고 스키마에 추가하세요:
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
// java
// nodejs
// go
# restful
구성 옵션
MinHash 함수의 ` params ` 사전은 다음 매개변수를 지원합니다. 모든 매개변수 이름은 대소문자를 구분하지 않습니다.
매개변수 |
유형 |
기본값 |
설명 |
|---|---|---|---|
|
int |
파생됨 |
서명 생성을 위한 해시 함수의 개수입니다. 출력 이진 벡터의 차원은 |
|
int |
|
싱글링(shingling)에 사용되는 N-그램 크기. 단어 수준: 일반적으로 1~3입니다. 문자 수준: 일반적으로 2~6입니다. |
|
str |
|
사용할 해시 함수. 옵션:
|
|
str |
|
토큰화 수준. 옵션:
|
|
int |
|
MinHash 함수 초기화를 위한 난수 시드입니다. |
인덱스 구성
MinHash 이진 벡터에 권장되는 인덱스 유형은 MINHASH_LSH 이며, 메트릭 유형은 MHJACCARD 입니다.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
// java
// nodejs
// go
# restful
검색 시 Jaccard 정밀화(Jaccard refinement)를 사용할 경우, ` with_raw_data `를 ` True `로 설정하십시오. LSH 조회 결과로 반환된 후보에 대한 예상 Jaccard 유사도를 계산하려면 원시 MinHash 시그니처가 필요합니다.
컬렉션 생성
위에서 정의한 스키마 및 인덱스 매개변수를 사용하여 컬렉션을 생성합니다:
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
// java
// nodejs
// go
# restful
2단계: 문서 삽입
컬렉션을 설정한 후 텍스트 데이터를 삽입합니다. 원시 텍스트만 제공하면 됩니다. MinHash 함수가 각 문서에 대한 이진 벡터를 자동으로 생성합니다.
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
// java
// nodejs
// go
# restful
3단계: MinHash를 사용하여 검색
데이터를 삽입한 후, 원본 텍스트 쿼리를 제공하여 준중복 문서를 검색하세요. Milvus는 각 쿼리를 자동으로 MinHash 이진 벡터로 변환합니다. Jaccard 정밀화 기능을 활성화하면 추정된 Jaccard 유사도에 따라 LSH 후보들의 순위를 매길 수 있습니다.
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
// java
// nodejs
// go
# restful
mh_search_with_jaccard 를 True 로 설정하여 Jaccard 정제 기능을 활성화합니다. refine_k 는 정제에 사용되는 후보 풀의 용량을 제어합니다. Milvus는 max(refine_k, limit) 를 용량으로 사용하지만, LSH 조회 결과 일치 항목이 적을 경우 더 적은 수의 후보만 정제할 수 있습니다. refine_k 를 늘리면 추가 계산 비용이 발생하지만 결과 품질이 향상될 수 있습니다.
다음 단계
전체 텍스트 검색: 근사 중복 탐지 대신 어휘적 관련성 순위를 매기기 위해 BM25를 사용합니다.
분석기 개요: 텍스트 토큰화를 위해 사용자 정의 분석기를 구성합니다.
MINHASH_LSH 인덱스: 리콜 및 성능을 위한 LSH 매개변수 튜닝에 대해 알아보세요.
