

モデルランカーの概要Compatible with Milvus 2.6.x
従来のベクトル検索は、高次元空間におけるベクトルの一致度、つまり純粋に数学的な類似性に基づいて検索結果をランク付けします。このアプローチは効率的ですが、真の意味でのセマンティックな関連性を見逃してしまうことがよくあります。例えば、「データベース最適化のベストプラクティス」を検索する場合を考えてみましょう。ベクトルの類似度が高く、これらの用語が頻繁に言及されているドキュメントが表示されるかもしれませんが、実際には実行可能な最適化戦略が提供されていない可能性があります。
Model Rankerは、クエリとドキュメント間の意味的な関係を理解する高度な言語モデルを統合することで、Milvusの検索機能を一新します。ベクトル類似性のみに依存するのではなく、コンテンツの意味や文脈を評価することで、より知的で関連性の高い検索結果を提供します。
制限事項
モデルランカーは、グループ化検索では使用できません。
モデルによる再ランク付けに使用されるフィールドは、テキスト型(
VARCHAR)である必要があります。各モデルランカーは、評価に一度に 1 つの
VARCHARフィールドのみを使用できます。
仕組み
モデルランカーは、明確に定義されたワークフローを通じて、言語モデルの理解機能を Milvus の検索プロセスに統合します。
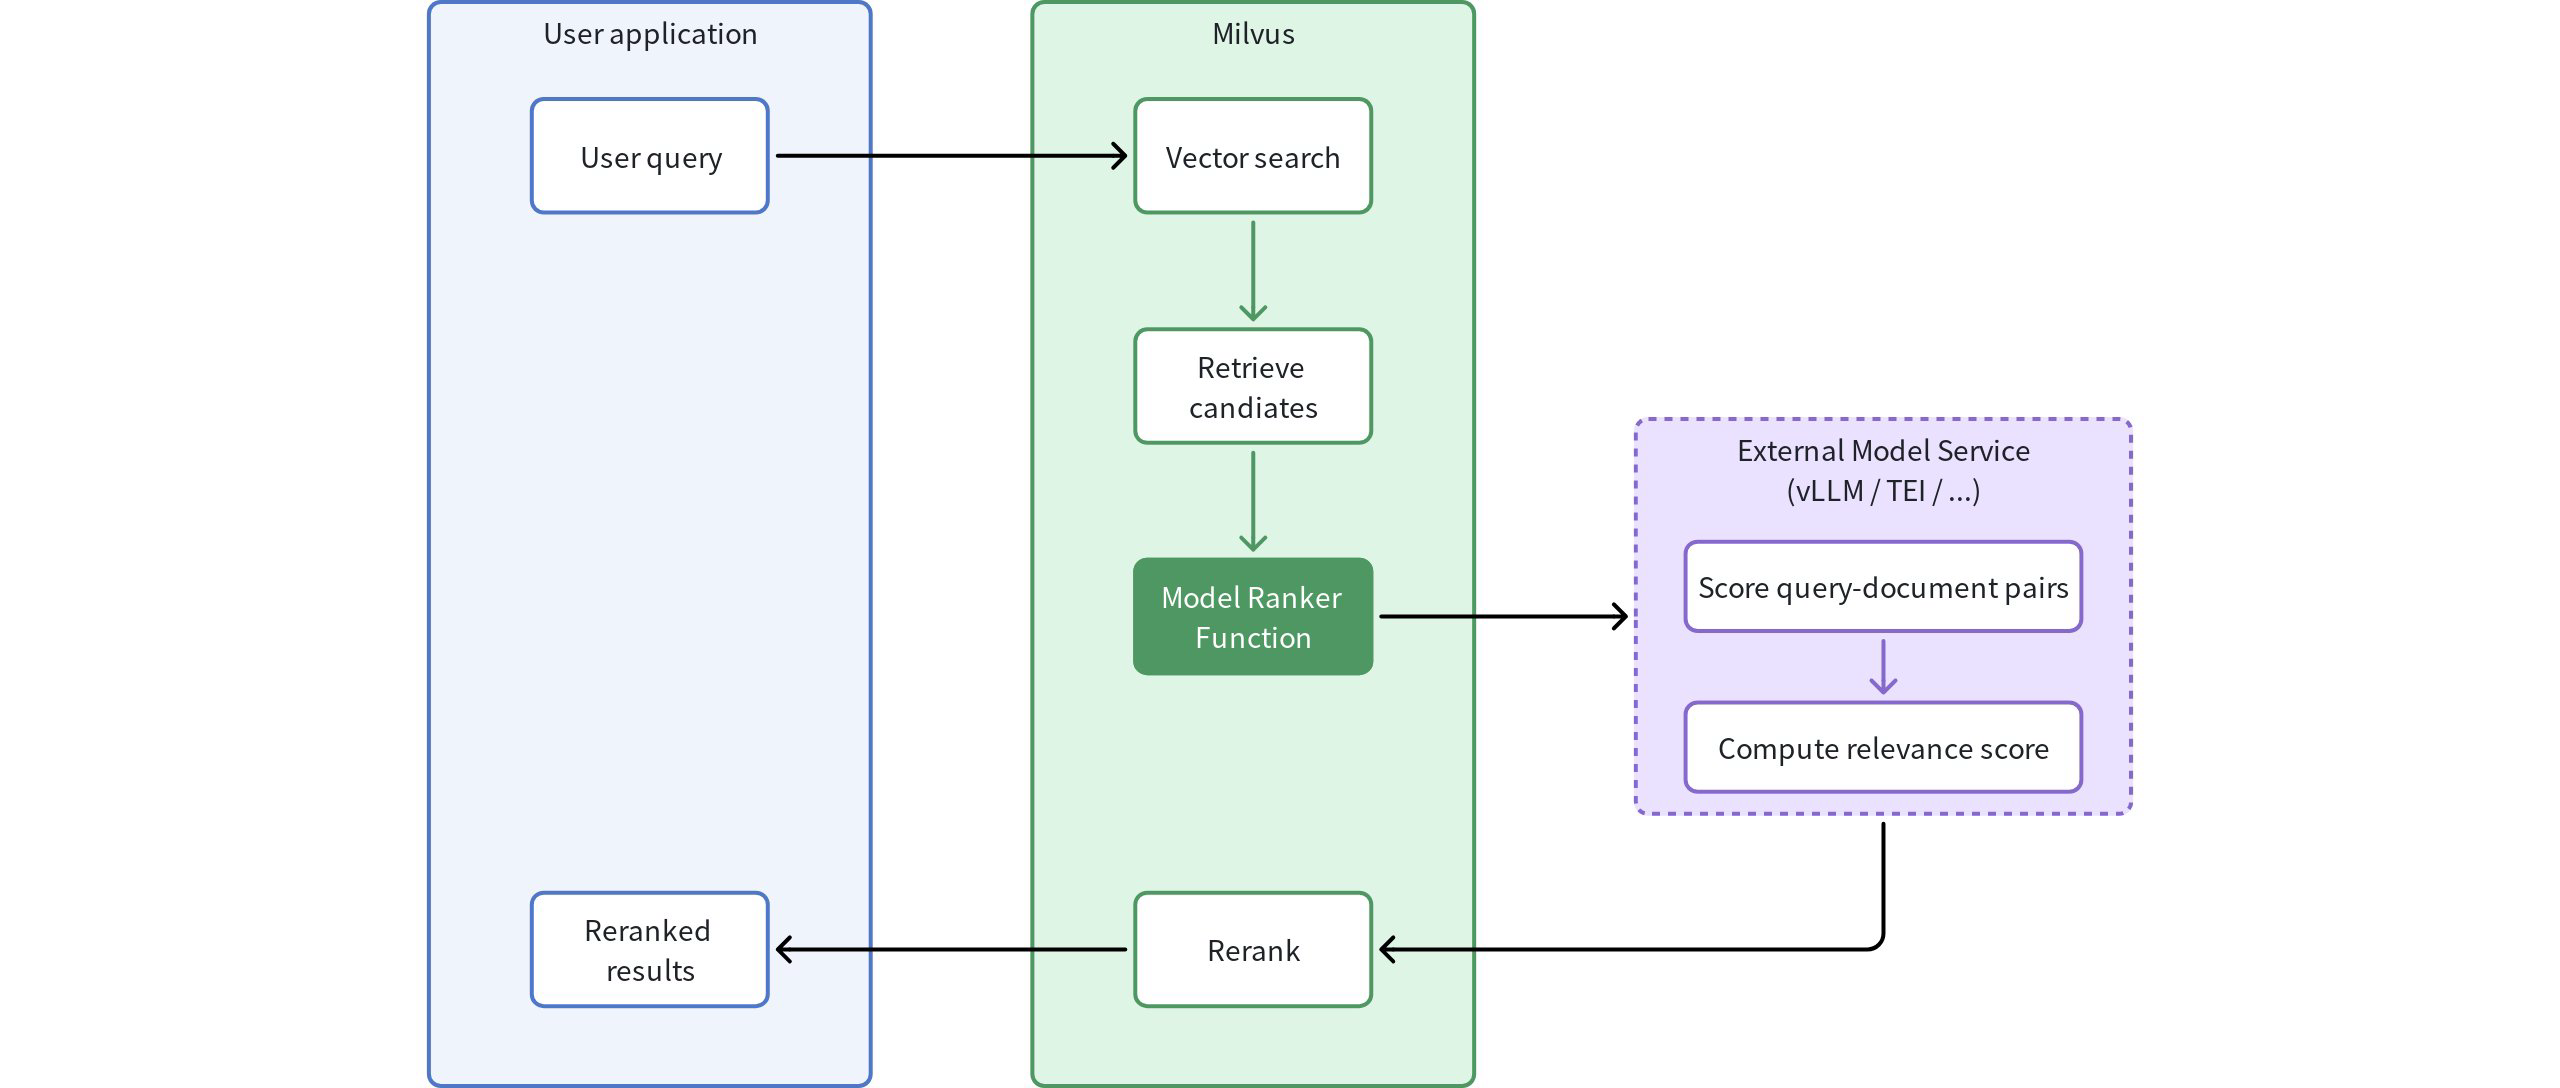 モデルランカーの概要
初期クエリ:アプリケーションが Milvus にクエリを送信します
ベクトル検索:Milvusが標準的なベクトル検索を実行し、候補ドキュメントを特定します
候補の抽出:システムはベクトル類似度に基づいて、最初の候補ドキュメントセットを特定します
モデル評価:モデルランカー関数がクエリとドキュメントのペアを処理します:
元のクエリと候補ドキュメントを外部のモデルサービスに送信します
言語モデルが、クエリと各ドキュメント間の意味的関連性を評価します
各文書には、意味的理解に基づいて関連性スコアが割り当てられる
インテリジェントな再ランク付け:モデルによって生成された関連性スコアに基づいて、文書の順序が再編成されます
検索結果の向上:アプリケーションには、単なるベクトル類似度ではなく、意味的関連性に基づいてランク付けされた検索結果が提供されます
ニーズに合ったモデルプロバイダーを選択
Milvusは、再ランク付けのために以下のモデルサービスプロバイダーをサポートしており、それぞれに独自の特性があります:
プロバイダー |
適した用途 |
特徴 |
使用例 |
|---|---|---|---|
vLLM |
深い意味理解とカスタマイズを必要とする複雑なアプリケーション |
|
法律用語や判例間の関係を理解する、ドメイン特化型モデルを導入した法律研究プラットフォーム |
TEI |
リソースを効率的に活用した迅速な導入 |
|
標準的な要件を満たしつつ、効率的な再ランク付け機能を必要とするコンテンツ管理システム |
Cohere |
信頼性と統合の容易さを優先するエンタープライズアプリケーション |
|
一貫したAPIパフォーマンスと多言語商品カタログを備えた、高可用性の検索機能を必要とするEコマースプラットフォーム |
Voyage AI |
特定のパフォーマンスおよびコンテキスト要件を持つRAGアプリケーション |
|
文書長が様々で、微調整された性能制御と専門的な意味理解を必要とする研究用データベース |
SiliconFlow |
費用対効果を優先した長文ドキュメントの処理アプリケーション |
|
インテリジェントなセグメンテーションとオーバーラップ制御を必要とする、長文のマニュアルや論文を処理する技術文書検索システム |
Hugging Face |
ホスト型Hugging Face文類似度モデルを活用したアプリケーション |
|
別途推論サービスを運用することなく、Hugging Faceモデルを使用して候補テキストの再ランク付けを行いたいセマンティック検索アプリケーション |
各モデルサービスの実装に関する詳細については、専用のドキュメントを参照してください:
実装
Model Ranker を実装する前に、以下の準備が整っていることを確認してください:
再ランク付け対象のテキストを含む「
VARCHAR」フィールドを持つMilvusコレクションMilvusインスタンスからアクセス可能な、稼働中の外部モデルサービス
Milvusと選択したモデルサービス間の適切なネットワーク接続
モデルランカーは、標準のベクトル検索およびハイブリッド検索操作の両方にシームレスに統合されます。実装には、再ランク付けの設定を定義するFunctionオブジェクトを作成し、それを検索操作に渡す作業が含まれます。
モデルランカーの作成
モデル再ランク付けを実装するには、まず適切な設定を持つFunctionオブジェクトを定義します。この例では、サービスプロバイダーとしてTEIを使用します:
from pymilvus import MilvusClient, Function, FunctionType

# Connect to your Milvus server
client = MilvusClient(
    uri="http://localhost:19530"  # Replace with your Milvus server URI
)

# Create a model ranker function
model_ranker = Function(
    name="semantic_ranker",  # Function identifier
    input_field_names=["document"],  # VARCHAR field to use for reranking
    function_type=FunctionType.RERANK,  # Must be set to RERANK
    params={
        "reranker": "model",  # Specify model reranker. Must be "model"
        "provider": "tei",  # Choose provider: "tei", "vllm", etc.
        "queries": ["machine learning for time series"],  # Query text
        "endpoint": "http://model-service:8080",  # Model service endpoint
        # "maxBatch": 32  # Optional: batch size for processing
    }
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.ranker.ModelRanker;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

ModelRanker ranker = ModelRanker.builder()
        .name("semantic_ranker")
        .inputFieldNames(Collections.singletonList("document"))
        .provider("tei")
        .queries(Collections.singletonList("machine learning for time series"))
        .endpoint("http://model-service:8080")
        .build();
// nodejs
// go
# restful
パラメータ |
必須? |
説明 |
値 / 例 |
|---|---|---|---|
|
はい |
検索の実行時に使用される、関数の識別子。 |
|
|
はい |
再ランク付けに使用するテキストフィールドの名前。
|
|
|
はい |
作成する関数のタイプを指定します。 すべてのモデルランカーについて、 |
|
|
はい |
モデルベースの再ランク付け関数の設定を含む辞書。使用可能なパラメータ(キー)は、サービスプロバイダによって異なります。 |
|
|
はい |
モデル再ランク付けを有効にするには、 |
|
|
はい |
再ランク付けに使用するモデルサービスプロバイダー。 |
|
|
はい |
再ランク付けモデルが関連性スコアを計算するために使用するクエリ文字列のリスト。 クエリ文字列の数は、検索操作におけるクエリの数と完全に一致している必要があります(テキストの代わりにクエリベクトルを使用している場合でも同様です)。一致しない場合、エラーが報告されます。 |
|
|
はい |
モデルサービスの URL。 |
|
|
いいえ |
1回のバッチで処理するドキュメントの最大数。値を大きくするとスループットは向上しますが、より多くのメモリが必要になります。 |
|
標準ベクトル検索に適用
モデルランカーを定義したら、検索操作の際に `ranker` パラメータに指定することで適用できます:
# Use the model ranker in standard vector search
results = client.search(
    collection_name,
    data=[your_query_vector], # Number of query vectors must match that specified in model_ranker.params["queries"]
    anns_field="vector_field",
    limit=10,
    output_fields=["document"],  # Include the text field in outputs
    ranker=model_ranker,  # Apply the model ranker here
    consistency_level="Bounded"
)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

SearchReq searchReq = SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .data(Collections.singletonList(new EmbeddedText("machine learning for time series")))
        .annsField("vector_field")
        .limit(10)
        .outputFields(Collections.singletonList(document))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .consistencyLevel(ConsistencyLevel.BOUNDED)
        .build();
SearchResp searchResp = client.search(searchReq);
// nodejs
// go
# restful
