

MinHash関数Compatible with Milvus 3.0.x
MinHash関数は、生テキストを、文書間のジャッカード類似度を 近似するバイナリベクトルに変換します。テキストのシンギングと複数のハッシュ関数を適用して固定長のシグネチャベクトルを生成することで、大規模な環境においても、近似重複文書の高速検出と文書重複排除を可能にします。
MinHashは組み込み関数であるため、Milvus内で実行され、外部モデルによる推論や前処理を必要としません。生のテキストを入力するだけで、Milvusが自動的にMinHashシグネチャベクトルを生成します。
制限事項
各MinHashシグネチャは32ビットのハッシュ値であるため、出力フィールドは次元が
dim % 32 == 0を満たすBINARY_VECTORでなければなりません。バイナリベクトルフィールドの
dimは、32 * num_hashesと一致している必要があります。一致しない場合はエラーが発生します。MINHASH_LSHのインデックスをMinHash関数の出力に使用する場合は、mh_element_bit_widthを32に設定する必要があります。
MinHashの仕組み
MinHashは、集合間のジャカード類似度を推定する、局所性に敏感なハッシュ手法です。Milvusにおいて、MinHash関数は以下のパイプラインに従います。ユーザーは生のテキストを入力として提供し、Milvusはバイナリベクトルを出力します。中間ステップはすべて内部で処理されます。
全体的なワークフローは、ドキュメントの取り込みとクエリ処理の両方で使用される共通のテキスト処理パイプラインと、それに続く保存および検索のためのフェーズ固有の操作で構成されています。
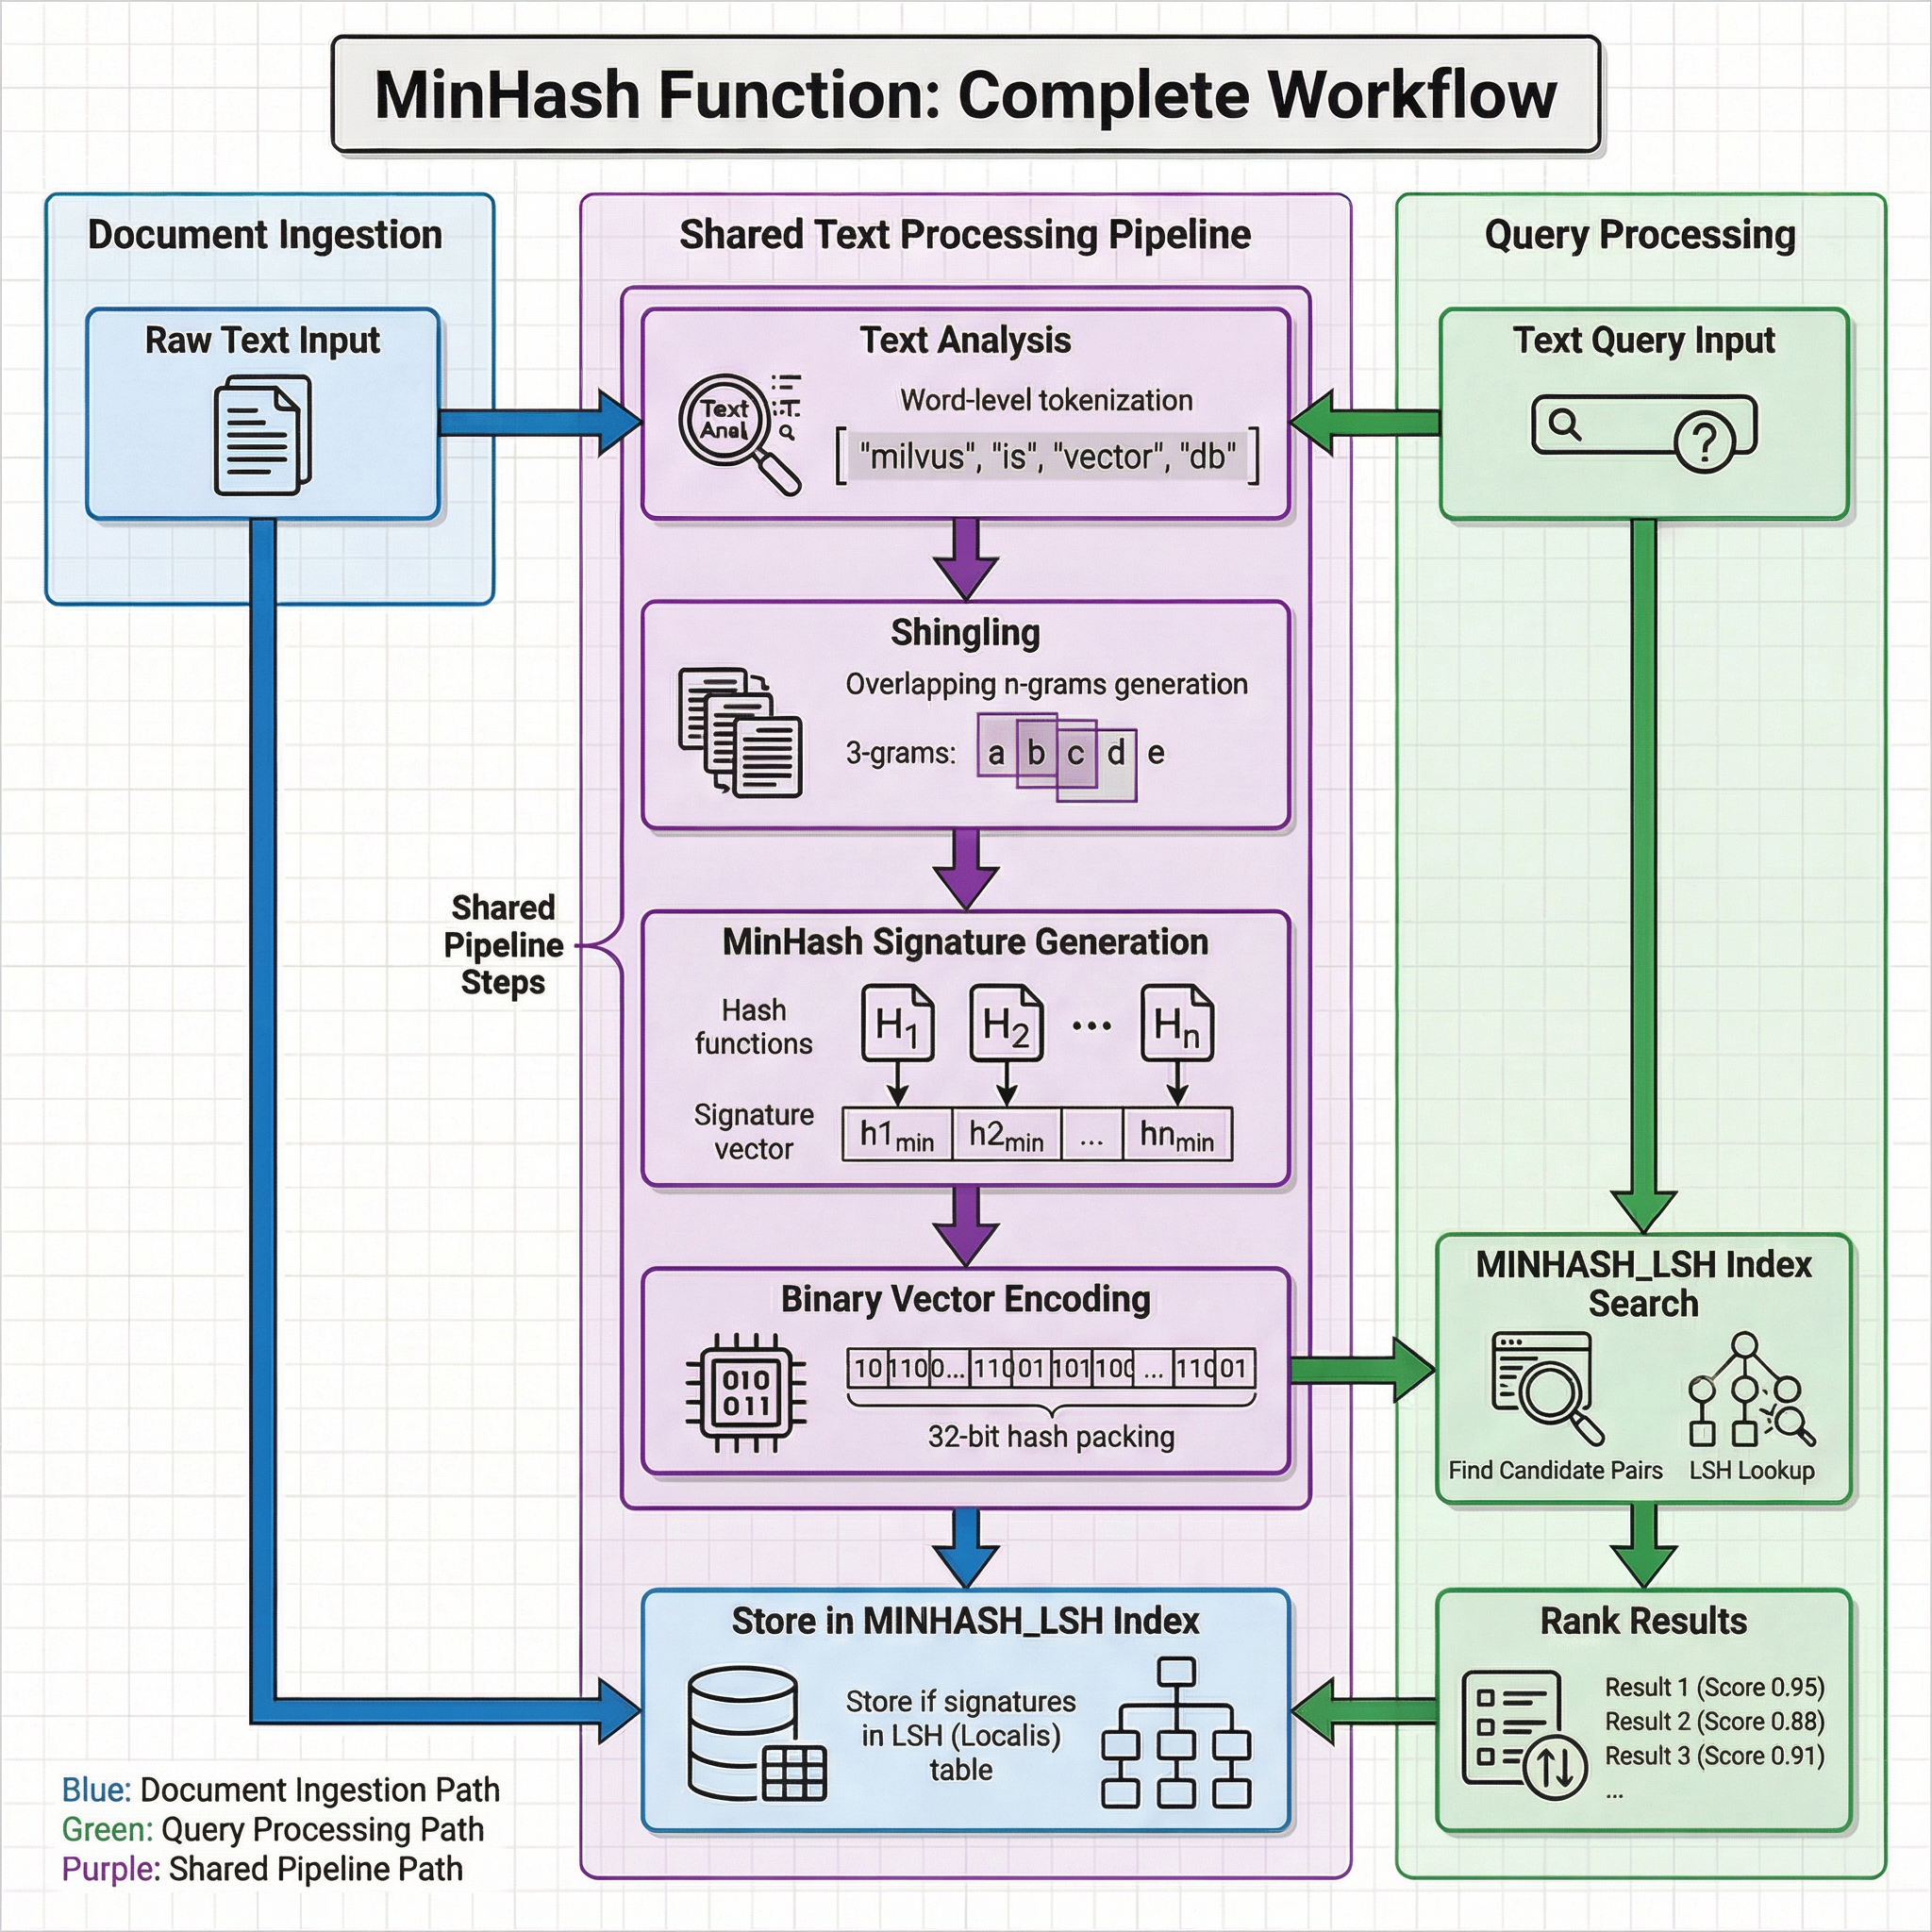 Iaqkbfeh8oqggsx6nsocfosondo
共通のテキスト処理パイプライン
ドキュメントの取り込みとクエリ処理の両方において、生のテキストは同じ4段階の変換処理を経ます:
テキスト分析:テキストはアナライザーによって処理される(
token_levelが"word"の場合)か、直接使用される(token_levelが"char"の場合)。単語レベルのトークン化では、入力フィールドに設定されたアナライザーを適用してテキストを用語に分割します。例えば、"milvus is vector db"は["milvus", "is", "vector", "db"]となります。シンギング:トークンは、サイズが
shingle_sizeの重なり合うn-グラム(シングル)に分割されます。たとえば、単語レベルで3-グラムを使用する場合、トークン「["information", "retrieval", "is", "a", "field"]」は「["information retrieval is", "retrieval is a", "is a field"]」のようなシングルになります。MinHashシグネチャの生成:複数のハッシュ関数(H1, H2, …, Hn、ここで n =
num_hashes)がシングル集合に適用される。 各ハッシュ関数について、すべてのシンブルにわたる最小のハッシュ値が選択されます。これらの最小値の集合が MinHash 署名を形成します。これは、元の文書のジャッカード類似度を近似する固定長の表現です。バイナリベクトルエンコーディング:各署名値は 32 ビットのハッシュであり、完全な署名は次元
32 * num_hashesのBINARY_VECTORにパックされます。
文書の取り込み
挿入時、共有パイプラインによって生成されたバイナリベクトルは、MINHASH_LSH インデックスに格納されます。このインデックスは、類似したシグネチャを同じバケットにグループ化するLSH(局所性感受性ハッシュ)テーブルを維持しており、クエリ実行時に候補を高速に検索できるようにしています。
クエリ処理
検索時には、クエリテキストが同じ共有パイプラインを通過してバイナリベクトルが生成されます。このベクトルを使用してMINHASH_LSH インデックス内でLSH検索が行われ、類似している可能性が高い候補ペアが迅速に特定されます。ジャカード精緻化が有効になっていない場合、Milvusは推定ジャカード類似度によるランク付けが行われていないLSH候補を返します。 ジャカード精緻化が有効になっている場合、Milvusは保存された生のMinHashシグネチャを使用して、推定ジャカード類似度に基づいて候補をランク付けし、上位K件の結果を返します。
どちらの処理経路も同一の変換ロジックを共有しているため、内容が高度に重複している2つのドキュメントは、類似したMinHashシグネチャを生成します。これにより、ドキュメント間の語順、書式、あるいは些細な表現の違いがあっても、ニアダブレートを効果的に検出することが可能になります。
開始する前に
MinHash 関数を使用する前に、コレクションスキーマに以下の項目を含めるよう計画してください:
生コンテンツ用のテキストフィールド
コレクションには、生のテキストを格納するための
VARCHARフィールドが含まれている必要があります。このフィールドは、MinHash関数の入力として機能します。テキストフィールド用のアナライザー(単語レベルのトークン化を使用する場合)
token_levelが"word"(デフォルト)に設定されている場合、テキストフィールドにはアナライザーが有効になっている必要があります。アナライザーは、シンギングの前にテキストがどのようにトークン化されるかを定義します。デフォルトでは、Milvusはstandardアナライザーを使用します。別のアナライザーを設定するには、「ユースケースに適したアナライザーの選択」を参照してください。MinHash出力用のバイナリベクトルフィールド
コレクションには、MinHash関数によって生成されたバイナリベクトルを格納するための
BINARY_VECTORフィールドが含まれている必要があります。そのディメンションは32 * num_hashesと一致している必要があります。
ステップ 1: MinHash 関数を含むコレクションを作成する
MinHash関数を使用するには、コレクションの作成時にその関数を定義します。この関数はコレクションスキーマの一部となり、データの挿入や検索の際に自動的に適用されます。
スキーマフィールドの定義
コレクションスキーマには、少なくとも以下の3つのフィールドを含める必要があります。
プライマリフィールド:コレクション内の各エンティティを一意に識別します。
テキストフィールド(
VARCHAR): 生のテキストドキュメントを格納します。MilvusがMinHashシグネチャ生成のためにテキストを処理できるよう、enable_analyzer=Trueを設定してください。デフォルトでは、Milvusはテキスト分析にstandardアナライザを使用します。別のアナライザを設定するには、「ユースケースに適したアナライザの選択」を参照してください。バイナリベクトルフィールド(
BINARY_VECTOR): MinHash関数によって自動的に生成されたバイナリベクトルを格納します。次元は32 * num_hashesと一致している必要があります。
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="http://localhost:19530", token="root:Milvus")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
// java
// nodejs
// go
# restful
MinHash関数の定義
MinHash関数は、分析されたテキストを、ドキュメント間のジャカード類似度を近似するバイナリベクトルに変換します。
関数を定義し、スキーマに追加します:
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
// java
// nodejs
// go
# restful
設定オプション
MinHash関数のparams 辞書は、以下のパラメータを受け付けます。すべてのパラメータ名は大文字小文字を区別しません。
パラメータ |
型 |
デフォルト |
説明 |
|---|---|---|---|
|
int |
由来 |
署名生成に使用するハッシュ関数の数。出力バイナリベクトルの次元は、 |
|
int |
|
シンギング用のN-gramサイズ。単語レベル:通常は1~3。文字レベル:通常は2~6。 |
|
str |
|
使用するハッシュ関数。オプション:
|
|
str |
|
トークン化レベル。オプション:
|
|
int |
|
MinHash関数の初期化に使用するランダムシード。 |
インデックスの設定
MinHash バイナリベクトルに推奨されるインデックス型は `MINHASH_LSH` で、メトリック型は `MHJACCARD` です。
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
// java
// nodejs
// go
# restful
検索でジャッカード精緻化を使用する場合は、with_raw_data をTrue に設定してください。LSH検索によって返された候補に対する推定ジャッカード類似度を計算するには、生のMinHashシグネチャが必要です。
コレクションの作成
上記で定義したスキーマおよびインデックスパラメータを使用してコレクションを作成します:
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
// java
// nodejs
// go
# restful
ステップ 2: ドキュメントの挿入
コレクションの設定が完了したら、テキストデータを挿入します。必要なのは生のテキストのみです。MinHash関数が各ドキュメントのバイナリベクトルを自動的に生成します。
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
// java
// nodejs
// go
# restful
ステップ 3: MinHash を使用した検索
データの挿入が完了したら、生のテキストクエリを指定して、近似重複ドキュメントを検索します。Milvusは各クエリを自動的にMinHashバイナリベクトルに変換します。Jaccard精緻化を有効にすると、推定されたJaccard類似度に基づいてLSH候補をランク付けできます。
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
// java
// nodejs
// go
# restful
mh_search_with_jaccard をTrue に設定すると、ジャッカード精緻化が有効になります。refine_k は、精緻化に使用される候補プールの容量を制御します。Milvusはmax(refine_k, limit) を容量として使用しますが、LSH検索で一致する候補が少ない場合は、精緻化の対象となる候補数が少なくなる場合があります。refine_k の値を大きくすると、計算負荷は増えますが、結果の品質を向上させることができます。
今後の展望
全文検索:近似重複の検出ではなく、語彙的関連性のランキングにBM25を使用します。
アナライザーの概要:テキストのトークン化用にカスタムアナライザーを設定します。
MINHASH_LSH インデックス:リコール率とパフォーマンス向上のための LSH パラメータの調整について学ぶ。
